Litestream 的可写 VFS
Litestream 的作者 Ben Johnson 讲这款 Unix 风格的工具如何把 SQLite 数据库同步到 S3 式对象存储,以及它为何成了 Sprites 的关键组件。这次的新东西是可写的 VFS。
中文
复制
*Image by:
I'm Ben Johnson, and I work on Litestream at Fly.io. Litestream is the missing backup and restore system for SQLite. It's free, open-source software, and it ought to run anywhere. Read more here.
Every time we write about it, our description of what Litestream is gets a little tighter. This time: Litestream is a Unix-style tool for keeping SQLite databases in sync with S3-style object storage. With it, you get SQLite's speed and simplicity without having to worry about catastrophic data loss. Your application doesn't even need to know it exists — just run it as a background tool.
These past two weeks have been busy.
We recently launched Sprites. If you don't know what Sprites are yet, go take a look. It's one of the coolest things we've ever shipped. I won't spend more time pitching it. Anyway, Sprites is a big deal, and Litestream is a key component of it — which is also a big deal to me.
Sprites depends directly on Litestream in two important ways.
First, Litestream SQLite is at the core of our global Sprites orchestrator. Our flagship product, Fly Machines, relies on a centralized Postgres cluster; Sprites is different: this orchestrator, written in Elixir, runs directly on S3-compatible object storage. Every organization that signs up for Sprites gets its own SQLite database, kept in sync by Litestream.
This design is interesting. It uses the "lots of SQLite databases" pattern, which is underrated. It scales well. And as Fly.io has grown, keeping that Postgres cluster healthy has been a major engineering challenge.
But as far as Litestream goes, there isn't much to say about this orchestrator, so I'll stop there. The second way Sprites uses Litestream is much more interesting.
Litestream 直接内置于每个 Sprite 所运行的磁盘存储栈中。
Sprite 的启动时间不到一秒,每个 Sprite 启动时都带有 100GB 的持久存储。这背后是相当棘手的工程问题。我们之所以能做到这一点,是因为 Sprite 存储的根是兼容 S3 的对象存储;而我们让它变快的方式,是维护一个记录在用存储块的数据库,并利用挂载的 NVMe 作为读穿透缓存。做这件事的系统是 JuiceFS,而那个数据库——我们姑且叫它“块映射”——是一个重写过的元数据存储,基于(你猜对了)BoltDB。
开玩笑的!当然是 Litestream SQLite。
Sprite 存储很挑剔
Sprite 里的一切都为了快速启动而设计。
如果 Sprite 底层的 Fly Machine 重启,我们可能需要从对象存储重建块映射。块映射不算大,但也不小;最坏情况下大概几十兆字节。
问题在于,这一切发生在 Sprite 重新启动的过程中。换个角度说,这可能是在响应一个传入的 Web 请求时发生的;也就是说,我们必须在足够短的时间内完成,才能及时对该请求作出响应。时间预算很紧。
为了进一步加快速度,我们正在集成 Litestream VFS 来改善启动时间。VFS 是一个动态库,加载到你的应用中即可使用。加载之后,你就可以做这样的事:
sqlite> .open file:///my.db?vfs=litestream
sqlite> PRAGMA litestream_time = '5 minutes ago';
sqlite> SELECT * FROM sandwich_ratings ORDER BY RANDOM() LIMIT 3 ;
22|Veggie Delight|New York|4
30|Meatball|Los Angeles|5
168|Chicken Shawarma Wrap|Detroit|5
Litestream VFS 让我们可以直接在对象存储的 blob 上运行时间点 SQLite 查询,在数据库还没下载完之前就回答查询。
这很好,但并不完美。我们有两个问题:
- 只能读,不能写。用户会往 Sprite 磁盘里写数据。存储栈需要能立即写入。
- 在冷启动时,除了下载整个数据库别无他法,这时直接从对象存储上跑查询简直是救命稻草,但在稳态下它不够快。
这些问题很有意思。以下是我们解决它们的第一版方案。
可写 VFS
我们做的第一件事,是让 VFS 可以选择性地支持读写。这个特性相当微妙;它很有趣,但并没有看上去那么通用。让我解释一下它的工作原理,然后再解释为什么它要这样设计。 读的时候请记住,这里讨论的只是 VFS 本身。显然,以常规方式使用 Litestream 的普通 SQLite 数据库是可写的。
VFS 的工作方式是:为对象存储中数据库的每个页面维护一份 (file,offset, size) 索引;索引本身的数据存放在 LTX 文件里,这样 VFS 启动时就能快速重建,查询也大量走缓存。前面查询 sandwich_ratings 时,我们的 VFS 库拦截了 SQLite 的读取方法,在索引里查到所需页面,取回并缓存。
读路径没问题。写就麻烦多了。
只读模式下,Litestream 在后台轮询,这样就能发现远端写入者新建的 LTX 文件。这支持一个很实用的场景:跑测试,或对生产环境必须保持快速的数据库做慢速分析查询。
写模式下不允许有多个写入者——多写入者的分布式 SQLite 数据库就是 Lament Configuration,而我们不想去探索那一片痛苦的风景。所以写模式下的 VFS 关掉了轮询:我们假定只有一个写入者,也没有额外的备份需要盯着。
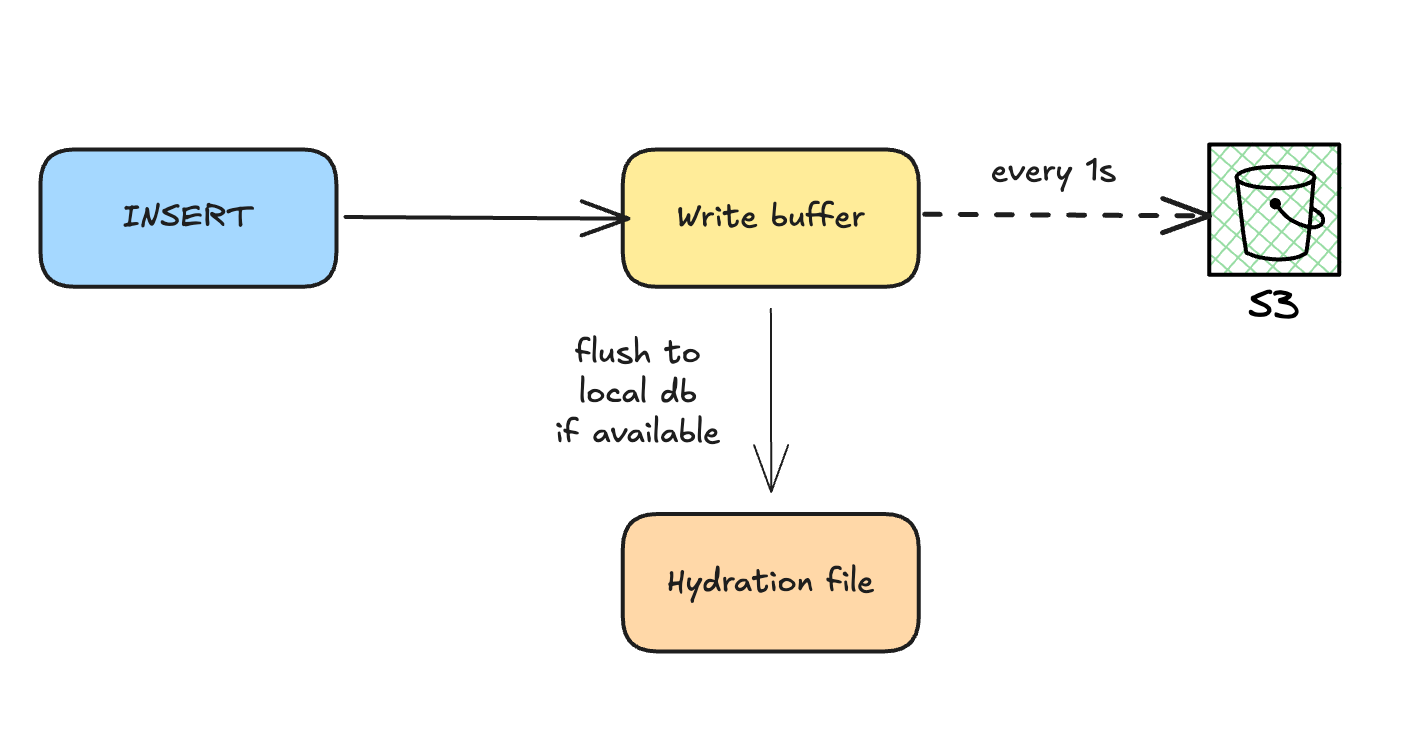
接下来是缓冲。写入先落到本地临时缓冲区(“写缓冲区”)。大约每秒一次(或干净关闭时),我们把写缓冲区同步到对象存储。在那次同步发生之前,经 VFS 写入的数据都不算真正持久化。
大多数存储的块映射比这要小得多,但即便如此。
现在回想一下我们要支持的场景:一个 Sprite 正在冷启动,它的存储栈需要在启动后几毫秒内就能处理写入,而手上并没有那份 10MB 块映射的完整副本。可写 VFS 模式让我们做到了这一点。
关键在于,我们只在这个场景已有的持久性要求范围内支持它。Sprite 上的所有存储都共享这种“最终持久化”特性,所以 VFS 写入的这套约定在这里说得通。放到你的应用里,多半说不通。但如果出于某种原因它正好合适,那就用吧。要用 Litestream VFS 开启写入,只需把环境变量 LITESTREAM_WRITE_ENABLED 设为 "true"。
水合
Sprite 的存储栈使用 VFS 模式下的 SQLite。在我们最初的 VFS 设计中,大部分数据都放在 S3 上。还是那句话:冷启动时没问题,稳态下就不太行了。
为了解决这个问题,我们从 dm-clone 这类系统里借鉴了一招:后台水合。水合的设计思路是,一边远程响应查询,一边跑一个循环把整个数据库拉下来。启动 VFS 时设置 LITESTREAM_HYDRATION_PATH 环境变量,我们就会把数据水合到那个文件里。
水合利用了 LTX 压缩,只写入每个页面的最新版本。读操作不会被水合阻塞;我们直接从对象存储响应读请求,等水合文件就绪后再切换过去。
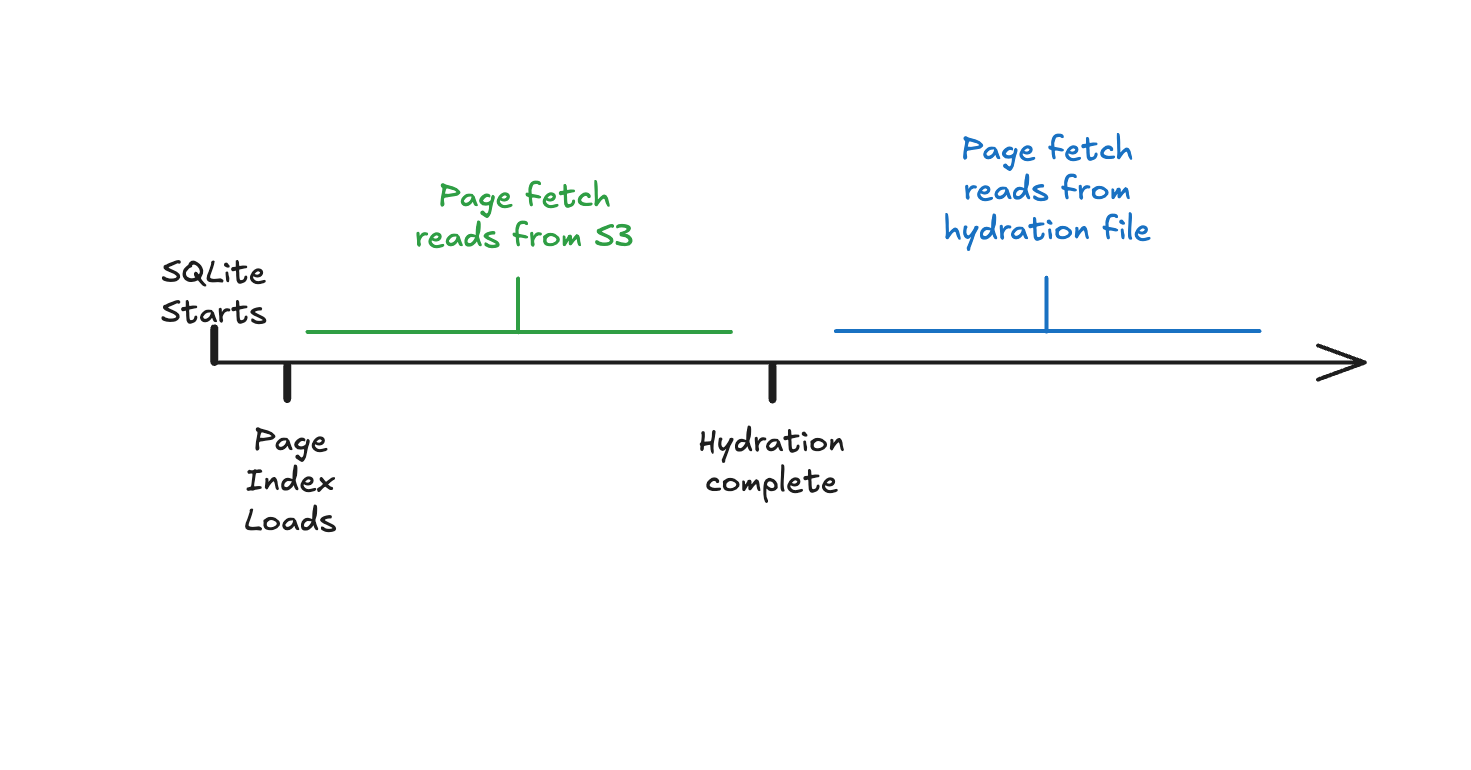
水合文件是什么?它就是你数据库的一份完整副本。跑一遍 litestream restore 得到的东西和它一模一样。
因为这套设计面向的是 Sprites 这种频繁重启的环境,我们把数据库写进一个临时文件。每次启动时,我们没法确信数据库用的是最新状态——除非做一次完整恢复——所以退出 VFS 时干脆把水合文件扔掉。这个行为目前已经写死在 VFS 里了。这个特性满足了 Sprites 的需求,但同样,未必是你们的应用想要的。
合在一起看
这篇文章讲的是我们在开源项目 Litestream 上做出的两个比较大的动作,但这些特性的适用范围很窄,针对的是和我们存储栈所面临的问题相似的那类场景。如果你觉得它们对你有用,我很高兴,也希望你能告诉我。
对于普通的读写负载,你不需要这套机制。Litestream 不用 VFS 也能正常工作,应用不用改,作为 sidecar 和你的应用一起跑就行。这种配置的全部意义就在于高效跟上写入;当你知道写入发生时手里有完整的数据库,这件事就很容易。
但在我看来,整件事是一个很有价值的案例,说明 Litestream 如何被用在一个相对复杂、要求苛刻的问题领域里。Sprites 非常酷,而且知道 Sprite 上每一次磁盘写入都经过 Litestream,这让人很满足。