内部の仕組み、ホットパスを迂回する:D1 はいかにして数百万データベースまでスケールするか
Cloudflare は D1 のコントロールプレーンを書き直し、クエリパスに一切の関連作業を入れずに数百万のデータベースを管理できるようにした。Durable Objects、ハートビート、キュー、事前集計した使用量表、Quicksilver で複製したレートリミッターを使っている。
日本語
コピー
従来のデータベースアーキテクチャは、アプリケーション1つにつき大規模なデータベースクラスタを1つか2つ、それに加えて接続プールの仕組みを用意することを前提としていた。AI 支援開発や vibe coding のプラットフォームはこの前提を根本から覆し、アプリケーションを多数の小さなデータベースへと向かわせる。ユーザーごと、アプリごと、プレビュー環境ごと、テナントごとに1つのデータベース、という形だ。このパターンは D1 と相性がいい。D1 は Cloudflare の SQLite ベースのマネージドサーバーレスデータベースで、数百万のデータベースを作成でき、実際に使った分だけを支払う。そこから問題が生じる。数百万のデータベースに向けてコントロールプレーンをどうスケールさせるか。しかも、クエリのたびに中央のボトルネックを通って遅くなる、という事態を避けながら。数百万のデータベースを作成し(そのうち任意の時点で数十万がアクティブ)、そうしたプラットフォームを D1 が支えるために、私たちはアーキテクチャを大きく作り替えた。本記事では舞台裏に入り、D1 コントロールプレーンの仕組みを分解して説明する。ここで述べるアーキテクチャパターンの多くは、Cloudflare 開発者プラットフォーム上で構築する人なら誰でもそのまま当てはめられる。記事はついでに、私たちが自分たちのコントロールプレーンをどう作ったかも示す。
数字で見る成長
これらの変更を計画し始めた時点で、D1 の利用はすでに着実に伸びていたが、大規模プラットフォームが D1 上で構築され始めれば、支えるべき規模ははるかに大きくなると分かっていた。現時点ではこうなっている。過去1年で、D1 の存続している(削除されていない)データベース数は15倍、過去2年では65倍に増えた(2026年10月8日時点)。過去1年で、1日あたりのアクティブデータベース数は18倍に増えた(2026年10月8日時点)。その日に少なくとも1回クエリを実行したデータベースをアクティブと数える。すでに数多くの成熟したプラットフォームが D1 でプロダクトを構築しており、使っているのはすべての Cloudflare ユーザーが利用できるのと同じツールだ。
「ChatGPT Sites は、誰もがアイデアを共有できる体験に変えられるようにします。D1 は、ユーザーがダッシュボードやゲーム、ツールにカスタム指標、リーダーボード、コメントなどを簡単かつスケーラブルに追加する手段を提供してくれます」——Jon Abrams、ChatGPT Sites @ OpenAI
このブログで述べる変更を書いている間も、私たちは予想される成長をはるかに上回る目標に対して定期的に負荷テストを行った。これがどこに最適化の労力を注ぐべきかを決めている。
指針となるエンジニアリング原則
Cloudflare Developer Platform 上で動くアプリケーションは、フルスタックアプリやサービス API から、社内の単一ユーザー向けポータル、大規模なマルチテナントの vibe coding プラットフォームまで、あらゆるものが混在している。数百万のデータベースを支える D1 コントロールプレーンを作るにあたり、以下の信条と原則がアーキテクチャ上の判断を導いた。私たちのプラットフォーム上でコントロールプレーンやデータプレーンを構築する人にも同じように当てはまる。
- すべてのプロセスは障害と冪等性を前提に設計する。障害は必ず起きる。システムはできる限り自己修正して前に進み続ける必要がある。
- データプレーン操作のホットパス(私たちの場合、すべてのクエリリクエスト)では、集中型の単一リージョンコンポーネントを避ける。
- 重要なルーティングメタデータには Workers KV を使う。グローバルに分散した KV ストアなので、キャッシュミス時に中央データベースへ問い合わせるのはごくわずかなケースで済む。
- 中央の Postgres データベースへは Hyperdrive 経由でアクセスし、効率的な接続プールと最適化されたルーティング・キャッシュを得る。可能な限り読み取り専用レプリカを使う。
- 集計結果はデータベース内で定期的に事前計算し、ユーザーリクエストの処理中にスキャンクエリを実行しない。
- 強い一貫性を必要としないコンポーネント間では、結果整合性とキューを使い、信頼性と可用性を高める。
- 実際に近い負荷でアプリケーションを負荷テストし、ボトルネックと非効率を見つけ、そこを優先して最適化する。
社内でシステムを構築する際にはさらに多くのエンジニアリング原則に従っているが、上記は十分に汎用的で、Cloudflare 上で構築する誰にでも当てはまる。以降のセクションでは、D1 データベースのライフサイクルを中心とした D1 コントロールプレーンの主要なシステムコンポーネントとフローを詳しく見ていき、実際のシステムでこれらの原則をどう具現化するかを示す。
高レベルアーキテクチャ
まず D1 の主要コンポーネントを紹介する。
図では、D1 を支える副次的なフローに対応する矢印やボックスをいくつか省略しているが、上記で D1 が外部に提供する機能セットはほぼ網羅している。残りは本記事の後半、専用のセクションで掘り下げる。
まず、すべての D1 データベースは1つの SQLite Durable Object によって支えられている。だから数百万のデータベースを作るのはとても簡単だ。
「HTTP API」のブロックは、Cloudflare dashboard、Wrangler、Cloudflare CLI を含むすべての API 入口を表している。すべての API リクエストは Cloudflare のエッジゲートウェイを通り、D1 Edge API Worker が処理する。
図では、ユーザーがデータベースに対して SQL クエリを実行できる HTTP エンドポイントを「Query endpoints」と記している。残りのエンドポイントは、データベースの作成・削除・一覧表示、インポート・エクスポート、タイムトラベルといった通常のデータベース操作をカバーし、「CRUD endpoints」と記している。
CRUD endpoints は Hyperdrive を通じて、私たちが「Core」と呼ぶ中核データセンターの Postgres クラスタにクエリを投げる。ここには2つの構成がある。1つはキャッシュを有効化して Postgres の読み取り専用レプリカを指すもの、もう1つはキャッシュを無効化して Postgres のプライマリを指すものだ。
Edge API Worker は、リクエストの種類に応じて D1 Eyeball Worker を呼び出すことがある。Eyeball Worker は、基盤となる D1 Durable Object(DO)での処理が必要なすべてのリクエストのプロキシとして機能する。これにより、可観測性、自動リトライ、エラーハンドリング、その他のクエリ関連の挙動を含む、あらゆるクエリ処理ロジックを Eyeball Worker に集約できる。
Workers KV はエッジ側のキャッシュ層として機能し、読み取りが多く書き込みが少ないメタデータを保持する。すべての D1 Worker がこれを読み取れる。
「Worker Binding」のブロックは、D1 Worker binding をバインドしたすべてのユーザー Worker を表す。D1 Binding からのリクエストは直接 D1 Eyeball Worker に送られ、Eyeball Worker がそのデータベースを支える Durable Object にリクエストを転送し、レスポンスをユーザー Worker にプロキシして返す。
ユーザーがデータベースでクエリを実行する方法は2つある。HTTP API のクエリエンドポイントを使うか、D1 Binding を使って自分のアカウントにデプロイした Worker を使うかだ。
運用面では、各操作を次のいずれかに分類している。
- データプレーン:データベースクエリに関わるあらゆるリクエスト。可能な限り高速であるべきで、常にエッジで動作する。
- コントロールプレーン:あらゆる HTTP API 操作、またはクエリ以外のユーザーリクエストに応じて動く内部プロセス。中央集約された単一リージョンのコンポーネントに依存してよい。
- バックグラウンド非同期プレーン:分析や課金に関わるあらゆるワークフロー。結果整合性でよく、どこで動いてもよい。
その下にはまだ多くの仕組みがあるので、主要なフローを見ていこう。
ユーザーの近くで高速にオンデマンドのデータベースを作成する
マルチテナントプラットフォームと AI agent による開発では、大量のデータベースインスタンスを高速かつ低コスト、そして確実に作成する必要がある。
D1 データベースを作成する Wrangler コマンドの例を示す:
% time wrangler d1 create "demo-01"

✅ Successfully created DB 'demo-01' in region WEUR
...
0.56s user 0.13s system 42% cpu 1.614 total
ユーザーが D1 データベースを作成するとき、そのデータベースがクエリを受け付けられるようになるまでに、いくつかやることがある。
- そのアカウントが、無料枠の制限またはアカウントの制限内でさらにデータベースを作成できるか確認する。
- 一意の D1 データベース UUID と一意の Durable Object ID(newUniqueId())を生成し、アカウントとデータベースの情報で基盤となる Durable Object(DO)を初期化する。
- 新しく作成したデータベースの情報を Postgres に永続化する(データベースごとに1行、メタデータと初期化済み Durable Object ID へのマッピングを含む)。
- データベース ID から Durable Object ID へのマッピングを Workers KV に書き込む(後でデータプレーンとクエリエンドポイントが使う)。
実際のフローと、各ステップが失敗したときの復旧方法を見ていこう。
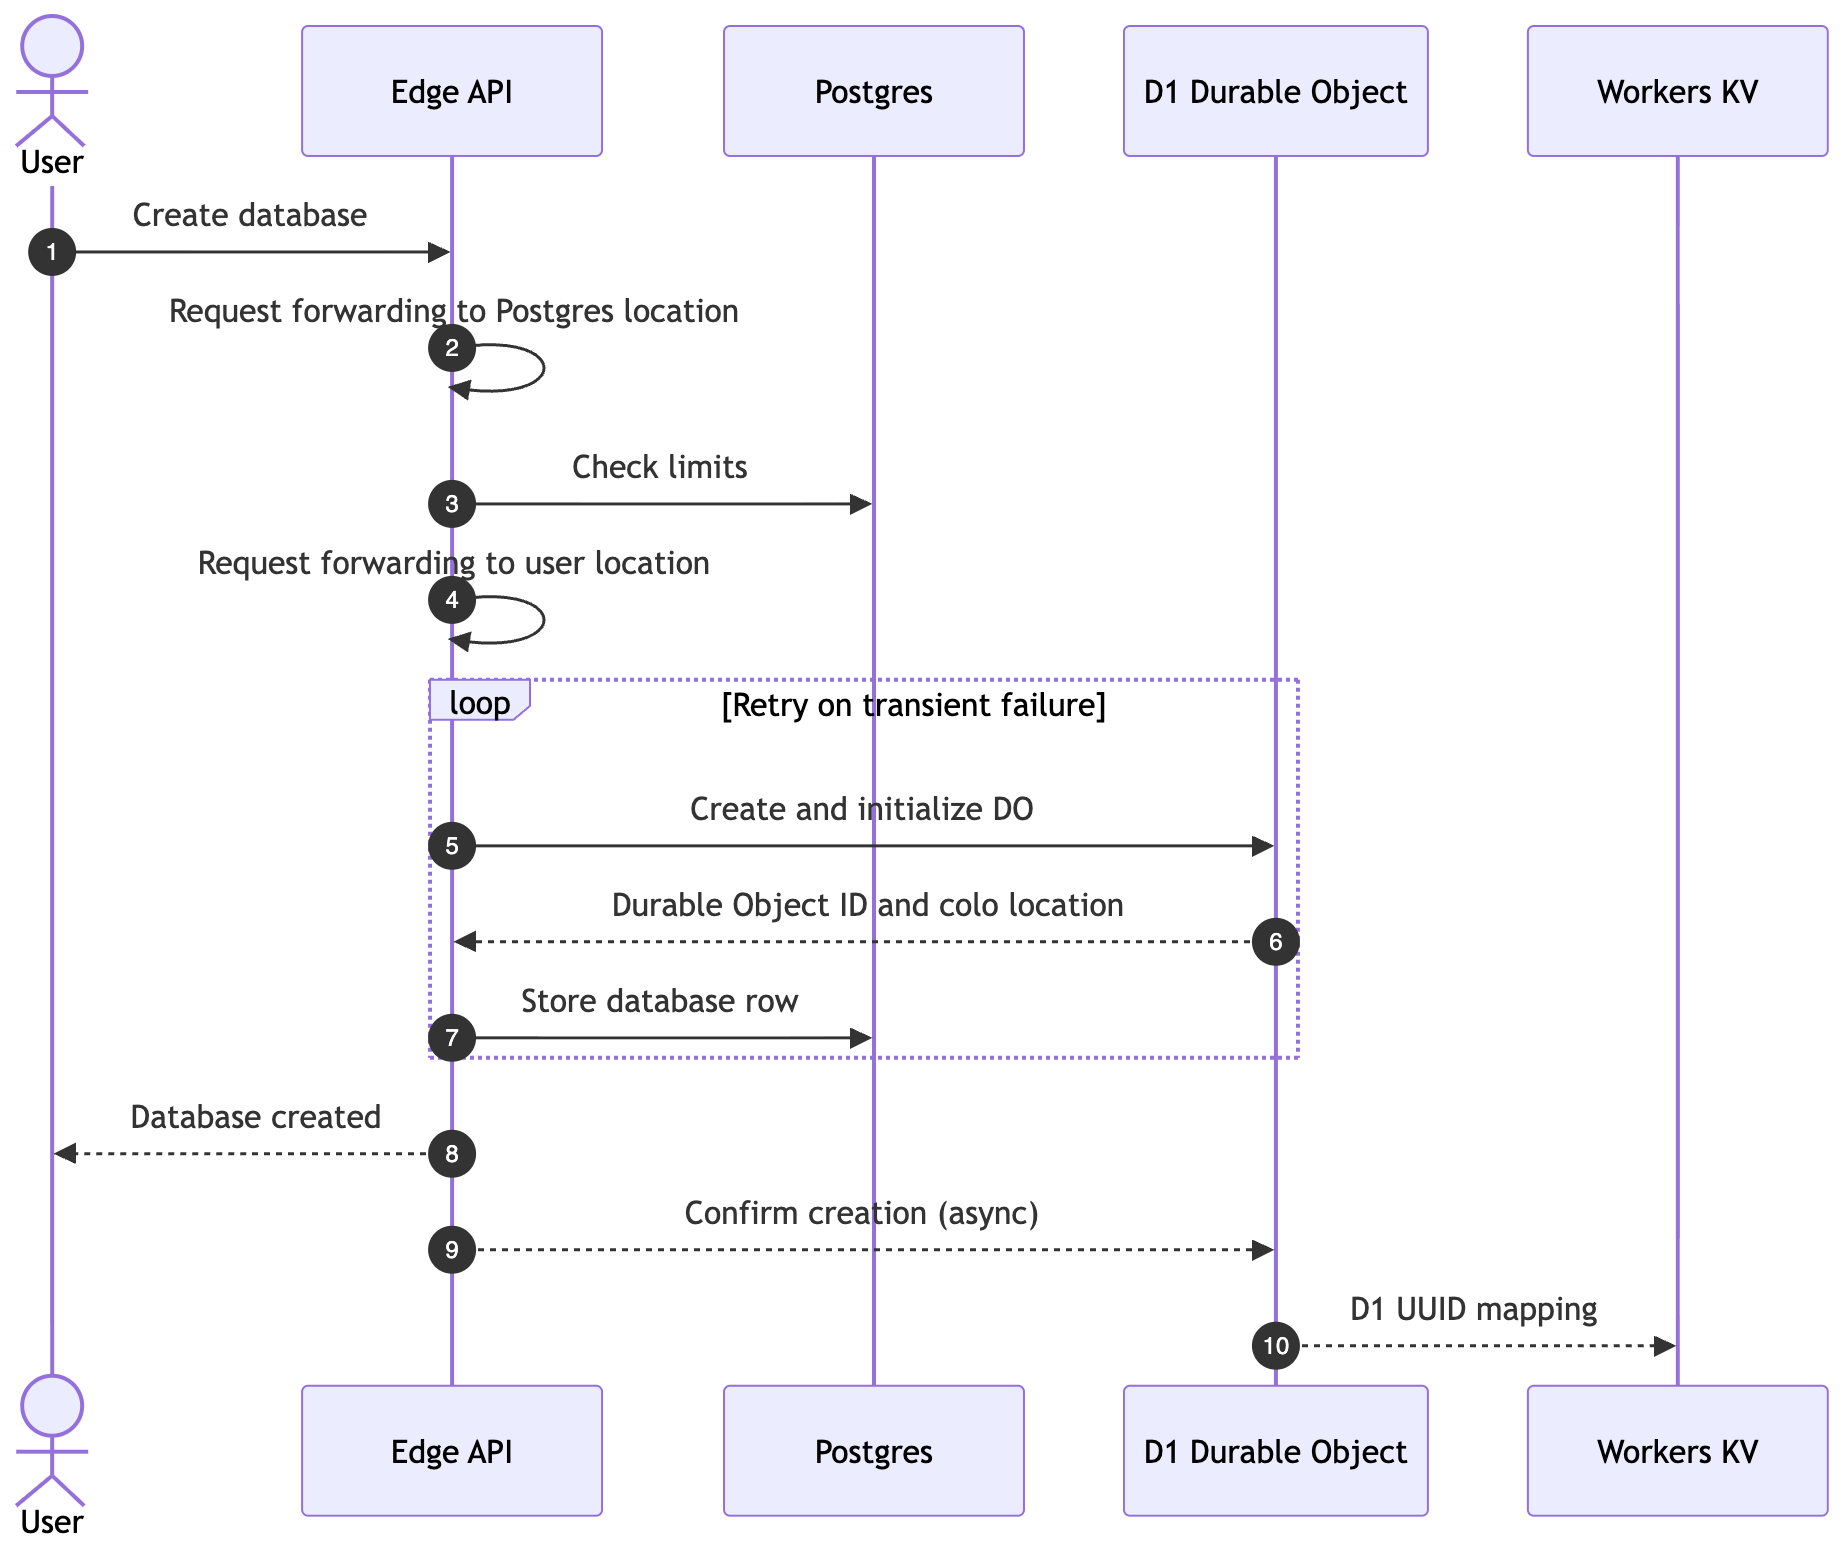
データベース作成リクエストが届くと、Edge API Worker のハンドラが最寄りの Cloudflare エッジノードで呼び出される。Edge API はキャッシュを有効にした Hyperdrive(キャッシュ TTL は数秒)経由で Postgres のリードレプリカに問い合わせ、指定アカウント配下の削除されていないデータベースの数を取得する。
Postgres へのラウンドトリップが複数回必要なエンドポイント(第 2 ステップ)では、Edge API Worker はコントロールプレーンのリクエストを Postgres クラスタに近いデータセンターへ転送する。「create database」エンドポイントもその一つだ。遠くから往復すると数百ミリ秒かかることがあるのに対し、Postgres の近くなら数ミリ秒で済む。Postgres への問い合わせが最大 1 回で済むエンドポイントにこの最適化は要らない。Hyperdrive が Cloudflare ネットワーク上で効率的なルーティングをすでに処理しているからだ。
オプションを何も指定せずに D1 データベースを作成すると、データベースはデフォルトでリクエスト元の近くに配置される。明示的なロケーションヒントや管轄区域を指定すれば、データベースの位置に影響を与えられる。ロケーションヒントと管轄区域のオプションは Durable Objects がサポートするものと完全に同一で、指定した内容はそのまま基盤の Durable Object の初期化に渡される。
デフォルトの作成では、D1 データベースをリクエスト元の近く、つまりユーザーの近くに作成したい。そのために図の第 4 ステップで、リクエストの実行を内部的にリクエスト元に近いデータセンターへ転送し、そこから基盤の Durable Object を呼び出す。これにより、基盤の Durable Object がユーザーの近くに配置されることが保証される。
明示的な Worker の配置ヒントを使い、実行時に Service Bindings 経由で正しい Worker を呼び出すことで、同様のルーティング手法を実現できる。
配置の観点では、作成エンドポイントはやや特殊なケースだ。Postgres への問い合わせは少なくとも 2 回必要だが、同時に基盤の Durable Objects への長距離呼び出しも 1 回行う。後者はリクエストごとに異なるため、リクエストを世界のどこで実行しても効率が悪くなりうる。だからこそ、最初のリクエストを Postgres の近くへ転送する方を選んでいる。
次のステップは newUniqueId() API でデータベース UUID と新しい一意の Durable Object IDを生成し、新しい Durable Object stub 上で init(options) RPC 関数を呼び出すことだ。Durable Object は情報を自身の永続ストレージに保存し、以降に届くすべてのリクエストが、紐づいたデータベースのメタデータをすべて取得できるようになる。
Edge API Worker が初期化レスポンスを受け取ると、Hyperdrive 経由でデータベースのメタデータを中央の Postgres プライマリに書き込む。1 データベースにつきメタデータ 1 行だ。
以上のステップはリトライループに包まれている(図の第 5〜7 ステップ)。DO の初期化または Postgres への書き込みが失敗した場合、別の ID の組でリトライする(これが重要である理由は次の節で述べる)。
Postgres への書き込みは「チェックポイントの作成」にあたる。最終レスポンスがユーザーに届かなくても、データベースは作成済みとみなされる。この瞬間から、そのデータベースはすべてのコントロールプレーン操作に現れ、Worker にバインドしてクエリを提供できるようになる。
これで D1 データベースはクエリを受け取れる状態になった。
Durable Object への最後の作成確認 RPC は waitUntil() の中に置かれ、失敗しても構わない。この呼び出しは DO にデータベースが有効化されたことを通知し、DO はただちにデータベースのメタデータを Workers KV に更新する。以降のクエリは Workers KV キャッシュから直接情報を読めるようになり、Postgres に問い合わせる必要はなくなる。
よくある疑問は、作成フローをまるごと 1 つの Postgres トランザクションに入れてしまえばもっと簡単なのではないか、というものだ。答えは単純で、スケールしないからだ。Durable Object の初期化中ずっと接続を占有することになるが、その DO は地球の反対側にいるかもしれない。
ハートビートによるデータベースの自己修復
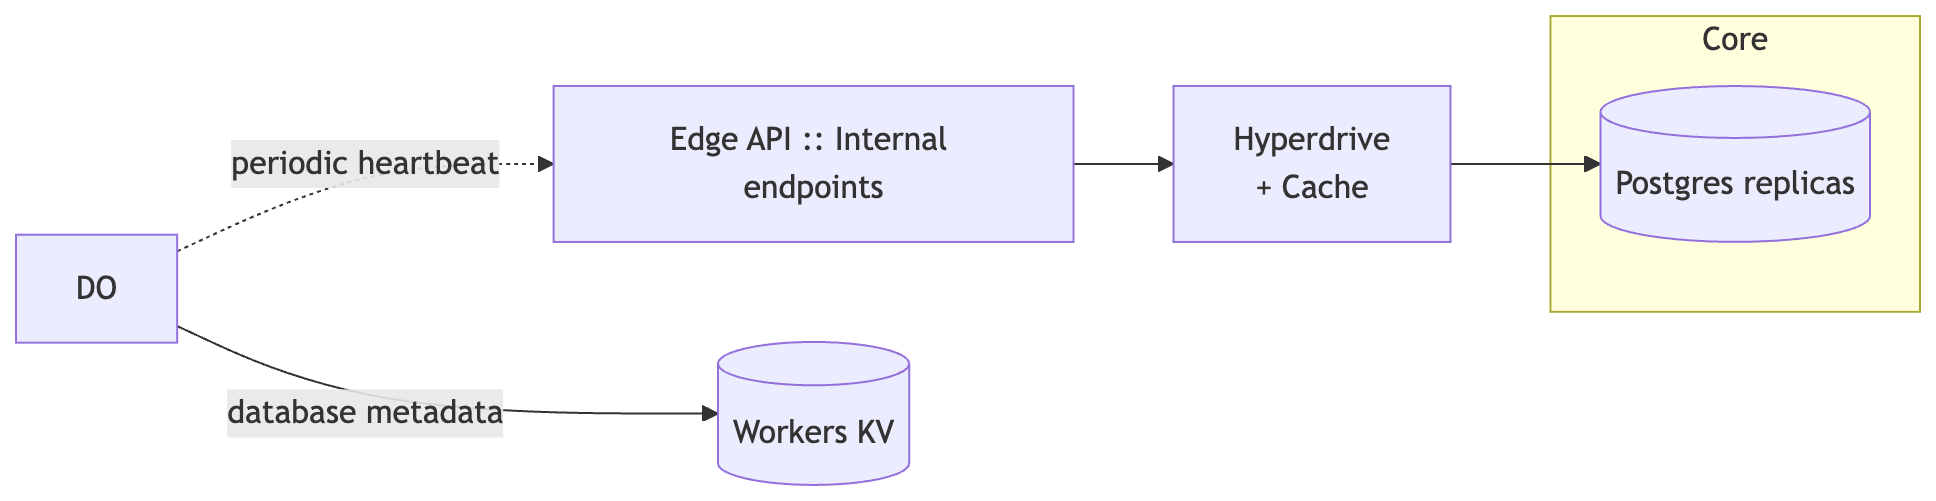
D1 の Durable Object はそれぞれ定期的にコントロールプレーンへハートビートを送信し、最新のデータベース状態(active または deleted)とアカウントの上限(強制適用の詳細は後述)を取得する。送信間隔は 30 秒で、これにデータベースごとに変動する jitter を加える。データベース単位やアカウント単位で間隔を調整したり、ハートビート自体を停止したりするスイッチも用意している。
ハートビートは多少古いデータでも許容する。つまり Hyperdrive の多層キャッシュや Postgres のリードレプリカが応答しても構わない。このハートビート経路があることで、Durable Object は自己修正し、データベースの作成と削除について唯一の信頼できる情報源(Postgres)と整合する。
先に進む前に一点補足する。前節の作成フロー(ステップ 5)で、リトライのたびに異なるデータベース UUID と Durable Object ID を使うのはなぜか。データベース UUID を再利用して Durable Object ID だけを新しくすると、複数の Durable Object が同じデータベースを自分が所有していると認識してしまい、原因究明が難しい問題になる。定期ハートビートは、孤立したオブジェクトのクリーンアップも兼ねている。
また、Durable Object を初期化してからでないと、データベースのマッピングを Postgres に書き込んではいけない。そうしないと、クエリリクエストがすでにこの Durable Object へ流れ始め、状態が未初期化であるために拒否される可能性がある。
たとえば次のような失敗シナリオを考える。なぜ自己修正できるのかを見てほしい。
- 前節のすべてのステップを実行し、Durable Object A の初期化まで終えたところで Postgres への書き込みが失敗する。
- Worker がこのループをリトライし、別の ID B で新しい DO を初期化する。今回は Postgres への書き込みに成功する。
- この時点で、このリクエストは 2 つの Durable Object を初期化して動かしているが、有効なのは片方だけである。
- ユーザーがクエリできるのは Durable Object B だけだ。Postgres に存在する ID はこれだけで、Postgres が唯一の信頼できる情報源だからである。
- 30 秒以内に DO A が次のハートビートをコントロールプレーンへ送信し、「自分のデータベースは存在しない」という応答を受け取る。これがきっかけで DO A は自分自身を deleted とマークする。
削除エンドポイントのフローも同様だ。
ハートビートのもう一つの自己修正的な役割は、Workers KV のデータが最終的に実際の状態——データベースが active か deleted か——を反映するようにすることだ。
作成フローの最後のステップで Workers KV を更新するのは「ベストエフォート」であり、失敗しても問題にはならない。これは結果整合性であり、次に Durable Object がハートビートを送信する際に、Workers KV のエントリへ正しい値が書き込まれることを保証する。Workers KV は結果整合性で整合性読み取りができないため、Durable Object が Workers KV エントリ書き込みの直列化点となる。
削除は同じ流れを逆方向にたどる。Durable Object が自身の「削除済み」状態を Workers KV に書き込む役割を担い、これも実際の削除操作の中でベストエフォートで行われ、失敗してもハートビートが最終的に修正する。Durable Object は自身のストレージにも active または deleted の状態を保持しているので、Workers KV のデータが古くてリクエストを通してしまっても、即座にクエリを拒否または受け入れられる。
まとめると、外部データストアへの書き込みと Durable Object 自身の更新の両方が必要な操作では、データベースハートビートが整合状態へ至るための最後の砦になる。
ホットパスを分離する:クエリを中央データベースに通さない
クエリエンドポイントの核心は、Postgres やその他の集中型・単一リージョンのコンポーネントへのアクセスを避けることにある。HTTP クエリリクエストはすべて、ユーザーの元のリクエスト位置に最も近い場所で Edge API Worker として実行され、その後 Eyeball Worker を経由して D1 Durable Object へ直接到達する。
Edge API Worker は、標準的な HTTP API 認証、リソースベースの認可、アカウントおよびデータベース単位のレート制限、リクエスト検証、アカウント特典の確認、その他 API 関連の機能を処理してから、実際のビジネスロジックを実行する。
一方 Eyeball Worker はこうした追加チェックを省略する(独自のレート制限を除く)。その理由は、下層では D1 Binding が D1 Eyeball Worker を指す Service Binding だからだ。各ユーザー Worker の D1 Binding はエンコードされた情報を運び、特定の D1 データベースへのアクセスを認可する。D1 Eyeball Worker はこの情報を検証してリクエストを通す。
次の図は、HTTP API 経由でクエリを実行する流れを示している。
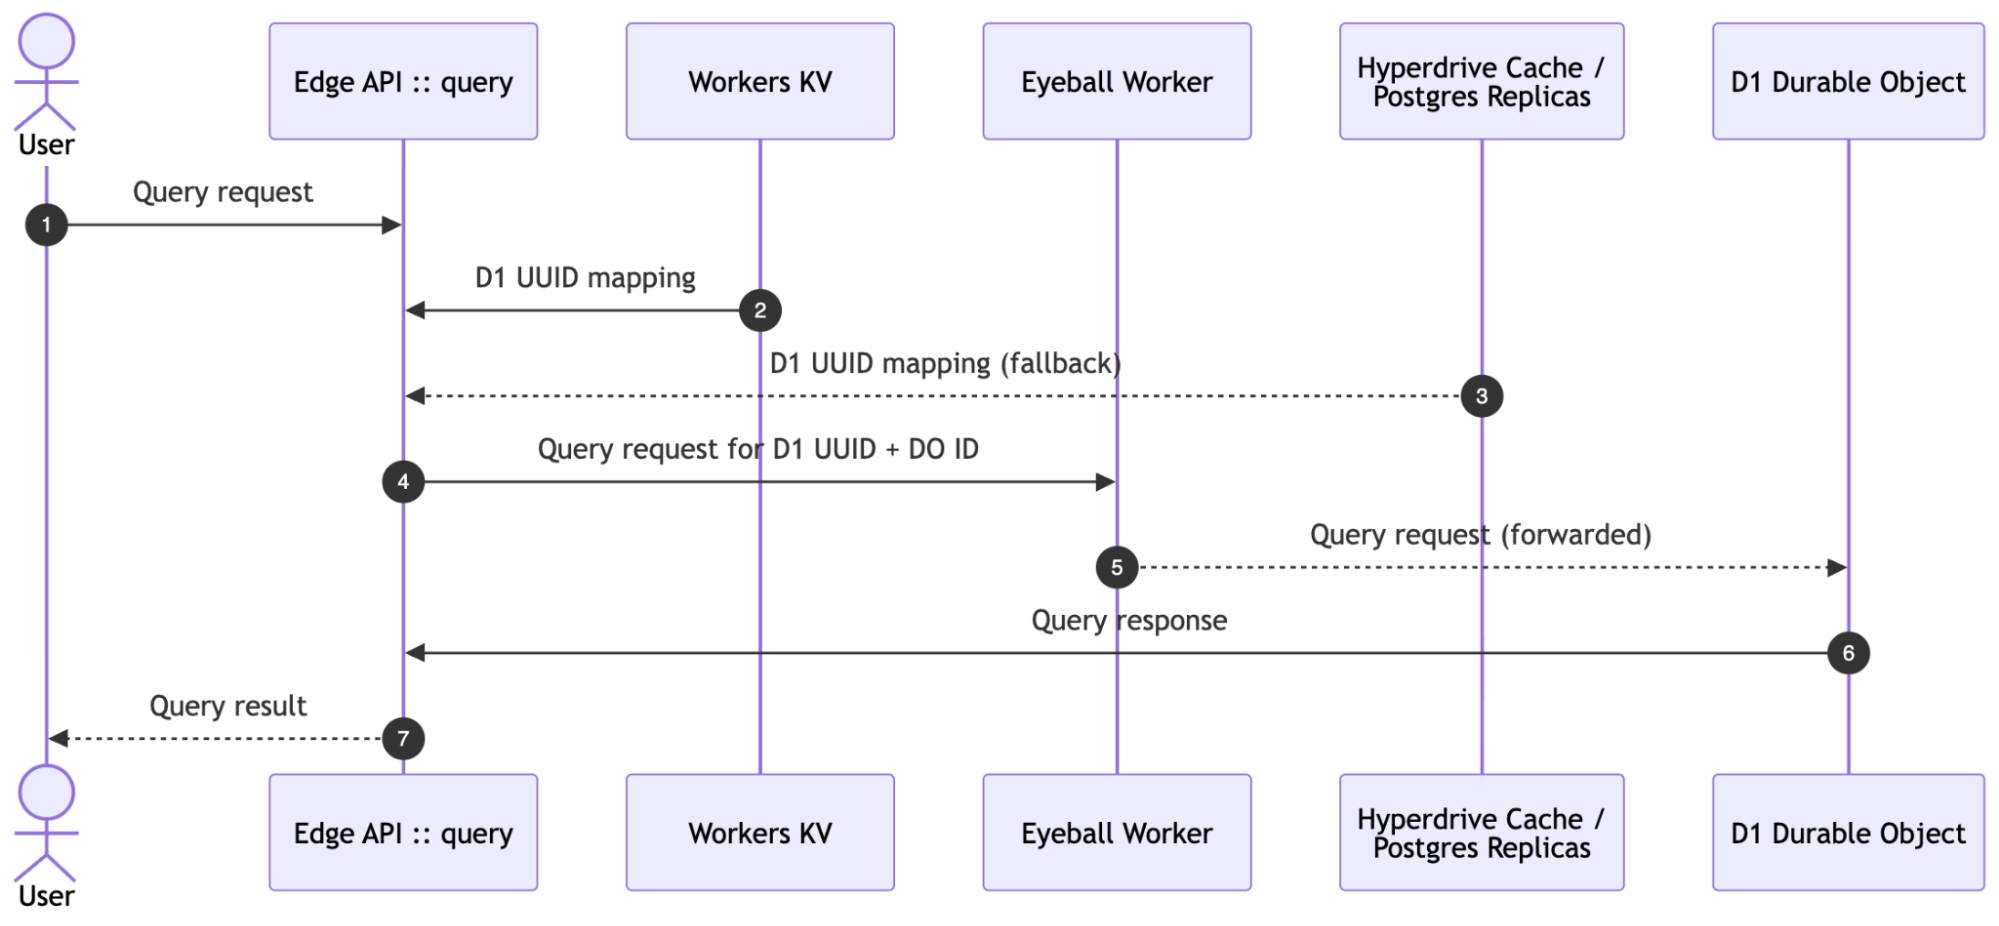
- ユーザーが HTTP API 経由でクエリリクエストを送信する。
- Edge API Worker はまず、Workers KV から D1 UUID とデータベースメタデータのマッピングを読み込もうとする。
- まれに、このエントリが Workers KV に見つからないことがある。原因は前述の書き込み失敗か、可用性の問題だろう。その場合は Hyperdrive 経由で Postgres レプリカからマッピングを読み取ることにフォールバックする。実際のレプリカにクエリを投げる前に、Hyperdrive は呼び出し元のロケーションにあるキャッシュを確認し、次に Postgres クラスタ付近のキャッシュを確認する。どちらにもヒットしなかった場合にのみ、Postgres レプリカへマッピングを問い合わせる。
- マッピングを取得すると、Edge API Worker は Worker Service Bindings 経由で Eyeball Worker を呼び出し、関連する ID を渡す。
- Eyeball Worker が検証を済ませ、クエリリクエストを D1 Durable Object に転送する。
- D1 Durable Object が SQL クエリを実行し、結果を Eyeball Worker 経由で Edge API Worker に返し、これがユーザーに返される。
// Edge API Worker
const parsed = parseQueries(request);

const cachedDB = await withRetries(getCachedDatabase(parsed.dbUuid));

const response = await env.EYEBALL_WORKER.query({
  db: cachedDB,
  queries: parsed.queries,
});

return response;
データベース作成時に newUniqueId() を使い、「名前」で Durable Object をアドレス指定して上の手順 2、3 を省かないのはなぜか。答えは、クエリリクエストの間に「名前」から「Durable Object ID」への中央マッピングへのルックアップ往復を 1 回避けるためだ。Durable Object ID だけでは足りず、Eyeball Worker でどの Durable Object Namespace を使うべきかを決めるには他のメタデータも必要になる。その結果、ルックアップは 1 回ではなく 2 回になる。
ほとんどの場合——私たち自身の多くのアプリケーションにおいてさえ——Durable Object を名前でアドレス指定する方法は十分に機能し、自分の ID から Durable Object ID へのルックアップも省ける。まずはこれを出発点にして、どうしても必要になったときだけ一意の DO ID に切り替えるとよい。
Hyperdrive Caching があるのになぜ Workers KV を使うのか、と思うかもしれない。
Workers KV は単なるキャッシュではなく永続データストアだ。エントリが KV のエッジキャッシュから落ちても、読み取りは KV 自身のストレージが応答し、Postgres には到達しない。Postgres をデータプレーンから締め出せるわけだ。キャッシュが壊滅的に消去された状況で、何百万ものデータベースが一斉に自分のルーティング情報を取りに行けば、メタステーブル障害を引き起こす。
念のため付け加えると、D1 Binding を持つユーザー Worker からのクエリリクエストは D1 UUID マッピングメタデータを解決する必要がない。binding 自体が内部でその情報を保持しているため、リクエストは直接 Eyeball Worker と Durable Object に送られる。
クエリ実行そのものと、Durable Objects が内部でどう実装されているかについては、D1 の読み取りレプリケーションに関する私たちのブログ記事を読んでほしい。すべての詳細を掘り下げて説明している。
次に、D1 を支える非同期フローを見ていこう。
ストレージ使用量制限の強制
一定規模に達したプラットフォームは、最終的に課金と使用量制限の強制が必要になる。執筆時点で、D1 には Free プランでアカウントあたり 5 GB のストレージ制限があり、Workers Paid では 1 TB(リクエストに応じて引き上げ可能)だ。
一般に、使用量制限の強制と課金システムは結果整合性と非同期処理に向いている。次のいくつかのセクションでは、D1 がこうした制限の強制をどう実装しているかを見ていく。
非同期の更新処理にキューを活用する
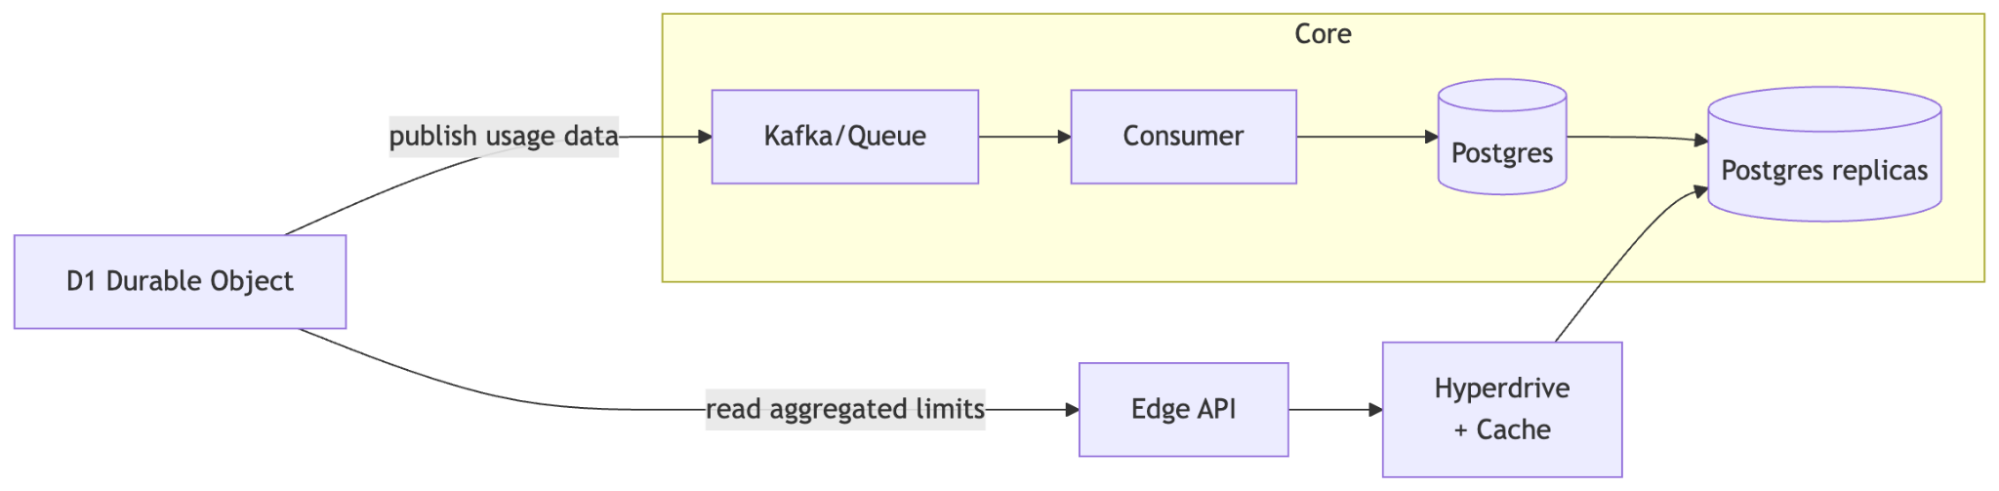
この道のりの最初の一歩は、各 Durable Object がストレージ使用量の更新を Kafka 風のキューに publish し、まとめて非同期に処理できるようにすることだった。コントロールプレーンがすべての更新を同期的に処理する必要はない。負荷のピークがすぐには反映されず、使用量の情報が一時的に遅れても問題ない。大事なのは Postgres を圧迫し、そのあおりで D1 のユーザーに影響が出るのを避けることだ。そこでキューのコンシューマー数を絞り、Postgres への書き込み負荷も抑えた。
キューのコンシューマーは Cloudflare の中央データセンター(「Core」)で動く。一方、Durable Object 自体は世界各地のエッジノードに分散している。使用量はまず各エッジサーバー上でローカルに集計し、その後で内部のキューシステムに publish する。
ここでの原則ははっきりしている。キューでピークをならして書き込みをまとめ、中央リージョンにある Postgres のデータストアに届ける。
使用量の差分のバッチ処理と事前集計
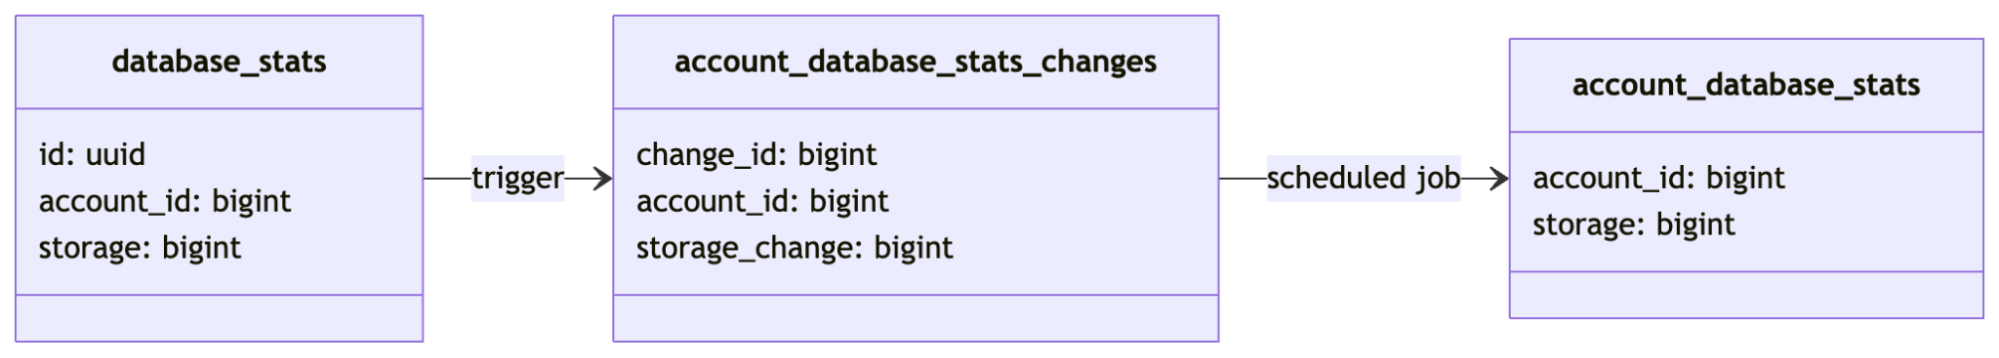
キューコンシューマは、各データベースが最新で報告したサイズを Postgres のテーブルに書き込む。しかし、これだけでは制限を執行する判断には使えない。必要なのはアカウント配下のすべてのストレージ使用量の合計だ。執行のたびに使用量を読みに行くとなると、SELECT sum(storage) FROM database_stats WHERE account_id = ? を走らせるわけにはいかない。このクエリのコストは、アカウントあたりのデータベース数に比例して増える。数百万の D1 データベースを抱えるアカウント——たとえば D1 で作られた agentic coding プラットフォームなど——では、まったく耐えられない。
理想的には、アカウント ID からデータベースのストレージ合計へ直接飛べるルックアップテーブルが欲しい。増分ビュー維護でこの合計をあらかじめ計算し、データベースのストレージが変わったときに更新し続ければよい。
このテーブルを account_database_stats と呼ぶ。
理論上は、キューコンシューマが各更新の到着時に自分で database_stats と account_database_stats を更新することもできる。だが実際にやってみると、大きなアカウントでは同じ行に書き込みロックが集中する。そこで 3 つ目のテーブル account_database_stats_changes を追加した。変更キューとして機能するもので、すべての変更のログであり、1 つのアカウントに複数のレコードが入りうる。そして定期的にこのテーブルの更新を account_database_stats に集約する。流れはこうだ。
- キューコンシューマが、特定のデータベースの使用量情報を
database_statsテーブルに書き込む。 - トリガーがそのデータベースのストレージ量の差分を計算し、その delta を
account_database_stats_changesテーブルに入れる(delta ごとに 1 行)。 - 毎秒走る定期ジョブが
account_database_stats_changesの中身をすべて消費し、それらの delta の合計でaccount_database_statsを更新する。
具体的には、定期ジョブはこのクエリを実行する。
WITH updates AS MATERIALIZED (
  DELETE FROM account_database_stats_changes
  RETURNING *
),
changes AS MATERIALIZED (
  SELECT
    account_id,
    SUM(storage_change) AS storage
  FROM updates
  GROUP BY account_id
)
INSERT INTO account_database_stats (account_id, storage)
SELECT
  account_id,
  storage
FROM changes
ON CONFLICT (account_id) DO UPDATE
SET storage = account_database_stats.storage + EXCLUDED.storage;
account_database_stats_changes から更新のバッチを取得し、アカウントごとに集約して、delta をアカウント別ストレージのテーブルに書き込む。書き込みの前に変更を集約するので、特定の行に書き込み競合は起きない。
Common Table Expression (CTE) DELETE ... RETURNING は保留中の変更をアトミックに消費し、削除した行を次の CTE に渡す。Postgres はデータを変更する CTE を一度だけ、最後まで実行する。クエリはその後、変更をアカウントごとにグループ化し、集約された更新をアカウントごとに一度だけ適用するので、書き込み競合が減る。
この schema 設計は Cloudflare の他の多くのチームが使っているパターンで、これによりアカウントあたり数百万のリソースまでスケールできる。リソースが増えても、よくある操作が高くつくことはない。
この合計は結果整合である点に注意してほしい。一部のデータベースにあるような一級市民としての増分ビュー維護ではない。キューを使って Durable Objects から Postgres へ更新を送っているので、結果整合でまったく問題ない。
Hyperdrive によるキャッシュ読み取り
これでアカウントごとの総ストレージ量のルックアップテーブルができた。次はどうするか。
各 D1 Durable Object は、前述の定期的なハートビートでアカウントの使用量を取得する。SELECT storage FROM account_database_stats WHERE account_id = ? で Postgres をクエリし、結果をアカウントのクォータやプラン上限と比較する。合計が上限を超えていれば、データベースサイズを増やす書き込みをすべて禁止する。
クエリは Hyperdrive を経由して Postgres レプリカへ送られ、Hyperdrive 内蔵のキャッシュを使う。Hyperdrive のキャッシュキーはクエリ文とすべてのパラメータ値で構成され、TTL は数秒だ。パラメータがアカウント ID だけなので、そのアカウント配下のどのデータベースも同じキャッシュ値を共有する。まさに望むとおりの挙動だ。
ここで巧妙なキャッシュの技がある。Hyperdrive 経由のキャッシュ読み取りはデフォルトの TTL が 60 秒で、Hyperdrive のキャッシュ設定 はすべてのクエリに効く。クエリによっては、キャッシュ値の TTL をもっと短くしたい。クエリに dynamic_ttl パラメータを 1 つ足すだけで、X 秒ごとに異なるキャッシュキーが生成され、より早く新しい値を読める。
-- $2 = Math.floor(Date.now() / (X * 1000))
SELECT storage, $2 as dynamic_ttl
FROM account_database_stats WHERE account_id = $1
アカウント ID とデータベース ID をパラメータにしたクエリを書きたくなるかもしれない。そうすればアカウントの合計から現在のデータベースの合計を引ける。これは「制限をかけ始める前に、このデータベースはあとどれだけストレージを使えるか?」という問いに正確な答えを出し、データベースがより早く制限をかけ始めるようになる。
だがそうすると、データベース ID が Hyperdrive のキャッシュキーに含まれ、キャッシュヒット率が極端に下がる。数百万のアクティブなデータベースを持つアカウントでは、アカウント単位のキャッシュキーなら、ほとんどのハートビートが Hyperdrive 内の同じキャッシュ済みアカウント情報にヒットし、Postgres まで届かない。
使用量の変化への反応速度という点では、制限の執行は理論上の限界より少し遅い。だが許容範囲だ。
この流れとは別に、Postgres のストレージ使用量情報を定期的に ClickHouse クラスタへスナップショットし、ストレージが時間とともにどう変化したかの履歴を取るプロセスもある。この ClickHouse のイベントは、ストレージ使用量の課金における権威あるデータ源でもある。
エッジで行数の使用制限を執行する
D1 は無料プランの顧客に対して、1 日あたりの実行使用量の制限も執行する。ここでは別のパターンを使っており、これも触れておく価値がある。
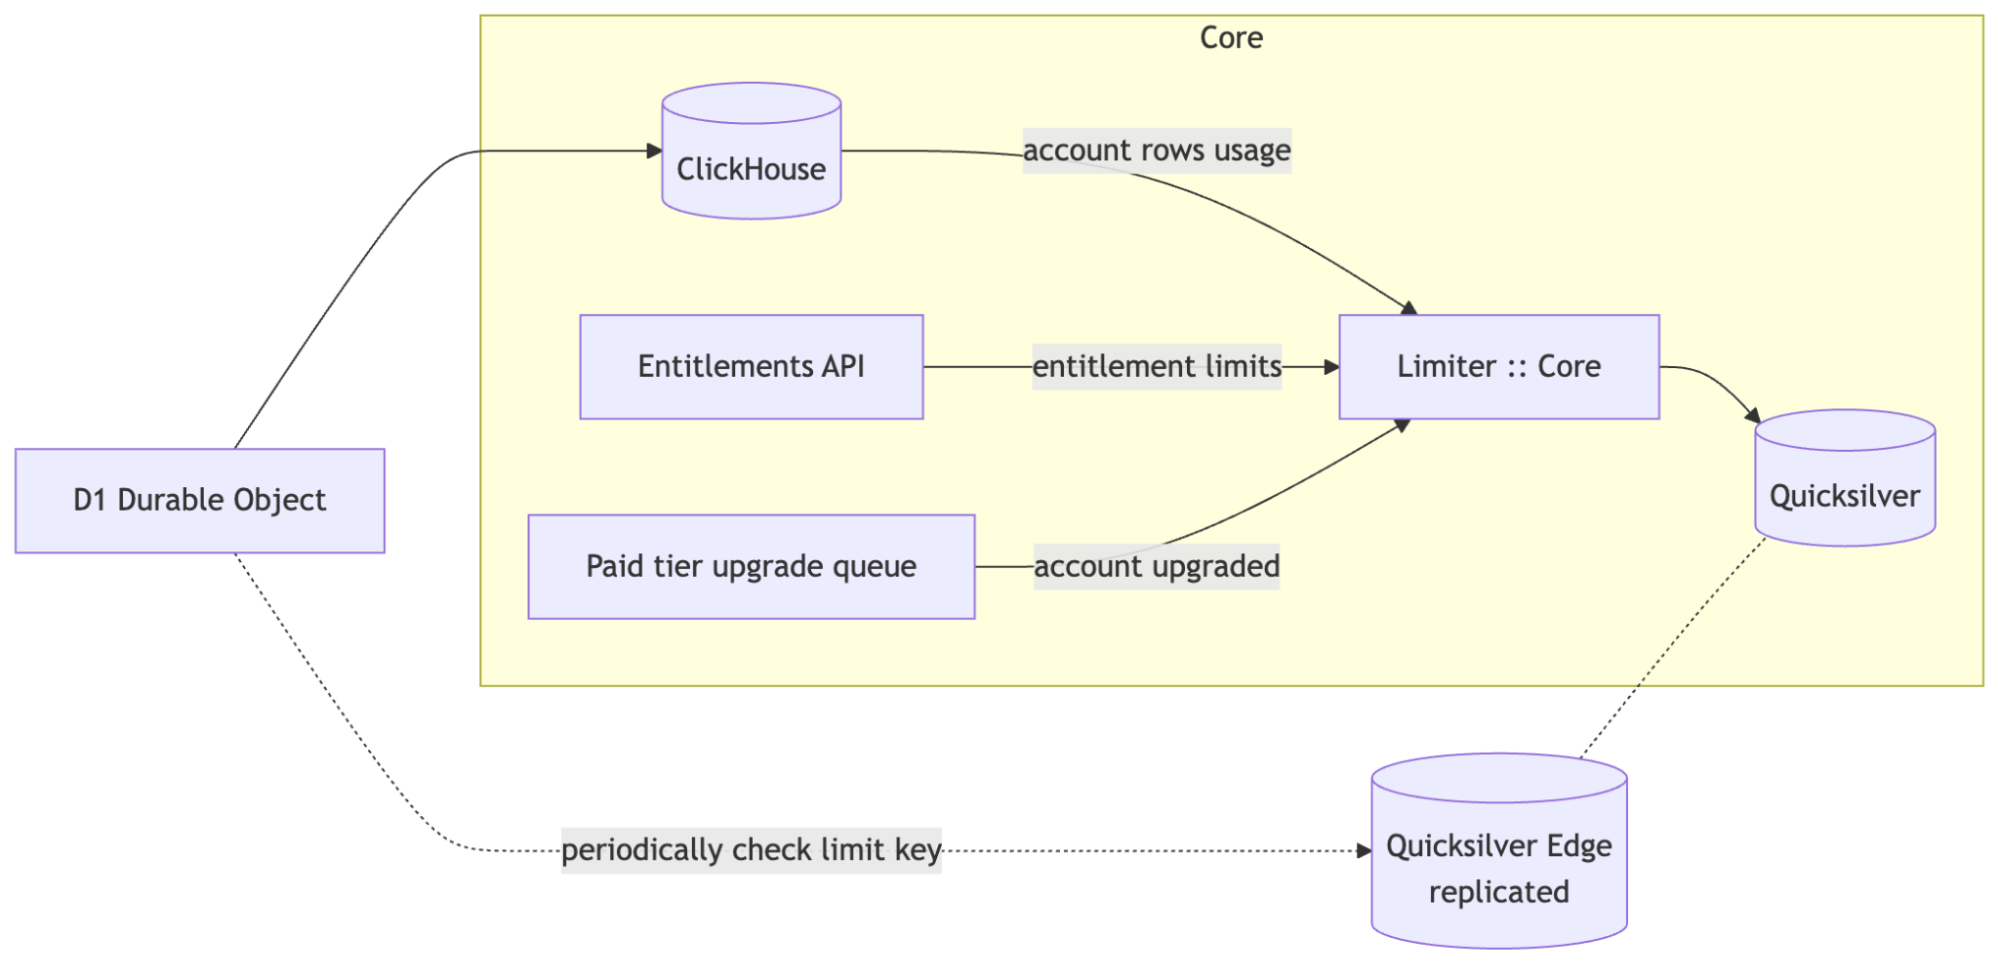
Durable Object で SQL クエリを実行するたびに、そのクエリが読み書きした行数(必要に応じてインデックス更新も)をカウントしている。クエリの実行が完了すると usage event を発行し、それが最終的に別の ClickHouse クラスタへ届く。行数ベースの従量課金は、このイベントによって駆動されている。
中核となるコンポーネント——ここでは「Limiter」と呼ぶ——は Core データセンターで動作しており、定期的に ClickHouse へ問い合わせて、その日の始まり以降の usage events を取得する:
SELECT account_id, sum(rows_read) as reads, sum(rows_written) as writes
FROM requests
WHERE timestamp > toStartOfDay(now())
GROUP BY account_id HAVING reads > ? or writes > ?
ClickHouse はこうしたクエリの処理を Postgres より得意としており、Postgres クラスタに分析クエリの負荷をかける必要もなくなる。
上限を超えたアカウントごとに、entitlements と tier を確認する(この制限は無料プランのユーザーにのみ適用される)。実際に超過していれば、メールを送り(その日中は重複送信しない)、Quicksilver にキーを書き込む。有効期限はその日の終わりに設定する。Quicksilver は社内で使っているグローバル分散キーバリューストアで、レプリケーション遅延はサブ秒だ。アカウントが Workers Paid プランにアップグレードすると、キューからメッセージを受け取り、その Quicksilver キーを削除する。
各 D1 Durable Object は定期的にエッジで Quicksilver を確認し、そのアカウントが制限されているかどうかを判定する。制限中であれば、解除されるまで以降のクエリ実行をすべて拒否する。
Developer Platform で開発するユーザーは、Quicksilver 上に構築された Workers KV Instant を利用できる。
このパターンによって、一連の流れがリージョンの Postgres にまったく負荷をかけずに済み、タスクごとに適切なツールを選べるようになった。分析クエリは Postgres で実行するより ClickHouse のほうが効率的だ。
このパターンは社内ではよく見られるが、ストレージ用量の制限で採用している方法とは異なる。将来的には、他の制限の適用もこのパターンへ移行するかもしれない。
結論
D1 のアーキテクチャは、コントロールプレーンの関心事とホットパス上のクエリ実行を分離するという一つの考え方を軸に設計されている。
どの判断も、私たちの指針に従っている。すなわち、中心リージョンのボトルネックを減らすこと。キャッシュ、リードレプリカ、結果整合性を可能な限り活用して読み取りスループットを水平スケールさせること。タスクごとに適切なデータストアを選ぶこと——トランザクションのメタデータには Postgres、分析には ClickHouse、グローバルに複製するルーティングデータには Workers KV だ。
vibe coding プラットフォームを構築していて、ホスト型 SQLite データベースを高速かつ低コスト、そして信頼性高くユーザーへ提供したいなら、D1 を検討してほしい。
Workers と Developer Platform でアプリを構築しているなら、ここで取り上げたパターンとトレードオフは、D1 が実際の場面で下した判断を反映している。自分のアプリの土台として役立ててほしい。
D1 のドキュメントを読み、D1 Discord チャンネルで何を作ったか教えてほしい!
謝辞
問題のある利用パターンの発見と改善提案に協力してくれた、Cloudflare 内の Databases チームと Hyperdrive チームに感謝する。