底层揭秘,绕开热路径:D1 如何扩展至数百万数据库
Cloudflare 重写了 D1 的控制平面,让它能管理数百万个数据库,同时不把任何相关工作放进查询路径。用到的手段包括 Durable Objects、心跳、队列、预聚合的用量表,以及经 Quicksilver 复制的限流器。
中文
复制
传统数据库架构假设每个应用对应一两个大型数据库集群,通常还要配一套连接池方案。AI 辅助开发和 vibe coding 平台把这一模式彻底翻转,推动应用走向大量小型数据库:每个用户、每个应用、每个预览环境或每个租户一个库。这种模式与 D1 格外契合。D1 是 Cloudflare 基于 SQLite 的托管无服务器数据库,允许你创建数百万个数据库,并且只为实际用量付费。问题随之而来:如何为数百万数据库扩展控制平面,又不让每次查询都穿过中心化瓶颈、因而变慢?为了让 D1 支撑起创建了数百万数据库(其中任意时刻有数十万处于活跃状态)的平台,我们做了大量架构调整。本文深入幕后,拆解 D1 控制平面的工作原理。我们描述的许多架构模式,任何基于 Cloudflare 开发者平台构建的人都可以直接套用。文章也顺带展示了我们是如何构建自己的控制平面的。
数字上的增长
我们开始规划这些改动时,D1 的用量已经在稳步增长,但我们清楚,一旦大型平台开始基于 D1 构建,需要支撑的规模会大得多。到目前为止,情况是这样的。过去一年,D1 的存活(未删除)数据库数量增长了 15 倍,过去两年增长了 65 倍(截至 2026 年 10 月 8 日)。过去一年,每日活跃数据库数量增长了 18 倍(截至 2026 年 10 月 8 日)。只要一个数据库当天执行了至少一次查询,就算作活跃。已经有不少成熟平台在用 D1 构建产品,用的就是所有 Cloudflare 用户都能拿到的同一套工具。
“ChatGPT Sites 让任何人都能把想法变成可分享的体验。D1 为我们的用户提供了一种简单、可扩展的方式,为他们的仪表盘、游戏和工具加上自定义指标、排行榜和评论等功能。”——Jon Abrams,ChatGPT Sites @ OpenAI
在撰写这篇博客所述改动的同时,我们定期针对远高于预期增长的目标做负载测试。这决定了优化工作该往哪里投。
指导性的工程原则
跑在 Cloudflare Developer Platform 上的应用,从全栈应用、服务 API,到内部单用户门户、大规模多租户 vibe coding 平台,中间什么都有。在构建支撑数百万数据库的 D1 控制平面时,以下信条和原则指导了我们的架构决策,对任何在我们平台上构建控制平面和数据平面的人同样适用。
- 设计每个进程时都要考虑故障和幂等性。故障一定会发生,系统需要尽可能自我修正并继续推进。
- 数据平面操作的任何热路径(对我们来说就是所有查询请求)都要避免集中式的单区域组件。
- 关键路由元数据使用 Workers KV 这个全球分布的 KV 存储,这样缓存未命中时只有极少数情况需要查询中心数据库。
- 通过 Hyperdrive 访问中心 Postgres 数据库,以获得高效的连接池以及优化的路由和缓存,并尽可能使用只读副本。
- 定期在数据库中预计算聚合结果,避免在处理用户请求时执行扫描查询。
- 在不需要强一致性的组件之间使用最终一致性和队列,以提高可靠性和可用性。
- 用贴近真实的负载对应用做负载测试,找出瓶颈和低效之处,优先优化这些地方。
我们在内部构建系统时还遵循更多工程原则,但上面这些足够通用,适用于任何在 Cloudflare 上构建的人。接下来的章节将深入介绍 D1 控制平面围绕 D1 数据库生命周期的主要系统组件和流程,并展示如何在真实系统中把这些原则落到实处。
高层架构
先来介绍 D1 的主要组件。
图中还省略了一些箭头和方框,它们对应支撑 D1 的次要流程,但上面这些已经构成了 D1 对外提供的功能集。其余部分会在本文后续的专门章节中展开。
首先,每个 D1 数据库都由一个 SQLite Durable Object 支撑,因此创建数百万个数据库非常容易。
“HTTP API”这一块代表我们所有的 API 入口,包括 Cloudflare dashboard、Wrangler 和 Cloudflare CLI。所有 API 请求都经过 Cloudflare 的边缘网关,由 D1 Edge API Worker 处理。
图中把允许用户对数据库执行 SQL 查询的 HTTP 端点标为“Query endpoints”。其余端点涵盖常规的数据库操作,比如创建、删除、列出数据库,以及导入导出和时间旅行功能,标为“CRUD endpoints”。
CRUD endpoints 通过 Hyperdrive 查询我们核心数据中心(称为“Core”)里的 Postgres 集群。这里有两套配置:一套启用了缓存,指向 Postgres 只读副本;另一套禁用缓存,指向 Postgres 主库。
Edge API Worker 可能会调用 D1 Eyeball Worker(取决于请求类型)。Eyeball Worker 是所有需要由底层 D1 Durable Object(DO)处理的请求的代理。这样一来,所有查询处理逻辑都能放进 Eyeball Worker,包括可观测性、自动重试、错误处理以及其他与查询相关的行为。
Workers KV 充当边缘侧的缓存层,用于读多写少的元数据,所有 D1 Worker 都可以读取。
“Worker Binding”这一块代表所有绑定了 D1 Worker binding 的用户 Worker。来自 D1 Binding 的请求直接发往 D1 Eyeball Worker,后者再把请求转发给支撑该数据库的 Durable Object,并将响应代理回用户 Worker。
用户可以通过两种方式在数据库中执行查询:一种是通过 HTTP API 查询端点,另一种是通过他们使用 D1 Binding 在自己的账户中部署的 Worker。
在运维层面,我们把每个操作归入以下类别之一:
- 数据平面:任何与数据库查询相关的请求;应尽可能快,并且始终在边缘运行。
- 控制平面:任何 HTTP API 操作,或为响应非查询类用户请求而运行的内部流程;它们可以依赖中心化的单区域组件。
- 后台异步平面:任何与分析和计费相关的工作流;可以最终一致,并且可以在任何地方运行。
底层还有很多内容,所以我们来看看关键流程。
靠近用户的快速按需数据库创建
多租户平台和 AI agent 驱动的开发需要以快速、低成本且可靠的方式创建大量数据库实例。
下面是一个用于创建 D1 数据库的 Wrangler 命令示例:
% time wrangler d1 create "demo-01"

✅ Successfully created DB 'demo-01' in region WEUR
...
0.56s user 0.13s system 42% cpu 1.614 total
当用户创建 D1 数据库时,在数据库准备好接收查询之前,需要完成几件事。
- 检查该账户是否还能在免费额度限制或账户限制内创建更多数据库。
- 生成唯一的 D1 数据库 UUID、唯一的 Durable Object ID(newUniqueId()),并使用账户和数据库信息初始化底层 Durable Object(DO)。
- 将新创建数据库的信息持久化到 Postgres 中(每个数据库一行,包括元数据以及到已初始化 Durable Object ID 的映射)。
- 将数据库 ID 到 Durable Object ID 的映射写入 Workers KV(之后由数据平面和查询端点使用)。
我们来看看实际流程,以及在每一步失败时如何恢复。
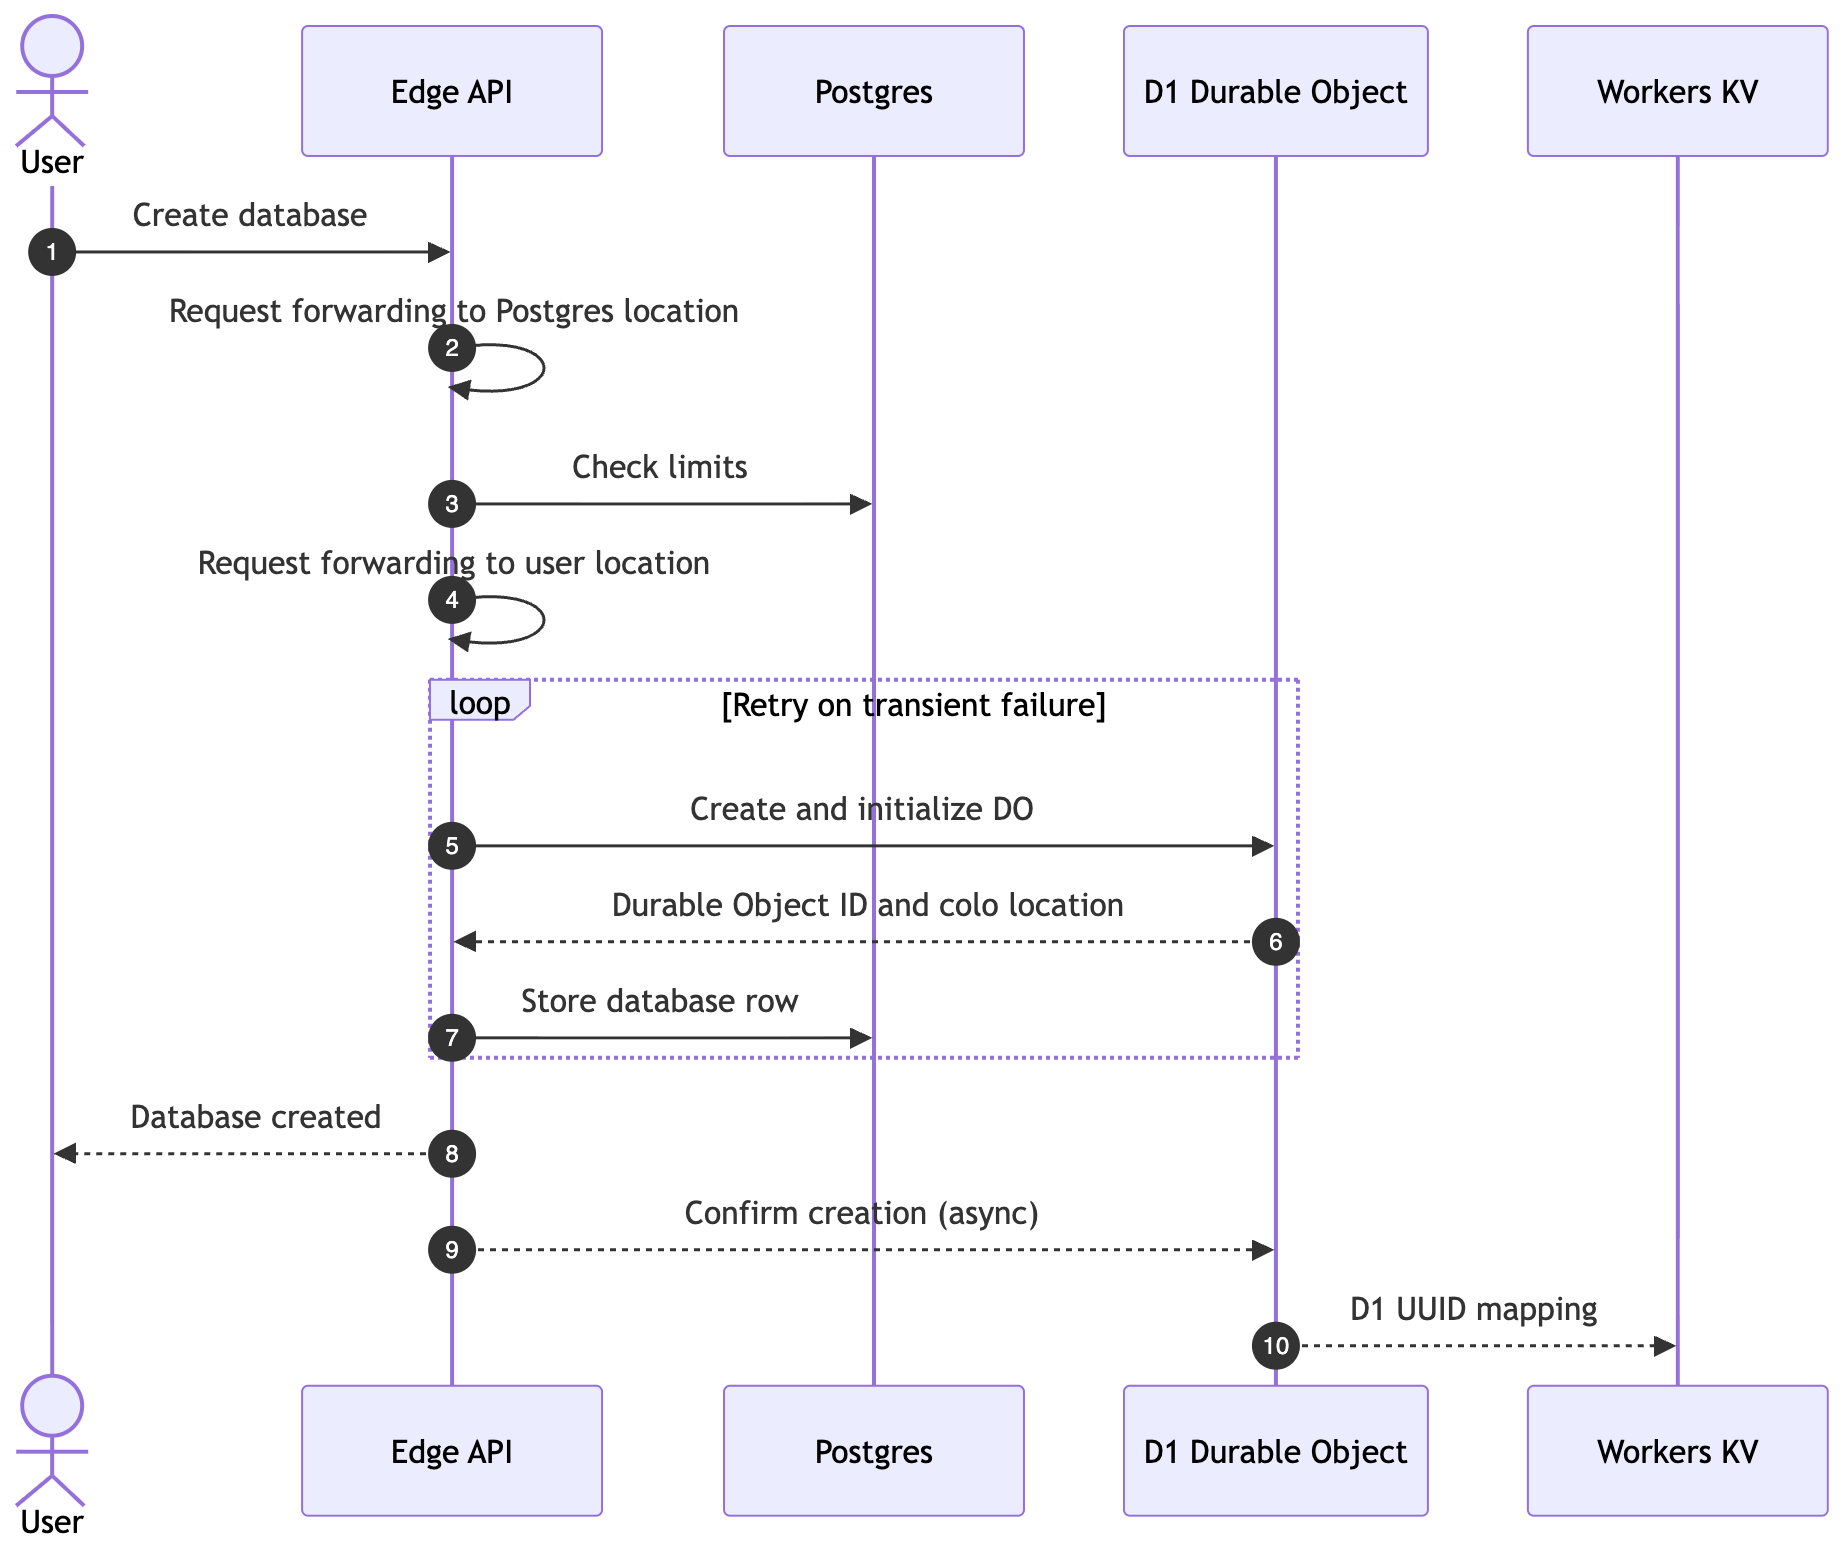
数据库创建请求一进来,我们的 Edge API Worker handler 就会在最近的 Cloudflare 边缘节点被调用。Edge API 通过启用了缓存的 Hyperdrive(缓存 TTL 为几秒)向 Postgres 只读副本查询,得到指定账户下未删除的数据库数量。
对于需要多次往返 Postgres 的端点(第 2 步),Edge API Worker 会把控制平面请求转发到靠近 Postgres 集群的数据中心,“create database”端点就是其中之一。原因是从远处往返一次可能要几百毫秒,而靠近 Postgres 只需几毫秒。对于最多只查一次 Postgres 的端点,我们不需要做这个优化,因为 Hyperdrive 已经通过 Cloudflare 网络处理了高效路由。
不带任何选项创建 D1 数据库时,数据库默认会放在请求所在位置附近。你可以通过提供显式的位置提示或司法管辖区来影响数据库的位置。位置提示和司法管辖区选项与 Durable Objects 支持的完全一致,因此提供之后会直接透传给底层的 Durable Object 初始化。
在默认创建的情况下,我们希望 D1 数据库创建在请求的原始位置附近,靠近用户。为此,在图中第 4 步,我们会在内部把请求的执行转发到靠近原始请求位置的数据中心,并从那里调用底层的 Durable Object。这样就保证了底层 Durable Object 被放置在用户附近。
你可以使用显式的 Worker 放置提示,并在运行时通过 Service Bindings 调用正确的 Worker,来实现类似的路由技巧。
就放置而言,创建端点算是个比较特殊的情况:虽然我们至少要查询 Postgres 两次,但同时还要对底层 Durable Objects 做一次长距离调用,而后者因请求而异,所以把请求放到世界的哪一边执行都可能不够高效。这就是我们倾向于把初始请求转发到靠近 Postgres 的地方的原因。
下一步是使用 newUniqueId() API 生成数据库 UUID 和一个新的唯一 Durable Object ID,并在新的 Durable Object stub 上调用 init(options) RPC 函数。Durable Object 会把信息存入自己的持久化存储,此后每一个进来的请求都能拿到所关联数据库的全部元数据。
Edge API Worker 收到初始化响应后,通过 Hyperdrive 把数据库元数据写入中心的 Postgres 主库,每个数据库一行元数据。
上述步骤包在一个重试循环里(图中第 5-7 步)。当 DO 初始化或写入 Postgres 失败时,我们会换一组 ID 重试(这一点很重要,下一节会讲到)。
写入 Postgres 就是“创建检查点”:即使最终响应没能送达用户,数据库也算已经创建。从这一刻起,该数据库会出现在所有控制面操作中,也可以绑定到某个 Worker 上来提供查询服务。
至此,D1 数据库已经可以接收查询了。
向 Durable Object 发出的最后一次创建确认 RPC 放在 waitUntil() 里,失败也无妨。这个调用会通知 DO 数据库现已激活,DO 随即把数据库元数据更新到 Workers KV,这样后续任何查询都能直接从 Workers KV 缓存读到信息,无需再查 Postgres。
一个常见的问题是:为什么创建流程不干脆整个放进一个 Postgres 事务里,这样不是更简单吗?答案很简单:它撑不起规模,因为那会在 Durable Object 初始化期间一直占着连接,而那个 DO 可能在地球的另一端。
用心跳实现数据库自我修复
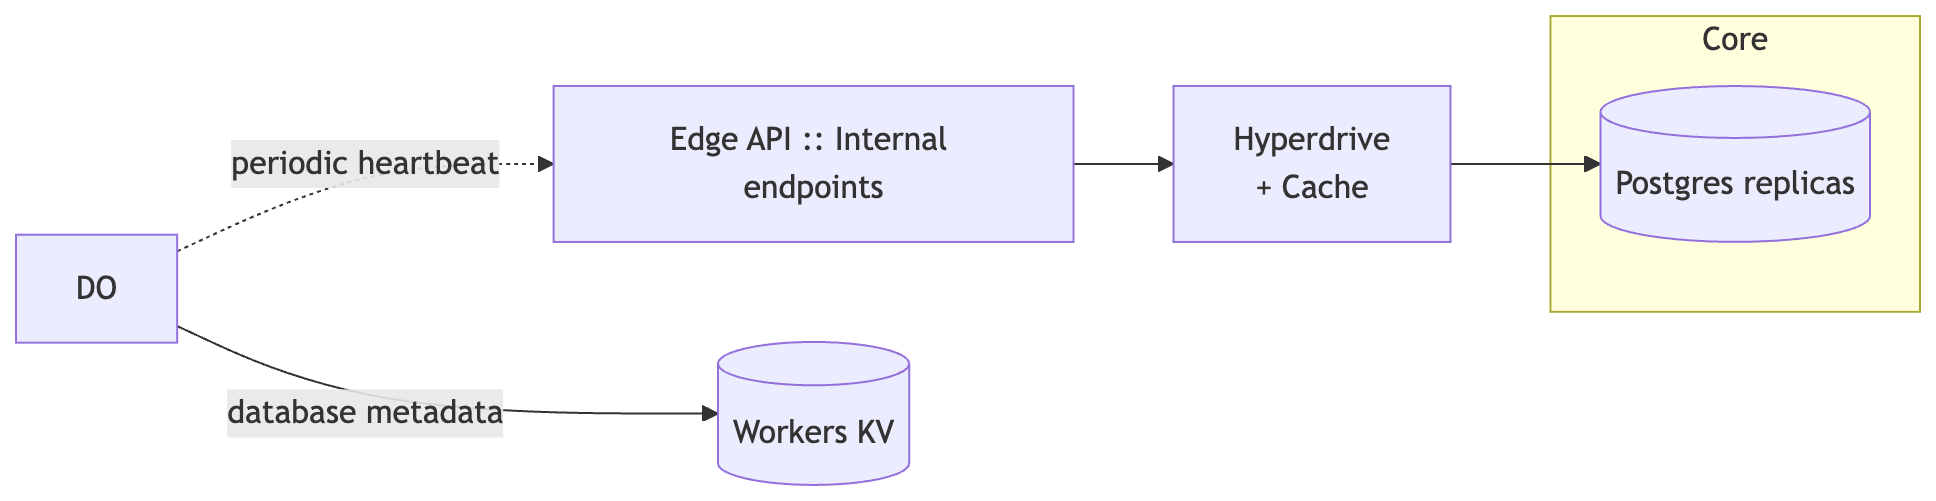
每个 D1 Durable Object 都会定期向控制面发送心跳,以获取最新的数据库状态(active 或 deleted)和账户限额(后面的强制执行部分会详细讲)。间隔是 30 秒,再加上一个按数据库浮动的 jitter。我们也有开关,可以按数据库或账户调整间隔,或者干脆关掉心跳。
心跳可以容忍稍微过期的数据,也就是说,Hyperdrive 的多层缓存或 Postgres 只读副本都可以响应它。这条心跳链路让 Durable Object 能够自我纠正,在数据库的创建和删除上对齐唯一事实来源(Postgres)。
继续之前先澄清一点。上一节的创建流程(第 5 步)中,每次重试都使用不同的数据库 UUID 和 Durable Object ID,原因是:如果复用数据库 UUID 而只换新的 Durable Object ID,就会有多个 Durable Object 认为自己拥有同一个数据库,导致难以排查的问题。定期心跳同时也起到了清理孤儿对象的作用。
另外,必须先初始化 Durable Object,再把数据库映射写入 Postgres,否则查询请求可能已经开始流向这个 Durable Object,并因为状态未初始化而被拒绝。
举个例子,假设出现下面这种失败场景,看看它为什么能自我纠正:
- 我们执行了上一节的所有步骤,直到初始化完 Durable Object A,然后写入 Postgres 失败。
- Worker 重试这个循环,用一个不同的 ID B 初始化了新的 DO,这次成功写入 Postgres。
- 此时这个请求已经初始化并运行了两个 Durable Object,但只有一个是有效的。
- 用户只能查询 Durable Object B,因为 Postgres 里只有这个 ID,而 Postgres 是我们的唯一事实来源。
- 30 秒内,DO A 向控制面发送下一次心跳,收到的响应是它的数据库不存在。这会触发 DO A 把自己标记为 deleted。
删除端点的流程也类似。
心跳的另一种自我纠正行为,是确保 Workers KV 中的数据最终能反映真实状态——数据库是处于活跃还是已删除。
创建流程中最后一步更新 Workers KV 是“尽力而为”的,即使失败也不会造成问题。它是最终一致的,下一次 Durable Object 发送心跳时,会确保 Workers KV 中的条目已写入正确的值。由于 Workers KV 是最终一致的,且无法进行一致性读取,Durable Object 就成了写入 Workers KV 条目的串行化点。
删除则以相反的方向走同样的流程:Durable Object 负责把自身的“已删除”状态写入 Workers KV,同样是在实际删除操作中尽力而为,如果失败,心跳最终会纠正过来。Durable Object 也会在自己的存储中保存活跃或已删除状态,因此它可以立即拒绝或接受查询请求,即使 Workers KV 数据陈旧、放行了请求。
总的来说,当操作既需要写入外部数据存储、又需要更新 Durable Object 自身时,数据库心跳是进入一致状态的兜底机制。
解耦热路径:让查询不经过中心数据库
查询端点的核心原则是避免访问 Postgres 或任何其他集中式、单区域的组件。每个 HTTP 查询请求都会在离用户原始请求位置最近的地方执行 Edge API Worker,然后通过 Eyeball Worker 直接到达 D1 Durable Object。
Edge API Worker 负责标准的 HTTP API 认证、基于资源的授权、账户和数据库级别的限流、请求校验、检查账户权益,以及其他与 API 相关的功能,之后才执行真正的业务逻辑。
而 Eyeball Worker 会跳过这些额外检查(除了它自己专用的限流),因为在底层,D1 Binding 是指向 D1 Eyeball Worker 的 Service Binding。每个用户 Worker 的 D1 Binding 都携带编码信息,授权访问某个特定的 D1 数据库,D1 Eyeball Worker 会校验这些信息并放行请求。
下图展示了通过 HTTP API 执行查询的流程。
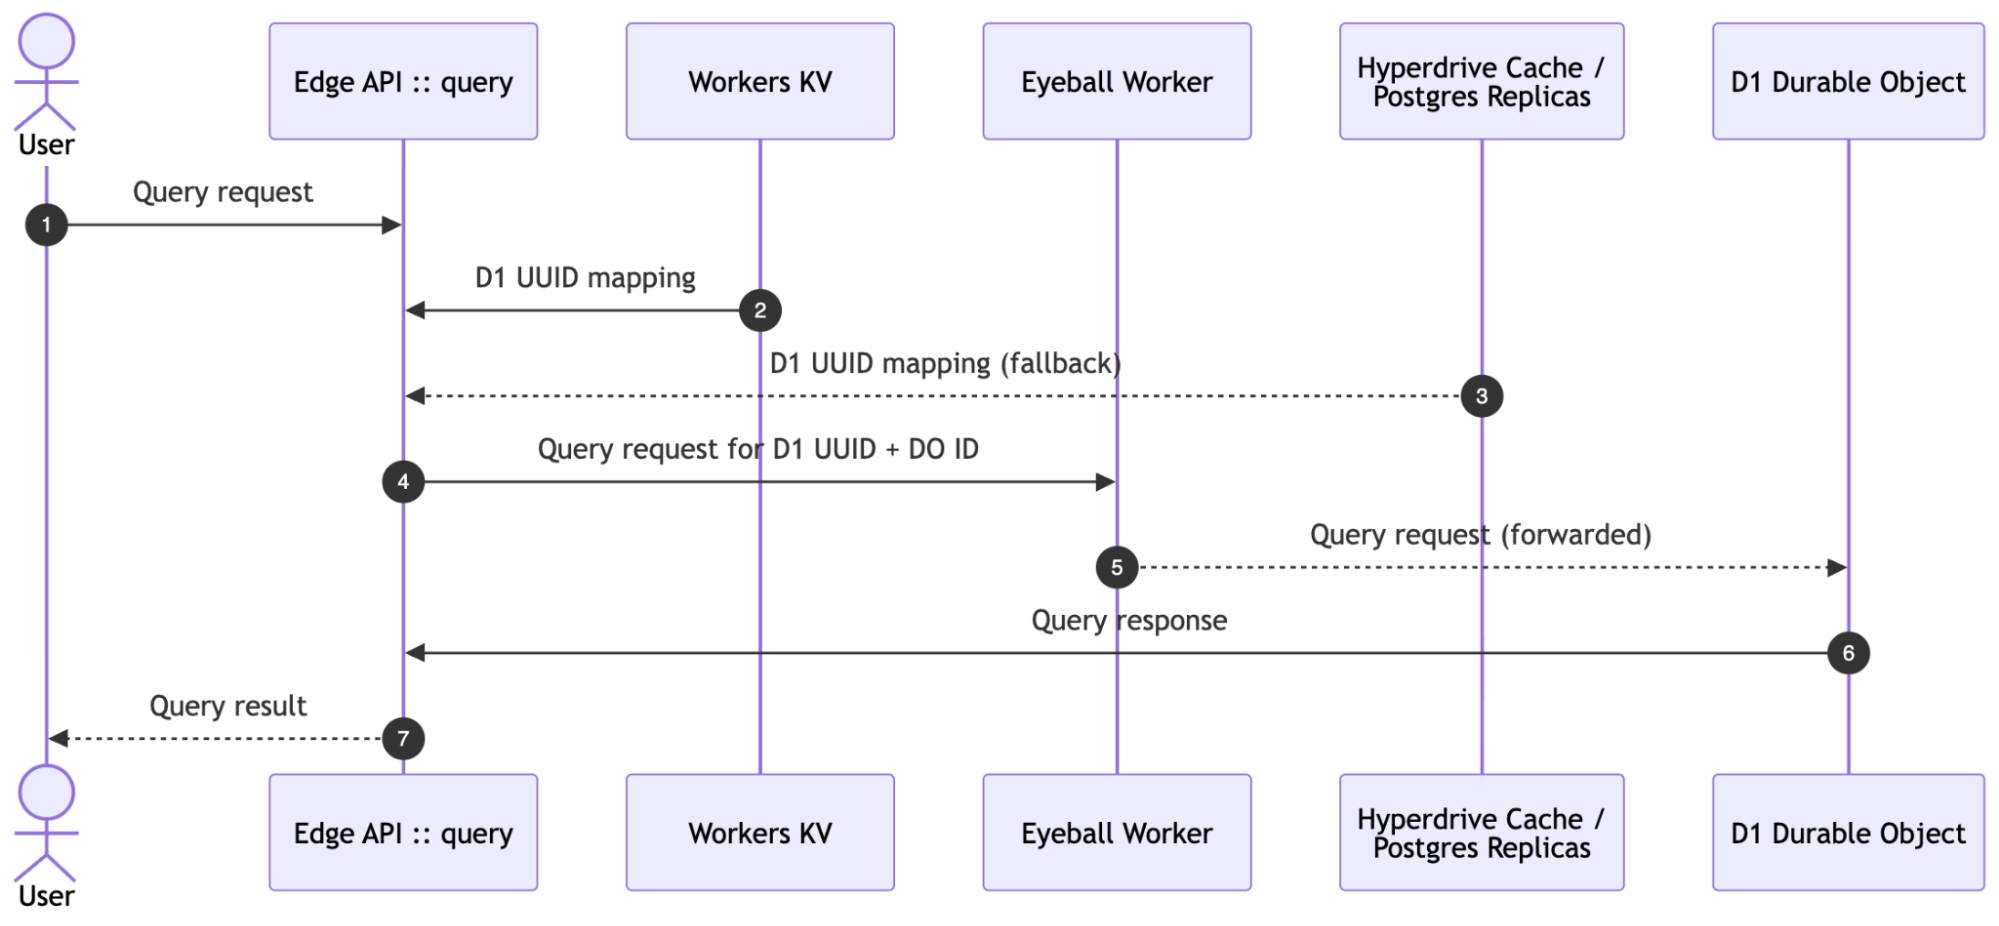
- 用户通过 HTTP API 发送查询请求。
- Edge API Worker 首先尝试从 Workers KV 中加载 D1 UUID 到数据库元数据的映射。
- 少数情况下,Workers KV 中找不到该条目,原因可能是前面提到的写入失败,也可能是可用性问题。此时我们回退到通过 Hyperdrive 从 Postgres 副本读取映射。在查询实际副本之前,Hyperdrive 会先检查调用方所在位置的缓存,再检查 Postgres 集群附近的缓存,只有两处都未命中时,才会向 Postgres 副本查询该映射。
- 拿到映射后,Edge API Worker 通过 Worker Service Bindings 调用 Eyeball Worker,并传入相关 ID。
- Eyeball Worker 完成校验,将查询请求转发给 D1 Durable Object。
- D1 Durable Object 执行 SQL 查询,将结果经 Eyeball Worker 返回给 Edge API Worker,再由后者返回给用户。
// Edge API Worker
const parsed = parseQueries(request);

const cachedDB = await withRetries(getCachedDatabase(parsed.dbUuid));

const response = await env.EYEBALL_WORKER.query({
  db: cachedDB,
  queries: parsed.queries,
});

return response;
如果你想知道为什么我们在创建数据库时使用 newUniqueId(),而不是用“名称”来寻址 Durable Object,从而省掉上面的第 2、3 步,答案是:为了在查询请求期间避免一次到中心映射的查找往返,即从“名称”查到“Durable Object ID”。仅有 Durable Object ID 还不够,我们还需要其他元数据来确定 Eyeball Worker 中该用哪个 Durable Object Namespace。这样一来,一次查找就变成了两次。
在大多数情况下——即便在我们自己的许多应用中也是如此——按名称寻址 Durable Object 都工作得很好,它还省去了从你自己的 ID 到 Durable Object ID 的查找,所以可以以此为起点,只有在不得已时才改用唯一的 DO ID。
你可能还想知道,既然已经有了 Hyperdrive Caching,为什么还要用 Workers KV。
Workers KV 是持久化数据存储,而不只是缓存:如果某个条目从 KV 的边缘缓存中掉出,读取会由 KV 自身的存储来响应,而不是落到 Postgres,从而把 Postgres 挡在数据面之外。在缓存被灾难性清空的情况下,上百万个数据库同时去获取自己的路由信息,会导致亚稳态故障。
提醒一下,来自带有 D1 Binding 的用户 Worker 的查询请求不需要解析 D1 UUID 映射元数据,因为 binding 本身在内部就持有这些信息,所以请求会直接发往 Eyeball Worker 和 Durable Object。
至于查询执行本身,以及 Durable Objects 在底层是如何实现的,请阅读我们关于 D1 读复制的博客文章,里面深入介绍了所有细节。
接下来,我们来看看支撑 D1 的异步流程。
强制执行存储用量限制
所有达到一定规模的平台最终都需要强制执行计费和用量限制。在撰写本文时,D1 在 Free 计划上有每账户 5 GB 的存储限制,在 Workers Paid 上为 1 TB(可应请求提高)。
一般来说,用量限制的执行和计费系统很适合采用最终一致性和异步处理,在接下来的几节中,我们将探讨 D1 如何实现这些限制的执行。
使用队列进行异步更新处理
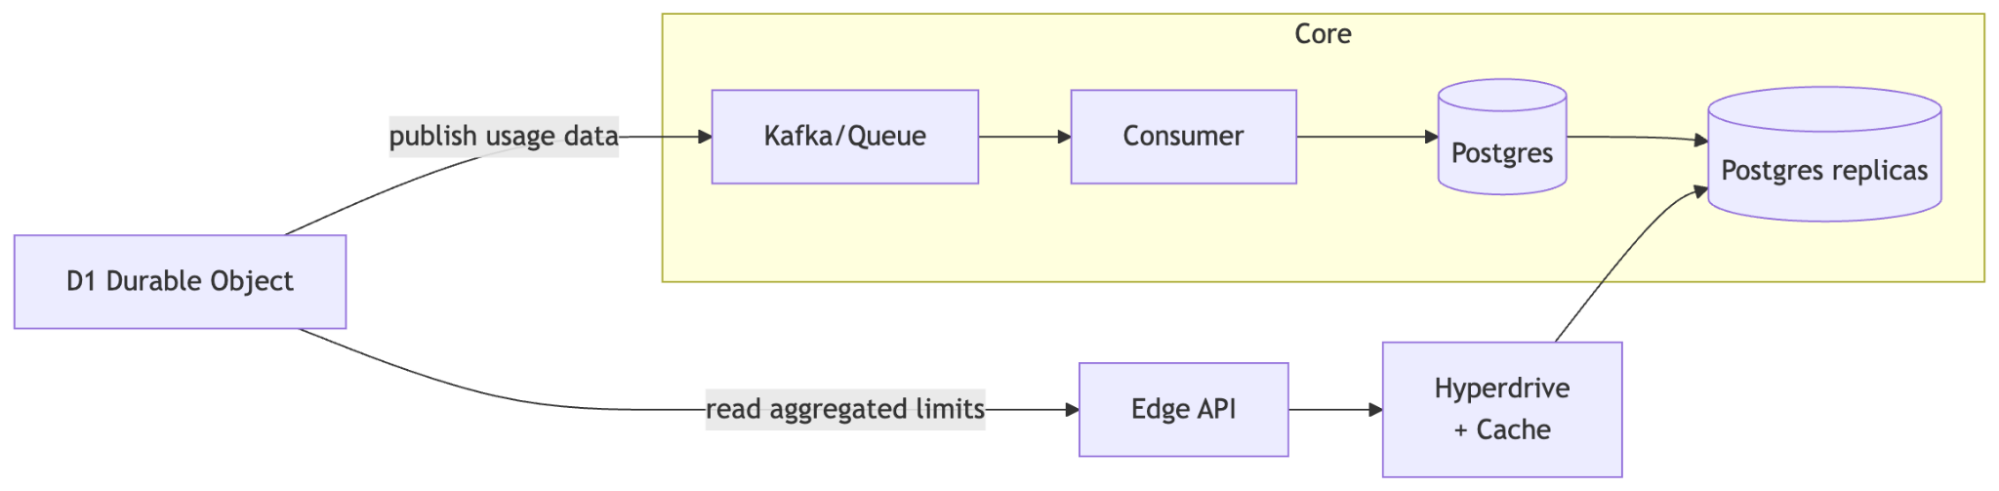
这段旅程的第一步,是让每个 Durable Object 将存储用量更新发布到一个类 Kafka 队列中,以便批量、异步处理。控制平面不需要同步处理每一条更新:负载高峰没有立刻反映出来、用量信息暂时滞后,这都没问题。重要的是不能压垮 Postgres,进而影响 D1 的用户。为此我们限制了队列消费者的数量,从而也限制了 Postgres 的写入负载。
队列消费者系统运行在 Cloudflare 的中央数据中心(“Core”)内,而 Durable Object 本身则分布在全球各地的边缘节点上。用量先在每台边缘服务器上本地聚合,然后再发布到内部队列系统。
这里的原则很明确:用队列来削峰和批量写入,落到我们位于中心区域的 Postgres 数据存储上。
批量处理用量增量与预聚合
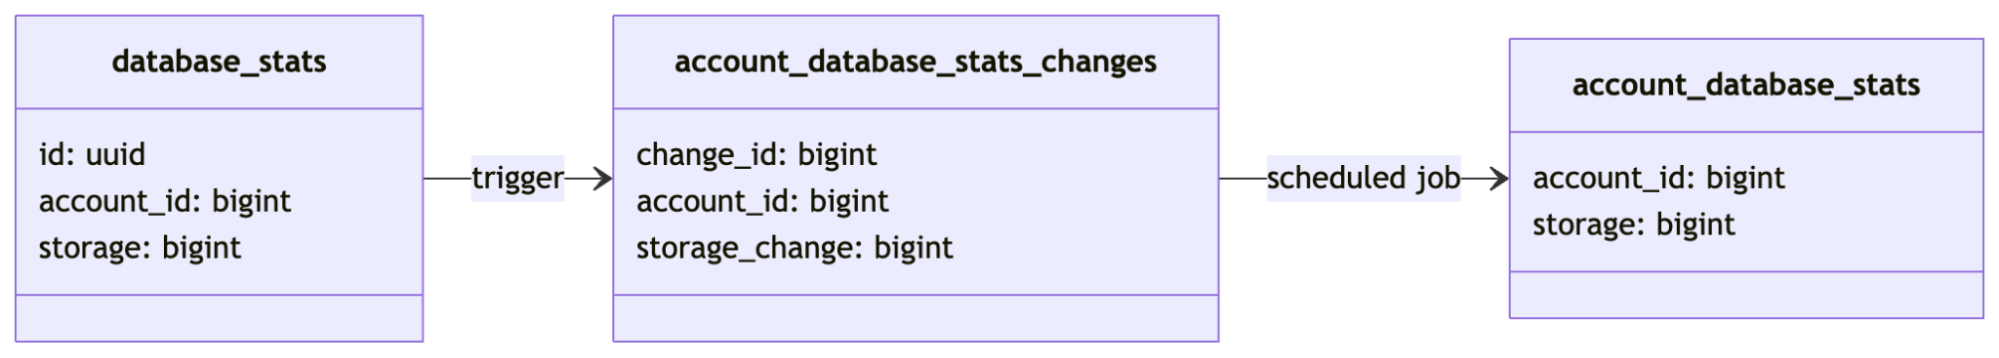
队列消费者会把每个数据库最新上报的大小写入一张 Postgres 表。但这并不是执行决策所需要的东西。做执行决策时,我们需要的是整个账户下所有存储用量的总和。等到执行时再去读取用量,我们不可能去跑 SELECT sum(storage) FROM database_stats WHERE account_id = ?。这个查询的开销会随每个账户上数据库的数量线性增长。对于拥有数百万个 D1 数据库的账户来说,这根本撑不住,比如一些用 D1 构建的 agentic coding 平台。
理想情况下,我们需要一张查找表,能直接从账户 ID 跳到数据库存储总量。办法是用增量视图维护来预先算出这个总量,并在数据库存储发生变化时保持更新。
我们把这张表叫做 account_database_stats。
理论上,我们可以让队列消费者在每一条更新到来时,自己去更新 database_stats 和 account_database_stats。但实际做下来,对于大账户,这会在同一行上造成大量写锁争用。于是我们加了第三张表 account_database_stats_changes,它起到变更队列的作用。这是一份所有变更的日志,每个账户可以有多条记录。然后我们定期把这张表里的更新聚合进 account_database_stats。流程是这样的:
- 队列消费者把某个具体数据库的用量信息写入
database_stats表。 - 一个触发器算出该数据库存储量的差值,把这个 delta 放进
account_database_stats_changes表(每个 delta 一行)。 - 一个定时任务每秒运行一次,消费掉
account_database_stats_changes里的所有内容,并用这些 delta 的总和更新account_database_stats。
具体来说,定时任务执行的是这个查询:
WITH updates AS MATERIALIZED (
  DELETE FROM account_database_stats_changes
  RETURNING *
),
changes AS MATERIALIZED (
  SELECT
    account_id,
    SUM(storage_change) AS storage
  FROM updates
  GROUP BY account_id
)
INSERT INTO account_database_stats (account_id, storage)
SELECT
  account_id,
  storage
FROM changes
ON CONFLICT (account_id) DO UPDATE
SET storage = account_database_stats.storage + EXCLUDED.storage;
它从 account_database_stats_changes 拿到一批更新,按账户聚合,然后把 delta 写入按账户存储的表。这样就不会在任何特定行上产生写争用,因为我们在写入之前先把变更聚合了。
Common Table Expression (CTE) DELETE ... RETURNING 会原子性地消费掉待处理的变更,并把删除的行传给下一个 CTE。Postgres 对修改数据的 CTE 只会执行一次,且会执行到底。查询随后按账户对这些变更分组,每个账户只应用一次聚合后的更新,从而减少写争用。
这种 schema 设计是 Cloudflare 许多其他团队都在用的模式,它让我们能够扩展到每个账户数百万个资源,而新增资源不会让常见操作变得更昂贵。
需要注意的是,这个总数是最终一致的。它不像某些数据库里那种一等公民式的增量视图维护。我们已经用队列把更新从 Durable Objects 送进 Postgres,所以最终一致对我们来说完全可以接受。
通过 Hyperdrive 缓存读取
现在每个账户的总存储量都有了一张查找表。接下来呢?
每个 D1 Durable Object 会通过前面提到的周期性心跳,定期获取账户的用量。我们用 SELECT storage FROM account_database_stats WHERE account_id = ? 查询 Postgres,把结果与账户的配额和套餐上限做比较。如果总数超限,我们就禁止所有会增加数据库大小的写入。
查询经由 Hyperdrive 发往 Postgres 副本,并使用 Hyperdrive 内置的缓存。Hyperdrive 的缓存键由查询语句和所有参数值组成,过期时间(TTL)为几秒。由于只用账户 ID 作为参数,该账户下的每个数据库都会共享同一个缓存值,这正是我们想要的。
接下来是一个巧妙的缓存技巧。通过 Hyperdrive 进行的缓存读取默认过期时间为 60 秒,而 Hyperdrive 缓存配置 会作用于所有查询。对于某些查询,我们希望缓存值的过期时间更短。只要在查询里加一个 dynamic_ttl 参数,就能每 X 秒生成一个不同的缓存键,从而更早读到新值。
-- $2 = Math.floor(Date.now() / (X * 1000))
SELECT storage, $2 as dynamic_ttl
FROM account_database_stats WHERE account_id = $1
你可能会想写一个以账户 ID 和数据库 ID 为参数的查询。这样就能查出账户总量,再减去当前数据库的总量。对于“在开始执行限制之前,这个数据库还能用多少存储空间?”这个问题,这会给出精确答案,从而让数据库更早开始执行限制。
如果这样做,数据库 ID 就会被纳入 Hyperdrive 的缓存键,导致缓存命中率极低。对于拥有数百万个活跃数据库的账户,以账户为单位的缓存键意味着大多数心跳都会命中 Hyperdrive 中同一份缓存的账户信息,根本不会到达 Postgres。
就对应使用量变化的反应速度而言,限额执行比理论上能做到的略慢,但这是可以接受的。
在上述流程之外,我们还有一个进程,会定期把 Postgres 中的存储使用量信息快照到 ClickHouse 集群,以便获得存储随时间变化的历史视图。这些 ClickHouse 事件也是存储用量计费的权威数据来源。
在边缘执行行数使用限额
D1 还会对免费套餐客户执行每日执行用量限额。这里采用的模式有所不同,同样值得一提。
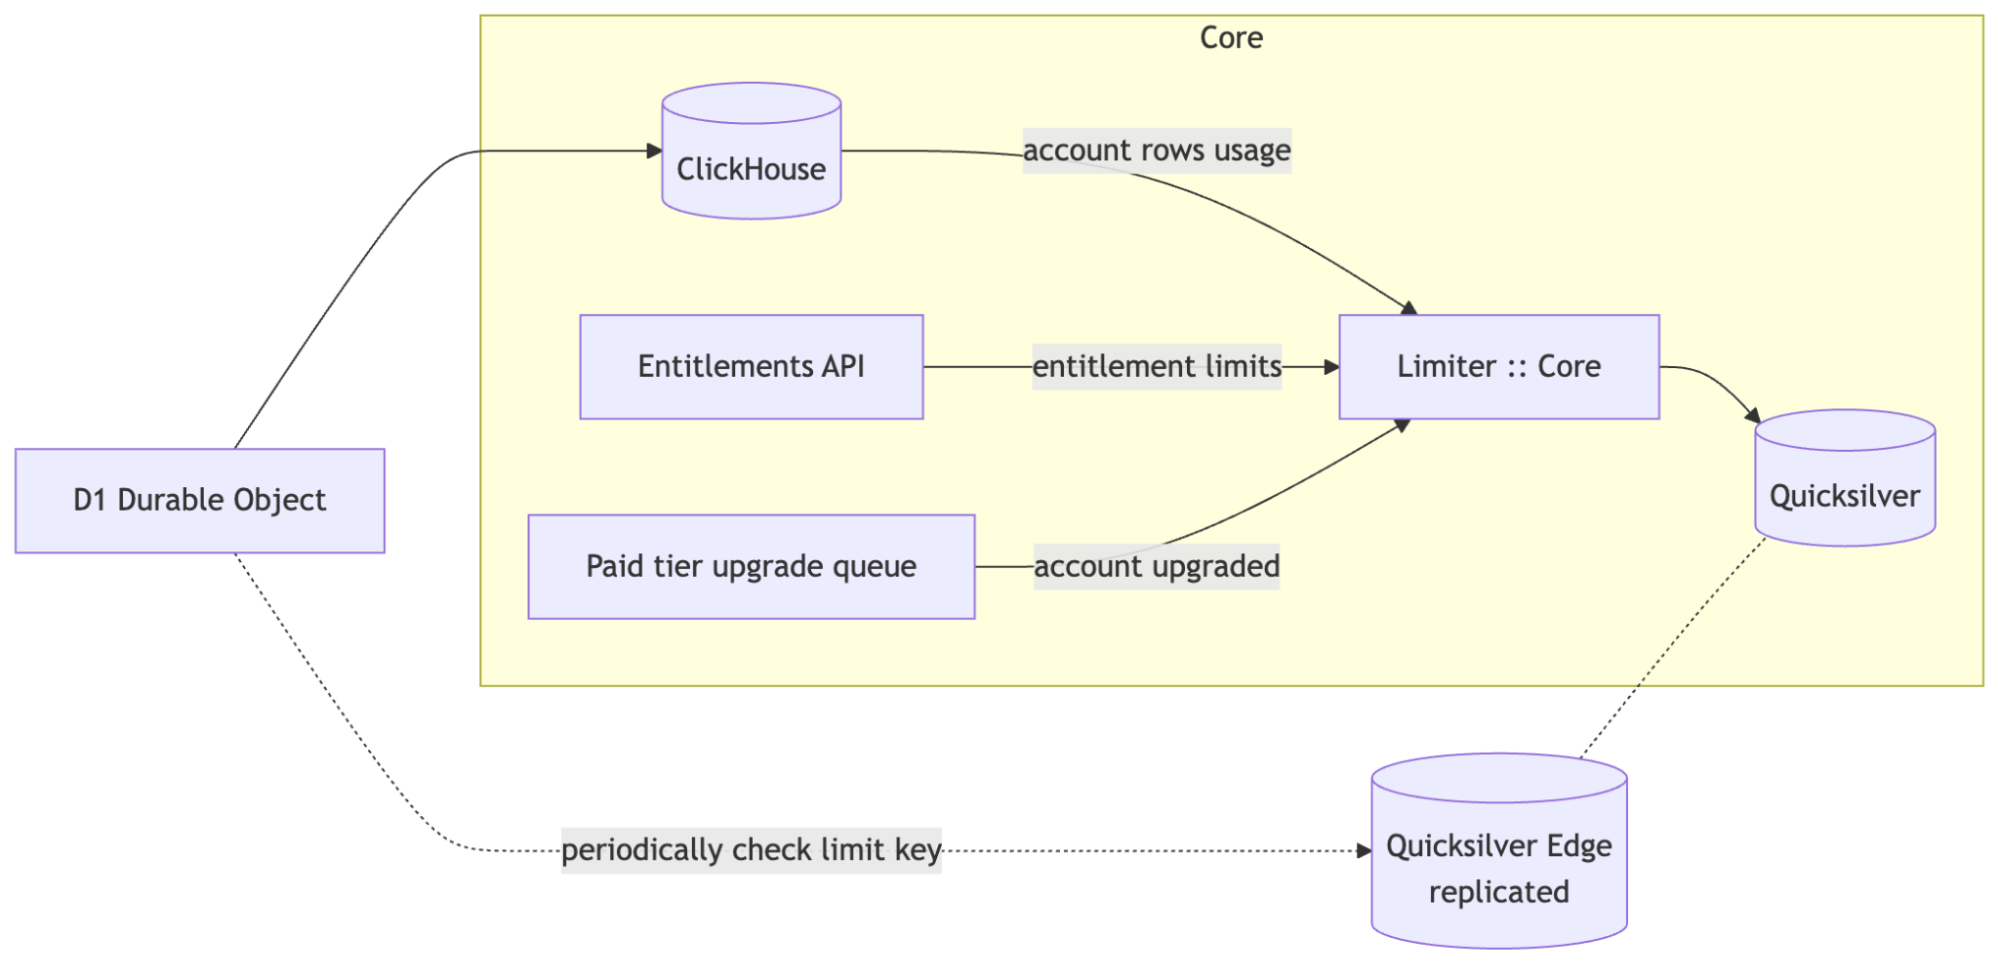
在 Durable Object 中执行任何 SQL 查询时,我们都会统计该查询读取和写入的行数(必要时还包括索引更新)。查询执行完成后,我们会发布一个 usage event,最终进入另一个 ClickHouse 集群。基于行数的用量计费正是由这些事件驱动的。
一个核心组件——姑且称之为 “Limiter”——运行在我们的 Core 数据中心,它会定期从 ClickHouse 查询当天开始以来的 usage events:
SELECT account_id, sum(rows_read) as reads, sum(rows_written) as writes
FROM requests
WHERE timestamp > toStartOfDay(now())
GROUP BY account_id HAVING reads > ? or writes > ?
ClickHouse 处理这类查询比 Postgres 更擅长,同时我们也不必让 Postgres 集群承受分析型查询的额外负担。
对于每个超限的账户,我们会检查其 entitlements 和 tier(此限制仅适用于免费版用户)。如果确实超限,我们会给他们发邮件(当天去重),并在 Quicksilver 中写入一个 key,过期时间设在当天结束。Quicksilver 是我们内部的全局分布式键值存储,复制延迟在亚秒级。如果账户升级到 Workers Paid 套餐,我们会从队列收到一条消息,然后清除该 Quicksilver key。
每个 D1 Durable Object 会定期在边缘检查 Quicksilver,确认所属账户是否已被限流;如果已被限流,则拒绝后续任何查询执行,直到限制解除。
在 Developer Platform 上开发的用户可以使用 Workers KV Instant,它构建在 Quicksilver 之上。
这套模式让整个流程不会给区域级 Postgres 带来任何负载,也为每项任务选用了合适的工具。用 ClickHouse 做分析查询比在 Postgres 里做更高效。
这种模式在公司内部很常见,但与我们在存储用量限制上采用的方式不同。未来,我们可能会把其他限制的执行也迁移到这套模式上。
结论
D1 的架构围绕一个核心思路设计:将控制平面的关注点与热路径上的查询执行分开。
每一个决策都遵循我们的指导原则:减少中心区域瓶颈;尽可能借助缓存、只读副本以及最终一致性来横向扩展读吞吐;为每项任务选择合适的数据存储——事务性元数据用 Postgres,分析用 ClickHouse,全局复制的路由数据用 Workers KV。
如果你正在构建一个 vibe coding 平台,希望以快速、低成本且可靠的方式为用户提供托管 SQLite 数据库,可以考虑使用 D1。
如果你在 Workers 和 Developer Platform 上构建应用,这里讨论的模式与取舍反映了 D1 在真实场景中做出的决策。可以把它们作为你自己应用的基础。
查看 D1 的文档,并在 D1 Discord 频道告诉我们你构建了什么!
致谢
非常感谢 Cloudflare 内部的 Databases 和 Hyperdrive 团队,他们帮助我们发现了有问题的使用模式并提出了改进建议。