Docker サンドボックスとコンテナ:主な違い
コンテナはホストのカーネルを共有する。Docker Sandbox は独自のカーネルを持つ microVM で、マシン全体を必要としながら、そのマシンに触れさせてはならないコーディングエージェントのために設計されている。
日本語
コピー
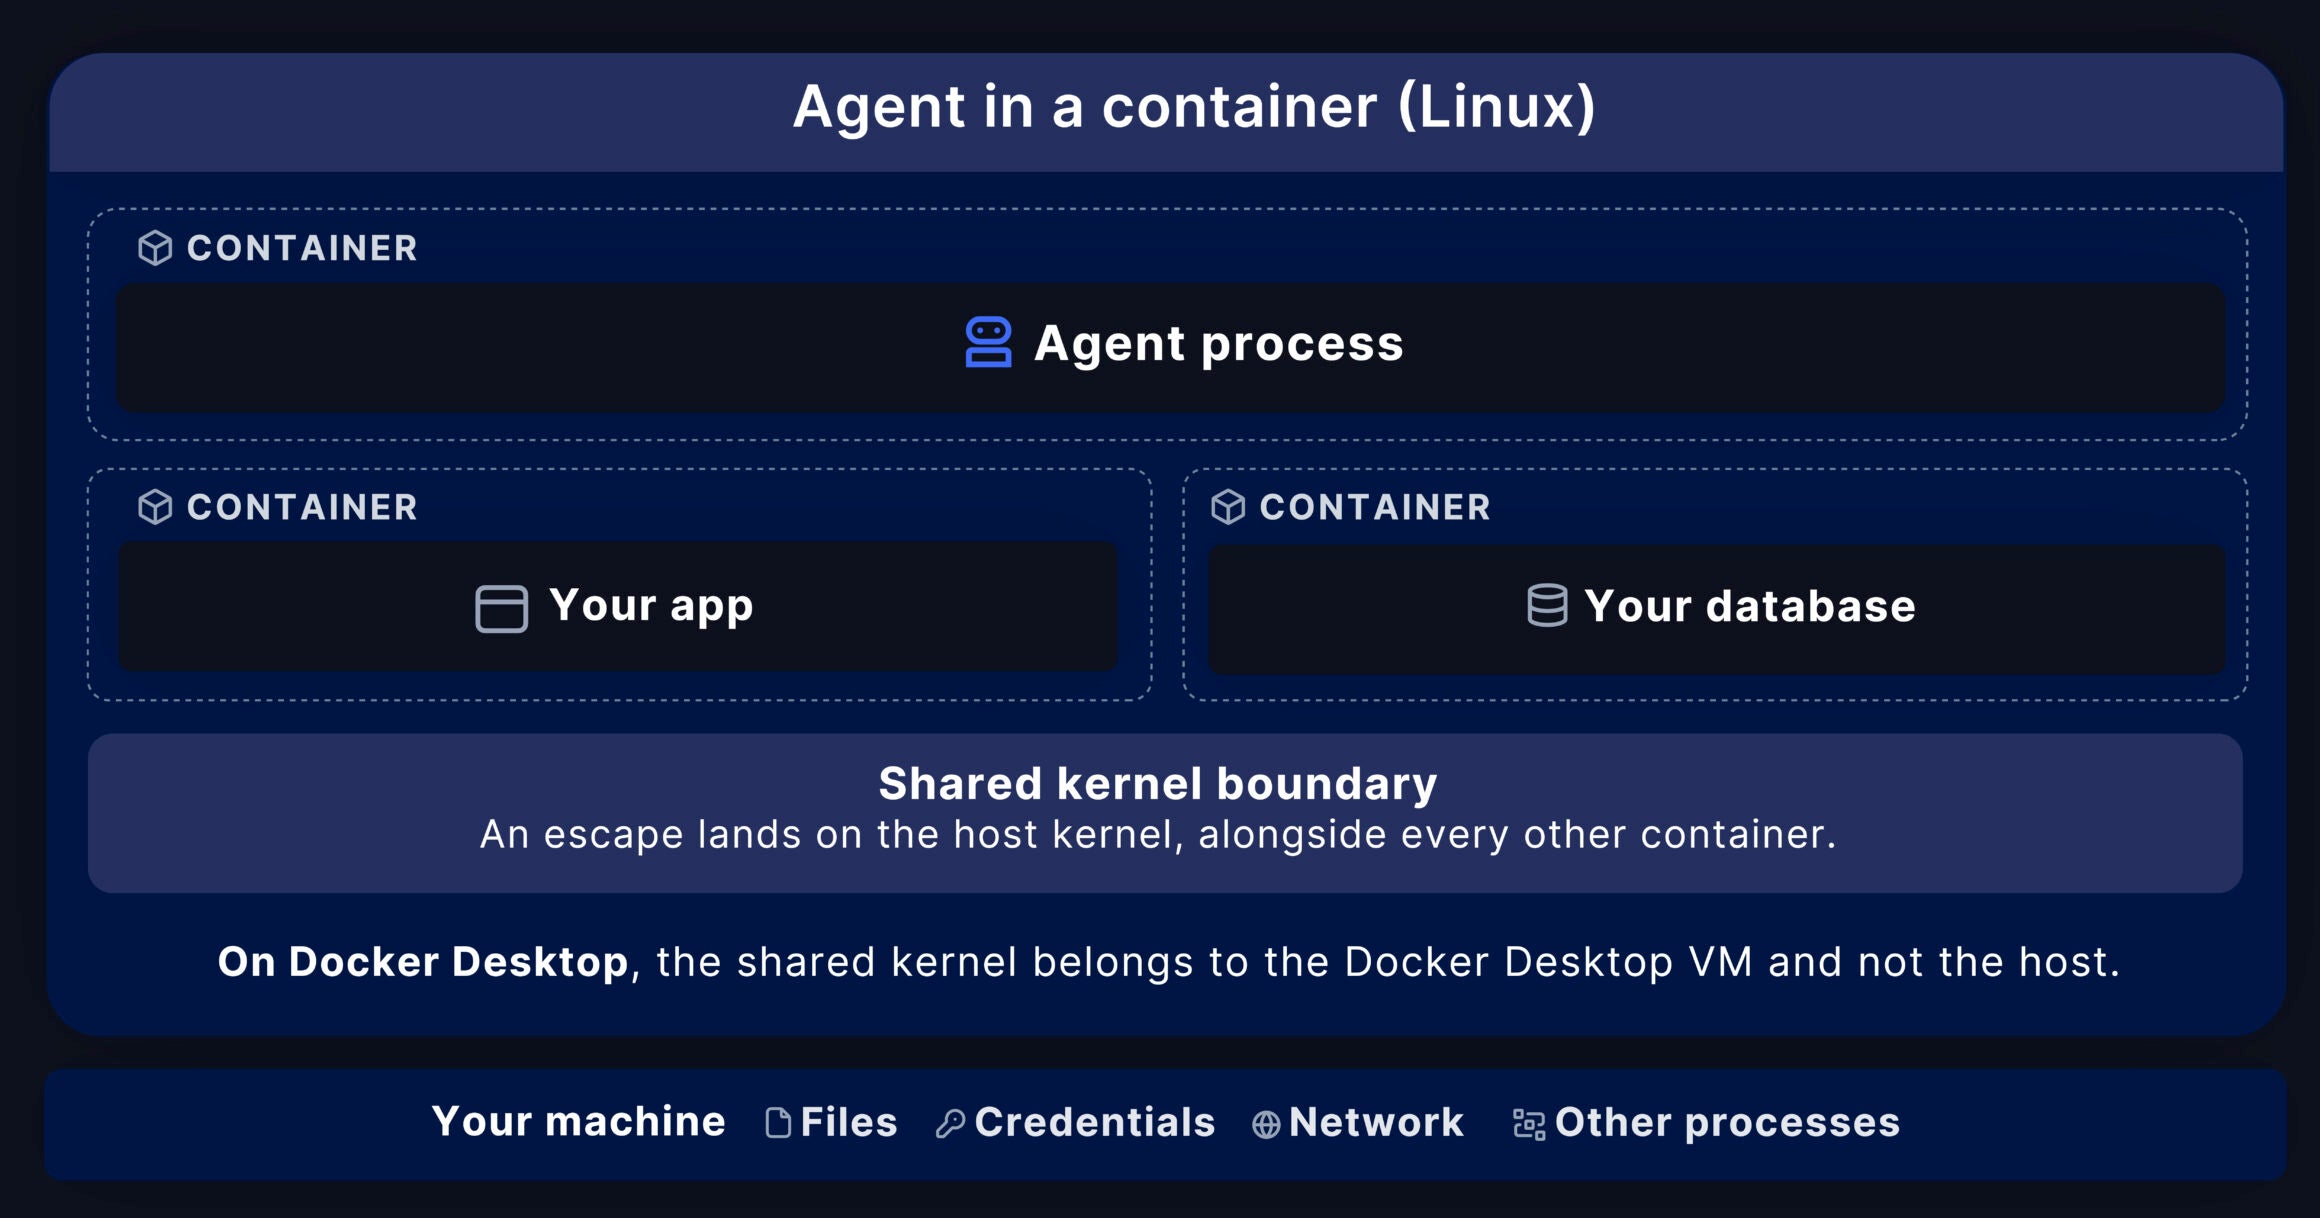
Docker Sandboxes と聞いて、何年も Docker を使ってきた人なら「中で AI エージェントが動くコンテナ」を思い浮かべるだろう。十数年にわたり、コンテナは Docker 製品のほぼすべてにおける配布単位だった。サンドボックスと言われれば、ワークロードを包むまた別の方法程度にしか聞こえない。
だが実際には、この二つは別の技術だ。コンテナはホストカーネルを他のすべてと共有する隔離されたプロセスだ。Docker Sandboxes は独自の Linux カーネルを持つ専用 microVM であり、独立したファイルシステム、ネットワーク、Docker Engine を備え、開発マシン一台分の環境を必要とする自律型コーディングエージェントのために作られている。サンドボックスの中ではコンテナも動かせる。両者が混同されやすい理由の一つはそこにある。
WeAreDevelopers の基調講演で、Docker プレジデントの Mark Cavage は、コンテナは設計どおりの仕事を今も果たしているが、私たちが今コンテナに求めているのは別の仕事だ、と述べている。
コンテナはアプリケーションを隔離するために生まれ、その役割は今も十分に果たしている。しかしコーディングエージェントは行為する側だ。自ら判断を下し、開発者がノート PC を操作するのと同じようにあなたのシステムを動かす。リポジトリを clone し、パッケージをインストールし、データベースを起動し、イメージをビルドする。それを何時間も続け、失敗すればやり直す。誰もレビューしていないファイルや Web ページ、ツールの出力に書かれた指示に従って動くことさえある。
この「別の仕事」には別の境界が必要であり、境界をどこに引くかで、エージェントの一度のミスがどこまで波及するかが決まる。本記事では、Docker Sandboxes とコンテナがそれぞれどうワークロードを隔離するのか、カーネルの外側で何が違うのか、サンドボックスを使うためにセットアップで何を払うのか、そしてどう使い分けるのかを説明する。
要点
- コンテナはホストカーネルを共有する隔離されたプロセス。Docker Sandboxes はカーネル、ファイルシステム、ネットワーク、Docker Engine を自前で持つ microVM。
- パッケージ済みのアプリケーション、CI ジョブ、短時間の実行には、これまでどおりコンテナを使うべき。
- Docker Sandboxes が向くのは、sudo や独立した Docker Engine、長期間保持する状態、ホスト側で強制するネットワークと認証情報の制御を必要とする自律エージェント。
- コンテナはエージェントを縛る仕組みの一部になり得るし、サンドボックスの中でもコンテナは動かせる。エージェントはサンドボックスに入れ、エージェントが扱うアプリケーションはコンテナに入れる。
コンテナとは
コンテナはホスト上で動く単一または複数のプロセスで、独立したファイルシステム、プロセスツリー、ネットワークのビューを持つ。このビューを提供するのが Linux namespace であり、CPU、メモリ、I/O の計量を担うのが cgroup だ。マシン上のすべてのコンテナはホストカーネルも共有する。コンテナの起動が速く、高い密度で配置でき、オーバーヘッドがごく小さいのはそのためだ。
この設計は十数年にわたるツール群に支えられている。Compose、Kubernetes、OCI レジストリ、イメージスキャナ、そしてほぼすべての CI システムが、コンテナを共通の基本単位として扱う。サービスを動かす、コードを実行する、単一のリクエストを処理する、評価を一度回して捨てる。どれもコンテナが第一候補になるのが普通で、この構図は変わらない。
ⓘ コンテナは仮想マシンの中であってもカーネルを共有する。macOS と Windows では、Docker Desktop が Linux コンテナを仮想マシン内で動かすことで、ホスト OS から切り離している。だがその仮想マシン内のコンテナは依然として一つのカーネルを共有しており、コンテナ同士の隔離の度合いは変わらない。
Docker Sandboxes とは
Docker Sandboxes は AI コーディングエージェントを、独立した Linux カーネルを持つ microVM の中で動かす。microVM は独自のファイルシステムとネットワークスタック、そしてプライベートな Docker Engine を持つ。エージェントはこの隔離環境内で sudo 権限を持ち、パッケージのインストール、サービスの起動、イメージのビルド、Compose アプリケーション一式の起動まで自由に行える。ホストの Docker daemon にも、ワークスペース外のホストファイルシステムにも触れず、同じマシン上の他の サンドボックスにも影響しない。
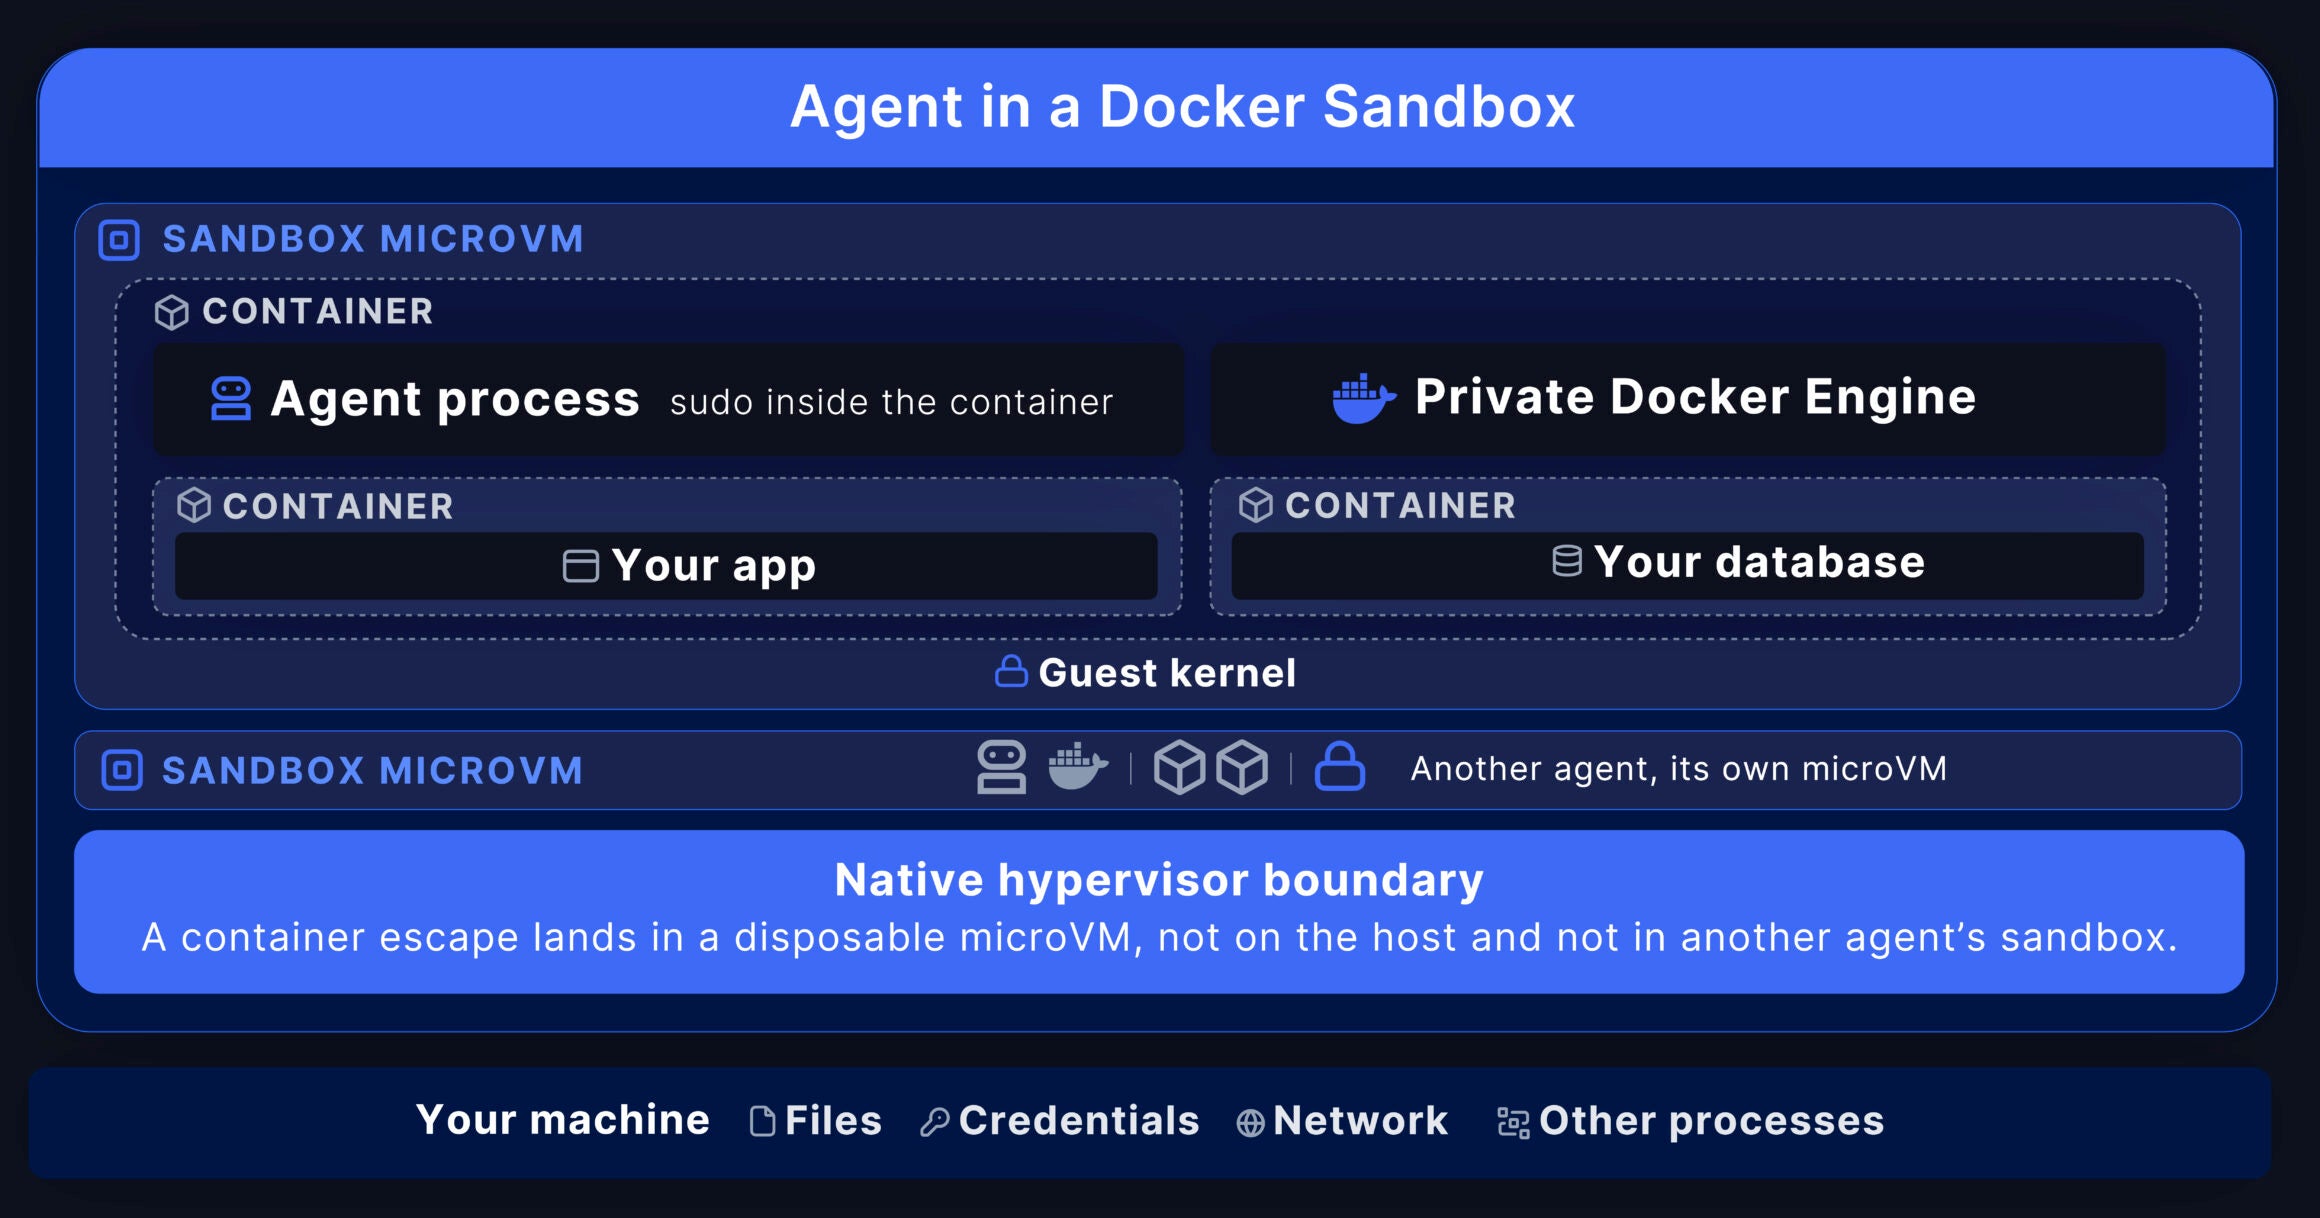
Docker Sandboxes のコマンドラインツール sbx なら、コマンド 1 つで起動できる。
sbx run claude
これでサンドボックスが作成され、エージェントが起動する。停止も再開もでき、サンドボックスを削除するまでは、エージェントがインストールしたすべてのものに後から戻れる。
コーディングエージェントに完全なマシンが必要な理由
コーディングエージェントに完全なマシンが必要なのは、セッションが数時間にわたって状態を積み上げ続けるからであり、また検証されていない指示に従って動作するからだ。コンテナは依存関係の集合が既知の単一プロセス向けに作られている。エージェントの仕事はその形に当てはまらない。
エージェントにはマシン全体の権限と、マシン全体のために設計された境界が必要だ。エージェントを有用にする能力、つまりコードを実行し、パッケージをインストールし、ネットワークにアクセスする能力は、そのまま周囲の境界を侵食し続ける能力でもある。エージェントは環境の縁を探る。その仕事自体が環境を変えることを要求するからだ。
エージェントは数時間にわたって状態を積み上げる
コーディングエージェントのセッションは、開発者の午後そのものだ。リポジトリをクローンし、パッケージをインストールし、PostgreSQL を起動し、マイグレーションを実行し、イメージをビルドし、Compose でアプリを立ち上げ、ログを読み、コードを直し、もう一度試す。このループは数時間続くことがあり、各ステップは前のステップが残した結果に依存している。
コンテナはイメージと明示的なボリューム数個から再構築されることを前提に設計されている。エージェントがそうしたボリュームの外に作ったパッケージ、データベース、ビルド成果物は、コンテナを再構築すると失われる。各ステップが前のステップの上に積み上がるセッションにとって、これは望ましくない。
Box by ASCIIはこの違いを明確に述べている。「サンドボックスは、開発者がノート PC を使うのと同じように使われる。だからサンドボックスはノート PC のように振る舞わなければならない」。
エージェントは信頼できない指示に従って動作する
どのコマンドを実行するかを決めるプログラムは確率的であり、しかも多くの場所から同時に指示を読み取る。ソースファイル、issue の説明、Web ページ、パッケージのメタデータ、MCP ツールの出力などだ。その入力の一部は信頼できず、README やツールの説明に埋め込まれた悪意ある指示がエージェントを意図的に操作しうる。エージェントが生成するコードにも、誤りや敵意が混じりうる。
タスクを誤って解釈したエージェントが本番データベースを削除した事例はすでに起きている。エージェントが YOLO モードで無人運転を始めれば、権限の確認プロンプトで止めることはできない。権限がこれほど大きく、予測可能性がこれほど低いワークロードには、それ専用に設計された境界が要る。
これらの事実を並べると、なぜ Docker Sandboxes を作ったのかが見えてくる。自律型コーディングエージェントにはマシン規模の能力が必要だが、開発者のマシン上のすべてに触れてよいわけではない。要点は四つに集約される。
- 隔絶(Containment)、つまりモデルが書き換えられない境界
- 制御(Control)、エージェントが何をしているか観察でき、止められること
- 選択(Choice)、環境全体を作り直さずにエージェント、モデル、ツールを自由に差し替えられること
- 容量(Capacity)、他の開発者が同じ環境を再現でき、単一マシンの範囲を超えて拡張できること
次の各節でこの四つがそれぞれどういう形になるかを見ていく。まずは隔絶からだ。
コンテナと Docker Sandboxes の隔絶の違い
手短に言えば、コンテナの境界はホストと共有するカーネルであり、Docker Sandboxes はエージェント専用のカーネルの外側にハイパーバイザーの境界を一枚加えている。この違いが、侵入が起きたときにどこまで到達するかを決める。ついでに、あの厄介な問題、つまりエージェントがどうやって Docker にアクセスするかも解決する。
コンテナと隔絶の分かれ目はここにある。コンテナは隔絶の一部になりうるし、多くの場合はなるべきだが、隔絶が覆うのはエージェントを取り巻く環境全体だ。それはモデルが書き換えられない境界から始まる。だから Docker は自律型エージェントに、独立したカーネルを持つ microVM を選んだ。
共有カーネル vs. 専用カーネル
コンテナの境界は共有カーネルによって強制され、抜け出すにはカーネルの脆弱性かサイドチャネル攻撃を突くしかない。どちらも簡単に見つかるものではない。だがその敷居を越えた先には、ホストのカーネル全体、マシン上の他のすべてのプロセス、そしてそれらとマウントを共有しているあらゆる認証情報が待っている。
ⓘ この状況は Linux 環境にのみ当てはまる。Docker Desktop(macOS と Windows)では、共有されるカーネルは Docker Desktop 仮想マシンのカーネルであり、ホストのカーネルではない。したがって脱出してもその仮想マシン内に留まり、OS には届かない。
Docker Sandboxes ではエージェントが専用のカーネルを持ち、ホストとの間にはハイパーバイザーの境界がある。エージェントがコンテナを抜け出しても、行き着く先は使い捨ての microVM だけで、ホストには触れられない。しかもサンドボックスを削除して新しく作れる。各エージェントはそれぞれ独立した microVM を持つので、同じマシンで動く二つのエージェントも互いのサンドボックスには届かない。ただし、エージェントに共有することを選んだものには引き続きアクセスできる。ワークスペース、許可したネットワーク宛先、MCP server、skill などだ。
Docker socket の問題
/var/run/docker.sock をコンテナにマウントするのは、コンテナに Docker へのアクセス権を与える昔ながらの方法で、Compose の設定、CI パイプライン、可観測性ツールのあちこちで見かける。代償は、ホストの Docker daemon の制御権をコンテナに渡すことだ。Docker がこの権限を信頼できるユーザーにしか開放していないのは、これを手にすればホストのパスをマウントし、特権コンテナを起動できるからだ。
エージェントがこれを利用するのに脆弱性は要らない。socket をマウントしたコンテナに入れれば、エージェントは周囲を探索して自分がコンテナの中にいると判断し、設定上のこの穴を見つけ出す。Mark の基調講演のデモでは、それだけでエージェントがホスト上の鍵ファイルを読み出した。zero-day は一切使っていない。
socket はいくつもある穴のひとつにすぎない。エージェントがそれらを見つけられるのは、環境の探索がもともと仕事の一部だからだ。Docker-in-Docker、マウントされた認証情報、範囲が広すぎるホストマウントも、それぞれ別の穴になる。コンテナは、設定に従って動くアプリを隔離するために設計されている。だがエージェントはその設定を絶えず試す。隙があれば、たいてい見つけてしまう。
microVM は境界をどこに引くか
Docker Sandboxes は、欠けていた境界を正しい位置に置いた。エージェントはゲスト内部のプライベート Docker Engine と通信し、イメージのビルド、Testcontainers の実行、Compose stack 一式の起動ができる。一方、ホストの daemon とその socket は常に microVM の外にある。コンテナは得意なことをそのまま続けるが、エージェントが広げられない境界の中に閉じ込められる。
Docker Sandboxes の中のエージェントに、ホスト上の鍵ファイルを探させたとしよう。エージェントは Docker socket を見つけ、それを使ってホストのパスをマウントし、特権コンテナを起動しようとする。だがホストには届かない。microVM が提供する信頼境界は、コンテナよりはるかに強固だ。Docker Sandboxes の背後にあるアーキテクチャでは、なぜ microVM がこの用途に適した形なのかを詳しく説明している。
カーネルの外側にある制御
隔絶は境界を引く。制御 は、その境界の内側で何が見え、何を止められるかを決める。つまりエージェントが何にアクセスを許されるか、そして行くべきでない場所へ向かったときに止められるかどうかだ。サンドボックスでは、こうした制御をホスト側が強制する。エージェントの手は届かないので、無効化も回避もできない。外向き通信、認証情報、組織レベルのポリシーは、いずれもこの仕組みで動く。制御とは、エージェントが依然として触れられるもの、つまりあなたが共有することを選んだものを把握しておくことでもある。microVM はそれを隠せない。
| 標準コンテナ内のエージェント | Docker Sandboxes 内のエージェント | |
|---|---|---|
| カーネル | ホストのカーネルを共有 | microVM 内で独自の Linux カーネルを実行 |
| Docker | ホストの socket かネストした daemon が必要 | microVM 内部のプライベート Docker Engine を使用 |
| ワークスペース | マウントしたホストのパスが見える | 直接読み書きのマウント、または VM 内のプライベートクローンを使用 |
| ネットワーク | コンテナネットワークと、その運用側が提供する制御 | 外向き通信はホスト側プロキシ経由、デフォルト拒否ポリシー |
| 認証情報 | 通常は環境変数、ファイル、マウントされた socket として注入 | 対応する HTTP サービスでは、ホスト側で認証情報を注入 |
| 状態 | 通常はイメージと明示的なボリュームから再構築 | パッケージ、イメージ、コンテナ、エージェントの履歴が sbx rm まで保持される |
| オーケストレーション | Compose、Kubernetes、ほとんどの CI システムに適合 | sbx のライフサイクルと実験的な環境ファイルを使用 |
制御はホスト側が強制する
これらの制御が成り立つのは、エージェントのプロセス外で動いているからだ。エージェントが手を届かせられるルールは回避できる。だから本当に重要なルールはすべてホスト側に置く。外向き通信はホスト側プロキシを通り、ポリシーはデフォルト拒否だ。エージェントが向かおうとした宛先は、誰かがリストに追加するまでブロックされたままだ。認証情報も同じ理屈で扱う。対応する HTTP サービスでは、プロキシが外向きリクエストに認証情報を注入する。エージェントは認証情報を使えるが、元の値が VM に入ることはない。
開発者一人の設定をチームの標準にしたいときは、Docker AI Governance がネットワーク、ファイルシステム、MCP のポリシーを組織レベルの統制へ移行できる。
エージェントがなお触れられるもの
microVM は、あなたが進んで共有したものを隠せない。だからこそ、注意を向けるべきは共有する部分だ。
ワークスペースがその最大のものだ。デフォルトでは読み書きでマウントされるので、エージェントはプロジェクト内のファイルを編集したり削除したりできる。クローンモードなら、エージェントは VM 内のプライベートクローンで作業するため、ホスト側の作業ツリーは守られる。ただし元のリポジトリはサンドボックス内から依然として読める。
MCP サーバーとスキルも同様に共有される。ローカルの stdio MCP サーバーはホスト上で動き、共有されたエージェントスキルはホスト側のストレージを使う。エージェントの到達範囲はこの両方にも及ぶ。
どのモードを選ぶにせよ、変更されたコードを実行する前に必ず diff を読んでほしい。
選択と容量、Docker Sandboxes の設定コスト
Docker Sandboxes にはある程度の設定作業と、対応する hypervisor が要る。ただし設定の部分は Kits と環境ファイルが引き受けてくれる。エージェントやツールに対する選択権を得るのも、同じ設定をチームで再現する力を得るのも、ここだ。
Kits と環境ファイル
Kitsはツール、ファイル、コマンド、ネットワークルール、認証情報、エージェントへの指示をひとまとめにして、設定を再現可能にする。対象のエージェント、ツール、IDE ごとに別々に配布されるので、サンドボックス内で動かすものを差し替えても、環境を作り直す必要はない。sbxenv.yaml はプロジェクトごとのサンドボックス設定を記録するファイルで、これをリポジトリにコミットしておけば、チームの誰もがコマンド 1 つで同じサンドボックスを再現でき、全員が同じ設定から作業を始められる。(Kits はアーリーアクセス、環境ファイルは実験的機能なので、どちらも変更される前提でいてほしい。)
ホスト側で強制する統制にも、それなりの設定が要る。ネットワークポリシーでは、どの宛先がワークフローの一部なのかを誰かが決める必要がある。認証情報の仲介にはサービスの紐付けと承認済みドメインの追加が要る。clone モードは、変更がホストのリポジトリに届く前に fetch のステップを挟む。
ハイパーバイザーとリソース要件
サンドボックスの実行は、コンテナの実行よりマシンへの要求が高い。対応するハイパーバイザーが必要で、現時点では Apple silicon 搭載の macOS 14 以降、Windows Hypervisor Platform、または対応する Ubuntu 上の KVM が該当する。別の仮想マシンの中で動かすなら、ネストした仮想化も要る。独立したカーネルと Docker Engine を抱えるため、コンテナをもう 1 つ動かすよりメモリとディスクも食う。
ボトルネックが手元のマシンにあるなら、Docker Cloud Sandboxes が Docker のホストする計算資源上で同じ microVM 分離を提供する。コマンド 1 つで、ノート PC とクラウドの間でサンドボックスを移せる。ローカルとクラウドのサンドボックスは、それぞれ独立した鍵とネットワークポリシーを持つ。
コンテナと Docker Sandboxes のどちらを選ぶか
コードとその依存関係を自分で管理しているならコンテナ。ワークロードが実行時にコードを生成したり取得したりして、独自の境界を必要とするなら Docker Sandboxes を選ぶ。
| コンテナを選ぶ場合 | Docker Sandboxes を選ぶ場合 |
|---|---|
| コードとその依存関係を自分で管理している | ワークロードが実行時にコードを生成・取得する |
| 実行時間が短く、イメージから作り直せる | セッションが数時間続き、状態が積み上がっていく |
| ワークロードが Docker を必要としない、または Docker がすでに使える CI 上で動く | ワークロードが独自の Docker Engine を必要とし、ホストの socket に触れてはいけない |
| 密度を最大にしたい。Compose や Kubernetes と噛み合う | ホスト側で強制するネットワークと認証情報のポリシーが必要で、ワークロードからは無効化できない |
| 動かすコードに対してカーネルの境界で足りる | ワークロードとカーネルの間にハイパーバイザーの層を挟みたい |
次のどれか 1 つでもプロジェクトに当てはまるなら、Docker Sandboxes から始めるべきだ。
- エージェントが無人で動く、または権限の確認プロンプトが自動承認される
- エージェントがイメージをビルドする、あるいは Compose や Testcontainers を動かす
- エージェントが読む入力が自分で書いたものではない。issue、Web ページ、パッケージのメタデータ、MCP の出力など
- エージェントに API key が必要だが、それをエージェントの環境に出したくない
- セッションが単一のタスクより長く続く
まずは sbx run claude から始める。ワークフローを広げるにつれて、clone モード、kit、ネットワークポリシー、認証情報の仲介、組織のガバナンスを順に加えていく。
エージェントはサンドボックスに、アプリはコンテナに
コンテナの立場は揺るがない。サービス、CI ジョブ、パッケージとして届けるものは、コンテナが引く境界でちょうど足りる。それを取り巻くエコシステムができあがっているからこそ、この役割はコンテナが担い続けている。だが、コーディングエージェントに本物の仕事をさせるには、コンテナ 1 つでは足りない。必要なのは隔絶だ。モデルが書き換えられない境界、迂回できない統制、そのうえでツールを自由に選べ、環境を必要に応じて広げられること。
Docker Sandboxes はこの分離を microVM で実現し、その中でコンテナもそのまま動かせる。境界があるからこそ、エージェントはむしろ速く走れる。コマンドを 1 つずつ承認する代わりに、仕事を任せればいい。
サンドボックスはコマンド 1 つで立ち上がる。sbx run claude と Docker Sandboxes クイックスタートから始めよう。ある開発者の設定をチームの標準にしたくなったら、Docker AI Governance が同じ統制を組織全体に広げてくれる。
よくある質問
Docker Sandboxes はコンテナではないのか?
違う。コンテナはホストのカーネルを共有する隔離されたプロセスだ。Docker Sandboxes は microVM で、独自のカーネル、ファイルシステム、ネットワーク、Docker Engine を持つ。サンドボックスの中ではコンテナが動くので、両者は混同されやすい。
Docker Sandboxes の中で Docker を動かせるか?
動かせる。サンドボックスごとに独立した Docker Engine があり、エージェントはイメージのビルド、Testcontainers の実行、Compose アプリの起動ができる。ホストの socket も Docker-in-Docker も要らない。
Docker Sandboxes はコンテナに取って代わるのか?
違う。パッケージ済みアプリ、CI ジョブ、短時間の実行には、今もコンテナが最適なツールだ。サンドボックスは自律エージェントに一段強い境界を加えるもので、コンテナはサンドボックスの中で動かし続ける。
コンテナと隔絶はどう違うのか?
コンテナが隔離するのは 1 つのワークロードだ。隔絶が対象にするのはエージェントを取り巻く環境全体で、どの境界の内側で動くのか、何にアクセスできるのか、どのツールを使うのか、どう再現するのかまで含む。コンテナは隔絶の一部になり得る。Docker Sandboxes はそこに、自律エージェントに必要な microVM の境界を足す。
AI エージェントは環境に何を求めるのか?
Docker は 4 つの要件を挙げている。隔絶(モデルが書き換えられない境界)、制御(エージェントが何をしているか見え、いつでも止められること)、選択(モデル、エージェント、ツールを替えるときに一から作り直さなくてよいこと)、容量(他の開発者が同じ構成を再現でき、1 台のマシンを超えて拡張できること)。
Docker Sandboxes の実行に必要なものは?
対応するハイパーバイザーが必要だ。macOS 14 以降の Apple silicon、Windows Hypervisor Platform、または対応する Ubuntu 上の KVM のいずれか。別の仮想マシンの中で動かす場合はネストした仮想化が要る。