ダスト:逆伝播不要のTransformer事前学習
Dust は逆伝播なしで transformer を事前学習し、活性化空間の摂動を利用してどの重みにクレジットを与えるかを決定する。論文は複数の規模での結果を報告し、この手法が標準的な訓練ループにまだ劣る点について議論している。
日本語
コピー
TL;DR
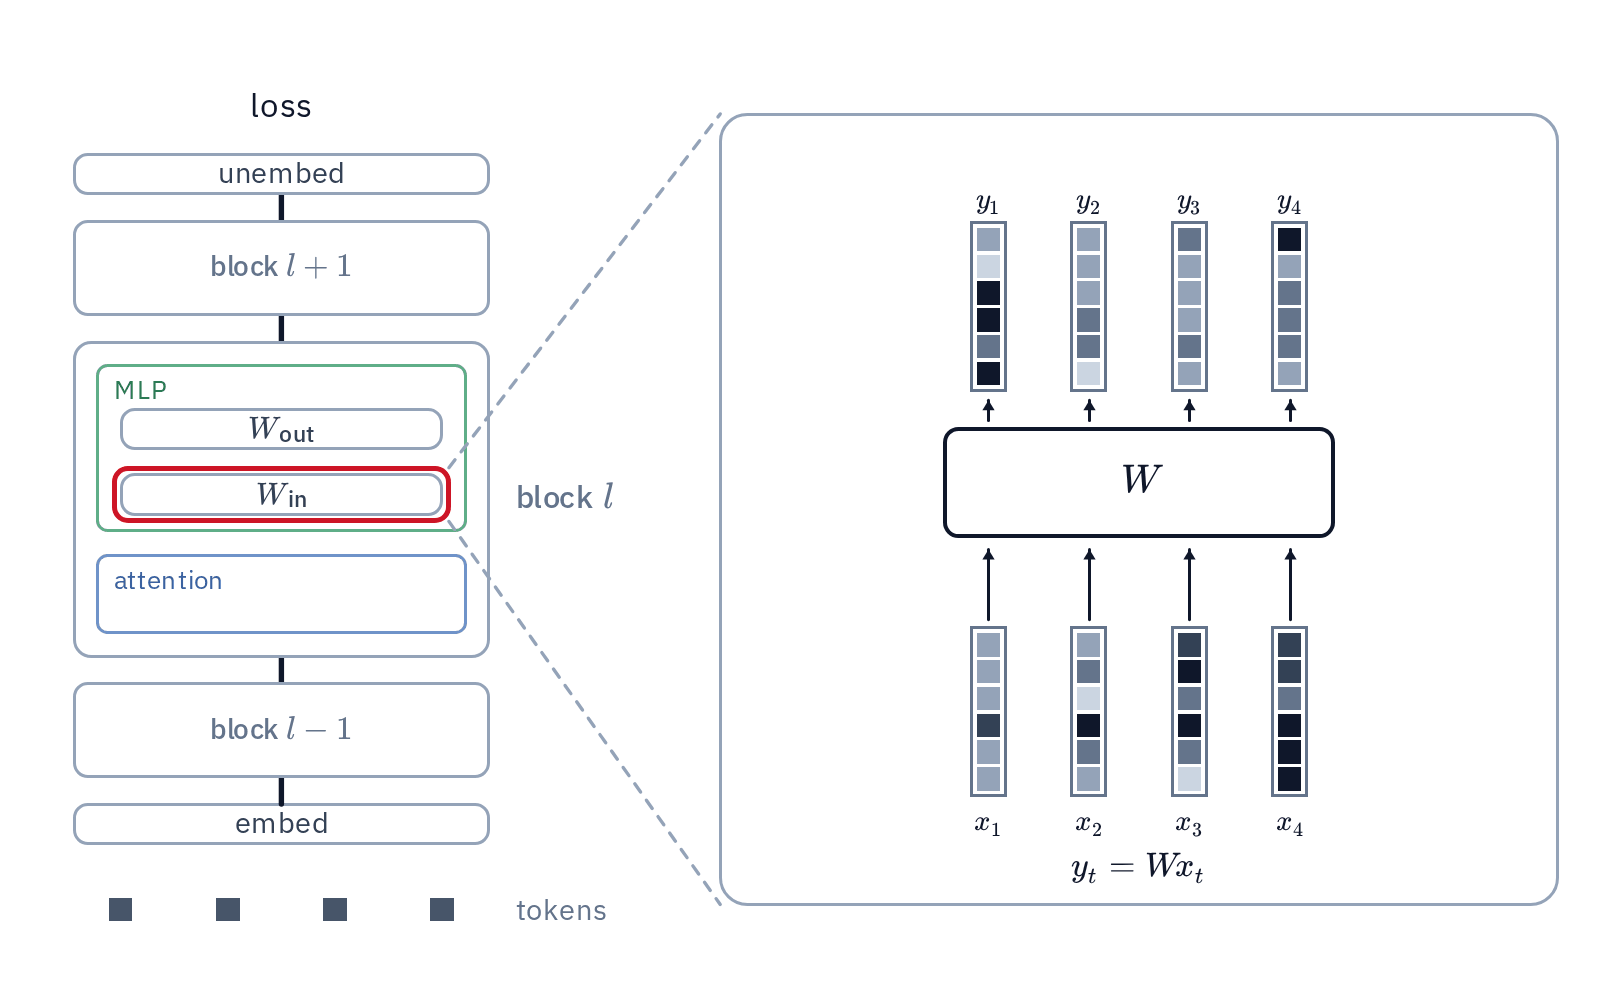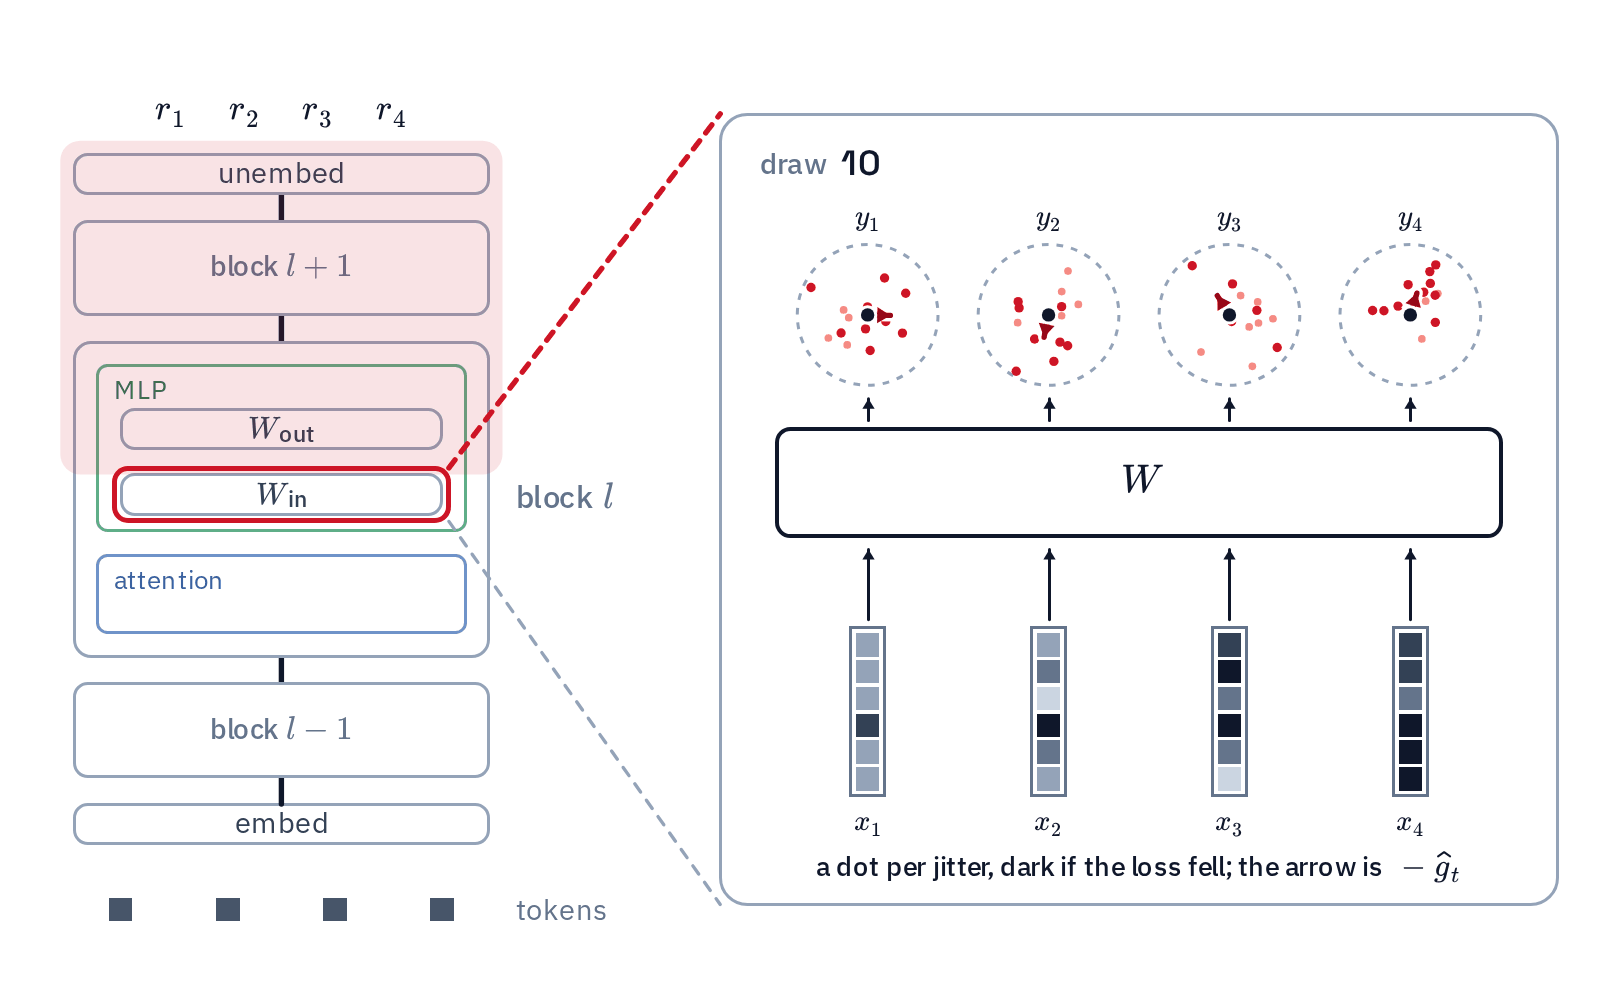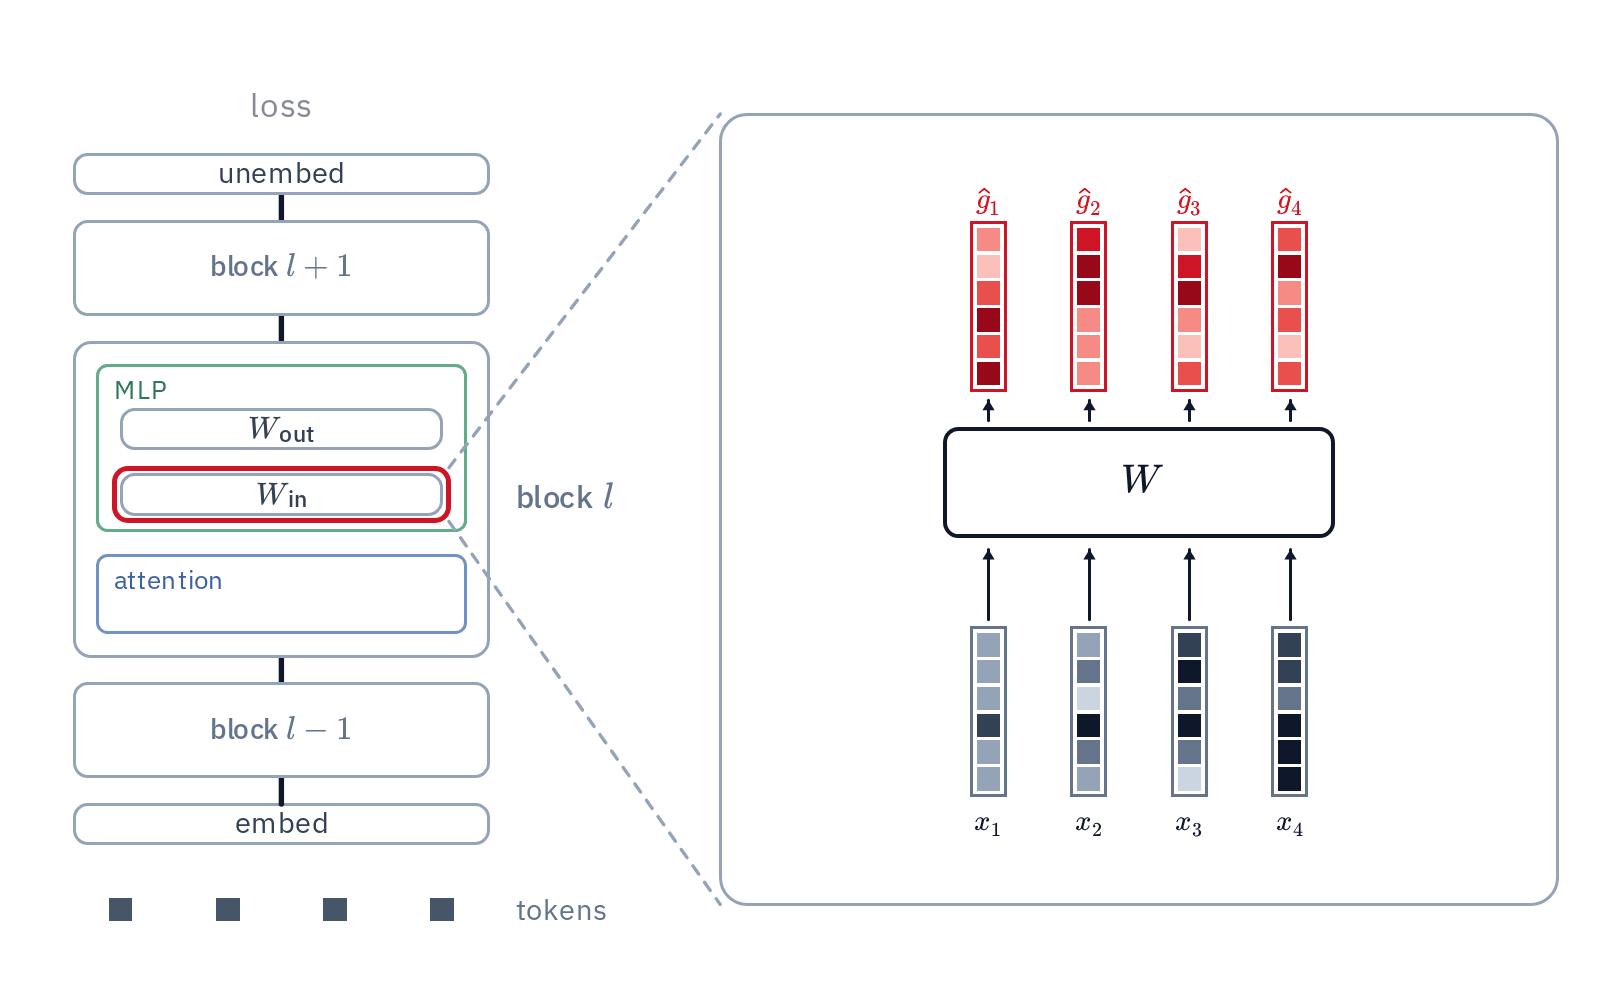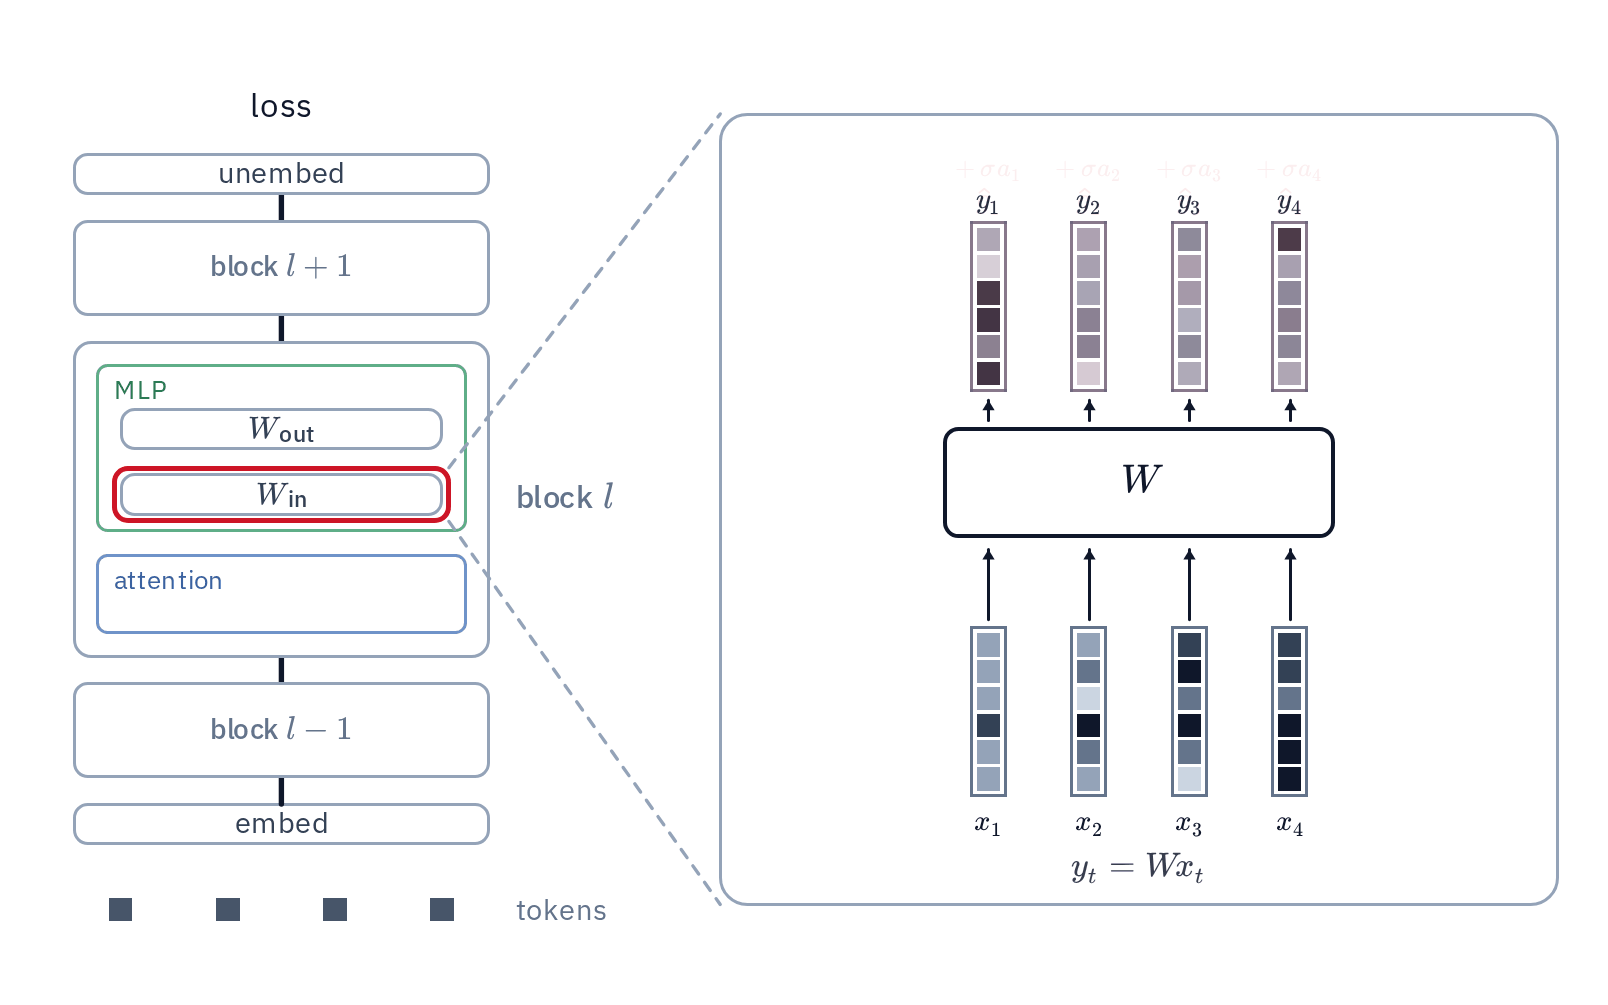
- transformer 言語モデルの事前学習において、誤差逆伝播と競合しうる初のゼロ次手法を提案する。Dust は各トークン上で独立に活性を摂動させる(ノード摂動)ため、各トークンが仮想的な個体群のメンバーとなり、1 回の順伝播でそれらすべてを並列に評価できる。
- 個体群規模が大きいとき(つまり計算量が大幅に増えるとき)、Dust は誤差逆伝播をよく近似し、さまざまな設定でそれを上回ることさえある。これは計算資源が潤沢な状況では、誤差逆伝播を超えられる可能性を示唆する。
- Dust は重み空間の ES より数桁効率的だ。我々の外挿によれば、1M トークン以降、Dust は EGGROLL(最先端の ES 手法)の transformer 実装より約 10310^3103 から 10410^4104 倍効率的である。
- ゼロ次手法は大規模ネットワークにスケールしないというのが一般的な見方だ。しかし注目すべきことに、モデルが大きいほど個体群効率は下がるどころか上がる:243M パラメータのモデルは、ほとんどの個体群規模で の小さいモデルを上回る。
- 個体群が大きくなるにつれ、Dust の勾配推定は誤差逆伝播の勾配とよりよく一致し、我々が試したすべての規模(1B トークンまで)でその一致は保たれる。スケーラビリティにとって良い兆候だ。
目次
TL;DR 1 はじめに 2 手法 2.1 活性空間での摂動 2.2 信用割り当て 2.3 干渉とチューニング 3 逆伝播なしの事前学習 3.1 設定 3.2 主な結果 3.3 Adam での Dust 4 高次元空間での探索 4.1 過パラメータ化 4.2 逆伝播的な勾配の創発 5 結論 6 関連研究 参考文献 付録
1 はじめに
深層学習はこれまで誤差逆伝播を中心に組み立てられてきた。誤差逆伝播は、transformer ベースの言語モデルを含む現代のニューラルネットワークを訓練できる唯一の信用割り当てアルゴリズムだ。微分可能性を要求し、一階勾配を生み出す。深層学習のアーキテクチャ、オプティマイザ、ハードウェアは、この制約のもとで共進化してきた。
だが、世の中で使える計算資源が増え続けるなら、微分可能性や誤差逆伝播、高階勾配近似といった帰納バイアスよりも、探索に基づく、より汎用的で力任せな学習アルゴリズムのほうを選びたくなるかもしれない。苦い教訓(Sutton, 2019Richard S. Sutton. The bitter lesson. http://www.incompleteideas.net/IncIdeas/BitterLesson.html, 2019. Blog post.)とは、計算量とともにスケールする汎用的な手法が最終的に勝つというものだ。AlphaGo Zero(Silver et al., 2017David Silver, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou, Aja Huang, Arthur Guez, Thomas Hubert, Lucas Baker, Matthew Lai, Adrian Bolton, Yutian Chen, Timothy Lillicrap, Fan Hui, Laurent Sifre, George van den Driessche, Thore Graepel, and Demis Hassabis. Mastering the game of Go without human knowledge. Nature, 550 (76): 354–359, 2017. doi: 10.1038/nature24270.)はその最も明快な例だ。人間のデータで AlphaGo を導くことは、当初こそネットワークの学習を速めたが、計算資源が十分に大きくなると、純粋な自己対戦のネットワークがそれを逆転した。同じことが微分可能性と誤差逆伝播にも言える。計算資源が乏しい状況では優れた帰納バイアスとして学習を効率化するかもしれないが、計算資源が潤沢な状況では、使えるアーキテクチャの空間を狭めてしまう。同じアーキテクチャの内部であっても、勾配ベースの手法は損失曲面を最適に探索できない(Liu et al., 20Shengchao Liu, Dimitris Papailiopoulos, and Dimitris Achlioptas. Bad global minima exist and SGD can reach them. In Advances in Neural Information Processing Systems, volume 33, 20.)。現在のニューラルネットワークが汎化に膨大なデータを要する理由も、ここにあるのかもしれない。より柔軟で探索に基づく信用割り当てアルゴリズムは、より良い汎化へ向かう重要な一歩になり得る。
本稿の目標は、逆伝播を、解析的な構造にあまり頼らず、力任せの計算に大きく依存する学習アルゴリズムで置き換えることだ。これを Dust と呼ぶ。Dust はゼロ次最適化アルゴリズムである。活性値を摂動させ、各摂動が損失をどれだけ下げたかで報酬を与え、集団の中で報酬によって重み付けした摂動の平均を取ることで、勾配を推定する。
従来の ES は重みを摂動させる(Salimans et al., 2017Tim Salimans, Jonathan Ho, Xi Chen, Szymon Sidor, and Ilya Sutskever. Evolution strategies as a scalable alternative to reinforcement learning. arXiv preprint arXiv:1703.03864, 2017.)。EGGROLL もそうだ(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)。その規模は集団の大きさとともに増すが、集団を大きくするのは高くつく。各メンバーを実際にインスタンス化して評価しなければならないからだ。私たちは仮想集団という考え方でこの二つのコストを同時に消す。各メンバーをインスタンス化する代わりに、重み空間をまるごと迂回し、ノードを摂動させる手法と同じように活性値を摂動させる(Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.; Widrow and Lehr, 1990Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323.)。これを token ごとに独立して行うので、各 token が一人のメンバーになり、1 回の順伝播でそのすべてを並列に評価できる。
活性空間は重み空間より探索に値する。機構的可解釈性は、言語化できるかどうかに関わらず推論が活性の中に存在することを示してきた(Gurnee et al., 2026Wes Gurnee, Nicholas Sofroniew, Adam Pearce, Mateusz Piotrowski, Isaac Kauvar, Runjin Chen, Anna Soligo, Paul Bogdan, Euan Ong, Rowan Wang, Ben Thompson, David Abrahams, Subhash Kantamneni, Emmanuel Ameisen, Joshua Batson, and Jack Lindsey. Verbalizable representations form a global workspace in language models. arXiv preprint arXiv:2607.15495, 2026.; Lindsey et al., 2025Jack Lindsey, Wes Gurnee, Emmanuel Ameisen, Brian Chen, Adam Pearce, Nicholas L. Turner, Craig Citro, et al. On the biology of a large language model. Transformer Circuits Thread, 2025.)。つまりこの道は、訓練を潜在的な推論の探索に変えうる(Vegesna and Dahal, 2025Akshay Vegesna and Samip Dahal. Decoupling search and learning in neural net training. arXiv preprint arXiv:2509.10973, 2025.)。次に私たちは、活性空間の摂動をきわめて汎用的な信用割り当ての規則と組み合わせる。transformer block の中で種類の異なる層に、それぞれ別の token レベルの報酬を割り当てるのだ。この二つのバイアスに、いくつかの実装上の細部と効率化の工夫(摂動を受けたモジュール同士が干渉しないようにする、など)を加えたものが、アルゴリズムの全体である。
我々の貢献は以下のとおりである。
- transformer 言語モデルの事前学習において、逆伝播と競合する初の第零次手法を提案する。大規模な种群サイズでは、Dust は複数の設定で逆伝播を上回り、計算資源が潤沢な条件下では逆伝播を超えうることを示す。
- Dust は重み空間 ES より数桁効率的である。1M token 以降について、我々の外挿によれば、Dust は EGGROLL の transformer 実装より約 10310^3103 から 10410^4104 倍効率的である。
- 一般に信じられているのとは逆に、より大きなモデルは种群効率が低くなるどころかむしろ高くなり、より大きな种群を活用できる。これは過パラメータ化に新たな視点を与える。すなわち、より大きな探索空間であり、より良い幾何構造を持ちうるということだ。
- 种群が大きくなるにつれて、Dust の勾配推定は逆伝播との整合性が高まる。我々が試したすべての規模——1B token まで——でこの整合性が成り立ち、これはスケーリングにとって良い兆候である。
本論文は、探索に基づく信用割り当てアルゴリズムに基礎を与え、我々が思いつく最も難しいタスク——transformer の事前学習——において逆伝播と互角に渡り合えるようにすることを目的とする。我々は、今日の逆伝播を置き換えられるほど計算効率を高めようとしているわけではないし、それが可能にする新しい種類のニューラルネットワーク——外部プログラムをループに組み込んだネットワークや、時間方向の逆伝播では訓練が難しい多段リカレント transformer——の訓練にも使っていない。この二つは今後の課題として残す。
2 手法
Dust は次のように動作する。各線形層の出力にガウスノイズを加える。これは各 token で独立に行い、順伝播を一度実行し、その token における損失の変化でその token のノイズに報酬を与える。複数回のサンプリングで平均を取ると、報酬で重み付けされたノイズがその層の出力における誤差の推定値となり、これとその層の入力との外積が重み勾配となる。アテンションの内部機構には変種を用いる。それらは、現在および未来の token における損失を直接用いるのではなく、アテンション出力のそれらの token における推定誤差を通じて信用を得る。核心的な直感はこうだ。重み空間 ES は順伝播一回につき种群メンバーを一つしか評価しないが、我々は token ごとにメンバーを一つ、並列に評価する。しかもメンバーは隠れ状態にノイズを加えるだけで実体化でき、コストが低い。したがって現代の transformer では、一回の順伝播で評価される种群サイズは重み空間 ES より少なくとも三桁大きい。以下、各構成要素を順に詳述する。
2.1 活性化空間の摂動
進化戦略のボトルネックは种群サイズである。各メンバーは摂動された重みのコピーと、自身の順伝播を必要とする。EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)は低ランク摂動によってこれらのコピーを安価にするが、各メンバーは依然としてバッチ内の一つの系列要素にすぎず、种群サイズは賄える順伝播の回数に制限される。我々は代わりに活性化を摂動させる。各 token で独立に行う。その token において、ネットワークはその活性化を生み出した層の重みに低ランク摂動が加えられたかのように振る舞うが、この摂動が重みの中に実体化されることはない。我々はこれを仮想种群と呼ぶ。transformer の一つの系列は数千 token を持つため、一回の順伝播で系列ごとに一つのメンバーではなく数千のメンバーを評価する。モデル内のすべての重みは、2L 個の残差混合スカラーを除いてこの方法で訓練され、その 2L 個のスカラーは通常の重み空間 ES で訓練される。
重みではなく活性化にノイズを加えることはノード摂動と呼ばれ(Widrow and Lehr, 1990Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323。)、それを支持するよくある理由は次元である(Ren et al., 2023Mengye Ren, Simon Kornblith, Renjie Liao, and Geoffrey Hinton. Scaling forward gradient with local losses. In International Conference on Learning Representations, 2023.;Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。層の出力は 個の要素を持ち、重みは 個を持つため、活性化ノイズが存在する空間ははるかに小さい。大まかに言えば、この次元の議論は活性化が大きく token も多い transformer には当てはまらない。系列上のノイズは テンソルであり、 になればその要素数は重み行列と少なくとも同じになる。しかし、摂動と報酬がともに token ごとに独立であれば、活性化の摂動は token 軸に沿った新たな効率的な种群をもたらし、これは EGGROLL がもともと依拠する batch 軸と直交する。
2.2 信用割り当て
線形層 について、すべての token でその出力を揺らし、。ここで 、 はノイズのスケールであり、その後順伝播を実行する。各 token s において、中心化された損失の低下量 を計算する。ここで は摂動後の損失、 は同じバッチ順伝播でまとめて評価された各サンプルの、その token における平均摂動損失である。token t における揺らぎの報酬とは、t での損失低下量に、それ以降の各 token の損失低下量を減衰 で割り引いて加えたものである。揺らぎはアテンションを通じてこれらの token にも影響を及ぼすため、
(1)
を使う場合、各ジッターは自身のトークンからのみ報酬を得る。どの層が未来のトークンを参照できるかは、第 2.3 節のパラメータ調整で決まる。すべてのトークンに対して独立にジッターを1回ずつ行うことを抽出と呼び、1つの集団は K 回の抽出を含む。複数回の抽出で平均を取ると、報酬で重み付けされたノイズは
(2)
はその層の出力の推定誤差であり、これとその層の入力との外積(順伝播時にすでに計算済み)をトークンごとに総和したものが重み勾配である。
(3)
誤差逆伝播も同じ入力から同じ外積を作る。違いは出力誤差の出どころだけだ。逆伝播では連鎖律から、我々の方法では集団から来る。埋め込み層では xt が one-hot ベクトルなので、外積は g^t\hat g_tg^t をそのトークンの行に散らして足し込むことに相当する。
集団規模に制限がなければ、上記の推定量がそのまま完全な手法であり、各摂動は同じ一回の順伝播に収まる。各サンプルの報酬重み付きノイズは勾配に不偏誤差を加えたものになる。サンプル数を増やすと勾配は線形に、誤差は平方根で積み上がるので、両者の比は集団の拡大とともに下がり、極限では干渉が消える。
2.3 干渉とハイパーパラメータ調整
現実に許容できる集団規模では、主なコストは干渉である。つまり同じ一回の順伝播で多くの層の多くのトークンに揺らぎを与えるため、あるトークンのノイズに対する報酬の損失変化に、その伝播中の他のすべての摂動の影響が混ざり込む。この干渉は三つの面から減らす。第一に、層の種類ごとに別々の順伝播で揺らぎを与え、それぞれに独自のノイズスケールを持たせ、各 block にも独自の伝播を持たせる。これらの伝播は完全な順伝播より安い。クリーンな順伝播はすでにキャッシュされており、block lll のサンプリングは lll 以降の block を再実行するだけで済むからだ。第二に、アテンション内部(query、key、value、gate、value embedding)はそれぞれ別々に揺らぐ。トークン損失にはこれらの揺らぎがほとんど現れないので、代わりにアテンション出力を通じて報酬を与える。詳細は後述する。第三に、言語モデリングヘッドはキャッシュされた logits 上で直接揺らぎ、各サンプリングでは語彙のごく一部について交差エントロピーを計算し直すだけで、コストは順伝播のごく一部で済む。これによりこのヘッドははるかに大きな集団で回せる。
アテンション内部については、揺らぎだけを使ってキャッシュされたクリーンな活性からその block のアテンション出力を再計算する。揺らぎの評価には、推定したアテンション出力勾配との整合度を使う。
cs=−⟨g^s,Δos⟩,c_s = -\langle \hat g_s, \Delta o_s \rangle ,cs=−⟨g^s,Δos⟩,
(4)
ここで Δos\Delta o_sΔos はトークン s におけるアテンション出力の揺らぎによる変化、g^s\hat g_sg^s は式 2 で推定したその出力の誤差である。報酬は式 1 で、損失の減少量をこれらのヘッドごとのスコアで置き換える。
ハイパーパラメータ、層の種類ごとのノイズスケール、アテンション内部構造の信用減衰、各層に割り当てる集団の取り分は、二通りの方法で調整できる。一つはグリッドサーチで、小さなトークン予算のもとで各設定を訓練し、損失を最も下げた設定を残す。信頼できるが高い。もう一つは、単一 batch 上で我々の推定と誤差逆伝播の勾配のコサイン類似度を最大化するグリッドサーチで、訓練が一切要らない。単一 batch でコサインが大きくても、訓練後の損失が低いとは限らない。そこでコサインで候補を絞り、訓練で決める。どちらの方法でも、調整はほぼ一度きりのコストで済む。見つかった設定はおおむねトークン予算と集団規模をまたいで汎化するからだ。例外が一つある。10M と 20M トークンの最大集団では、より遅い信用減衰と、サンプリングをアテンション側に寄せることが依然として得になる(付録 F)。つまりこの探索が与えるのは手法一般の法則であり、ある一回の実行の設定ではない。当然ながら、すべての層が未来のトークンからの信用を必要としない。例外は keys、values、gates、value embeddings で、これらは後続のトークンから読まれるため、 は 1 に近い。
3 誤差逆伝播なしの事前学習
3.1 設定
FineWeb 上で GPT 風の transformer を訓練する。4096 トークンの BPE tokenizer を使い、batch は 16k トークン(2048 トークンの系列 8 本)、1 epoch、モメンタム付き SGD と一定の学習率で訓練する。基礎モデルは 8 層、幅 512。各手法は同じプロトコルを使い、各セルで三つの乱数シードを回し、トークン予算と集団規模ごとに個別に調整する。Dust と誤差逆伝播はモメンタムと学習率のグリッドを共有する。EGGROLL は同じ transformer アーキテクチャで実装し(EGGROLL-Transformer と呼ぶ)、独自のステップ幅、モメンタム、ノイズスケール、適応度整形のグリッドで調整する。検証セットとテストセットはそれぞれ 544 系列のホールドアウト。最良の検証 checkpoint におけるテスト損失を報告する。
Dust では集団を draw 数で数え、EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)では batch の順伝播回数で数える。後者は重み空間のベースラインである。1 draw とは選んだ層の全トークンの活性に一度摂動を加えることで、トークン損失を報酬とする。population K は更新ごとの draw 数である。1 draw は一回の順伝播よりやや安い。クリーンな順伝播の結果はキャッシュ済みで、第 lll ブロックへの摂動は第 lll ブロック以降を再実行するだけで済むからだ。K は head とアテンション内部の draw を数えない。これらは更新 FLOPs のごく一部にすぎない(付録 E)。総合すると、population 256 で Dust の計算量は同程度の population の EGGROLL をすでに下回る。したがってこの比較は EGGROLL に有利である。
3.2 主要結果
6.0 6.5 7.0 7.5 8.0 検証損失 1M tokens 0 0.25 0.5 0.75 1 訓練の進捗 5.0 6.0 7.0 8.0 検証損失 10M tokens 0 0.25 0.5 0.75 1 訓練の進捗 Dust 64 1k 16k EGGROLL- Transformer 64 1k 16k 誤差逆伝播
図 1:1M および 10M tokens での訓練中の検証損失。Dust(紫)、同じ population の EGGROLL(灰)、誤差逆伝播(黒い破線)。横軸は消費した token 予算の割合。色の濃さは population を表し、64、1k、16k と大きくなるほど濃くなる。曲線は 3 つの乱数シードの平均。
7.2 7.4 7.6 7.8 8.0 テスト損失 100k tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 1M tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 テスト損失 10M tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 20M tokens 64 256 1k 4k 16k Population
∞ 4.43 フィット 1.53 P−0.145 + 4.43 P → ∞ での極限 極限の 95% 区間 EGGROLL-Transformer Dust Backprop
図 2:検証セットで選んだ checkpoint における、テスト損失の population 規模に対する依存。token 予算ごとに 1 パネルで、Dust(紫)と EGGROLL-Transformer(灰)。点は表 1 の各セル、黒い破線は同じ予算でハイパーパラメータを調整した backprop、破線の曲線は Dust の 5 つのセルに対する冪乗則フィット。100k のパネルだけ y 軸の範囲が独立で、残り 3 つは共通。20M では、紫の一点鎖線がフィットの極限値 4.43 で、これはまだ下降中の階段から外挿したもの。 の誤差バーはその 95% bootstrap 区間で、population 規模ごとに乱数シードをリサンプリングしている。
token 予算を 100k から 20M まで、population 規模を 64 から 16k まで振り、各予算で同じグリッド上で backprop のハイパーパラメータを調整した(表 1、図 2)。100k と 1M token では Dust が最終的に backprop を下回り、100k では数百回のサンプリング、1M では千回程度でそれを達成している。10M と 20M token では、backprop との差は population 規模が大きくなるほど縮まる。10M では階段はすでに平坦になり、フィットした極限は backprop をわずかに上回る。20M では階段は 16k 回のサンプリングでもまだ下降している。その冪乗則フィットが与える極限は 4.431(95% 区間 3.89 から 4.58)で、backprop の 4.633 を下回るが、階段はまだ下降中でフィットの制約は緩い。したがってこれは、差が population 規模とともに縮まり続ける証拠として読むべきであり、実測された極限ではない。
重み空間の ES ははるかに効率が悪い。population 規模が 256 倍でも、EGGROLL は 16k でようやく Dust の 64 回サンプリング時の水準に届かない。100k token ではその差は 0.02 以内に縮まるが、1M、10M、20M では常に 0.4 から 0.6 高い(図 2)。EGGROLL の階段は 16k でもまだ急に下降しているので、population 規模をさらに増やせば改善は続くが、階段をそのまま延ばすとすると、Dust の最小 population 規模の水準に達するには数千倍から約 10410^4104 倍の population 規模が必要になる(付録 D)。図 1 にも訓練中の差が表れている。Dust は 1k と 16k のサンプリングで最後まで backprop の曲線にぴったり寄り添うが、EGGROLL の各曲線は早々に遅れを取り、Dust の 64 回サンプリング時の水準よりずっと高いところで平坦になる。
3.3 Adam での Dust
5.5 6.0 6.5 7.0 7.5 テスト損失 100 万 token、Adam 使用 64 256 1k 4k 16k 64k ∞ population 規模
EGGROLL-Transformer Dust 5.248 誤差逆伝播 5.361
図 3:100 万 token、Adam 使用時のテスト損失の population 規模に対する依存。Dust(紫)、EGGROLL(灰)、誤差逆伝播(黒、破線)。紫の曲線は実行した各 population 規模に対する冪乗則フィットで、紫の一点鎖線はその極限値 5.248 で、誤差逆伝播を下回る。 のバーは極限値の 95% 自助法区間、すなわち 5.17 から 5.30 で、population 規模ごとに乱数シードをリサンプリングしている。Dust と誤差逆伝播は 5 つの乱数シードの平均、EGGROLL は 3 つ。Dust の Adam 実行では token 埋め込みのサンプリングが増えており、合計で記載の population 規模の約 倍になる。
残りの部分は主に SGD を扱うが、3 つの手法すべてについて Adam でも 100 万トークンのステップ実験を繰り返し(図 3)、各集団サイズごとにバックプロパゲーションの学習率、Dust 自身のハイパーパラメータ、EGGROLL のステップ幅・モーメンタム・適応度シェーピングを再チューニングした。興味深いことに、EGGROLL は Adam からほとんど何も得られず、チューニング後の Adam のステップはどの集団サイズでも表 1 の SGD のステップと 0.01 も違わなかった。一方、Adam は Dust とバックプロパゲーションの両方を改善し、ステップの形も以前と似ていた。Dust は集団サイズが大きいところでバックプロパゲーションに迫り、その極限値の区間はバックプロパゲーションを下回る(図 3)。つまり Dust の推定はすでに現代のオプティマイザと組み合わせて機能する。もっとも、現代のオプティマイザはバックプロパゲーションの勾配に合わせて最適化されたものだが。オプティマイザと Dust を共進化させればさらなる利得が得られる可能性があると考えており、これは今後の課題とする。
4 高次元空間での探索
4.1 過パラメータ化
各行内のテスト損失はその行の最小値その行の最大値
| 集団サイズ | パラメータ数 | 規模間 | |||
|---|---|---|---|---|---|
| 2.0M | 7.3M | 38M | 243M | ||
| 64 | 5.705 | 5.556 | 5.558 | 5.719 | |
| 256 | 5.486 | 5.362 | 5.358 | 5.419 | |
| 1k | 5.265 | 5.161 | 5.158 | 5.214 | |
| 4k | 5.189 | 5.095 | 5.053 | 5.124 | |
| 16k | 5.171 | 5.065 | 5.036 | 5.086 | |
| バックプロパゲーション | 5.180 | 5.066 | 5.015 | 5.048 |
図 4:10M トークン固定、パラメータ数 2M から 243M までの 4 つのモデル規模(L2/d128、L4/d256、L8/d512、L16/d1024)における、テスト損失の集団サイズ依存性。各規模は同じユニット数とバックプロパゲーションを用い、各集団サイズで最良の規模を太字で示す。
ゼロ次手法では大規模ネットワークを訓練できないというのが従来の見方である(Lillicrap et al., 20Timothy P. Lillicrap, Adam Santoro, Luke Marris, Colin J. Akerman, and Geoffrey Hinton. Backpropagation and the brain. Nature Reviews Neuroscience, 21 (6): 335–346, 20. doi: 10.1038/s41583-020-0277-3。)。順伝播 1 回で返るのはスカラー 1 つだけなので、勾配推定の分散は摂動の次元とともに増大し、有効な更新 1 回に必要な集団サイズも大きくなる(Nesterov and Spokoiny, 2017Yurii Nesterov and Vladimir Spokoiny. Random gradient-free minimization of convex functions. Foundations of Computational Mathematics, 17 (2): 527–566, 2017. doi: 10.1007/s10208-015-9296-2。;Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。これを直接検証した。10M トークン固定で集団サイズを一通り振り、2M、7M、38M、243M パラメータの 4 規模(パラメータ数の比は に達する)を訓練した(図 4;チューニングの詳細は付録 F)。得られた顕著な観察は 2 つあり、いずれも通説に反する。
- 大きなモデルは集団効率が低いどころか、むしろ高いことが多い。 集団サイズ 256 以上ではいずれも、損失は 2M から 7M、38M へと下がり、243M モデルはわずかに劣るだけだった。テストした最小の集団サイズでも、 倍大きいモデルはほぼ同等の性能を示し、それ以外の集団サイズではすべて上回った。ある範囲までは、大きなモデルが規模から得る利得が分散の損失を上回る。ただし、同じ集団サイズとモデル規模では、バックプロパゲーションとの差はモデル規模とともに広がるものの、特に集団サイズが大きい場合はほとんど無視できる程度だった。
- 小さなモデルが頭打ちになっても、大きなモデルは集団サイズとともに改善し続ける。 小さなモデルは早く飽和し、大きなモデルは集団サイズを増やすほど改善を続ける。1k サンプルを超えると、38M と 243M のモデルの利得は 2M と 7M より約 30% 大きく、集団サイズをいくら増やしても最小のモデルは競争力を持てない。
モデル規模は、探索空間の大きさと幾何形状として捉えるのが適切だ。モデルが大きければ探索できる空間が広がり、より大きな种群規模を支えられる。同時に損失曲面の条件数が改善する可能性があり、种群が小さくても探索がうまく進むのはそのためかもしれない。
4.2 逆伝播勾配に似た勾配の創発
0.00 0.05 0.10 逆伝播勾配とのコサイン類似度 EGGROLL、10M tokens 64 1k 16k 128k 0.00 0.25 0.50 0.75 1.00 Dust、10M tokens 64 1k 16k 128k Dust、100M tokens 64 1k 16k 128k Dust、1B tokens 64 1k 16k 128k 种群 MLP 平均 Q K V head
図 5:同一バッチ上で推定した勾配と逆伝播勾配のコサイン類似度を層種別ごとに示す(層について平均、MLP は入力射影と出力射影の平均)。横軸は种群規模。Dust は 10M、100M、1B tokens で逆伝播により学習したチェックポイントを使用し、EGGROLL は同じ計算予算での 10M tokens の結果を用いる(左図、座標軸に注意)。Dust の曲線はフィット式 であり、种群規模 64 から 128k の測定値からフィットしたもの。EGGROLL の曲線は各測定点をそのまま結んでいる。縦の破線は各段階の学習で用いた 16k の种群規模。初期化状態および EGGROLL の 100M tokens での結果は付録 B を参照。
Dust の推定勾配と、同一バッチ上での逆伝播勾配とのコサイン類似度を、層種別ごとおよび層ごとに測定した。用いたチェックポイントは逆伝播で学習され、token 数は 2 桁にわたる(10M から 1B tokens)。1 ステップあたりの順伝播回数(种群規模)は 64 から 128k まで増やした(図 5)。学習のどの段階でも、層種別ごとのコサイン類似度は种群規模とともに上昇し、2 パラメータの式
(5)
は層種別ごとに RMSE 0.06 未満でフィットした。ここで は上界、c はその層が に達するときの种群規模である。有用な勾配は大きな种群でのみ創発しており、連鎖律はどこにも組み込まれていない。第 2.3 節で述べたとおり、コサイン類似度を最大化するためにハイパーパラメータをわずかに調整しただけである。100M token のチェックポイントでは、層種別ごとの平均コサイン類似度のフィット RMSE は 0.0032〜0.0367 だった(詳細は付録 G)。Dust の勾配はコサイン類似度で逆伝播に近いが、その近さの度合いは層種別や個々の層によって異なる。EGGROLL の推定値は同じ順伝播回数で同様に測定したもので、种群規模とともに増加するものの、128k でも head 以外の層種別ではコサイン類似度が 0.05 未満にとどまる。第 3.2 節でこれに基づく学習がまったく進まなかった理由は、おそらくここにある。
重要なのは、token 数が増えてもコサイン類似度がほとんどの層で安定している点で、これはスケーリングにとって良い兆候だ。第 3 節で示したとおり、backprop に匹敵しそれを超えるために必要な种群規模は token の増加とともに大きくなる。しかし大きな种群のもとでは、コサイン類似度は 2 桁にわたる token の範囲で平坦であり続ける。つまり种群が十分大きければ、この要件はtoken の増加とともに大きくなり続けない可能性がある。また、Dust の勾配は backprop の勾配に近いが正確には収束しない。これはむしろ良い性質だ。推定値は近い方向を指すが backprop の勾配そのものではないため、異なる最適化軌跡へと導かれ、我々の実験ではその軌跡が backprop を上回ることさえあった(第 3.2 節)。
5 結論
Rumelhart et al. (1986)David E. Rumelhart, Geoffrey E. Hinton, and Ronald J. Williams. Learning representations by back-propagating errors. Nature, 323: 533–536, 1986. 以来、ニューラルネットワークの学習アルゴリズムは backprop であり続け、現在のアーキテクチャ、オプティマイザ、ハードウェアもすべてそれを前提に作られている。計算資源がますます潤沢になるにつれ、より良い代替手段が十分あり得ると我々は考えている。提案する Dust は既存の ES アルゴリズムを大きく改善し、事前学習した transformer 上で backprop をよく近似し、計算資源が十分ならそれを上回ることさえある。
興味深い未解決の問題も多い。第一に、Dust が損失景観を暗黙に探索することを通じて、backprop の一次勾配より良い方向を見つけ、より高次の曲率を捉え、探索を平坦な領域へ引き寄せられるか、そしてそれはどうやって起きるのか。大きな种群のもとで backprop を下回ることがあるため可能だという兆候はあるが、その仕組みはわかっていない。第二に、Dust はネットワークが端から端まで微分可能であることを必要としないため、アーキテクチャの探索空間を広げる。backprop が苦手とされる領域、たとえば時間方向の逆伝播で学習するリカレント計算や looped 計算では、より良い性能を出せるかもしれない。第三に計算効率だが、これは本稿の主題ではない。現状の計算資源では、Dust が backprop の実用的な代替となるには、計算効率を数桁改善する必要がある。
6 関連研究
言語モデルのゼロ次事前学習に関する初期の研究(Allaire et al., 2025Nathan Allaire, Mahsa Ghazvini Nejad, Sébastien Le Digabel, and Vahid Partovi Nia. Zeroth order optimization for pretraining language models. In Proceedings of ICPRAM, pages 113–121, 2025. doi: 10.5220/0013261100003905. URL https://doi.org/10.5220/0013261100003905.)考察了通过权重扰动从零开始训练)は、Transformer の難しさを扱った。その後彼らが提案した手法 KronZO(Allaire et al., 2026Nathan Allaire, Sébastien Le Digabel, Dominique Orban, and Vahid Partovi Nia. Zeroth-order Kronecker optimization for pretraining language models. SN Computer Science, 7, 2026. URL https://www.gerad.ca/en/papers/G-2025-44. Article 162.)は、Kronecker 構造を持つコンパクトな摂動と選択的な方向更新を採用し、事前学習の精度を高めつつメモリ使用量を抑える。EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)は低ランク構造を利用し、大規模な重み摂動の集団を GPU 上で効率的に扱えるようにした。Dust は代わりに活性値を探索し、トークンごとの報酬を利用することで、1 回の順伝播からより多くの信用割り当て情報を引き出す。
ファインチューニングでは、MeZO(Malladi et al., 2023Sadhika Malladi, Tianyu Gao, Eshaan Nichani, Alex Damian, Jason D. Lee, Danqi Chen, and Sanjeev Arora. Fine-tuning language models with just forward passes. In Advances in Neural Information Processing Systems, volume 36, 2023.)が、順伝播だけで、推論並みのメモリ使用量で言語モデルを適応させられることを示した。Evolution Strategies at Scale(Qiu et al., 2026Xin Qiu, Yulu Gan, Conor F. Hayes, Qiyao Liang, Yinggan Xu, Roberto Dailey, Elliot Meyerson, Babak Hodjat, and Risto Miikkulainen. Evolution strategies at scale: LLM fine-tuning beyond reinforcement learning. In Proceedings of the International Conference on Machine Learning, 2026. URL https://arxiv.org/abs/2509.24372. arXiv:2509.24372.)は、数十億パラメータの言語モデルを ES で全パラメータ微調整できることを示した。Neural Thickets(Gan and Isola, 2026Yulu Gan and Phillip Isola. Neural thickets: Diverse task experts are dense around pretrained weights. arXiv preprint arXiv:2603.12228, 2026. URL https://arxiv.org/abs/2603.12228.)通过随机扰动预训练权重、挑选最佳候选并集成其预测,找到了有用的任务专家。这些结果说明,围绕一个预训练模型,搜索能取得多大的成效。而我们的实验则针对从零预训练、直接学习表示本身这一问题。
我々の活性化摂動はノード摂動を基盤としている(Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。GEMINI(Le Cun et al., 1988Yann Le Cun, Conrad C. Galland, and Geoffrey E. Hinton. GEMINI: Gradient estimation through matrix inversion after noise injection. In Advances in Neural Information Processing Systems, volume 1, pages 141–148, 1988. URL https://proceedings.neurips.cc/paper/1988/file/a0a080f42e6f13b3a2df133f073095dd-Paper.pdf。)は最初の隠れ層にノイズを注入し、反復的な行列逆算によって層ごとの勾配推定を復元する。Zoop(Hu et al., 2025Xixi Hu, Bo Liu, Qiang Liu, Xiaocong Du, Bhargav Bhushanam, Louis Feng, Chengyue Gong, and Kaizhao Liang. Zoop it! Efficient zero-order optimization with output perturbation. In ICML Workshop on Tiny Titans: The next wave of On-Device Learning for Foundation Models, 2025. URL https://openreview.net/forum?id=Tc8vFyRhPO.)利用输出扰动微调语言模型,借助局部导数将估计出的输出梯度转换为参数更新。Scaling Forward Gradient with Local Losses(Ren et al., 2023Mengye Ren, Simon Kornblith, Renjie Liao, and Geoffrey Hinton. Scaling forward gradient with local losses. In International Conference on Learning Representations, 2023.)は活性化摂動、局所損失、前向きモード自動微分を組み合わせることで、推定量の分散を低減する。Forward gradients with multiple tangents(Flügel et al., 2025Katharina Flügel, Daniel Coquelin, Marie Weiel, Charlotte Debus, Achim Streit, and Markus Götz. Beyond backpropagation: Optimization with multi-tangent forward gradients. In International Joint Conference on Neural Networks, 2025. URL https://arxiv.org/pdf/2410.17764v2.)同样采用前向模式微分,通过正交投影组合多个方向导数来改进梯度估计。
もう一つの研究の流れは、大域的な誤差逆伝播を局所的な学習力学で置き換えるものである。Sakana AI の PC-ALM(Seely and Gould, 2026Jeffrey Seely and Julian Gould. Augmented Lagrangian predictive coding. arXiv preprint arXiv:2605.31022, 2026. URL https://arxiv.org/abs/2605.31022.)通过局部预测编码动力学和拉格朗日乘子来传播信用。它使用局部导数,并在图像分类任务上进行评估。Dust は、transformer の事前学習中に順方向の摂動から信用を推定し、各 token の報酬をアテンション出力の局所目的関数と結びつける。
参考文献の完全なリストは原論文を参照。