尘埃:无需反向传播的Transformer预训练
Dust 无需反向传播即可预训练 transformer,它利用激活空间中的扰动来决定哪些权重应获得信用。论文报告了多个规模下的结果,并讨论了该方法在哪些方面仍落后于标准训练循环。
中文
复制
TL;DR
- 我们提出首个在 transformer 语言模型预训练中能与反向传播相竞争的第零阶方法。Dust 在每个 token 上独立扰动激活(节点扰动),因此每个 token 都是一个虚拟种群成员,一次前向传播就能并行评估它们全部。
- 在大种群规模下(即算力大幅增加时),Dust 能很好地逼近反向传播,在多种设置下甚至超过它。这暗示在算力充裕的情形下,我们或许能超越反向传播。
- Dust 比权重空间的 ES 高效几个数量级。根据我们的外推,从 1M token 起,Dust 比 EGGROLL(一种最先进的 ES 方法)的 transformer 实现高效约 10310^3103 到 10410^4104 倍。
- 人们普遍认为第零阶方法无法扩展到大型网络。但引人注目的是,我们发现模型越大,种群效率越高而非越低:一个 243M 参数的模型在大多数种群规模下都优于一个 的较小模型。
- 随着种群增长,Dust 的梯度估计与反向传播的梯度对齐得更好,并且在我们测试的每个规模上(直至 1B token)都保持良好对齐,这对扩展性是个好兆头。
目录
TL;DR 1 引言 2 方法 2.1 激活空间扰动 2.2 信用分配 2.3 干扰与调参 3 无反向传播的预训练 3.1 设置 3.2 主要结果 3.3 Adam 下的 Dust 4 高维空间中的搜索 4.1 过参数化 4.2 类反向传播梯度的涌现 5 结论 6 相关工作 参考文献 附录
1 引言
深度学习一直围绕反向传播构建,而反向传播是唯一能训练现代神经网络(包括基于 transformer 的语言模型)的信用分配算法。它要求可微性,产出一阶梯度,深度学习的架构、优化器和硬件都是在这一约束下共同演化出来的。
不过,随着世界上可用的算力不断增加,我们可能更愿意采用基于搜索的、更通用也更暴力的学习算法,而不是可微性、反向传播、高阶梯度近似这类归纳偏置。苦涩的教训(Sutton, 2019Richard S. Sutton. The bitter lesson. http://www.incompleteideas.net/IncIdeas/BitterLesson.html, 2019. Blog post.)是:能随算力扩展的通用方法最终会胜出,AlphaGo Zero(Silver et al., 2017David Silver, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou, Aja Huang, Arthur Guez, Thomas Hubert, Lucas Baker, Matthew Lai, Adrian Bolton, Yutian Chen, Timothy Lillicrap, Fan Hui, Laurent Sifre, George van den Driessche, Thore Graepel, and Demis Hassabis. Mastering the game of Go without human knowledge. Nature, 550 (76): 354–359, 2017. doi: 10.1038/nature24270.)就是最明显的例子。用人类数据引导 AlphaGo,一开始确实帮网络学得更快,但算力足够大之后,纯自对弈的网络反超了它。同样地,可微性和反向传播在低算力场景下可能是很好的归纳偏置,能让学习更高效,但在高算力场景下,它们限制了可用架构的空间。即便在同一个架构内部,基于梯度的方法也无法最优地探索损失曲面(Liu et al., 20Shengchao Liu, Dimitris Papailiopoulos, and Dimitris Achlioptas. Bad global minima exist and SGD can reach them. In Advances in Neural Information Processing Systems, volume 33, 20.)。这或许也能解释,为什么当前的神经网络需要海量数据才能泛化。一种更灵活、基于搜索的信用分配算法,很可能是走向更好泛化的重要一步。
本文的目标是用一种更依赖暴力计算、更少依赖解析结构的学习算法取代反向传播。我们把它叫做 Dust。Dust 是一种零阶优化算法:它扰动激活值,按每次扰动降低损失的程度给出奖励,再对种群中按奖励加权的扰动取平均,以此估计梯度。
传统的 ES 方法扰动的是权重(Salimans et al., 2017Tim Salimans, Jonathan Ho, Xi Chen, Szymon Sidor, and Ilya Sutskever. Evolution strategies as a scalable alternative to reinforcement learning. arXiv preprint arXiv:1703.03864, 2017.),比如 EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.),其规模随种群增长,但扩大种群代价高昂,因为每个成员都必须被实际实例化并评估。我们通过虚拟种群这一概念同时消除了这两项开销:不再实例化每个成员,而是完全绕开权重空间,转而扰动激活值,就像节点扰动那样(Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.; Widrow and Lehr, 1990Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323.)。我们在每个 token 上独立地做这件事,因此每个 token 就是一个成员,一次前向传播就能并行地评估它们全部。
激活空间比权重空间更值得搜索。机制可解释性已经表明,推理——无论能否被言语化——都存在于激活之中(Gurnee et al., 2026Wes Gurnee, Nicholas Sofroniew, Adam Pearce, Mateusz Piotrowski, Isaac Kauvar, Runjin Chen, Anna Soligo, Paul Bogdan, Euan Ong, Rowan Wang, Ben Thompson, David Abrahams, Subhash Kantamneni, Emmanuel Ameisen, Joshua Batson, and Jack Lindsey. Verbalizable representations form a global workspace in language models. arXiv preprint arXiv:2607.15495, 2026.; Lindsey et al., 2025Jack Lindsey, Wes Gurnee, Emmanuel Ameisen, Brian Chen, Adam Pearce, Nicholas L. Turner, Craig Citro, et al. On the biology of a large language model. Transformer Circuits Thread, 2025.),这意味着这条路可以把训练变成对潜在推理的搜索(Vegesna and Dahal, 2025Akshay Vegesna and Samip Dahal. Decoupling search and learning in neural net training. arXiv preprint arXiv:2509.10973, 2025.)。随后,我们把激活空间的扰动与一条非常通用的信用分配规则配对:为 transformer block 中不同类型的层分配不同的 token 级奖励。这两个偏置,加上一些实现细节和效率措施(比如避免被扰动的模块之间相互干扰),就是整个算法。
我们的贡献如下。
- 我们提出了首个在 transformer 语言模型预训练上能与反向传播竞争的第零阶方法。在大种群规模下,Dust 在多种设置中超过反向传播,这说明在算力充裕的条件下,我们有可能超越反向传播。
- Dust 比权重空间 ES 高效几个数量级。从 1M token 起,根据我们的外推,Dust 比 EGGROLL 的 transformer 实现高效约 10310^3103 到 10410^4104 倍。
- 与普遍看法相反,更大的模型往往种群效率更高,而非更低,并且能够利用更大的种群。这为过参数化提供了一个新视角:它是更大的搜索空间,且可能具有更好的几何结构。
- 随着种群增大,Dust 的梯度估计与反向传播的对齐程度更好;在我们测试的每一个规模上——直到 1B token——这种对齐都成立,这对扩展来说是个好兆头。
本文旨在为一种基于搜索的信用分配算法奠定基础,使其在我们所能想到的最难任务——预训练 transformer——上足以与反向传播相抗衡。我们并不试图让它的计算效率高到足以在今天取代反向传播,也没有用它训练其所能开启的新型神经网络,比如在回路中嵌入外部程序的网络,或是在时间反向传播难以训练的多步循环 transformer。这两者都留待未来工作。
2 方法
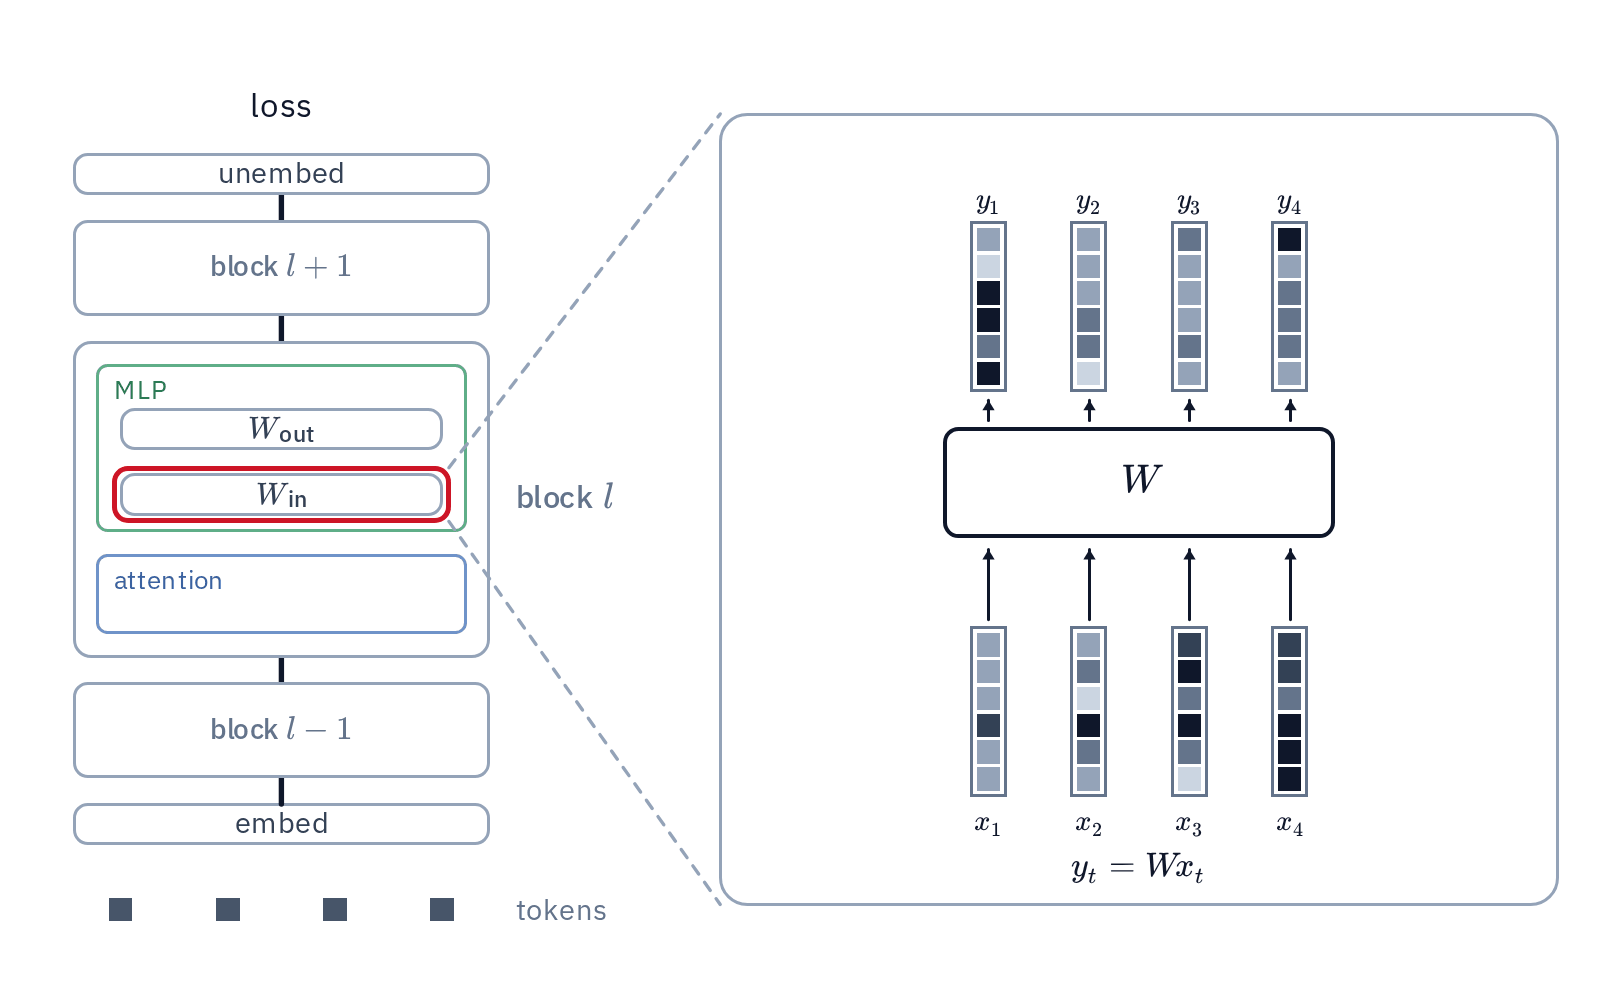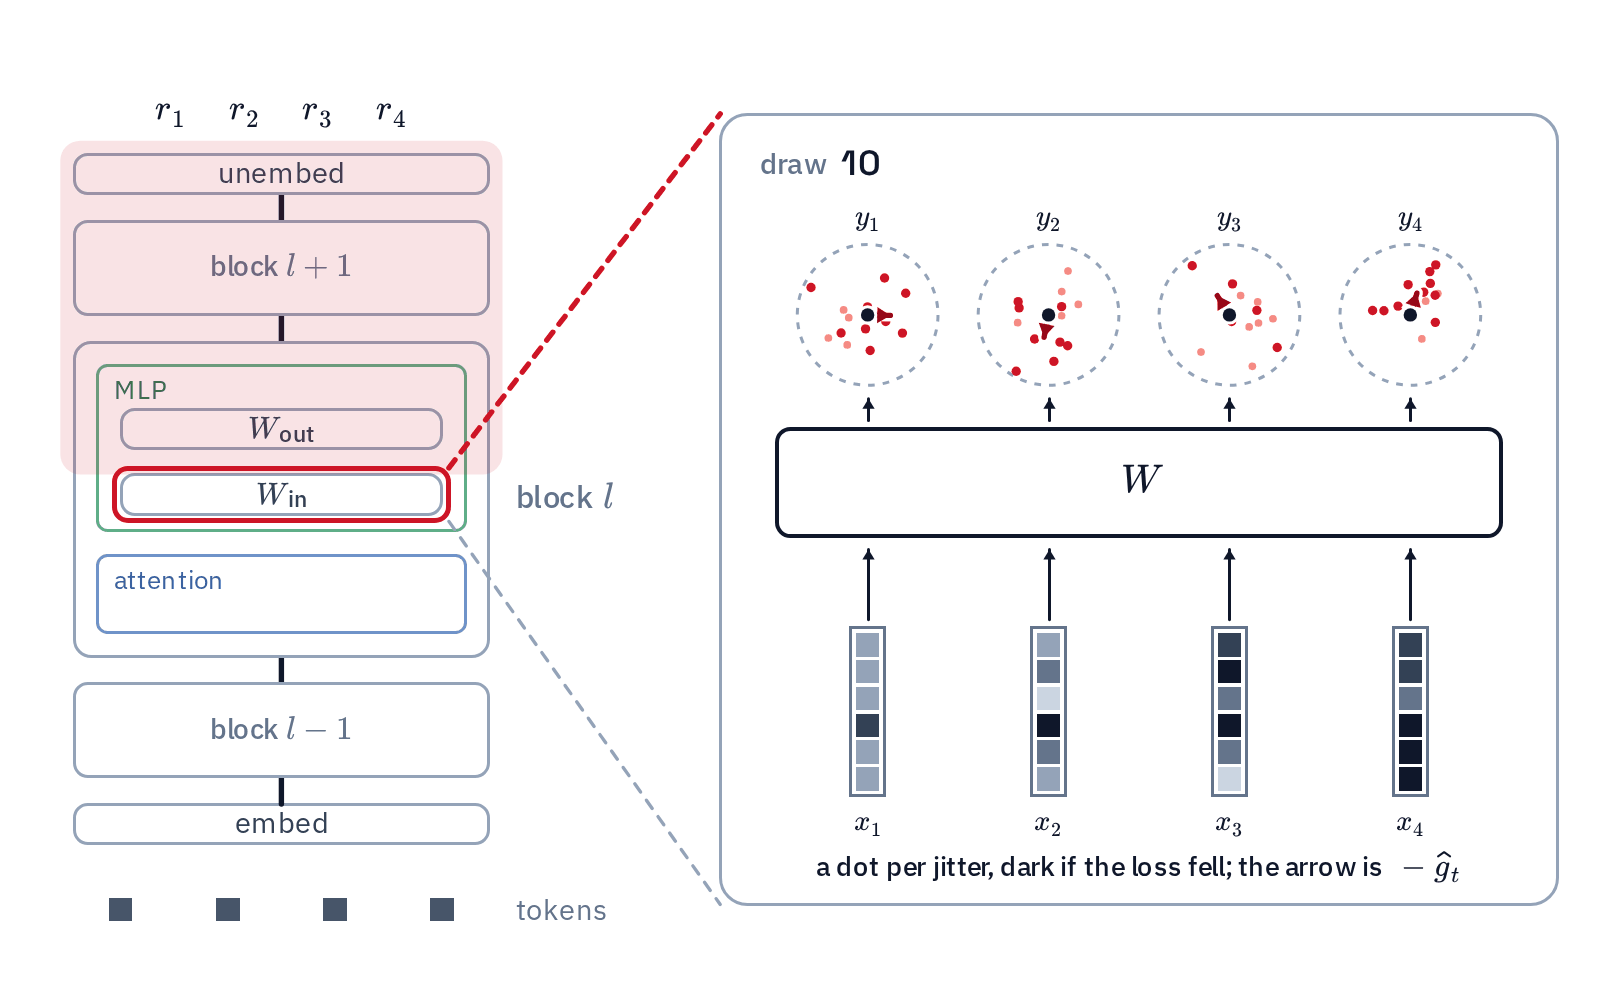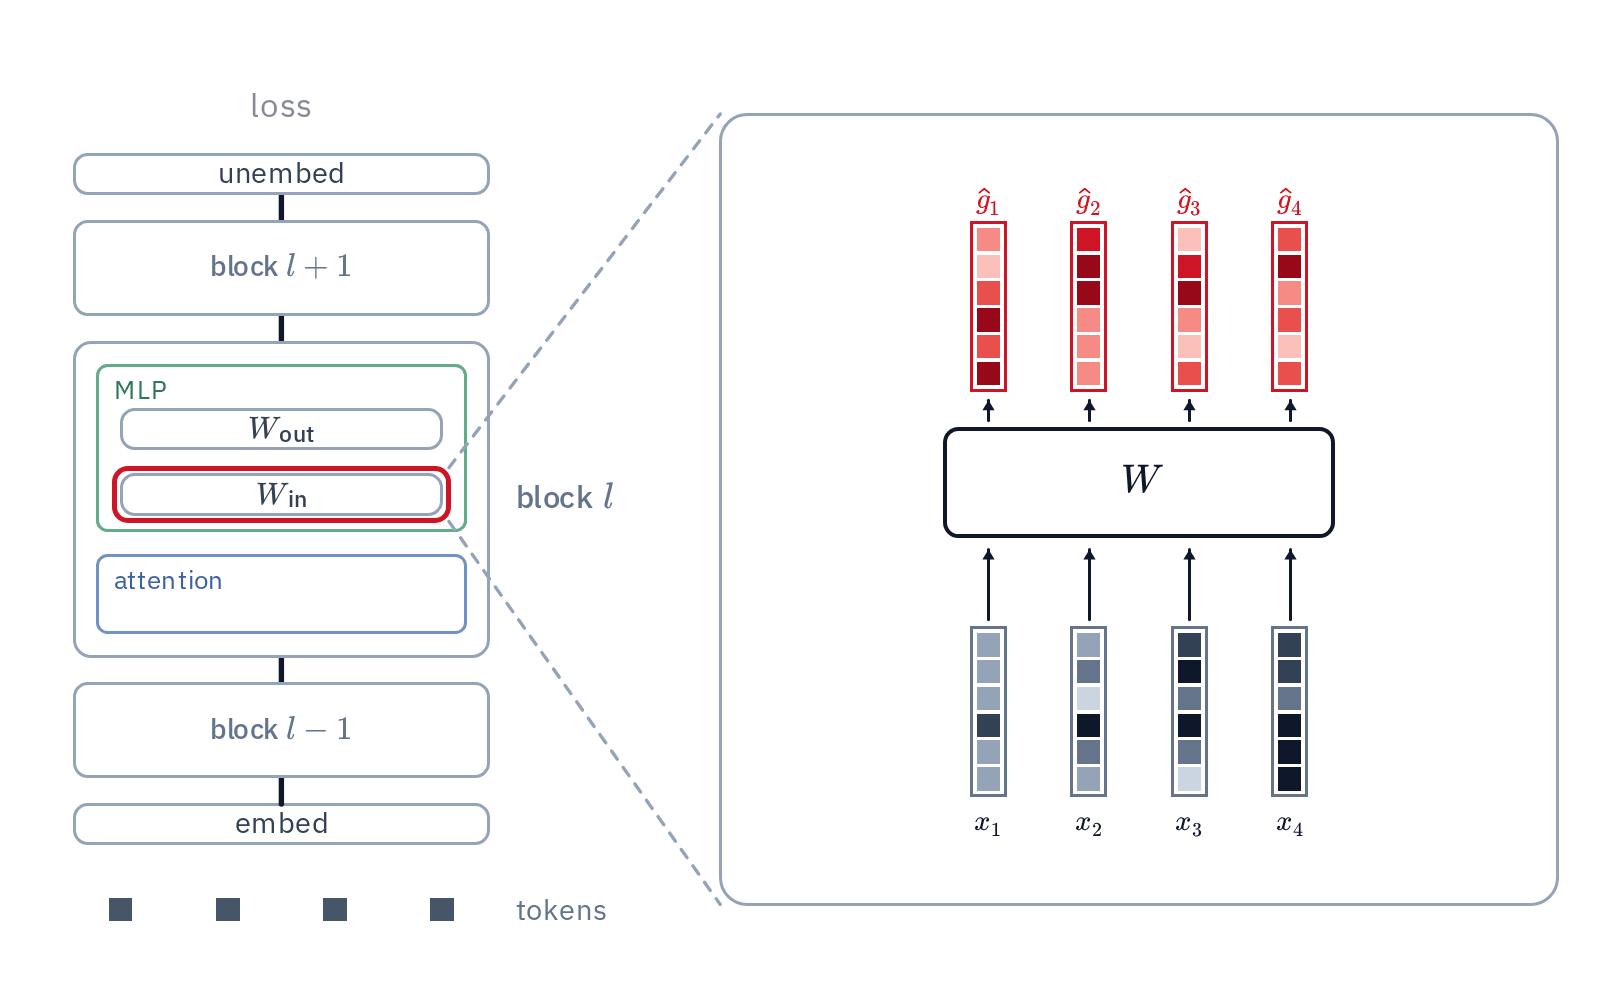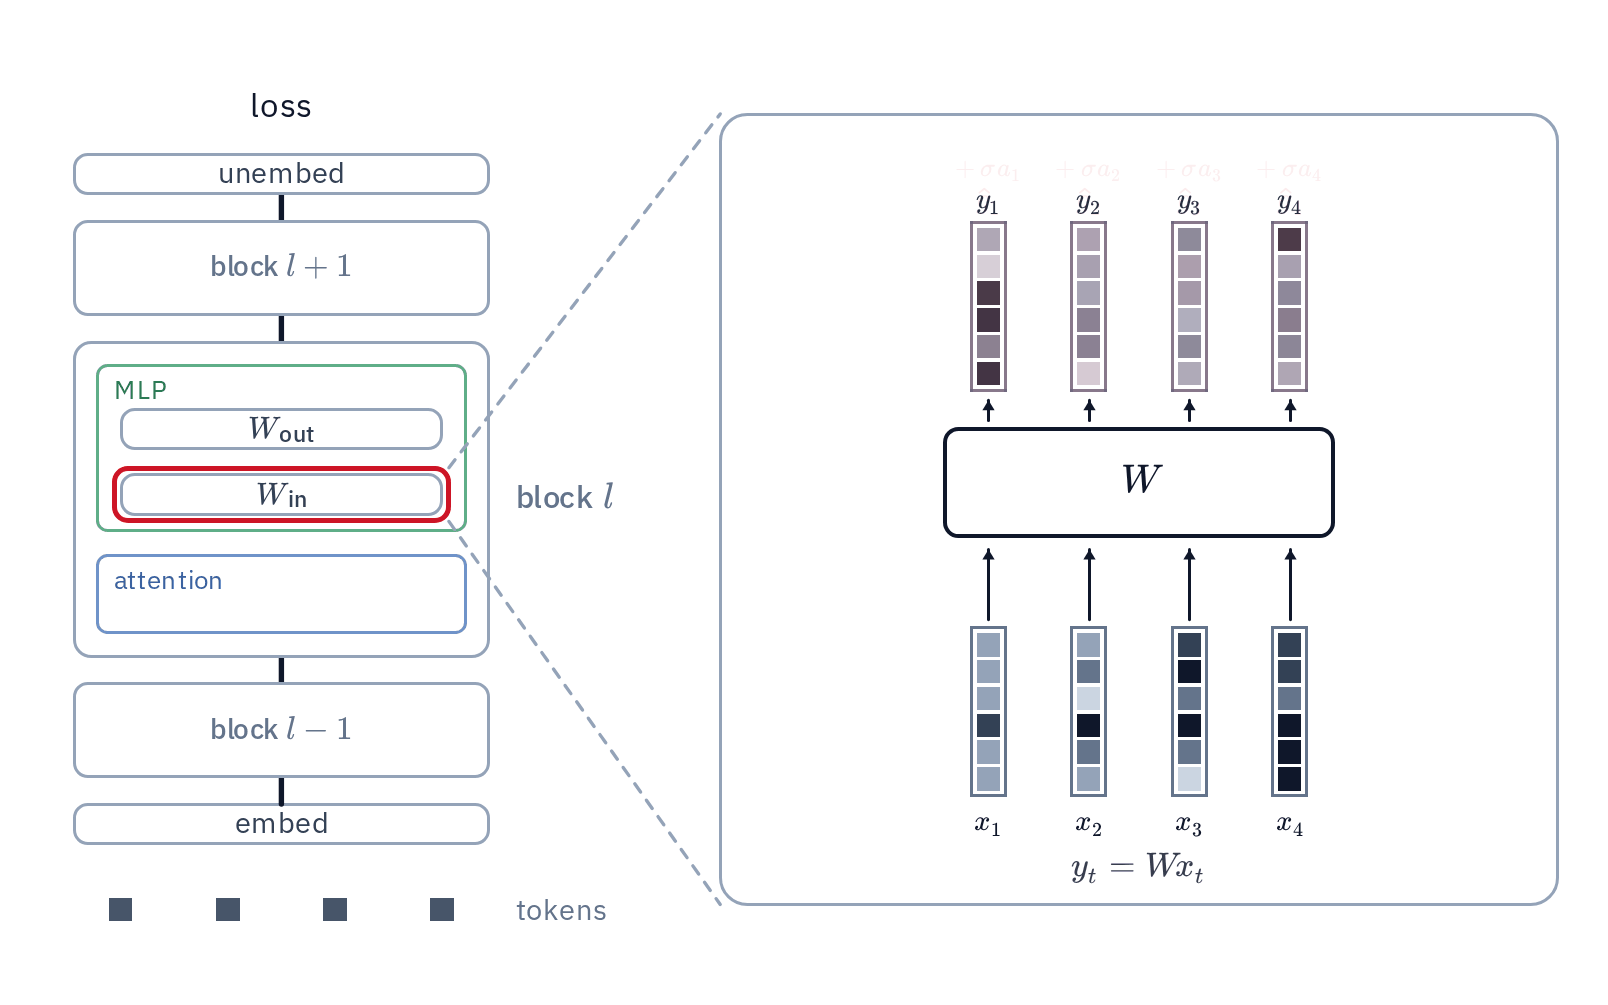
Dust 的工作方式如下。我们向每个线性层的输出加入高斯噪声,在每个 token 上独立进行,跑一次前向传播,并用该 token 处损失的变化来奖励该 token 的噪声。对多次采样取平均后,奖励加权的噪声就是该层输出处误差的估计,而它与该层输入的外积就是权重梯度。注意力内部机制采用一个变体:它们通过注意力输出在当前及未来 token 上的估计误差来获得信用,而不是直接用这些 token 的损失。核心直觉是:权重空间的 ES 每次前向传播只评估一个种群成员,而我们每次评估一个 token 一个成员,并行进行,而一个成员只需向隐藏状态加噪声即可实体化,成本很低。因此在现代 transformer 上,一次前向传播所评估的种群规模至少比权重空间 ES 大三个数量级。下面我们逐一详述各个组件。
2.1 激活空间扰动
进化策略的瓶颈是种群规模。每个成员都需要自己的一份扰动权重副本和一次自己的前向传播。EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.) 通过低秩扰动让这些副本变得廉价,但每个成员仍然只是批次中的一个序列元素,因此种群规模受限于所能负担的前向传播次数。我们改为扰动激活,在每个 token 上独立进行。在该 token 处,网络的行为就仿佛对产生该激活的层的权重施加了低秩扰动,而这一扰动从未在权重中实体化。我们称之为虚拟种群。transformer 中的一个序列有几千个 token,因此一次前向传播对每个序列评估几千个成员,而不是一个。模型中除 2L 个残差混合标量外,所有权重都以这种方式训练,而那 2L 个标量由普通的权重空间 ES 训练。
给激活值加噪、而不是给权重加噪,这叫节点扰动(Widrow and Lehr, 1990Bernard Widrow and Michael A. Lehr. 30 years of adaptive neural networks: Perceptron, Madaline, and backpropagation. Proceedings of the IEEE, 78 (9): 1415–1442, 1990. doi: 10.1109/5.58323。),支持它的常见理由是维度(Ren et al., 2023Mengye Ren, Simon Kornblith, Renjie Liao, and Geoffrey Hinton. Scaling forward gradient with local losses. In International Conference on Learning Representations, 2023.;Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。一层的输出有 个元素,权重有 个,所以激活噪声所在的空间小得多。粗略地看,这个维度论证对激活值很大、token 又多的 transformer 并不成立。一条序列上的噪声是一个 张量,一旦 ,它的元素数至少和权重矩阵一样多。不过,只要扰动和奖励都按 token 独立,扰动激活值带来的就是沿 token 轴的一个新的高效种群,它与 EGGROLL 本就依赖的 batch 轴正交。
2.2 信用分配
对一个线性层 ,我们在所有 token 上抖动它的输出,,其中 、 是噪声尺度,然后跑前向。在每个 token s 上计算去中心化的损失下降量 ,其中 是扰动后的损失, 是在同一次批量前向中一起求值的各次采样在该 token 上的平均扰动损失。token t 处抖动的奖励,就是 t 处的损失下降量,再加上以衰减 计入的、其后各 token 的损失下降量——抖动通过注意力也会影响到这些 token,
(1)
使用 时,每个抖动仅从自身的 token 获得奖励。哪些层能够看到未来的 token,由第 2.3 节的调参决定。对所有 token 各做一次独立抖动称为一次抽取,一个种群包含 K 次抽取。在多次抽取上取平均后,奖励加权的噪声
(2)
是层输出的估计误差,它与该层输入的外积(前向传播时已经算过)按 token 求和,就是权重梯度,
(3)
反向传播用相同的输入形成相同的外积。唯一的区别在于,它的输出误差来自链式法则,而我们的输出误差来自种群。对于嵌入层,xt 是 one-hot 向量,因此外积就是把 g^t\hat g_tg^t 散射累加到该 token 所在的行上。
当种群规模不受限制时,上述估计量就是完整的方法,每一次扰动都可以放进同一次前向传播中。每个样本的奖励加权噪声等于梯度加上一个无偏误差。随着样本数增加,梯度线性累加,而误差按平方根累加,因此二者的比值随种群增大而下降,在极限下干扰消失。
2.3 干扰与调参
在我们可以承受的种群规模下,主要代价是干扰,即我们在同一次前向传播中对许多层的许多 token 施加抖动,于是奖励某个 token 噪声的损失变化也会混入该次传播中其他所有扰动的影响。我们从三个方面减少这种干扰。第一,不同类型的层在各自独立的前向传播中抖动,各有自己的噪声尺度,每个 block 也有自己的传播。这些传播比完整前向更便宜,因为干净的前向已被缓存,而 block lll 的一次抽样只需重跑 lll 及其之后的 block。第二,注意力内部(query、key、value、gate、value embedding)分别抖动。token 损失几乎反映不出它们的抖动,因此改为通过注意力输出来给予奖励,具体如下。第三,语言建模头直接在缓存的 logits 上抖动,每次抽样只重新计算交叉熵,且只针对词表的一小片,代价只是前向传播的一小部分,从而让该头能跑大得多的种群。
对于注意力内部,我们仅用抖动从缓存的干净激活中重新计算其所在 block 的注意力输出。我们用与估计的注意力输出梯度的对齐程度来给抖动打分,
cs=−⟨g^s,Δos⟩,c_s = -\langle \hat g_s, \Delta o_s \rangle ,cs=−⟨g^s,Δos⟩,
(4)
其中 Δos\Delta o_sΔos 是抖动在 token s 处对注意力输出造成的改变,g^s\hat g_sg^s 是该输出由式 2 估计出的误差。奖励即式 1,用这些按头计算的分数替代损失下降量。
超参数、每种层类型的噪声尺度、注意力内部结构的信用衰减,以及每层分到的种群份额,可以用两种方式调。一种是网格搜索:在较小的 token 预算下用每组设置训练,保留使损失下降最多的那组。可靠,但贵。另一种网格搜索在单个 batch 上最大化我们的估计与反向传播梯度之间的余弦相似度,完全不需要训练。单个 batch 上余弦更大,训练后损失未必更低,所以余弦负责挑候选,训练负责定夺。无论哪种方式,调参基本都是一次性开销,因为找到的设置大体上能跨 token 预算和种群规模泛化,只有一个例外。在 10M 和 20M token 的最大种群下,更慢的信用衰减、以及把抽样更多偏向注意力一侧,仍然划算(附录 F)。因此,这个搜索得到的是方法的一般规律,而不是某一次运行的设置。不出所料,所有层都不需要来自未来 token 的信用,只有 keys、values、gates 和 value embeddings 例外——它们会被后续关注到它们的 token 读取, 接近 1。
3 无反向传播的预训练
3.1 设置
我们在 FineWeb 上训练 GPT 风格的 transformer,使用 4096 token 的 BPE tokenizer,batch 为 16k token(8 条 2048 token 的序列),训练一个 epoch,采用带动量的 SGD 和恒定学习率。基础模型有 8 层,宽度 512。每种方法使用相同的协议,每个格子跑三个随机种子,并在每个 token 预算和种群规模下单独调参。Dust 和反向传播共用一套动量和学习率网格;我们用相同的 transformer 架构实现 EGGROLL(命名为 EGGROLL-Transformer),并在它自己的步长、动量、噪声尺度和适应度塑形网格上调参。验证集和测试集各为 544 条序列的留出集。我们报告最佳验证 checkpoint 处的测试损失。
我们在 Dust 中以 draw 计 population,在 EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)中以 batch 的前向传播次数计 population,后者是我们的权重空间基线。一个 draw 是对选定层所有 token 的激活施加一次扰动,以 token loss 作为奖励,population K 即每次更新的 draw 数。一个 draw 比一次前向传播略便宜,因为干净的前向结果已被缓存,而扰动第 lll 块的 draw 只需从第 lll 块起重新运行。K 不计入 head 和 attention 内部的 draw,它们只占更新 FLOPs 的一小部分(附录 E)。综合来看,population 为 256 时,Dust 的计算量已低于同等 population 的 EGGROLL,因此这一比较对 EGGROLL 有利。
3.2 主要结果
6.0 6.5 7.0 7.5 8.0 验证损失 1M tokens 0 0.25 0.5 0.75 1 训练进度 5.0 6.0 7.0 8.0 验证损失 10M tokens 0 0.25 0.5 0.75 1 训练进度 Dust 64 1k 16k EGGROLL- Transformer 64 1k 16k 反向传播
图 1:在 1M 和 10M tokens 上训练过程中的验证损失,分别为 Dust(紫色)、相同 population 的 EGGROLL(灰色)和反向传播(黑色虚线)。横轴为已消耗 token 预算的比例。深浅表示 population,分别为 64、1k 和 16k,越大越深。曲线为三个随机种子的均值。
7.2 7.4 7.6 7.8 8.0 测试损失 100k tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 1M tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 测试损失 10M tokens 64 256 1k 4k 16k Population 4.0 4.5 5.0 5.5 6.0 6.5 7.0 7.5 20M tokens 64 256 1k 4k 16k Population
∞ 4.43 拟合 1.53 P−0.145 + 4.43 当 P → ∞ 时的极限 极限的 95% 区间 EGGROLL-Transformer Dust Backprop
图 2:在验证集选出的 checkpoint 上,测试损失随种群规模的变化;每个 token 预算对应一个面板,Dust(紫色)与 EGGROLL-Transformer(灰色)。点为表 1 中的各单元格,黑色虚线为在同一预算下调参的 backprop,虚线曲线为对 Dust 五个单元格的幂律拟合。100k 面板有独立的 y 轴范围,其余三个共用一个。在 20M 处,紫色点划线是拟合的极限值 4.43,这是从仍在下降的阶梯外推得到的, 处的误差棒是其 95% bootstrap 区间,每个种群规模下都重新采样了随机种子。
我们把 token 预算从 100k 扫到 20M,种群规模从 64 扫到 16k,并在每个预算下于同一网格上调参 backprop(表 1,图 2)。在 100k 和 1M token 下,Dust 最终低于 backprop,100k 时只用了数百次采样,1M 时用了上千次。在 10M 和 20M token 下,与 backprop 的差距随种群规模增大而缩小。10M 时阶梯已经变平,拟合出的极限略高于 backprop。20M 时,阶梯在 16k 次采样处仍在下降。其幂律拟合给出的极限为 4.431(95% 区间 3.89 到 4.58),低于 backprop 的 4.633,但阶梯仍在下降,拟合约束很松,因此我们把它读作差距随种群规模持续缩小的证据,而不是一个实测极限。
权重空间 ES 效率低得多。种群规模是 256 倍的情况下,EGGROLL 在 16k 时仍达不到 Dust 在 64 次采样时的水平。在 100k token 下它差距缩小到 0.02 以内,而在 1M、10M 和 20M 下始终高出 0.4 到 0.6(图 2)。EGGROLL 的阶梯在 16k 处仍在陡峭下降,所以种群规模再大它还会继续改善,但若把阶梯继续延伸,要达到 Dust 最小种群规模的水平,它需要的种群规模是后者的数千倍到约 10410^4104 倍(附录 D)。图 1 也展示了训练过程中的差距;Dust 在 1k 和 16k 次采样下全程紧贴 backprop 的曲线,而每条 EGGROLL 曲线都早早落后,并在远高于 Dust 在 64 次采样时的水平上变平。
3.3 Adam 下的 Dust
5.5 6.0 6.5 7.0 7.5 测试损失 100 万 token、使用 Adam 64 256 1k 4k 16k 64k ∞ 种群规模
EGGROLL-Transformer Dust 5.248 反向传播 5.361
图 3:在 100 万 token、使用 Adam 的条件下,测试损失随种群规模的变化,分别为 Dust(紫色)、EGGROLL(灰色)和反向传播(黑色,虚线)。紫色曲线是对所运行的各种群规模下种群规模的幂律拟合,紫色点划线是其极限值 5.248,低于反向传播。 处的条是极限值的 95% 自助法区间,即 5.17 到 5.30,每个种群规模下都对随机种子进行了重采样。Dust 和反向传播取五个随机种子的均值,EGGROLL 取三个;Dust 的 Adam 运行给 token 嵌入更多抽样,总计约为所列种群规模的 倍。
虽然本文余下部分主要关注 SGD,我们在三种方法上都用 Adam 重复了 100 万 token 的阶梯实验(图 3),并在每个种群规模下重新调优了反向传播的学习率、Dust 自身的超参数以及 EGGROLL 的步长、动量和适应度塑形。有意思的是,EGGROLL 从 Adam 中几乎一无所获,其调优后的 Adam 阶梯在每个种群规模下与表 1 中的 SGD 阶梯相差不到 0.01。然而,Adam 同时改善了 Dust 和反向传播,且阶梯的形状与之前相似。Dust 在种群规模较大时逼近反向传播,其极限值的区间位于反向传播之下(图 3)。因此,Dust 的估计已经能与现代优化器配合工作,尽管现代优化器是为反向传播梯度而优化的。我们怀疑优化器与 Dust 的协同进化可能带来进一步的收益,并将此留作未来工作。
4 高维空间中的搜索
4.1 过参数化
每行内的测试损失该行最低该行最高
| 种群规模 | 参数量 | 跨规模 | |||
|---|---|---|---|---|---|
| 2.0M | 7.3M | 38M | 243M | ||
| 64 | 5.705 | 5.556 | 5.558 | 5.719 | |
| 256 | 5.486 | 5.362 | 5.358 | 5.419 | |
| 1k | 5.265 | 5.161 | 5.158 | 5.214 | |
| 4k | 5.189 | 5.095 | 5.053 | 5.124 | |
| 16k | 5.171 | 5.065 | 5.036 | 5.086 | |
| 反向传播 | 5.180 | 5.066 | 5.015 | 5.048 |
图 4:固定 10M token 下四种模型规模,参数量从 2M 到 243M(L2/d128、L4/d256、L8/d512、L16/d1024),测试损失随种群规模的变化。各规模使用相同的单元数和反向传播,每个种群规模下最优的规模以粗体标出。
传统观点认为,零阶方法无法训练大型网络(Lillicrap et al., 20Timothy P. Lillicrap, Adam Santoro, Luke Marris, Colin J. Akerman, and Geoffrey Hinton. Backpropagation and the brain. Nature Reviews Neuroscience, 21 (6): 335–346, 20. doi: 10.1038/s41583-020-0277-3。)。一次前向传播只返回一个标量,因此梯度估计的方差随扰动维数增加而增大,做出一次有效更新所需的种群规模也随之增大(Nesterov and Spokoiny, 2017Yurii Nesterov and Vladimir Spokoiny. Random gradient-free minimization of convex functions. Foundations of Computational Mathematics, 17 (2): 527–566, 2017. doi: 10.1007/s10208-015-9296-2。;Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。我们直接检验了这一点:在固定 10M token、遍历整个种群规模范围的条件下训练四种规模,2M、7M、38M 和 243M 参数(参数量跨度达 )(图 4;调参细节见附录 F)。我们得到两个与主流认知相悖的显著观察。
- 更大的模型往往种群效率更高,而非更低。 在 256 及以上的每一个种群规模下,损失都从 2M 降到 7M 再降到 38M 参数,而 243M 模型只是略差。即便在我们测试的最小种群规模下,大 倍的模型表现也大致相当,而在其他所有种群规模下都更好。在一定范围内,更大的模型从规模中获得的收益超过了它在方差上的损失。不过我们观察到,在相同种群规模和模型规模下,与反向传播的差距随模型规模增大而增大,但几乎可以忽略,尤其是在大种群规模下。
- 小模型趋于平缓时,大模型仍随种群规模持续改善。 小模型更早饱和,大模型则随种群规模增大持续改善。超过 1k 次采样后,38M 和 243M 模型的收益比 2M 和 7M 高出约 30%,而且再多的种群规模也无法让最小的模型具备竞争力。
对模型规模更恰当的理解方式,是把它看作搜索空间的大小与几何形状。模型越大,可搜索的空间就越大,因而能支撑起更大的种群规模;同时损失曲面的条件数可能更好,这或许解释了为什么即便种群很小,搜索依然更有效。
4.2 类反向传播梯度的涌现
0.00 0.05 0.10 与反向传播梯度的余弦相似度 EGGROLL,10M tokens 64 1k 16k 128k 0.00 0.25 0.50 0.75 1.00 Dust,10M tokens 64 1k 16k 128k Dust,100M tokens 64 1k 16k 128k Dust,1B tokens 64 1k 16k 128k 种群 MLP 平均 Q K V head
图 5:同一批次上估计梯度与反向传播梯度的余弦相似度,按层类型给出(对层取平均;MLP 取输入与输出投影的平均),横轴为种群规模。Dust 使用在 10M、100M 和 1B tokens 上经反向传播训练的检查点,EGGROLL 使用相同算力预算下 10M tokens 的结果(左图,注意坐标轴)。Dust 的曲线是拟合规律 ,由种群规模 64 到 128k 的测量值拟合得到;EGGROLL 的曲线则直接连接各测量点。竖直虚线是各阶梯训练所用的 16k 种群规模。初始化状态以及 EGGROLL 在 100M tokens 下的结果见附录 B。
我们测量了 Dust 的估计梯度与同一批次上反向传播梯度之间的余弦相似度,按层类型和按层分别统计,所用检查点经反向传播训练、token 数跨越两个数量级,即从 10M 到 1B tokens,每步的前向传播次数(种群规模)从 64 增长到 128k(图 5)。在训练的每个阶段,每种层类型的余弦相似度都随种群规模上升,而一个双参数规律
(5)
对每种层类型的拟合 RMSE 均低于 0.06,其中 是上界,c 是该层达到 时的种群规模。有用的梯度仅凭大种群就涌现出来,没有任何链式法则被内置其中,只是按第 2.3 节所述对超参数做了轻微调整,以最大化余弦相似度。对 100M token 的检查点,各层类型平均余弦相似度的拟合 RMSE 为 0.0032–0.0367(详见附录 G)。Dust 的梯度在余弦相似度上接近反向传播,但接近程度因层类型和具体层而异。EGGROLL 的估计在相同前向传播次数下以同样方式测量,虽然随种群规模增长,但在 128k 时除 head 外每种层类型的余弦相似度仍低于 0.05,这或许解释了为什么第 3.2 节中基于它的训练毫无进展。
重要的是,随着 token 数量增长,余弦相似度在大多数层中都保持稳定,这对扩展性来说是个好信号。第 3 节表明,要匹配并超越 backprop 所需的种群规模会随 token 增加而增长。但在大种群下,余弦相似度在两个数量级的 token 范围内保持平坦,这意味着当种群足够大时,这一要求可能不再随 token 增加而增长。此外,Dust 的梯度接近 backprop 的梯度,但并不精确收敛于它,这其实是个好性质。估计值指向相近的方向,却不是 backprop 的梯度,因此会导向不同的优化轨迹,而在我们的实验中,这条轨迹甚至可以优于 backprop 的(第 3.2 节)。
5 结论
自 Rumelhart et al. (1986)David E. Rumelhart, Geoffrey E. Hinton, and Ronald J. Williams. Learning representations by back-propagating errors. Nature, 323: 533–536, 1986. 以来,backprop 一直是训练神经网络的算法,我们现有的架构、优化器和硬件也都是围绕它构建的。随着算力变得越来越充裕,我们认为完全可能有更好的替代方案。我们提出了 Dust,它大幅改进了现有的 ES 算法,在预训练 transformer 上能很好地逼近 backprop,在算力充足时甚至可以超越它。
还有许多有趣的开放问题。第一,Dust 能否、以及如何通过隐式探索损失景观找到比 backprop 一阶梯度更好的方向,捕捉到更高阶的曲率,把搜索拉向平坦区域。我们有迹象表明它可以,因为在大种群下它有时会落到 backprop 之下,但机制尚不清楚。第二,Dust 打开了架构的搜索空间,因为它不需要网络端到端可微,在 backprop 已知会吃力的地方可能表现更好,比如用时间反向传播训练的循环或 looped 计算。第三,算力效率,这不是本文的重点。在当前算力水平下,Dust 要成为 backprop 的实用替代方案,我们必须把算力效率提升几个数量级。
6 相关工作
语言模型零阶预训练的早期工作(Allaire et al., 2025Nathan Allaire, Mahsa Ghazvini Nejad, Sébastien Le Digabel, and Vahid Partovi Nia. Zeroth order optimization for pretraining language models. In Proceedings of ICPRAM, pages 113–121, 2025. doi: 10.5220/0013261100003905. URL https://doi.org/10.5220/0013261100003905.)考察了通过权重扰动从零开始训练 transformer 的难度。他们后续提出的方法 KronZO(Allaire et al., 2026Nathan Allaire, Sébastien Le Digabel, Dominique Orban, and Vahid Partovi Nia. Zeroth-order Kronecker optimization for pretraining language models. SN Computer Science, 7, 2026. URL https://www.gerad.ca/en/papers/G-2025-44. Article 162.)采用具有 Kronecker 结构的紧凑扰动和选择性方向更新,在改善预训练效果的同时降低了内存占用。EGGROLL(Sarkar et al., 2025Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2025.)借助低秩结构,使大规模权重扰动种群在 GPU 上变得高效。Dust 则转而搜索激活值,并利用每个 token 的奖励,从每次前向传播中提取更多信用分配信息。
在微调方面,MeZO(Malladi et al., 2023Sadhika Malladi, Tianyu Gao, Eshaan Nichani, Alex Damian, Jason D. Lee, Danqi Chen, and Sanjeev Arora. Fine-tuning language models with just forward passes. In Advances in Neural Information Processing Systems, volume 36, 2023.)表明,仅靠前向传播、内存占用接近推理水平,即可完成语言模型的适配。Evolution Strategies at Scale(Qiu et al., 2026Xin Qiu, Yulu Gan, Conor F. Hayes, Qiyao Liang, Yinggan Xu, Roberto Dailey, Elliot Meyerson, Babak Hodjat, and Risto Miikkulainen. Evolution strategies at scale: LLM fine-tuning beyond reinforcement learning. In Proceedings of the International Conference on Machine Learning, 2026. URL https://arxiv.org/abs/2509.24372. arXiv:2509.24372.)展示了用 ES 对数十亿参数语言模型进行全参数微调。Neural Thickets(Gan and Isola, 2026Yulu Gan and Phillip Isola. Neural thickets: Diverse task experts are dense around pretrained weights. arXiv preprint arXiv:2603.12228, 2026. URL https://arxiv.org/abs/2603.12228.)通过随机扰动预训练权重、挑选最佳候选并集成其预测,找到了有用的任务专家。这些结果说明,围绕一个预训练模型,搜索能取得多大的成效。而我们的实验则针对从零预训练、直接学习表示本身这一问题。
我们的激活扰动建立在节点扰动之上(Werfel et al., 2003Justin Werfel, Xiaohui Xie, and H. Sebastian Seung. Learning curves for stochastic gradient descent in linear feedforward networks. In Advances in Neural Information Processing Systems, volume 16, 2003.)。GEMINI(Le Cun et al., 1988Yann Le Cun, Conrad C. Galland, and Geoffrey E. Hinton. GEMINI: Gradient estimation through matrix inversion after noise injection. In Advances in Neural Information Processing Systems, volume 1, pages 141–148, 1988. URL https://proceedings.neurips.cc/paper/1988/file/a0a080f42e6f13b3a2df133f073095dd-Paper.pdf。)向第一个隐藏层注入噪声,并通过迭代矩阵求逆来恢复逐层的梯度估计。Zoop(Hu et al., 2025Xixi Hu, Bo Liu, Qiang Liu, Xiaocong Du, Bhargav Bhushanam, Louis Feng, Chengyue Gong, and Kaizhao Liang. Zoop it! Efficient zero-order optimization with output perturbation. In ICML Workshop on Tiny Titans: The next wave of On-Device Learning for Foundation Models, 2025. URL https://openreview.net/forum?id=Tc8vFyRhPO.)利用输出扰动微调语言模型,借助局部导数将估计出的输出梯度转换为参数更新。Scaling Forward Gradient with Local Losses(Ren et al., 2023Mengye Ren, Simon Kornblith, Renjie Liao, and Geoffrey Hinton. Scaling forward gradient with local losses. In International Conference on Learning Representations, 2023.)将激活扰动、局部损失与前向模式自动微分相结合,以降低估计量的方差。Forward gradients with multiple tangents(Flügel et al., 2025Katharina Flügel, Daniel Coquelin, Marie Weiel, Charlotte Debus, Achim Streit, and Markus Götz. Beyond backpropagation: Optimization with multi-tangent forward gradients. In International Joint Conference on Neural Networks, 2025. URL https://arxiv.org/pdf/2410.17764v2.)同样采用前向模式微分,通过正交投影组合多个方向导数来改进梯度估计。
另一条研究路线用局部学习动力学取代全局反向传播:Sakana AI 的 PC-ALM(Seely and Gould, 2026Jeffrey Seely and Julian Gould. Augmented Lagrangian predictive coding. arXiv preprint arXiv:2605.31022, 2026. URL https://arxiv.org/abs/2605.31022.)通过局部预测编码动力学和拉格朗日乘子来传播信用。它使用局部导数,并在图像分类任务上进行评估。Dust 则在 transformer 预训练期间从正向扰动中估计信用,将每个 token 的奖励与注意力输出的局部目标结合起来。
完整参考文献列表见原论文。