更快的傅里叶变换
Ben Recht 读了 OpenAI 那篇声称做出更快 FFT 的论文:改进只在指数上小了 10^-13,要等 n 超过 10^(10^10^15) 才回本,所以这不是突破,是钻大 O 记号空子的做法。
更多 research
首页Ben Recht 读了 OpenAI 那篇声称做出更快 FFT 的论文:改进只在指数上小了 10^-13,要等 n 超过 10^(10^10^15) 才回本,所以这不是突破,是钻大 O 记号空子的做法。
2011年,沙希德·侯赛因买了一张名为Salvage的乐队的CD单曲,之后却怎么也找不到他们的任何踪迹。十五年后,他找到了制作人和乐队成员,得知了背后的故事。
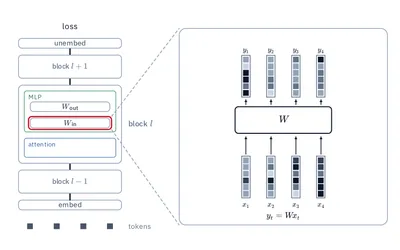
Dust 无需反向传播即可预训练 transformer,它利用激活空间中的扰动来决定哪些权重应获得信用。论文报告了多个规模下的结果,并讨论了该方法在哪些方面仍落后于标准训练循环。
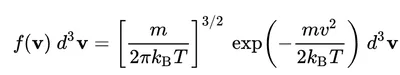
Dylan Black 让 Jev 生成物理上合理的概率分布来检验它的校准。结果是 Jev 比彻底放弃、把概率平均分摊还差,而且失败模式很成系统,作者据此质疑把 Jev 当作自动评判器的做法是否安全。
物理学教授 Matthew Schwartz 不再逆着 Claude 的脾气用,而是去找那些恰好适合当前一代模型能力的问题:把知识当作可搜索集、用几何直觉判定边界的任务。他交出两篇完成的研究,并描述了背后的 BootLoops harness。
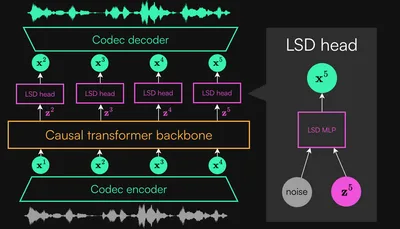
Kyutai 把连续音频语言模型里的一步流匹配目标(LSD)换成 drifting:指标全部持平、推理成本不变,却不再需要 Jacobian-vector 乘积。这是首个用 drifting 训练的自回归生成模型。
MOCHA 想让编译器快速适配从没见过的异构加速器,那测试基准怎么选?SEI 列出五个筛选维度与九项候选硬件,并请各团队自己推举目标,最终落在 AMD RDNA 4 与 Tenstorrent Tensix 上。
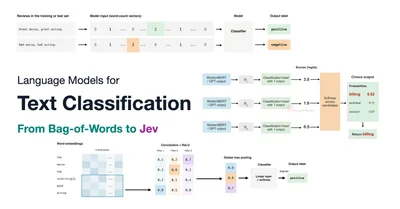
从朴素贝叶斯、RNN、CNN 到 Transformer,Raschka 梳理了文本分类的整条技术路线,再用 IMDb 实测 Jev:Choice API 达 96.47% 准确率、成本 0.65 美元,与微调后的 ModernBERT 相当,且不需训练。
Anthropic 用约 950 个 Claude agent 搜了 21 小时 DNA 数据库,发现噬菌体里一个带 CRISPR 式重复序列的新型酶系统 ART;它由逆转录酶、伙伴基因和重复阵列组成,功能与用途均未知。
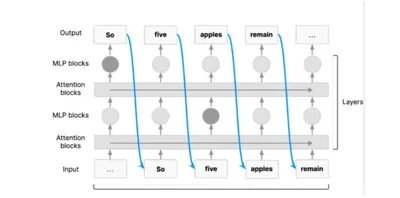
AI 2027 提出的神经语递归让 AI 以向量思考、无法被读懂,OpenAI 首席科学家 Pachocki 回应称并未实现。
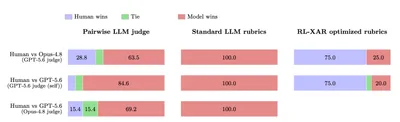
RL-XAR 通过元优化评分标准,让 LLM 评判者重新偏好专家人类写作,在论文段落、普利策小说续写和 Wikipedia 上大幅超越标准训练。