更快的傅里叶变换
Ben Recht 读了 OpenAI 那篇声称做出更快 FFT 的论文:改进只在指数上小了 10^-13,要等 n 超过 10^(10^10^15) 才回本,所以这不是突破,是钻大 O 记号空子的做法。
中文
复制
快速傅里叶变换是数字信号处理领域最重要的创新之一,也是我最喜欢的算法之一。FFT 能快速提取信号的频率成分,让你迅速分析、过滤和操纵频谱中不同频段的频率。
傅里叶变换通过一个简单的点积来计算每个频段的能量。1 设 x 为输入,一个长度为 n 的采样数组,f 为一个频率。那么 x 在 f 处的频率成分含量可由下式计算:
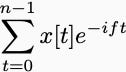
对于数字信号,稍作推导就能看出,只需计算 n 个这样的点积,即在频率 2𝜋/n 的每个倍数处各算一个,就能掌握全部频率成分。朴素地做,每个频率需要 n 次乘法和加法。因此,计算整个傅里叶变换看似需要 n2 次算术运算。
_快速_傅里叶变换是 James Cooley 和 John Tukey 于 1965 年提出的巧妙递归过程。2 核心思想是:长度为 n 的傅里叶变换可以通过打乱输入向量、对打乱后的分量分别计算两个长度为 n/2 的傅里叶变换,再用基本算术运算重新组合输出来完成。打乱和重组只需要线性次数的算术运算。迭代重复这一过程,即重复 log2(n) 次,就能算出完整的离散傅里叶变换。算上各种簿记开销,FFT 计算长度为 n 的傅里叶变换所需的算术运算少于 5 n log2 n 次。
为了让这种加速更具体:当 n 为 1,000 时,n^2 是 1,000,000,而 5 * n log n 约为 50,000,加速 20 倍。当 n 为 1,000,000 时,加速达 10,000 倍。在信号处理应用的约束下,这种加速往往决定了一个变换究竟算得出来还是算不出来。
自 FFT 发明以来,人们一直在寻找更快的傅里叶变换。其中一个问题是:到底能有多快。计算 FFT 似乎至少需要 n 次运算,因为光是把它写下来就要 n 步。FFT 比这个合理的速度下限慢 5log2(n) 倍,而 5log2(n) 这个因子可能很大。当 n 为一万亿时,它是 200。能不能想点巧办法,把这个 200 的系数降下来?
这不,上周 OpenAI 往数学界扔了一大堆论文,其中声称做出了更快的傅里叶变换。那篇名字起得很有辨识度的 “main.pdf” 给出的主要结论是
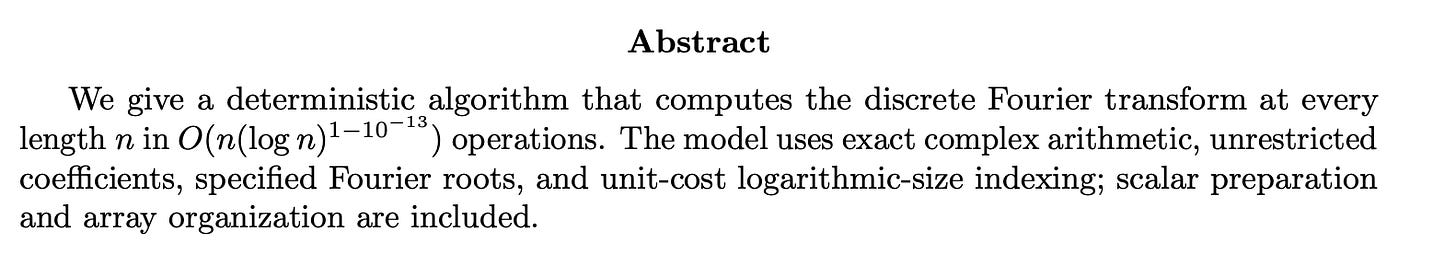
我很好奇这到底是怎么回事。理论上,那个 log(n) 项比标准 FFT 小了一丁点。
我读这篇论文了吗?当然没有。OpenAI 里也没人读过,那我凭什么读?我做了全世界每个数学家面对 AI 垃圾数学时都会做的事:把它再喂回垃圾机器,用聊天机器人界面开一场信息检索会话,把要点榨出来。拟人一点说:我问 ChatGPT 怎么看它自己的输出。这就是我们如今做数学研究的方式。什么世道。
遗憾的是,我没找到更快的傅里叶变换。我找到的是应用数学理论内部滋生的腐烂——当形式化与现实脱节到如此地步,所谓“突破”不过是数学家没法用自然语言把自己的游戏规则说清楚所留下的产物。
首先,“大 O”记号已经被滥用到了毫无意义的程度。复习一下定义吧,我本科时对它印象很深。一个算法的运行时间 T(n) = O(F(n)),当且仅当存在整数 N 和常数 C,使得
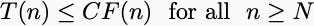
也就是说,只要 n 足够大,算法实际执行的步数就被某个方便的函数 F(n) 乘以一个常数所上界。F(n) 通常是熟悉且可解释的东西,比如多项式或指数函数。这个记号的意思是,我们只关心计算规模很大时会发生什么。我们关心计算时间的渐近增长率。所有常数都是等价的。
Big-O 记法在算法分析里用来走捷径很方便,但它也纵容了一种惊人的逻辑懒惰。如果我们想要一个实际更快的 FFT,我们要的是一个对合理大小的 n 只需要少于 50n 次操作的算法。但 O(n) 并不意味着 50n。它可能意味着 10⁸⁰n。这也会被算作“线性时间”算法。一个需要 n + 10⁸⁰ 次操作的算法,在大 O 的框架下同样算线性时间。一个只在 n 大于 10⁸⁰ 时才保证线性时间的算法,也算线性时间。10⁸⁰ 大约等于已知宇宙中的原子数。正因如此,Richard Lipton 和 Ken Regan 把隐藏常数大到不可想象的算法称为_galactic algorithms_。
OpenAI 的 FFT 算法无疑是 galactic 的。当 N=10¹² 时,C 的估计值是 10¹⁰⁰。所以即便 n=10¹⁰⁰,古老的 Cooley-Tukey-Gauss FFT 也要快 10⁹⁹ 倍。
那这个新的 FFT 结果为什么有意思?注意,在大 O 记法下,它在技术上确实比 Cooley-Tukey 算法_渐近_更快,因为
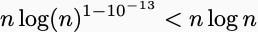
行吧。但考虑到那些常数,这个算法只有在 n 大到不可能时才跑得更快。粗略地说,你需要
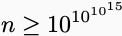
鬼知道这个数是什么意思。
Lipton 和 Regan 认为 galactic 算法有用,因为它们能推动研究。一旦你证明某个运行时间在渐近意义上是可能的,你就可以花时间去寻找一个实际能达到这个可证运行时间的算法。也许你可以派你的 AI agent 集群去追它。随你便。也许你最终能搞出一个实用的算法,但我不知道有哪个真实案例是这样发生的。我在这里尤其怀疑,因为 OpenAI 所用的“计算”模型和真实的计算机毫无相似之处。
“该模型使用精确复数运算。”这意味着它假设你可以以任意精度存储和相乘复数。事实上,这个算法要求你相乘的复数,其模会随 n _超多项式_增长。如果你把这些数按位存储,内存需求实际上会是输入长度的指数级。它假设你能在一次操作里把任意大的这种复数乘在一起。我们没有能做到这一点的计算机。所以即便 main.pdf 里的这个定理是“真的”(没人知道,我也不在乎),它也没有真正解决我们当初寻找更快 FFT 时想要解决的问题。
对于熟悉 FFT 理论分析的人来说,要打破 FFT 的速度极限就得用一套荒谬的计算模型,这并不令人意外。1973 年,Jacques Morgenstern 证明了,如果要求计算中使用的复数系数幅度有界,就不可能得到比 ½ n log n 更快的傅里叶变换。故事本应到此为止!但并没有。人们说 Morgenstern 的受限系数模型限制太强。四十年后,Nir Ailon 证明了,若不想出现严重的数值不稳定性,就不可能以快于 n log n 的速度计算 FFT。我猜这对某些人来说也还是太受限了。
所以这个新的 OpenAI 成果与其说是数学突破,不如说是计算机科学家不擅长形式化自己的设计规格所导致的怪事。计算机的“理论”定义与我们实际建造的计算机相去甚远。这个“更快”的傅里叶变换只是一个例子,说明理论可以偏离原问题到何种程度,以至于一个“开放问题”沦为了学术地位谜题。它的解法就像你把计算 bot 流投向不可能的问题,然后发现它们在进行非法黑客攻击。
这个 OpenAI 垃圾库中许多其他“重大”成果也可以用同样的方式批评。例如,其中一个成果是一个 galactic 算法,用 O(n^2.25) 次运算完成两个矩阵相乘。论文中使用的构造甚至无法让你估计隐藏在大 O 里的常数。3 它大可以就是无穷大,只有靠天球的神圣音乐才能计算出来。
不过,如果写得好得多,这些论文本可以进入计算机科学理论领域最负盛名的发表场所(即 STOC 或 FOCS 的同行评审会议论文集)。4 那篇矩阵乘法论文很可能还会获奖。但这两者都与计算机毫无关系!
这是因为计算机科学理论有一种文化,主动抑制在计算机上运行算法。在理论会议上发表论文,断言某个算法存在却从不把它写下来,是可以接受的。计算机科学理论已经变成了一种不关心计算机的数学,而且对于这些数学追求之外的影响力,它几乎不提供回报。我把这一点解释给一位朋友听,他对我评论说,“理论”有一个跨学科的含义,即“躲在自己制造的默默无闻之中”。
AI 特别擅长把我们最糟糕的倾向自动化。它放大那些没人喜欢、但任何个体都无法合理偏离的潜规则。它利用那些抵制集体行动的机械化传统。顺着这个思路,AI 现在能写没用的理论论文了。不过,也许在 OpenAI 那堆令人反胃的证明垃圾的荒诞之中,我们可以一起抬起头来意识到,该考虑做点别的了。
1 现在的年轻人管这叫余弦相似度。
2 维基百科页面说这应该归功于 1805 年的 Gauss!在学术界,正确归属功劳是个长期存在的问题。
3 那篇论文证明了:对每个大于 0 的 epsilon,都存在一个常数 C,使得 T(n) <= n^(2.25 + epsilon + C/log(n))。不管我用什么查询,都没法让 OpenAI 的模型给出 C 的定量估计。算了!
4 另一个糟糕的传统是,计算机科学把最负盛名的发表场所选成了审稿草率的会议论文集。
来源: argmin.net← 返回首页