より高速なフーリエ変換
Ben Recht は、より高速な FFT を実現したと主張する OpenAI の論文を読んだ。改善は指数で 10^-13 ぶん小さくなっただけで、n が 10^(10^10^15) を超えないと元が取れない。突破口ではなく、ビッグ O 記法の穴を突いたものだという。
日本語
コピー
高速フーリエ変換はデジタル信号処理における最も重要な発明のひとつであり、私が最も好きなアルゴリズムのひとつでもある。FFT は信号の周波数成分を素早く取り出し、スペクトルのさまざまな帯域を手早く分析・フィルタリング・操作できるようにしてくれる。
フーリエ変換は、各周波数帯域のエネルギーを単純な内積で計算する。x を入力、つまり長さ n のサンプル配列とし、f をひとつの周波数とする。このとき、周波数 f における x の成分は次式で求まる:
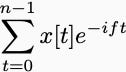
デジタル信号の場合、少し式をいじれば、この内積を n 個——周波数 2𝜋/n の各倍数につきひとつずつ——計算するだけで全周波数成分が得られることがわかる。素朴にやれば、各周波数に n 回の乗算と加算が要る。つまりフーリエ変換全体の計算には n² 回の算術演算が必要に見える。
_高速_フーリエ変換は、James Cooley と John Tukey が 1965 年に発表した巧妙な再帰的手続きである。核心となるアイデアはこうだ:長さ n のフーリエ変換は、入力ベクトルを並べ替え、並べ替えた成分に対して長さ n/2 のフーリエ変換をふたつ別々に計算し、その出力を基本演算で組み直すことで実行できる。並べ替えと組み直しに必要な算術演算は線形回数で済む。この過程を繰り返す——つまり log₂(n) 回繰り返す——ことで、離散フーリエ変換全体が計算できる。諸々の帳簿付けの手間を込みにしても、長さ n のフーリエ変換を FFT で計算するのに必要な算術演算は 5 n log₂ n 回未満だ。
この高速化を具体的に言えば:n が 1,000 のとき、n² は 1,000,000 だが、5 n log n はおよそ 50,000 で、20 倍速い。n が 1,000,000 なら 10,000 倍になる。信号処理の応用が抱える制約のもとでは、この差が変換を計算できるかできないかを分けることもしばしばだ。
FFT の発明以来、人々はより速いフーリエ変換を探し続けてきた。ひとつの疑問は、いったいどこまで速くできるのか、というものだ。FFT の計算には少なくとも n 回の演算が必要に見える。書き下すだけで n ステップかかるからだ。FFT はこのもっともらしい下限より 5 log₂(n) 倍遅く、この 5 log₂(n) という因子はかなり大きくなりうる。n が 1 兆なら 200 だ。何かうまい手を使って、この 200 という係数を下げられないだろうか?
そこでだ。先週 OpenAI が数学界に論文を大量に投げ込み、その中でより速いフーリエ変換を成し遂げたと主張した。その名も印象的な “main.pdf” が導く主結論はこうだ。
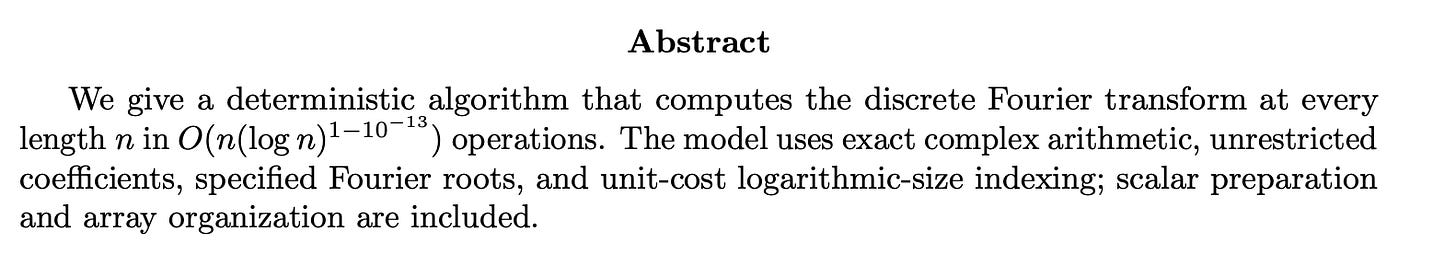
これが一体どういうことなのか気になった。理屈の上では、あの log(n) の項が標準的な FFT よりほんのわずか小さい。
私がこの論文を読んだかって?まさか。OpenAI の中でも誰も読んでいないのに、私が読む理由があるだろうか。私は世界中の数学者が AI のゴミ数学に直面したときに必ずやることをやった:それを再びゴミ機械に食わせ、チャットボットの画面で情報検索のセッションを開き、要点を搾り取ったのだ。擬人化して言えば、ChatGPT に自分の出力をどう思うか尋ねたわけだ。これが今日の数学研究のやり方である。なんという世の中だ。
残念ながら、より速いフーリエ変換は見つからなかった。見つけたのは、応用数学の理論の内側に繁殖した腐敗だった——形式化が現実からここまで乖離すると、いわゆる「ブレークスルー」は、数学者が自分のゲームのルールを自然言語で説明できないことの産物でしかなくなる。
まず、「大 O」記法は無意味なまでに濫用されている。定義をおさらいしよう。学部時代に強く印象に残ったものだ。アルゴリズムの実行時間 T(n) = O(F(n)) であるとは、整数 N と定数 C が存在して、次が成り立つことをいう。
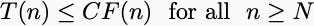
つまり、n が十分大きければ、アルゴリズムが実際に実行するステップ数は、都合のよい関数 F(n) に定数を掛けたもので上から抑えられる。F(n) は通常、多項式や指数関数といったおなじみで解釈しやすいものだ。この記法が意味するのは、計算の規模が大きいときに何が起きるかだけを見る、ということである。計算時間の漸近的な増え方に関心があるのだ。定数はすべて等価だ。
Big-O 記法はアルゴリズム解析で近道をするのに便利だが、同時に驚くほど論理を怠けることを許してしまう。実際に速い FFT が欲しいなら、必要なのは妥当な大きさの n に対して 50n 回未満の操作で済むアルゴリズムだ。だが O(n) は 50n を意味しない。10⁸⁰n かもしれない。それでも「線形時間」アルゴリズムに数えられてしまう。n + 10⁸⁰ 回の操作を要するアルゴリズムも、大 O の枠組みでは同じく線形時間だ。n が 10⁸⁰ より大きいときにのみ線形時間が保証されるアルゴリズムも、線形時間である。10⁸⁰ はおよそ既知の宇宙にある原子の数に等しい。まさにこの理由から、Richard Lipton と Ken Regan は、隠れた定数が想像を絶するほど大きいアルゴリズムを_galactic algorithms_ と呼んだ。
OpenAI の FFT アルゴリズムは疑いなく galactic だ。N=10¹² のとき、C の推定値は 10¹⁰⁰ である。つまり n=10¹⁰⁰ であっても、古き Cooley-Tukey-Gauss の FFT のほうが 10⁹⁹ 倍速い。
では、この新しい FFT の結果の何が面白いのか。よく見てほしい。大 O 記法の世界では、これは確かに Cooley-Tukey アルゴリズムより_漸近的に_速い。なぜなら
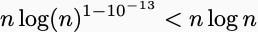
まあ、その通りだ。だが定数を考慮に入れると、このアルゴリズムが速くなるのは n が非現実的な大きさになってからだ。ざっくり言えば、必要なのは
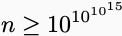
この数が何を意味するのか、私には見当もつかない。
Lipton と Regan は、galactic アルゴリズムには役に立つ面があると主張する。研究を前進させるからだ。ある実行時間が漸近的に可能だと証明してしまえば、その実行時間を実際に達成するアルゴリズムを探すことに時間を割ける。AI エージェントの群れを送り込んで追わせてもいい。好きにすればいい。最終的に実用的なアルゴリズムが生まれるかもしれないが、そうなった実例を私は知らない。ここで特に疑わしいのは、OpenAI が使っている「計算」のモデルが、実際のコンピュータとほとんど似ても似つかないことだ。
「このモデルは正確な複素数演算を用いる。」つまり、任意精度で複素数を保存し、掛け算できると仮定している。だが実際には、このアルゴリズムが掛け算を要求する複素数は、その絶対値が n に対して_超多項式的_に増大する。これらの数をビット列として保存するなら、メモリ所要量は入力長に対して事実上指数関数的になる。任意に大きなこうした複素数を 1 回の操作で掛け合わせられると仮定している。そんなことができるコンピュータは存在しない。だから main.pdf の定理が「正しい」としても(誰も知らないし、私も気にしない)、我々がより速い FFT を探していたときに解こうとしていた問題を、実際には何も解決していない。
FFT の理論解析に馴染みのある人にとって、FFT の速度限界を破るには馬鹿げた計算モデルが必要になるのは驚きではない。1973 年、Jacques Morgenstern は証明した。計算に使う複素係数の絶対値が有界であることを要求すれば、½ n log n より速いフーリエ変換は得られない。話はそこで終わるはずだった! 終わらなかった。Morgenstern の制限付き係数モデルは制約が強すぎると人々は言う。40 年後、Nir Ailon は証明した。深刻な数値不安定性を避けたいなら、n log n より速く FFT を計算することは不可能だと。これも一部の人には制約が強すぎるのだろう。
つまりこの新しい OpenAI の成果は、数学の突破というより、計算機科学者が自分の設計仕様を形式化するのが苦手なことから生じた珍事だ。コンピュータの「理論的」定義は、我々が実際に作っているコンピュータとはほど遠い。この「より速い」フーリエ変換は、理論が元の問題からどれだけ逸れうるか、そして「未解決問題」が学術的地位をめぐるパズルに成り下がる様子を示す一例にすぎない。その解法は、計算 bot の流れを不可能な問題に投げ込み、違法なハッキングをしているのを見つけるようなものだ。
この OpenAI のくだらない倉庫にある他の多くの「重大な」成果も、同じやり方で批判できる。たとえばその一つは、2 つの行列の積を O(n^2.25) 回の演算で計算する galactic アルゴリズムだ。論文で使われている構成では、大 O に隠れた定数を見積もることすらできない。3 それが無限大だって構わない。天球の神聖な音楽によってのみ計算できるのかもしれない。
とはいえ、もっとずっとうまく書かれていれば、これらの論文は計算機科学理論の分野で最も権威ある発表の場(つまり STOC や FOCS の査読付き会議論文集)に入れたはずだ。4 あの行列乗算の論文はおそらく受賞もしただろう。だがどちらもコンピュータとは何の関係もない!
計算機科学理論には、アルゴリズムをコンピュータ上で動かすことを積極的に抑制する文化があるからだ。理論の会議で、あるアルゴリズムが存在すると主張し、それを一度も書き下さないまま論文を発表するのは許容される。計算機科学理論はコンピュータを気にかけない数学になってしまい、そうした数学的追究の外側にある影響力にはほとんど見返りを与えない。このことを友人に説明したら、彼はこう評した。「理論」には、「自分で作った無名性の中に身を隠すこと」という学際的な意味があるのだと。
AI は我々の最悪の傾向を自動化するのが特に得意だ。誰も好まないが、どの個人も合理的に逸脱できない暗黙のルールを増幅する。集団行動に抵抗する機械化された伝統を利用する。この流れで言えば、AI は今や役に立たない理論論文を書ける。だが、OpenAI の吐き気を催す証明の山の不条理の中から、そろそろ別のことを考えてもいいのではないかと、皆で顔を上げて気づけるかもしれない。
1 今の若い人はこれをコサイン類似度と呼ぶ。
2 Wikipedia のページによれば、これは 1805 年の Gauss に帰されるべきだそうだ! 学術界では、功績を正しく帰属させることは長く続く問題である。
3 あの論文が証明したのは、0 より大きいすべての epsilon について、T(n) <= n^(2.25 + epsilon + C/log(n)) となる定数 C が存在する、ということだ。どんなクエリを使っても、OpenAI のモデルから C の定量的な見積もりを引き出せなかった。もういい!
4 もう一つの悪しき伝統は、計算機科学が最も権威ある発表の場として、査読の甘い会議論文集を選んできたことだ。