用 drifting 目标训练一个袖珍 TTS
Kyutai 把连续音频语言模型里的一步流匹配目标(LSD)换成 drifting:指标全部持平、推理成本不变,却不再需要 Jacobian-vector 乘积。这是首个用 drifting 训练的自回归生成模型。
中文
复制
用漂移目标训练口袋级 TTS
我们把连续音频语言模型里的一步流匹配目标(拉格朗日自蒸馏,LSD)换成了漂移目标。据我们所知,这是第一个用漂移训练的自回归模型,也是第一个用漂移训练的语音模型。在相同推理成本下,它在所有指标上都追平了 LSD 基线,不需要一步流目标所需的雅可比向量积,而漂移论文依赖的那些技巧在我们的设定下大多用不上——不过我们自己补了一个:核温度必须学出来,不能固定。
生成模型把噪声变成数据。扩散模型和流模型在推理时沿学到的向量场走很多小步来完成这件事。训练这个向量场一步跳完整条轨迹,就是 MeanFlow 和自蒸馏流映射(拉格朗日与欧拉自蒸馏,LSD、ESD)做的事,代价是一个雅可比:它们的损失里含有网络沿自身轨迹的导数,也就是雅可比向量积,计算昂贵、数值上脆弱,也正是这类配方难调的原因。无雅可比的一步目标确实存在(shortcut models、渐进式自蒸馏,PSD),但在我们手里训出来的模型明显更差。漂移走的是另一条路:保留单次前向传播,把迭代挪进训练里。每一步,每个生成样本都被推向数据、推离它的同类,损失就是这个推挤后的副本上的普通平方误差。没有轨迹,没有雅可比,任何地方都没有二阶项,质量却和 LSD 一样。
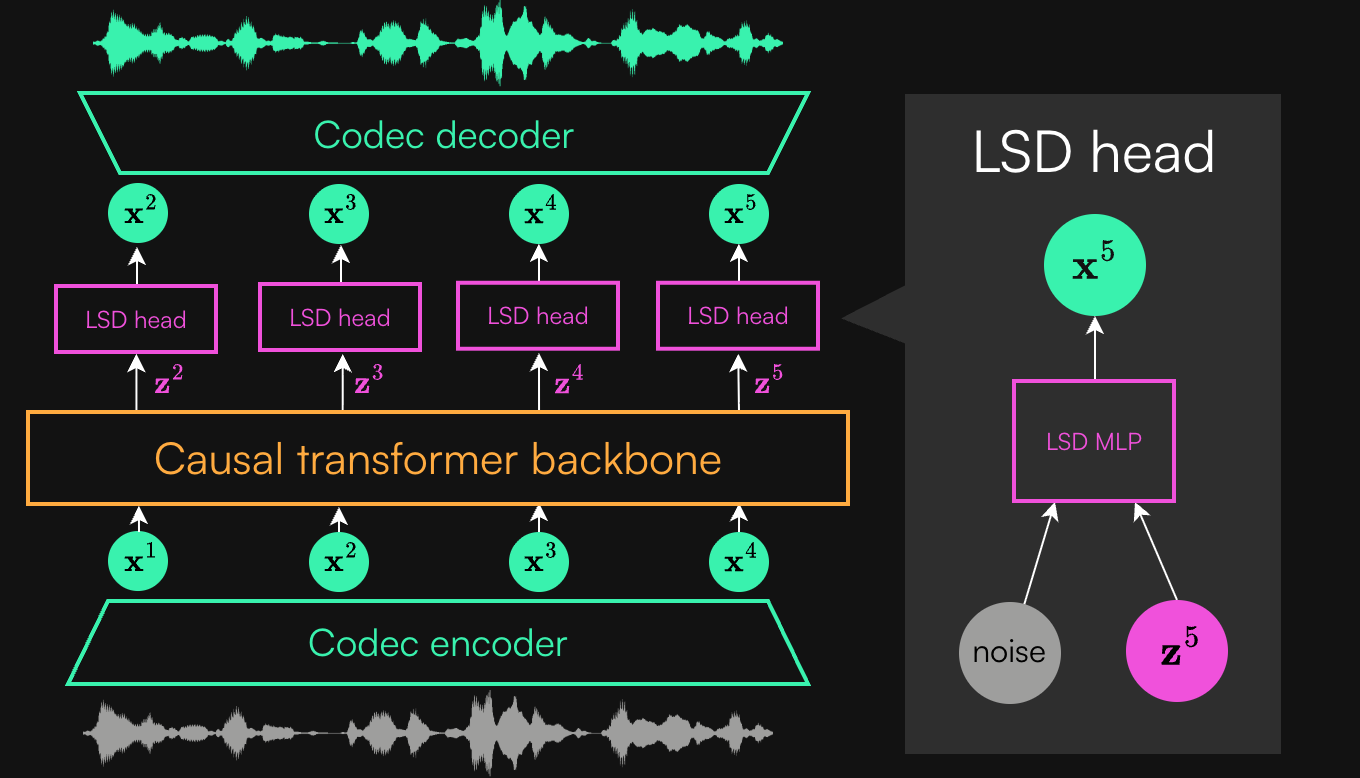
我们的 TTS 模型把音频生成为一串连续潜向量,每 80 ms 一个。一个 transformer 主干读取历史,一个小采样头把主干输出变成下一个潜向量,只需一次前向传播。此前这个头是用一步流匹配目标训练的,即拉格朗日自蒸馏(LSD)。这篇帖子用漂移(Generative Modeling via Drifting)训练同一个头,得到的模型在我们追踪的每一项指标上都追平 LSD 基线,推理成本也相同。
试一试
模型在 Pocket TTS 里,名为 english_drifting_26-09:6 层结构,带一个 drifting sampler head,从 24 层的 drifting teacher 蒸馏而来,guidance 已经烘焙进模型。下面的 demo 默认用它;语言选择器可以切回 LSD 系列模型。
Kyutai Pocket TTS
从噪声到语音只需一步,体积依然小到能放进口袋。
alba-mackenna/casual.wav
在本地运行模型时,你也可以用任意音频样本克隆音色。
和其他 Pocket TTS 模型一样,它跑在 CPU 上:
uvx pocket-tts generate --language english_drifting_26-09 --text "Hello from a drifting head."在 LibriSpeech test-clean(1,127 条,guidance 1,temperature 0.3)上,它的表现与默认英文模型持平:WER 0.90%、UTMOS 4.37,后者为 0.90% 和 4.36。训练代码和 teacher 配方(training/configs/drifting.yaml)都在仓库里。
简单回顾:Pocket TTS 与连续音频语言模型
如果你错过了最初的发布:Pocket TTS 是我们 100M 参数的文本转语音模型。它能从一段简短的音频提示克隆音色,输出以流式返回,在任何设备的 CPU 上都跑得比实时更快,整条推理链路都不需要 GPU。
大多数音频语言模型工作在离散 token 上:codec 把音频量化,模型再用 softmax 在码本上预测下一个 token。CALM 则让 latent 保持连续:Mimi codec 把 24 kHz 音频压缩成每帧一个 32 维向量,帧率 12.5 Hz,模型直接在这些向量上工作。
本文要改动的关键部分就是那个品红色方框:codec 的架构和权重、backbone 的架构都保持不变,只改训练 sampler head 的目标函数,以及通过 z_t 回传到 backbone 的梯度。
生成过程和经典的文本 LM 一样是自回归的:
- backbone transformer 接收一段简短的音色提示、待合成的文本,以及此前生成的 latent,输出当前帧的上下文向量
z_t。z_t表示我们接下来 80ms 想要产生的声音的分布。 - sampler head 是一个小型 MLP,把
(z_t, ε)映射到下一个 latent,其中ε是新的高斯噪声。有了噪声,head 才能表示可能下一帧的分布,而不是一个平均帧——平均帧听起来会发闷、没有生气。 - Mimi 解码器把 latent 还原成波形。
约束出在第 2 步。head 每帧只跑一次,所以任何迭代式的东西(扩散采样器、20 步 ODE 求解器)都会把推理成本乘以相应的步数。我们需要的是单步(1-NFE)目标。LSD 是其中一种答案:训练一个 flow,并在同一次运行中把它蒸馏成单步。Drifting 是另一种,而且它从一开始就不构建迭代式采样器。(Consistency models 和 shortcut models 属于第三类,按构造就是单步的;它们在我们这里表现不佳。)
从头讲 Drifting
扩散模型和 flow 模型在推理时迭代:从噪声出发,一步步精修。Drifting 把迭代挪到训练时:既然训练本身就是迭代过程,那就可以在每一步训练中把生成分布稍微精修一点,采样则变成一次前向传播。
设 q_θ 为 head 产出的样本分布,p 为数据分布,在这里就是给定上下文时下一个 Mimi latent 的分布。Drifting 在样本空间上定义一个 drifting field,
V(x) = attraction to data samples − repulsion from generated samples它由核 k(x, y) = exp(−‖x − y‖ / τ) 构造,其中 τ 是核温度,也就是它的带宽,即一个样本能感受到邻居的距离:每个生成样本被拉向附近的真实 latent,同时被推离其他生成样本。该场对 p 和 q 是反对称的,所以当 q = p 时它恰好为零:一旦生成器与数据吻合,吸引与排斥相互抵消,训练就不再推动它。
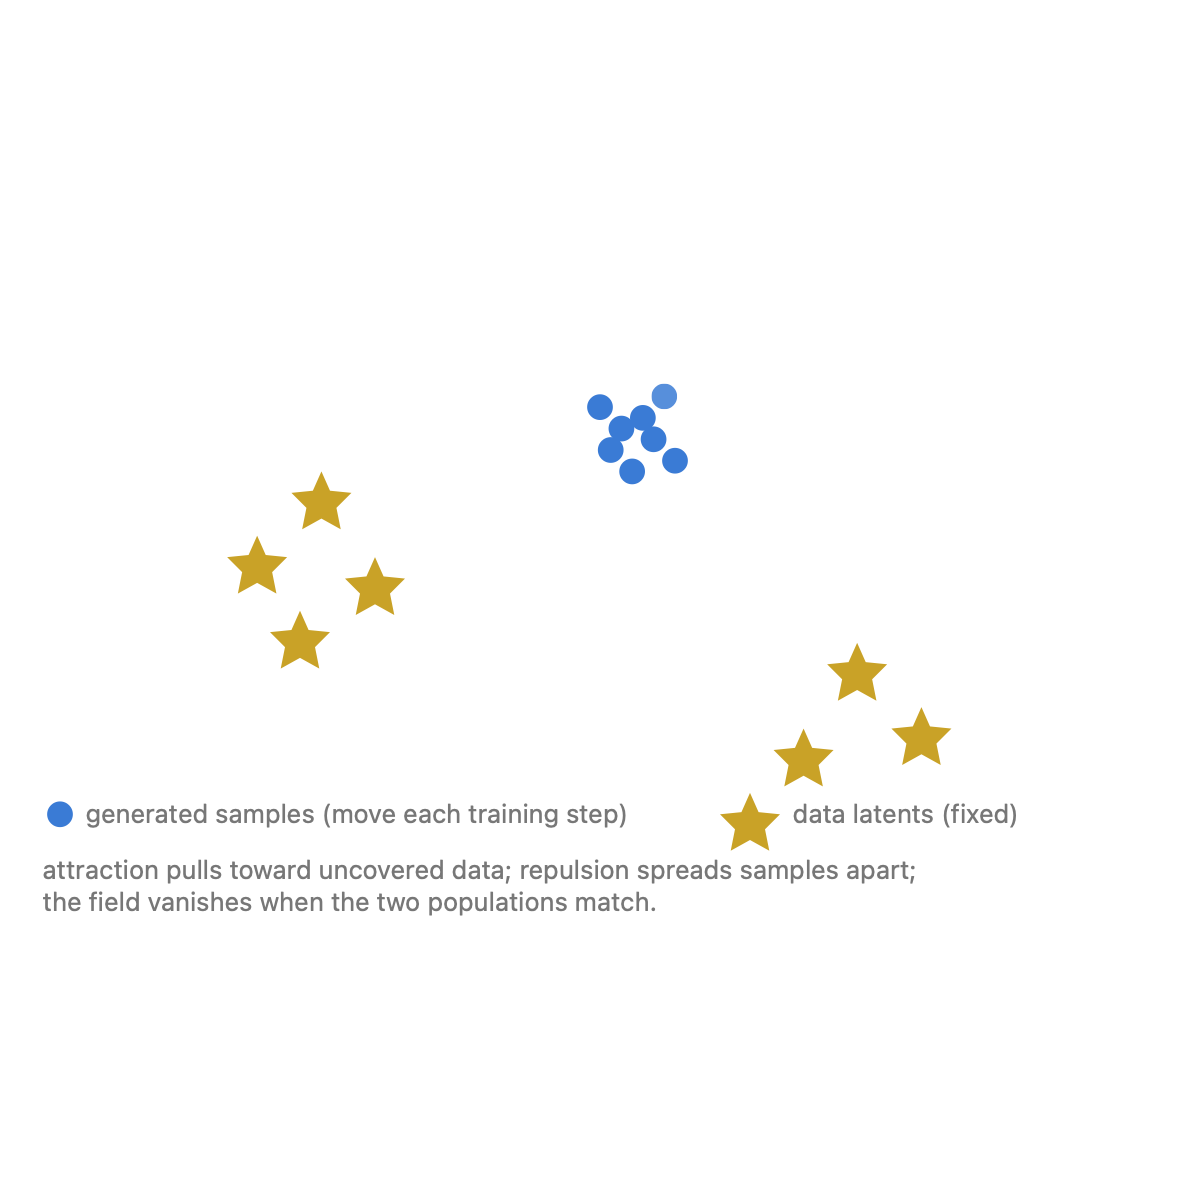
生成的样本(蓝色)被数据(金色)吸引,彼此之间相互排斥。在它们过于密集的地方,排斥占上风;在数据未被覆盖的地方,吸引占上风。达到平衡时,两个群体无法区分,场为零。
损失函数把每个生成样本向前推一个 drift 步:
y = f_θ(ε, c)
L = E‖y − stopgrad(y + V(y))‖²
其中 c 是条件。展开平方后,该损失对 y 的梯度是 y − (y + V) = −V(y)(相差一个常数因子),所以一步梯度下降会把每个样本移动 +V(y):场就是更新量,网络只需学会让样本沿着它移动。用简化的 Python 写出来,head 的一步训练长这样:
def drifting_loss(head, c, x_real, n_neg=32, tau=0.05):
    # c: context vectors [B, D]; x_real: the one data sample per context [B, D]
    eps = torch.randn(B, n_neg, D)
    y = head(c[:, None], eps)                         # n_neg generated candidates per context
    with torch.no_grad():                             # the field is a target, not a graph
        d_pos = (y - x_real[:, None]).norm(dim=-1)    # each candidate to the data sample
        d_neg = torch.cdist(y, y)                     # each candidate to its siblings
        w_pos = torch.softmax(-d_pos / tau, dim=1)    # kernel weights, rows sum to one
        w_neg = torch.softmax(-d_neg / tau, dim=-1)   # (diagonal masked out)
        attract = w_pos[..., None] * (x_real[:, None] - y)
        repel = (w_neg[..., None] * (y[:, None] - y[:, :, None])).sum(2)
        V = attract - repel
    return ((y - (y + V).detach()) ** 2).mean()       # dL/dy = -V, so descent moves y along +V
真正的实现加上了下面说的归一化和学习到的 tau,但结构上没有任何不同:没有第二个网络,没有求解器,没有 Jacobian 向量积。
drifting 论文的设定和 CALM 的设定差在哪
好消息
drifting 原论文做的是图像,要让它在图像上跑起来需要一堆机械装置。关键的一块是特征编码器:核距离在像素空间里没有意义(两张图可以感知上完全一样,L2 距离却很远),所以论文在一个单独训练的编码器的特征空间里计算场:多一个网络,多一套训练配方,还依赖表征质量。
在连续音频语言模型里,特征空间是白送的:codec latent 就是模型本来就待着的空间,Mimi latent 之间的普通 L2 距离就是一个合法的核。不需要额外的编码器。(为什么这些 latent 适合干这个:Mimi 的训练目标是把 WavLM 特征蒸馏进自己的 latent 空间,所以 latent 编码的是音素内容,而不是什么重建效果最好的东西;同一个音素的不同实现会落得很近。ABX 测试测的正是这件事,只用表征里的距离,而我们 codec 的 latent 能到大约 8% 的 ABX 错误率。)
自回归还帮了第二次忙。从有限样本估计一个总体层面的场,在高维和强多模态下会变得很难。但 head 从来不建模“所有语音的分布”,只建模 p(next frame | context),一个条件极强、低维、基本单模态的对象。64 个负样本就能把它采得不错。让一步 head 成为可能的那套条件,同样也让场能从一小把样本里轻松估出来。
坏消息
drifting 论文在 ImageNet 上训练,意味着他们有 1000 个类别,每个类别有很多样本。也就是说,给定一个条件,他们能抽出多个正样本。在我们的设定里,条件是语音提示 + 文本 + 已经生成的音频,压缩在潜变量 z_t 里。不用说,我们没法从这个条件出发从数据集里抽出多个正样本。所以只能用一个正样本干活。
配方
先说明一下下文衡量进展的方式。我们把可懂度记为语音识别器在生成音频上的词错误率(WER),感知质量用 UTMOS——一个预测人类平均意见得分的神经网络——来衡量,说话人相似度则用 prompt 与输出之间 WavLM 说话人嵌入的余弦相似度。训练这类模型并不是渐进式的:WER 在一次训练的前几个百分点内就饱和,之后 UTMOS 会在 3.7 左右徘徊很久,然后在几千步之内跳到 4.2 以上的最终水平。无论用 drifting 还是 LSD,这个跳变都会出现,它的时机决定了单次训练的实际耗时,也是我们比较配方时追踪的事件——记为首次达到或超过 UTMOS 4.0 的那次评估所在的步数。
让 drifting Pocket TTS 真正跑起来的有三个要素:
-
可学习的 kernel 温度。 即便做了归一化,温度仍需要一个取值,我们没有去扫它,而是让模型自己找。每一帧候选(正样本和
N个负样本)上的 kernel 权重构成一个分布,一个辅助损失训练τ去最大化正样本上的(对数)质量:τ于是变成了一个单标量的分类器校准。生成样本离数据还远时它起步很宽,随着样本逼近数据而收紧,最终在我们训练过的每一次运行里都收敛到同一个值(0.055 到 0.057)。起作用的是退火过程,而不是终点:如果把τ从一开始就固定在收敛值上,配方根本训不起来——候选会彼此塌缩,模型始终不可懂(UTMOS 2.1,WER 15% 到 20%);论文里那组固定的三个温度也以同样的方式失败(见消融部分的表格)。起点几乎无关紧要。从 0.05 到 10 的初始值都会退火到同一处,也都达到同样的质量(起点 1.0 训练最快)。 -
逐帧归一化的场。 kernel 温度
τ只有相对于典型距离才有意义。官方实现 已经为此做了归一化(成对距离除以它们的均值,driftV除以它的 RMS),但两者都是在整个 batch 上算成单个标量。我们保留双重归一化,只改变前者的粒度:距离按 逐帧 归一化,每个 context 的距离除以自己的均值。我们 batch 里的每一行都是不同的 conditioning,条件分布的展布也各不相同:元音中段的延续集中在一个很小的球里,短语起始则铺得很开。共用一个尺度会让 kernel 对某些帧太紧、对另一些帧太松。逐帧缩放让τ成为 每一帧 典型距离的无量纲比例,正因如此,单个可学习的τ才能在训练的任何阶段服务于所有 conditioning。消融表明这是速度杠杆而非必要条件:用论文那种单一 batch 级尺度,同一个模型仍能达到质量跳变,但要 300k 步而不是 200k 步。(drift RMS 仍按论文保持 batch 级。他们还把场在三个固定温度(0.02、0.05、0.2)上求和,而我们用的是单个可学习的τ,落在他们的区间内。) -
批量大小是目标函数的一部分。 行数越多,每一步平均包含的 one-positive 字段就越多。每步 64 行时,模型即使跑满 250k 步也达不到高质量;每步 128 行时,150k 步就能达到;每步 256 行时,100k 步即可,但每一步的开销是前者的两倍多,因此 128 行是达到高质量所需实际时间最短的配置(见文末的消融实验)。
与上面相同的伪代码,三个要素都已就位:
log_tau = nn.Parameter(torch.zeros(()))            # (1) learned kernel temperature, tau starts at 1.0

def drifting_loss(head, c, x_real, n_neg=32, num_pos=1):
    # (3) c has 128 rows: each row is one field estimate from num_pos data samples, the batch averages them
    # x_real: [B, num_pos, D], the data sample(s) for each context; num_pos = 1 in our setup
    B, D = c.shape
    y = head(c[:, None], torch.randn(B, n_neg, D))               # candidates [B, N, D]
    with torch.no_grad():
        cand = torch.cat([x_real, y], dim=1)                      # slots :num_pos = data, num_pos: = siblings
        d = torch.cdist(y, cand)                                  # [B, N, num_pos + N]
        d = d / d.mean(dim=(1, 2), keepdim=True)                  # (2) per frame: each context's distances
                                                                  #     divided by their own mean, so tau is a
                                                                  #     fraction of *this* frame's typical distance
        d[:, :, num_pos:] += 100 * torch.eye(n_neg)               # a candidate neither attracts nor repels itself
        w = torch.softmax(-d / log_tau.exp(), dim=-1)             # kernel weights over {data, siblings}
        attract = (w[:, :, :num_pos, None] * (x_real[:, None] - y[:, :, None])).sum(2)
        repel = (w[:, :, num_pos:, None] * (y[:, None] - y[:, :, None])).sum(2)
        V = attract - repel
        V = V / V.pow(2).mean().sqrt()                            # unit-RMS drift, as in the paper
    drifting_loss = ((y - (y + V).detach()) ** 2).mean()

    # (1) the same kernel read as a classifier: how much mass lands on the data sample(s)?
    #     only tau is trained by this term; it tightens as the candidates close in on the data
    log_p_data = torch.log_softmax(-d / log_tau.exp(), dim=-1)[:, :, :num_pos].logsumexp(-1)
    temperature_loss = -log_p_data.mean()
    return drifting_loss + temperature_loss
Pocket TTS 还依赖另外三个技巧,它们在 LSD 采样器的配置里就已经存在。这些技巧作用于采样器的输入,因此与采样器头无关。
高斯温度采样。 温度为 1 的采样复现的是训练分布,包括其中的瑕疵;更低的温度会让语音听起来更好。这里没有 softmax 可供重塑,所以温度作用在噪声上:对于温度 t < 1,在把噪声交给采样器头之前,先将 ε 乘以 √t(温度缩放的是高斯分布的方差,因此要开平方)。扫描结果见文末的消融实验。
潜变量无分类器引导(CFG)。 CFG 通过放大有条件预测与无条件预测之间的差异,用多样性换取保真度。扩散模型在每一步去噪时都应用它,与采样器纠缠在一起。Pocket TTS 则把它作用在用于条件化采样器头的潜变量上:分别在有文本条件和无文本条件下运行主干网络,将两者组合
z_cfg = z_uncond + γ · (z_cond − z_uncond)然后把结果像其他条件向量一样交给采样器头。和往常一样,只采样一次。引导系数取 1.5 到 2 可以消除四分之一的词错误(消融实验见文末)。
潜变量蒸馏。 潜变量 CFG 需要额外跑一遍主干网络。引导系数确定之后,我们把带引导的计算蒸馏进一个学生主干网络,让它一次前向就产出 z_cfg,也可以选择更小的学生网络。采样器头不重新训练,甚至完全不碰。
结果
在我们的标准评测上(1,127 条 LibriSpeech test-clean 跨句样本,两个采样器头均为单步生成):
| 采样器头 | WER | UTMOS | 说话人相似度 |
|---|---|---|---|
| LSD | 0.91% | 4.31 | 0.927 |
| drifting | 0.96% | 4.32 | 0.926 |
相同的主干网络架构,相同的编解码器,相同的推理开销。差异在评测噪声范围内,两个模型靠耳朵很难分辨。采样器头的目标函数决定它如何覆盖条件分布;我们感知到的大部分内容则由主干网络决定。
要点
- Drifting 可以直接替换连续音频 LM 中的一步蒸馏头,在我们追踪的每一项指标上都与之持平。
- 原论文需要的那些技巧在这里都消解了:Mimi 经 WavLM 蒸馏得到的潜空间扮演了特征编码器的角色,而自回归条件化又压缩了场需要捕捉的分布,最终每帧只需一个正样本。
- Pocket TTS 确实 依赖的技巧——潜空间 CFG 和潜空间蒸馏——在这次替换中原封不动地保留了下来,因为它们作用于条件向量,从不假设头如何采样。
- 配方:逐帧归一化的场,每批 128 行,32–64 个负样本,学习式核温度初始值设为 1.0
消融实验
以下数字支撑上述结论,除非某行另有说明,全部基于同一个 24 层骨干、同一份数据和同一套配方(每 25k 步评估一次;4 张 H100 GPU;UTMOS 为 3 个采样种子上的均值 ± 标准差):
温度初始化(每步 128 行,32 个负样本)
初始 τ | 收敛后的 τ | 首次 UTMOS ≥ 4.0 的评估 | 250k 步时的 UTMOS |
|---|---|---|---|
| 0.05 | 0.056 | 200k | 4.16 ± 0.01 |
| 1.0 | 0.056 | 150k | 4.29 ± 0.00 |
| 3.0 | 0.057 | 175k | 4.24 ± 0.01 |
| 5.0 | 0.057 | 150k | 4.27 ± 0.01 |
| 15、30、100 | 60 到 135(发散) | 从未 | 2.3 到 3.0 |
| 固定 0.02、0.05、0.2(论文的设置,不学习) | 不适用 | 250k 步前从未 | 2.17 ± 0.00 |
学习式 vs 固定核温度
在配方的 128 行、32 个负样本下:
τ | 首次 UTMOS ≥ 4.0 的评估 | 250k 步时的 UTMOS |
|---|---|---|
| 学习式,从 1.0 开始 | 150k | 4.29 ± 0.00 |
| 固定在收敛值 0.056 | 300k 步前从未(崩溃,WER 15 到 20%) | 2.10 ± 0.00(300k 步时 2.60) |
| 固定在论文的设置 0.02、0.05、0.2(求和) | 250k 步前从未 | 2.17 ± 0.00 |
在更早的配方上(64 个负样本,学习式 τ 从 10 开始),同样的对比中 τ 固定为 0.047:
| 数据,每步行数 | 固定 τ,首次 UTMOS ≥ 4.0 的评估 | 学习式 τ,同样条件 |
|---|---|---|
| HiFiTTS-2,64 行 | 400k | 275k |
| 我们的完整 TTS 语料,64 行 | 500k | 300k |
| HiFiTTS-2 2 kh 子集,32 行 | 500k | 300k |
τ 从一开始就固定在 0.056 时,head 根本起不来:kernel 已经收得很紧,而候选点离数据还很远,于是它们只能看到彼此,分布迅速塌缩到零(10 万步时只有数据尺度的 0.007),模型始终无法辨识(WER 15% 到 20%)。
每帧负样本数(每步 128 行,τ 从 1.0 开始)
| 负样本数 | 步/秒 | 首次达到 UTMOS ≥ 4.0 | 25 万步时 UTMOS |
|---|---|---|---|
| 16 | 3.3 | 17.5 万步 | 4.20 ± 0.01 |
| 32 | 3.3 | 15 万步 | 4.29 ± 0.00 |
| 64 | 2.4 | 17.5 万步 | 4.23 ± 0.00 |
16 个负样本不增加每步开销,但达到高质量更晚;64 个负样本每步多花 25% 的时间,却没有更早达到。
每步行数(32 个负样本,τ 从 1.0 开始)
| 每步行数 | 步/秒 | 首次达到 UTMOS ≥ 4.0(步数) | 同上(实际耗时) |
|---|---|---|---|
| 64 | 5.2 | 25 万步内始终未达到(UTMOS 3.77 ± 0.01) | 始终未达到 |
| 128 | 3.3 | 15 万步(25 万步时 4.29 ± 0.00) | 12.7 小时 |
| 256 | 1.4 | 10 万步(12.5 万步时 4.26 ± 0.00) | 20 小时 |
Field normalization(τ 从 10 开始,其余设置相同)
| 距离尺度 | 首次达到 UTMOS ≥ 4.0 | 30 万步时 UTMOS |
|---|---|---|
| 每批次一个标量,同论文 | 30 万步 | 4.11 ± 0.00 |
| 每帧一个 | 20 万步 | 4.29 ± 0.00 |
Latent classifier-free guidance(25 万步的 record 模型,温度 0.3;3 个采样种子的均值 ± 标准差)
guidance γ | WER | UTMOS | speaker sim |
|---|---|---|---|
| 1.0(关闭) | 1.43 ± 0.12% | 4.30 ± 0.00 | 0.924 |
| 1.5 | 1.03 ± 0.01% | 4.29 ± 0.00 | 0.924 |
| 2.0 | 1.25 ± 0.25% | 4.21 ± 0.01 | 0.921 |
| 3.0 | 15.7 ± 0.03% | 3.79 ± 0.01 | 0.914 |
guidance 取 1.5 时,UTMOS 只降百分之一,词错误就减少了四分之一以上;推到 3 则 EOS 判定过度自信,模型开始截断语音。
采样温度(25 万步的 record 模型,guidance 1.5;3 个采样种子的均值 ± 标准差)
| 温度 | WER | UTMOS | speaker sim |
|---|---|---|---|
| 1.0 | 1.32 ± 0.10% | 4.06 ± 0.00 | 0.924 |
| 0.7 | 1.22 ± 0.03% | 4.18 ± 0.00 | 0.925 |
| 0.5 | 1.23 ± 0.19% | 4.24 ± 0.01 | 0.924 |
| 0.3 | 1.03 ± 0.01% | 4.29 ± 0.00 | 0.924 |
温度 1 采样复现的是训练分布,瑕疵也一并复现;把噪声从 1.0 降到 0.3,换来 0.2 UTMOS 和减少五分之一的词错误,说话人相似度没有代价。
注意:drifting 这趟车比 LSD 开得慢
同样的数据、同样的 24 层骨干、同样的 4 张 H100:
| head 目标 | 每步行数 | steps/s | 首次评估达到 UTMOS ≥ 4.0 | 到该点的实际耗时 | 到该点已见行数 |
|---|---|---|---|---|---|
| LSD | 64 | 9.9 | 175k 到 200k | 4.9 到 5.6 小时 | 11M 到 13M |
| drifting(最佳配方) | 128 | 3.3 | 125k 到 150k | 10 到 12 小时 | 16M 到 19M |
按行算,两个目标的成本一样:8 张 GPU 上每步 128 行时,两者都是 5.5 steps/s,head 用 bf16 代替 float32 也没有任何变化。差别在行数:LSD 每步 64 行就能到,drifting 需要 128 行(用 64 行永远到不了,见行数消融),而且总共要多用约 1.5 倍的行。从样本估计出来的场,作为训练信号比回归目标更嘈杂,多出来的行就是用来把这份噪声平均掉。更好的估计器或温度调度能否填平这个差距,目前没有答案;今天 drifting 达到与 LSD 相同的质量,训练成本约为两倍。
作者
Manu Orsini, Samy Aïmeur, Nicolas Dufour
参考文献
- Generative Modeling via Drifting. arXiv 2602.04770;官方代码。
- Continuous Audio Language Models (CALM). arXiv 2509.06926。
- Moshi: a speech-text foundation model for real-time dialogue, which introduces the Mimi codec. arXiv 2410.00037。
- How to build a consistency model: learning flow maps via self-distillation (LSD, ESD, PSD). arXiv 2505.18825。
- Mean Flows for One-step Generative Modeling. arXiv 2505.13447。
- One Step Diffusion via Shortcut Models. arXiv 2410.12557。
- Consistency Models. arXiv 2303.01469。
- Flow Matching for Generative Modeling. arXiv 2210.02747。
- Classifier-Free Diffusion Guidance. arXiv 2207.12598。
- UTMOS: UTokyo-SaruLab System for VoiceMOS Challenge 2022. arXiv 2204.02152。
- WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing. arXiv 2110.13900。
- Evaluating speech features with the minimal-pair ABX task. Schatz et al., Interspeech 2013。