ドリフト目標でポケットTTSを訓練する
Kyutai は連続音声言語モデルの一段階フローマッチング目的(LSD)を drifting に置き換えた。指標はすべて同等、推論コストは変わらず、ヤコビアン・ベクトル積が不要になった。これは drifting で訓練された初の自己回帰生成モデルである。
日本語
コピー
ドリフト目的で訓練するポケットサイズ TTS
連続音声言語モデルで使っていた1ステップのフローマッチング目的(ラグランジュ自己蒸留、LSD)をドリフト目的に置き換えた。我々の知る限り、ドリフトで訓練した初の自己回帰モデルであり、ドリフトで訓練した初の音声モデルでもある。同じ推論コストで、すべての指標において LSD ベースラインに並んだ。1ステップフロー目的が必要とするヤコビアンベクトル積は不要で、ドリフト論文が依拠するテクニックの多くは我々の設定では使えなかった——ただし一つだけ自分たちで補った。カーネル温度は固定せず、学習させる必要がある。
生成モデルはノイズをデータに変える。拡散モデルとフローモデルは、推論時に学習したベクトル場に沿って小さなステップを多数踏むことでこれを成し遂げる。このベクトル場を訓練して軌跡全体を1ステップで飛び越えさせるのが MeanFlow と自己蒸留フローマップ(ラグランジュおよびオイラー自己蒸留、LSD、ESD)がやっていることで、その代償はヤコビアンだ。これらの損失にはネットワーク自身の軌跡に沿った微分、すなわちヤコビアンベクトル積が含まれ、計算コストが高く数値的に脆く、この種のレシピが調整しづらい原因になっている。ヤコビアン不要の1ステップ目的は確かに存在する(shortcut models、漸進的自己蒸留、PSD)が、我々が訓練した限りでは明らかに品質が劣った。ドリフトは別の道を行く。1回のフォワードパスはそのままに、反復を訓練側に移す。各ステップで、生成された各サンプルをデータへ押しやり、同類から遠ざける。損失はこの押しやったコピーに対する通常の二乗誤差だ。軌跡もヤコビアンもなく、どこにも二階項はない。それでいて品質は LSD と同じ。
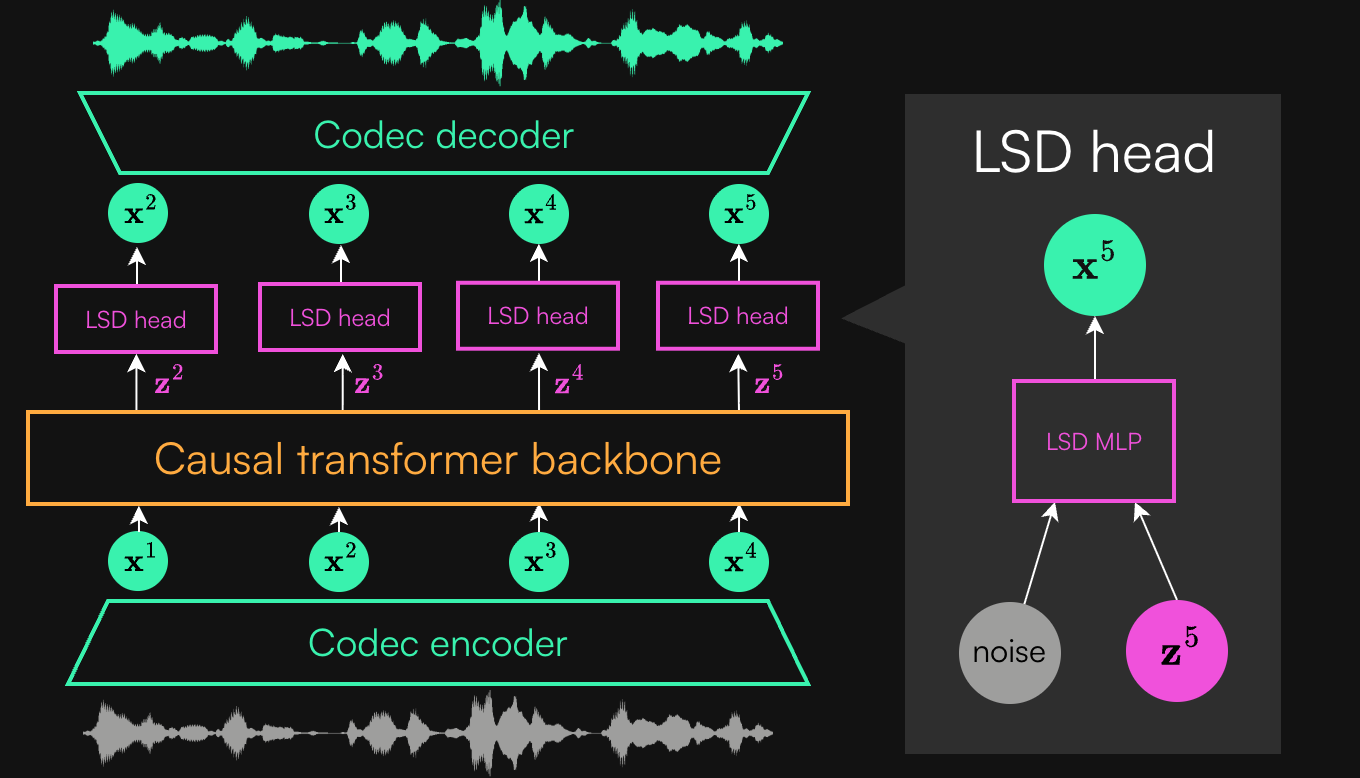
我々の TTS モデルは音声を連続潜在ベクトルの列として生成し、80 ms に1つ出力する。transformer バックボーンが履歴を読み、小さなサンプラーヘッドがバックボーンの出力を次の潜在ベクトルに変換する。フォワードパスは1回だけだ。これまでこのヘッドは1ステップのフローマッチング目的、すなわちラグランジュ自己蒸留(LSD)で訓練していた。本記事では同じヘッドをドリフト(Generative Modeling via Drifting)で訓練する。得られたモデルは我々が追跡しているすべての指標で LSD ベースラインに並び、推論コストも同じだ。
試してみる
モデルは Pocket TTS にあり、名前は english_drifting_26-09。6層で drifting sampler head を備え、24層の drifting teacher から蒸留し、guidance はモデルに焼き込んである。以下のデモはデフォルトでこれを使う。言語セレクタで LSD 系モデルに切り替えられる。
Kyutai Pocket TTS
ノイズから音声まで1ステップ、それでいてポケットに入るサイズ。
alba-mackenna/casual.wav
モデルをローカルで動かすときは、任意の音声サンプルで声をクローンできる。
他の Pocket TTS モデルと同様、CPU で動く:
uvx pocket-tts generate --language english_drifting_26-09 --text "Hello from a drifting head."LibriSpeech test-clean(1,127件、guidance 1、temperature 0.3)で、デフォルトの英語モデルと同等の性能を示す。WER 0.90%、UTMOS 4.37 に対し、後者は 0.90% と 4.36 だった。訓練コードと teacher のレシピ(training/configs/drifting.yaml)はリポジトリにある。
簡単な復習: Pocket TTS と連続音声言語モデル
最初のリリースを見逃した人向けに。Pocket TTS は我々の 100M パラメータのテキスト読み上げモデルだ。短い音声プロンプトから声をクローンし、出力はストリーミングで返し、どのデバイスの CPU でもリアルタイムより速く動き、推論チェーン全体に GPU を必要としない。
ほとんどの音声言語モデルは離散トークンで動く。codec が音声を量子化し、モデルは softmax でコードブック上の次のトークンを予測する。CALM は latent を連続のまま扱う。Mimi codec が 24 kHz の音声を1フレーム32次元のベクトルに圧縮し、フレームレートは 12.5 Hz。モデルはこれらのベクトルを直接扱う。
本記事で変更するのはマゼンタの枠の部分だ。codec のアーキテクチャと重み、backbone のアーキテクチャは変えない。変えるのは sampler head を訓練する目的関数と、z_t を通じて backbone に戻る勾配だけ。
生成は古典的なテキスト LM と同じく自己回帰的だ:
- backbone transformer は短い音色プロンプト、合成するテキスト、それまでに生成した latent を受け取り、現在フレームの文脈ベクトル
z_tを出力する。z_tは、これから 80ms で出したい音の分布を表す。 - sampler head は小さな MLP で、
(z_t, ε)を次の latent に写像する。ここでεは新しいガウスノイズだ。ノイズがあるからこそ、head は次のフレームとしてありうる分布を表現できる。平均的なフレームではいけない——それはこもって生気のない音になる。 - Mimi デコーダが latent を波形に戻す。
制約はステップ2にある。head は1フレームにつき1回しか動かないので、反復を伴うもの(拡散サンプラー、20ステップの ODE ソルバー)は推論コストをそのステップ数だけ掛け算にしてしまう。必要なのは1ステップ(1-NFE)の目的だ。LSD はその一つの答えで、flow を訓練しつつ同じ実行の中で1ステップに蒸留する。Drifting はもう一つの答えで、そもそも反復的なサンプラーを構築しない。(Consistency models と shortcut models は第三のカテゴリで、構造上1ステップだが、我々のところではうまくいかなかった。)
Drifting を一から説明する
拡散モデルと flow モデルは推論時に反復する。ノイズから出発し、一歩ずつ精錬していく。Drifting はその反復を訓練時へ移す。訓練自体が反復プロセスなのだから、各訓練ステップで生成分布を少しだけ精錬すればよい。サンプリングは一回のフォワードパスになる。
q_θ を head が出力するサンプル分布、p をデータ分布とする。ここではコンテキストが与えられたときの次の Mimi latent の分布だ。Drifting はサンプル空間上に drifting field を定義する。
V(x) = attraction to data samples − repulsion from generated samplesこれはカーネル k(x, y) = exp(−‖x − y‖ / τ) から構成される。τ はカーネル温度、つまりそのバンド幅で、あるサンプルがどれだけ離れた隣まで感じ取れるかを表す。各生成サンプルは近くの実 latent に引き寄せられ、同時に他の生成サンプルから押し離される。この場は p と q について反対称なので、q = p のときちょうどゼロになる。生成器がデータと一致すれば、引力と斥力が打ち消し合い、訓練はそれ以上動かなくなる。
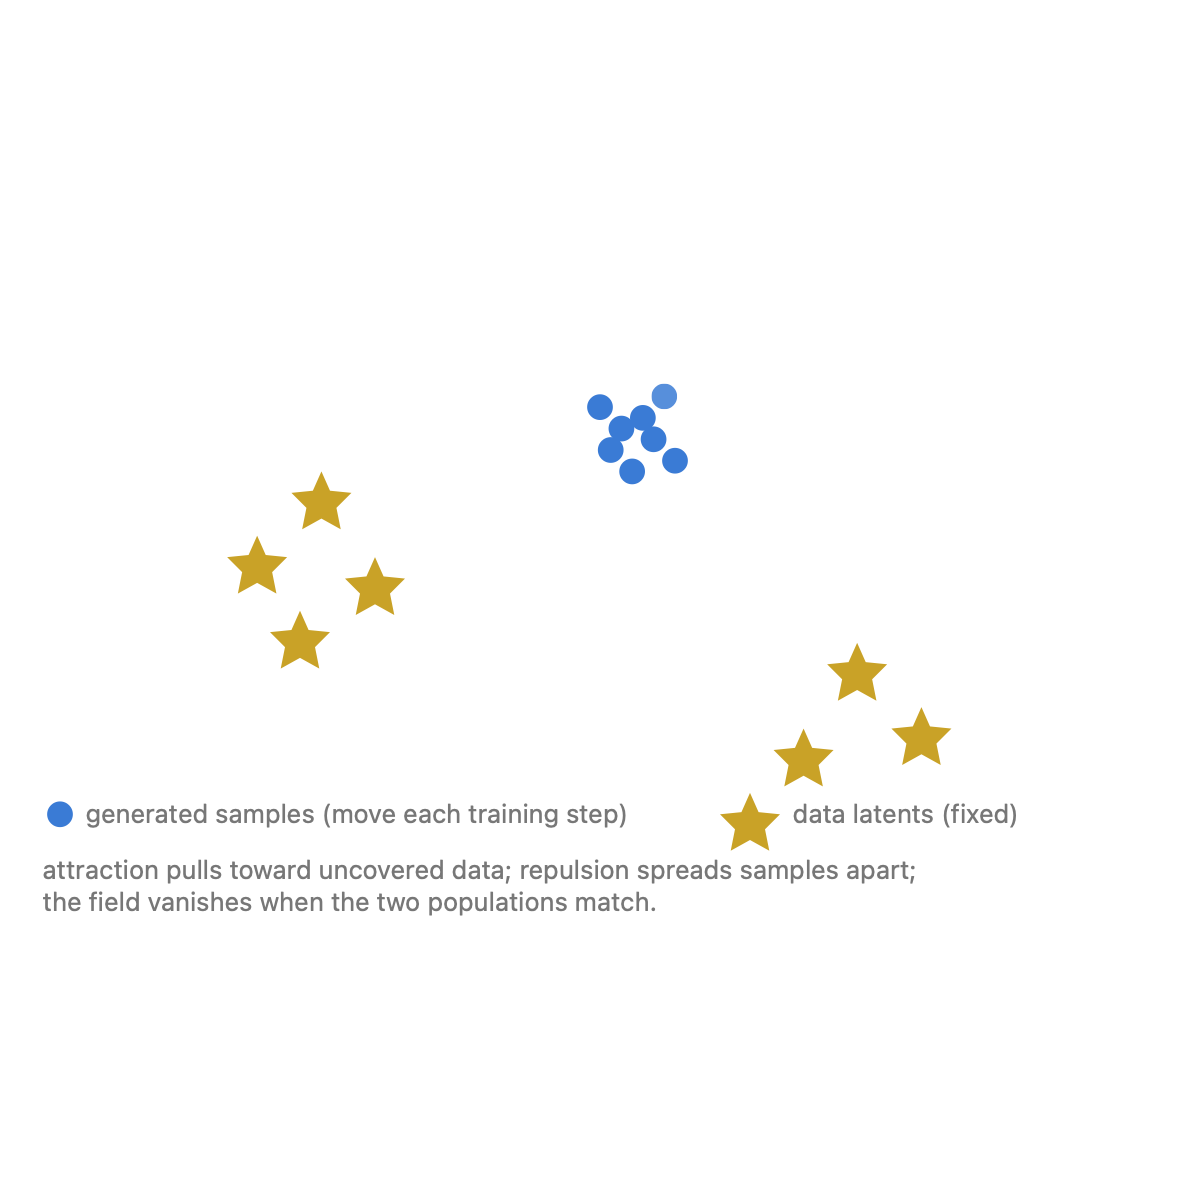
生成サンプル(青)はデータ(金)に引き寄せられ、互いに反発する。サンプルが密になりすぎた場所では斥力が勝ち、データが覆われていない場所では引力が勝つ。平衡に達すると二つの集団は区別できなくなり、場はゼロになる。
損失関数は各生成サンプルを drift 一歩分だけ前へ押す。
y = f_θ(ε, c)
L = E‖y − stopgrad(y + V(y))‖²
c は条件だ。二乗を展開すると、この損失の y に関する勾配は y − (y + V) = −V(y) になる(定数倍を除いて)。つまり勾配降下の一歩で各サンプルは +V(y) だけ動く。場がそのまま更新量であり、ネットワークはサンプルをそれに沿って動かすことだけを学べばよい。簡略化した Python で書くと、head の訓練一歩はこうなる。
def drifting_loss(head, c, x_real, n_neg=32, tau=0.05):
    # c: context vectors [B, D]; x_real: the one data sample per context [B, D]
    eps = torch.randn(B, n_neg, D)
    y = head(c[:, None], eps)                         # n_neg generated candidates per context
    with torch.no_grad():                             # the field is a target, not a graph
        d_pos = (y - x_real[:, None]).norm(dim=-1)    # each candidate to the data sample
        d_neg = torch.cdist(y, y)                     # each candidate to its siblings
        w_pos = torch.softmax(-d_pos / tau, dim=1)    # kernel weights, rows sum to one
        w_neg = torch.softmax(-d_neg / tau, dim=-1)   # (diagonal masked out)
        attract = w_pos[..., None] * (x_real[:, None] - y)
        repel = (w_neg[..., None] * (y[:, None] - y[:, :, None])).sum(2)
        V = attract - repel
    return ((y - (y + V).detach()) ** 2).mean()       # dL/dy = -V, so descent moves y along +V
実際の実装には後述する正規化と学習された tau が加わるが、構造は何も変わらない。二つ目のネットワークも、ソルバも、Jacobian ベクトル積も要らない。
drifting 論文の設定と CALM の設定はどこが違うか
良い知らせ
drifting の原論文は画像を扱っており、画像で動かすには機械仕掛けが山ほど要る。鍵となるのは特徴エンコーダだ。カーネル距離はピクセル空間では意味をなさない(知覚的にまったく同じ二枚の画像でも L2 距離は大きく離れる)。そこで論文は別途訓練したエンコーダの特徴空間で場を計算する。ネットワークが一つ増え、訓練レシピが一つ増え、しかも表現の質に依存する。
連続音声言語モデルでは特徴空間はただで手に入る。codec latent はモデルがもともと住んでいる空間そのもので、Mimi latent 間の普通の L2 距離がそのまま有効なカーネルになる。追加のエンコーダは不要だ。(なぜこれらの latent が適しているのか:Mimi の訓練目標は WavLM 特徴の蒸留を自身の latent 空間へ行うことなので、latent が符号化するのは音素内容であり、再構成が最も良くなる何かではない。同じ音素の異なる実現は近くに落ち着く。ABX テストが測っているのはまさにこれで、表現内の距離だけを使う。我々の codec の latent は ABX エラー率およそ 8% に達する。)
自己回帰はもう一つ助けになる。有限のサンプルから母集団レベルの場を推定するのは、高次元で多峰性が強いと難しくなる。だが head は「すべての音声の分布」をモデル化しているわけではなく、p(next frame | context) だけをモデル化している。条件が極めて強く、低次元で、ほぼ単峰の対象だ。負例 64 個もあれば十分よくサンプリングできる。head を一歩で済ませられるようにしている条件付けが、場を一握りのサンプルから容易に推定できるようにもしている。
悪い知らせ
drifting 論文が ImageNet で訓練しているということは、1000 クラスあり、各クラスにサンプルがたくさんあるということだ。つまり一つの条件が与えられれば、複数の正例を引ける。我々の設定では、条件は音声プロンプト + テキスト + すでに生成された音声であり、潜在変数 z_t に圧縮されている。言うまでもなく、この条件からデータセットの正例を複数引くことはできない。だから正例一つだけでやるしかない。
レシピ
まず、以下で進捗をどう測るかを説明しておく。可読性は生成音声に対する音声認識器の単語誤り率(WER)で、知覚品質は UTMOS——人間の平均意見スコアを予測するニューラルネット——で、話者類似度はプロンプトと出力の WavLM 話者埋め込みのコサイン類似度で測る。この種のモデルの訓練は漸進的ではない。WER は訓練の最初の数パーセントで飽和し、その後 UTMOS は 3.7 付近を長くさまよい、数千ステップのうちに 4.2 以上の最終水準へ跳ぶ。この跳びは drifting でも LSD でも現れ、その時期が一回の訓練の実時間を決める。我々がレシピを比較するときに追うのもこの事象で、UTMOS 4.0 に初めて到達または超過した評価のステップ数として記録する。
drifting Pocket TTS を実際に動かすまでに効いた要素は三つある。
-
学習可能なカーネル温度。 正規化をしても温度には値が要る。我々はスキャンせず、モデル自身に探させた。各フレームの候補(正例と
N個の負例)上のカーネル重みが一つの分布を作り、補助損失がτを訓練して正例上の(対数)質量を最大化する。τはこうして単一スカラーの分類器較正になる。生成サンプルがデータから遠いうちは広く始まり、サンプルがデータに近づくにつれて締まり、最終的には訓練したどの実行でも同じ値(0.055 から 0.057)に収束した。効いているのは終点ではなくアニーリングの過程だ。τを最初から収束値に固定すると、レシピはまったく訓練できない。候補が互いに潰れ合い、モデルは最後まで可読にならない(UTMOS 2.1、WER 15% から 20%)。論文にある固定三温度の組も同じように失敗する(アブレーションの表を参照)。初期値はほとんど関係ない。0.05 から 10 のどの初期値も同じ場所へアニーリングし、同じ品質に達する(初期値 1.0 が最速で訓練できる)。 -
フレームごとに正規化した場。 カーネル温度
τは典型的な距離に対してのみ意味を持つ。公式実装はすでにそのための正規化を行っている(ペアワイズ距離をその平均で割り、driftVをその RMS で割る)が、どちらもバッチ全体で単一のスカラーとして計算される。我々は二重正規化を保ったまま、前者の粒度だけを変えた。距離を フレームごと に正規化し、各コンテキストの距離を自身の平均で割る。バッチの各行は異なる conditioning であり、条件付き分布の広がりもそれぞれ違う。母音の途中の継続は小さな球に集中し、フレーズの始まりは大きく広がる。尺度を共有すると、カーネルはあるフレームにはきつすぎ、別のフレームには緩すぎる。フレームごとのスケーリングによってτは 各フレーム の典型的距離に対する無次元の比になる。だからこそ単一の学習可能なτが訓練のどの段階でもすべての conditioning に使える。アブレーションが示すのは、これが必要条件ではなく速度のレバーだということだ。論文式の単一バッチレベル尺度でも同じモデルは品質の跳びに到達するが、200k ステップではなく 300k ステップかかる。(drift RMS は論文どおりバッチレベルのままにしている。論文はさらに場を三つの固定温度(0.02、0.05、0.2)で総和するが、我々は単一の学習可能なτを使っており、それは論文の区間に入っている。) -
バッチサイズは目的関数の一部。 行数が増えれば、1ステップあたりに含まれる one-positive フィールドの平均個数も増える。1ステップ64行では、250k ステップ回しても高品質には届かない。128行なら150k ステップで到達する。256行なら100k ステップで到達するが、1ステップあたりのコストが128行の2倍以上かかる。したがって、高品質に到達するまでの実時間が最短なのは128行の構成になる(文末のアブレーションを参照)。
上と同じ擬似コードで、3つの要素がすべて揃ったもの:
log_tau = nn.Parameter(torch.zeros(()))            # (1) learned kernel temperature, tau starts at 1.0

def drifting_loss(head, c, x_real, n_neg=32, num_pos=1):
    # (3) c has 128 rows: each row is one field estimate from num_pos data samples, the batch averages them
    # x_real: [B, num_pos, D], the data sample(s) for each context; num_pos = 1 in our setup
    B, D = c.shape
    y = head(c[:, None], torch.randn(B, n_neg, D))               # candidates [B, N, D]
    with torch.no_grad():
        cand = torch.cat([x_real, y], dim=1)                      # slots :num_pos = data, num_pos: = siblings
        d = torch.cdist(y, cand)                                  # [B, N, num_pos + N]
        d = d / d.mean(dim=(1, 2), keepdim=True)                  # (2) per frame: each context's distances
                                                                  #     divided by their own mean, so tau is a
                                                                  #     fraction of *this* frame's typical distance
        d[:, :, num_pos:] += 100 * torch.eye(n_neg)               # a candidate neither attracts nor repels itself
        w = torch.softmax(-d / log_tau.exp(), dim=-1)             # kernel weights over {data, siblings}
        attract = (w[:, :, :num_pos, None] * (x_real[:, None] - y[:, :, None])).sum(2)
        repel = (w[:, :, num_pos:, None] * (y[:, None] - y[:, :, None])).sum(2)
        V = attract - repel
        V = V / V.pow(2).mean().sqrt()                            # unit-RMS drift, as in the paper
    drifting_loss = ((y - (y + V).detach()) ** 2).mean()

    # (1) the same kernel read as a classifier: how much mass lands on the data sample(s)?
    #     only tau is trained by this term; it tightens as the candidates close in on the data
    log_p_data = torch.log_softmax(-d / log_tau.exp(), dim=-1)[:, :, :num_pos].logsumexp(-1)
    temperature_loss = -log_p_data.mean()
    return drifting_loss + temperature_loss
Pocket TTS はさらに3つの工夫に依存しており、それらは LSD サンプラーの設定にもともと含まれている。いずれもサンプラーへの入力を操作するもので、サンプラーヘッドとは無関係。
ガウス温度サンプリング。 温度1のサンプリングは訓練分布をそのまま再現するので、その欠陥も一緒に再現してしまう。温度を下げると音声は良く聞こえる。ここには softmax がないので温度はノイズに作用する。温度 t < 1 のとき、ノイズをサンプラーヘッドに渡す前に ε に √t を掛ける(温度がスケールするのはガウス分布の分散なので、平方根を取る)。スキャン結果は文末のアブレーションを参照。
潜在変数の classifier-free guidance(CFG)。 CFG は条件付き予測と無条件予測の差を増幅し、多様性と引き換えに忠実度を高める。拡散モデルではこれを各デノイズステップで適用するため、サンプラーと密結合になる。Pocket TTS はこれをサンプラーヘッドの条件付けに使う潜在変数に対して適用する。テキスト条件ありとなしでバックボーンをそれぞれ走らせ、両者を組み合わせる
z_cfg = z_uncond + γ · (z_cond − z_uncond)あとは他の条件ベクトルと同じようにサンプラーヘッドに渡す。いつもどおり、サンプリングは1回だけ。ガイダンス係数を1.5から2にすると、単語誤りが4分の1減る(アブレーションは文末)。
潜在変数の蒸留。 潜在変数 CFG はバックボーンをもう1回走らせる必要がある。ガイダンス係数を決めたあと、ガイダンス付きの計算を生徒バックボーンに蒸留し、1回のフォワードで z_cfg を出させる。より小さな生徒ネットワークを選ぶこともできる。サンプラーヘッドは再訓練せず、一切触らない。
結果
標準評価(LibriSpeech test-clean の文をまたぐサンプル1,127件、どちらのサンプラーヘッドも1ステップ生成):
| サンプラーヘッド | WER | UTMOS | 話者類似度 |
|---|---|---|---|
| LSD | 0.91% | 4.31 | 0.927 |
| drifting | 0.96% | 4.32 | 0.926 |
バックボーンのアーキテクチャも、コーデックも、推論コストも同じ。差は評価ノイズの範囲内で、耳で聞いても2つのモデルはほとんど区別できない。サンプラーヘッドの目的関数は条件分布をどう覆うかを決める。我々が知覚するものの大半はバックボーンが決めている。
要点
- Drifting は連続音声 LM の1ステップ蒸留ヘッドをそのまま置き換えられ、追跡しているすべての指標で同等だった。
- 原論文が必要としていた工夫はここでは消える。Mimi を WavLM で蒸留した潜在空間が特徴エンコーダの役割を果たし、自己回帰的な条件付けが場の捉えるべき分布を圧縮するので、フレームごとに正例は1つで済む。
- Pocket TTS が実際に依存している工夫——潜在変数 CFG と潜在変数の蒸留——は今回の置き換えでもそのまま残った。これらは条件ベクトルに作用し、ヘッドがどうサンプリングするかを一切仮定しないからだ。
- レシピ: フレームごとに正規化した場、バッチあたり128行、負例32〜64個、学習されるカーネル温度の初期値1.0
アブレーション
以下の数値が上記の結論を支える。行に断りがない限り、すべて同じ24層のバックボーン、同じデータ、同じレシピによる(25k ステップごとに評価、H100 GPU 4枚、UTMOS は3つのサンプリングシードの平均 ± 標準偏差):
温度の初期化(1ステップ128行、負例32個)
初期 τ | 収束後の τ | 初めて UTMOS ≥ 4.0 になった評価 | 250k ステップ時の UTMOS |
|---|---|---|---|
| 0.05 | 0.056 | 200k | 4.16 ± 0.01 |
| 1.0 | 0.056 | 150k | 4.29 ± 0.00 |
| 3.0 | 0.057 | 175k | 4.24 ± 0.01 |
| 5.0 | 0.057 | 150k | 4.27 ± 0.01 |
| 15、30、100 | 60〜135(発散) | 到達せず | 2.3〜3.0 |
| 0.02、0.05、0.2 に固定(論文の設定、学習なし) | 該当なし | 250k ステップまで到達せず | 2.17 ± 0.00 |
学習式 vs 固定のカーネル温度
レシピどおりの128行、負例32個で:
τ | 初めて UTMOS ≥ 4.0 になった評価 | 250k ステップ時の UTMOS |
|---|---|---|
| 学習式、1.0 から開始 | 150k | 4.29 ± 0.00 |
| 収束値 0.056 に固定 | 300k ステップまで到達せず(崩壊、WER 15〜20%) | 2.10 ± 0.00(300k ステップ時は 2.60) |
| 論文の設定 0.02、0.05、0.2 に固定(合計) | 250k ステップまで到達せず | 2.17 ± 0.00 |
以前のレシピ(負例 64、学習式 τ は 10 から開始)では、同じ比較において τ を 0.047 に固定していた:
| データ、1 ステップあたりの行数 | τ 固定、初めて UTMOS ≥ 4.0 になった評価 | 学習式 τ、同じ条件 |
|---|---|---|
| HiFiTTS-2、64 行 | 400k | 275k |
| 完全な TTS コーパス、64 行 | 500k | 300k |
| HiFiTTS-2 2 kh サブセット、32 行 | 500k | 300k |
τ を最初から 0.056 に固定すると、head はまったく立ち上がらない。kernel はすでにきつく収まっているのに候補点はデータから遠く離れているため、候補点は互いしか見えず、分布は急速にゼロへ崩壊する(10 万ステップでデータスケールの 0.007)。モデルはいつまでも識別できない(WER 15% から 20%)。
フレームあたりの負例数(1 ステップ 128 行、τ は 1.0 から開始)
| 負例数 | ステップ/秒 | 初めて UTMOS ≥ 4.0 に到達 | 25 万ステップ時点の UTMOS |
|---|---|---|---|
| 16 | 3.3 | 17.5 万ステップ | 4.20 ± 0.01 |
| 32 | 3.3 | 15 万ステップ | 4.29 ± 0.00 |
| 64 | 2.4 | 17.5 万ステップ | 4.23 ± 0.00 |
負例 16 は 1 ステップあたりのコストを増やさないが、高品質に届くのが遅い。負例 64 は 1 ステップあたり 25% 余計に時間がかかるのに、到達は早くならない。
1 ステップあたりの行数(負例 32、τ は 1.0 から開始)
| 1 ステップあたりの行数 | ステップ/秒 | 初めて UTMOS ≥ 4.0 に到達(ステップ数) | 同上(実時間) |
|---|---|---|---|
| 64 | 5.2 | 25 万ステップ以内に一度も到達せず(UTMOS 3.77 ± 0.01) | 一度も到達せず |
| 128 | 3.3 | 15 万ステップ(25 万ステップで 4.29 ± 0.00) | 12.7 時間 |
| 256 | 1.4 | 10 万ステップ(12.5 万ステップで 4.26 ± 0.00) | 20 時間 |
Field normalization(τ は 10 から開始、ほかの設定は同じ)
| 距離スケール | 初めて UTMOS ≥ 4.0 に到達 | 30 万ステップ時点の UTMOS |
|---|---|---|
| バッチごとにスカラー 1 つ、論文どおり | 30 万ステップ | 4.11 ± 0.00 |
| フレームごとに 1 つ | 20 万ステップ | 4.29 ± 0.00 |
Latent classifier-free guidance(25 万ステップの record モデル、温度 0.3、サンプリングシード 3 つの平均 ± 標準偏差)
guidance γ | WER | UTMOS | speaker sim |
|---|---|---|---|
| 1.0(オフ) | 1.43 ± 0.12% | 4.30 ± 0.00 | 0.924 |
| 1.5 | 1.03 ± 0.01% | 4.29 ± 0.00 | 0.924 |
| 2.0 | 1.25 ± 0.25% | 4.21 ± 0.01 | 0.921 |
| 3.0 | 15.7 ± 0.03% | 3.79 ± 0.01 | 0.914 |
guidance 1.5 では UTMOS が 1% 下がるだけで、単語誤りは 4 分の 1 以上減る。3 まで上げると EOS の判定が過信になり、モデルは音声を打ち切り始める。
サンプリング温度(25 万ステップの record モデル、guidance 1.5、サンプリングシード 3 つの平均 ± 標準偏差)
| 温度 | WER | UTMOS | speaker sim |
|---|---|---|---|
| 1.0 | 1.32 ± 0.10% | 4.06 ± 0.00 | 0.924 |
| 0.7 | 1.22 ± 0.03% | 4.18 ± 0.00 | 0.925 |
| 0.5 | 1.23 ± 0.19% | 4.24 ± 0.01 | 0.924 |
| 0.3 | 1.03 ± 0.01% | 4.29 ± 0.00 | 0.924 |
温度 1 のサンプリングは訓練分布を再現し、瑕疵もそのまま再現する。ノイズを 1.0 から 0.3 に下げると、UTMOS 0.2 と単語誤り 5 分の 1 の削減が手に入り、話者類似度にコストはかからない。
注意:drifting は LSD より遅い
同じデータ、同じ 24 層のバックボーン、同じ H100 4 枚:
| head の目的関数 | 1 ステップあたりの行数 | steps/s | 初めて UTMOS ≥ 4.0 になった評価 | そこまでの実時間 | そこまでに見た行数 |
|---|---|---|---|---|---|
| LSD | 64 | 9.9 | 175k から 200k | 4.9 から 5.6 時間 | 11M から 13M |
| drifting(最良のレシピ) | 128 | 3.3 | 125k から 150k | 10 から 12 時間 | 16M から 19M |
行単位で見れば、両者のコストは同じだ。8 枚の GPU で 1 ステップ 128 行のとき、どちらも 5.5 steps/s で、head を bf16 にして float32 を置き換えても何も変わらない。違いは行数にある。LSD は 1 ステップ 64 行で到達できるが、drifting には 128 行が必要で(64 行では永遠に到達しない。行数のアブレーションを参照)、しかも合計で約 1.5 倍の行を消費する。サンプルから推定した場は、訓練信号としては回帰ターゲットよりノイズが多く、余分な行はそのノイズを平均化するために使われる。より良い推定器や温度スケジュールがこの差を埋められるかは、今のところ答えがない。今日 drifting が LSD と同じ品質に達するには、訓練コストが約 2 倍かかる。
著者
Manu Orsini, Samy Aïmeur, Nicolas Dufour
参考文献
- Generative Modeling via Drifting. arXiv 2602.04770;公式コード。
- Continuous Audio Language Models (CALM). arXiv 2509.06926。
- Moshi: a speech-text foundation model for real-time dialogue, which introduces the Mimi codec. arXiv 2410.00037。
- How to build a consistency model: learning flow maps via self-distillation (LSD, ESD, PSD). arXiv 2505.18825。
- Mean Flows for One-step Generative Modeling. arXiv 2505.13447。
- One Step Diffusion via Shortcut Models. arXiv 2410.12557。
- Consistency Models. arXiv 2303.01469。
- Flow Matching for Generative Modeling. arXiv 2210.02747。
- Classifier-Free Diffusion Guidance. arXiv 2207.12598。
- UTMOS: UTokyo-SaruLab System for VoiceMOS Challenge 2022. arXiv 2204.02152。
- WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing. arXiv 2110.13900。
- Evaluating speech features with the minimal-pair ABX task. Schatz et al., Interspeech 2013。