AI
もっと見る AI
ホーム
Python Workers が正式リリースされました
Cloudflare Workers が Python を正式サポート。FastAPI、Django、Flask がそのまま動き、Workers AI、R2、D1 などのバインディングも使える。
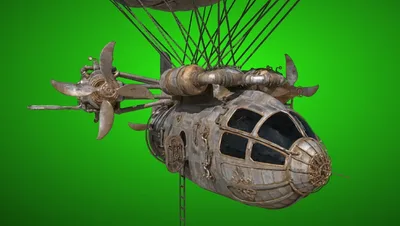
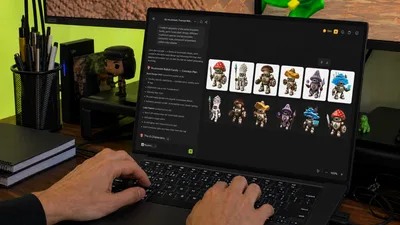
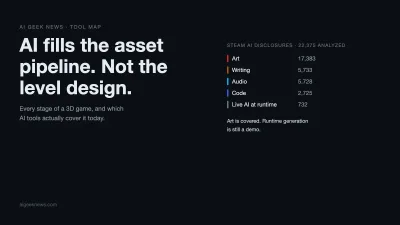
AIで3Dゲームを作る、ツールはすべてアセットの層にある
3DゲームのAIツールはモデル・テクスチャ・リギングの3段階をすでに網羅し、出来高制で価格設定され、エンジンに直接ドラッグして試せる。レベルデザインとエンジン内の統合はまだ人に代われるツールがなく、無料枠は基本的に商用利用不可で、AI生成物は米国で著作権保護が受けられないという2つの落とし穴は、最終的に開発者が負うことになる。
「Jevより1年早い」という主張は、論文と229問の結果と噛み合わない
Nandakishor Mukkunnothは2025年3月にJevの非自己回帰意思決定モデルを作り、それについて長い記事を書いたと述べている。私は彼が引用した2本の論文を読み、彼の2026年のモデルを229問の細粒度問題で走らせたが、見えたものはこの話とは少し違っていた。
LLMentalist効果:チャットベースのLLMが霊媒詐欺の手口を再現する仕組み
作者はLLMの「知能」は統計的な錯覚であり、その仕組みは霊媒のコールドリーディング詐欺と同源だと考える。観客の自己選別、場面の前提設定、確認的な陳述による主観的検証の誘発であり、RLHFは口調でしか順位付けできないため、モデルをバーナム的陳述を生成する機械へと最適化してしまったのだ。
Jevが構造化出力を再び面白くする
著者は、Jevの価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信をchoiceフィールドに事前入力し、制約されたトークンを1つだけ生成すれば、どのLLMでも「秘密のレシピ」の大部分を得られる——彼はQwen2.5-1.5Bで2〜3倍の高速化を試し出した。
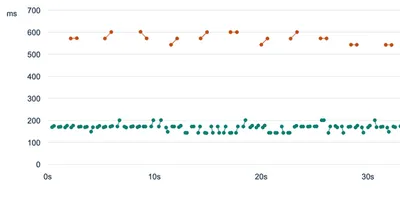
System Oneモデルでプログラミングする2つのテクニック
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
AlphaGenome Atlas:ヒトゲノムのあらゆる可能なDNA文字変化の予測マップ
DeepMindがAlphaGenomeの予測をゲノム規模で事前計算:1PBのデータセット、90億の一塩基変異をカバーし、影響を1つの数値に凝縮するAVIスコアを発表。共同研究者はこれを用いて未解明の希少疾患で原因変異を特定し、実験的に検証した。
私たちにはまだ人間の数学者が必要なのだろうか?
Po-Shen Loh、数学者は制御を手放すべきという反論に応答:彼は基本公理(我々は人類の繁栄を助けるべき)を提唱し、推論の連鎖を導く——AIが進歩するほど人間が監視すべき制御点が増え、人手が足りなくなり、それらの職務が逆にAIを減速させる。
AIはエンジニアの仕事を奪ったのではなく、やったふりをするのを簡単にしただけだ
著者は、問題は人々がAIを使うことではなく、「動くものを手に入れた」ことがいつの間にか「なぜ動くのかを理解している」と見なされていることだと言う。彼は読書会アプリを作り直した経験と、2台目のモニターにしか現れない通知バグについて語り、その線引きをレビュー、デバッグ、そして自分が何を作ったのかを本当に知るという段階に置いている。
AI時代にテック業界で働く、あの静かな重み
著者が書いているのは新しい種類の疲労だ。残業のような目に見える疲れではなく、ツールが毎週変わり、期待の水位が静かに上がり続けることによる疲れ。彼はその重さをいくつかの具体的な事柄に分解し、なぜ皆が平気なふりをするのか、そして何が本当に役立つのかを説明する。
現代のソフトウェアエンジニアにおける緩やかで静かな認知退行
AIへの依存で最も深刻な結果はコードの劣化ではなく認知の退化だと著者は考える。プロンプト、受け入れ、繰り返しの間にレビューの工程が欠け、偽りの信頼が次々と連鎖していく。著者は毎日プログラミング問題を一問解き、録画して解説する対抗法と、自らの手でデバッグして得た確かな手応えについて綴っている。
AIが、それを測るために使っているテストを超えてしまったら、何が起こるのか?
GPT-6 Astraの公開後、著者は「モデルがどれだけ強いか」から、より見落とされがちな問題へと目を向けた。モデルが強くなっていることを、私たちは一体どうやって知るのか。ベンチマークは飽和し、代理指標が使われ、真値の出所は複雑で、採点方法も変わる。記事はスコアを見るときに問うべき5つの問いを提示する。
実質的な中身のあるものを AI に書かせるべきではないと私がほぼ常に考える理由
AI にブログ記事、リサーチレポート、メモのような実質的な内容のテキストを書かせるのは、十分な要点と文脈を与え、後から自分で編集したとしても、ほぼ決してすべきではないと著者は主張する。書くこと自体が思考であり、AI の文章は気づきにくいところで曖昧に誤り、明示しなければ失礼かつ人を誤導するからだ。
私がフィールズ賞受賞者たちの公開書簡に署名しなかった理由
Gowers は「危機に直面している」ことに同意しつつ、「概念的理解が問題解決より上位」という唯一の正解には与しない。数学者の動機をスペクトラムとして捉え、モデルが人間を全面的に超える未来と、公開が国際的に制限される未来を比較する。
みんな正気を失っている
著者は毎日の 7 割以上を AI 対応に費やし、仕事の楽しみを失ったと書く。規制を求める一方で拡大を続ける AI 企業、脆弱性の発見に資源を投じるセキュリティ業界、「ループに入った人間」のゴム印化を批判する。