開発ツール
もっと見る 開発ツール
ホーム
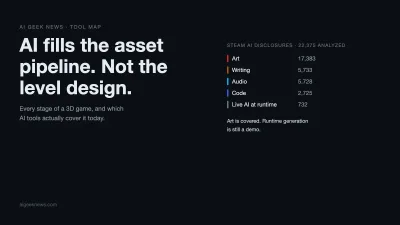
AIで3Dゲームを作る、ツールはすべてアセットの層にある
3DゲームのAIツールはモデル・テクスチャ・リギングの3段階をすでに網羅し、出来高制で価格設定され、エンジンに直接ドラッグして試せる。レベルデザインとエンジン内の統合はまだ人に代われるツールがなく、無料枠は基本的に商用利用不可で、AI生成物は米国で著作権保護が受けられないという2つの落とし穴は、最終的に開発者が負うことになる。
チームメンバーと AI エージェントに Workers への適切なアクセス権を付与する
Cloudflare は Developer Platform に Worker 単位のリソースレベルアクセス制御と 4 つのロールを追加し、チームメイトや agent が指定した Worker のみにアクセスできるようにします。
マーケティングオペレーション・アズ・コード:GitHubで計画からフォローアップまでのキャンペーンを自動化
GitHub のマーケティングチームは Issue forms、Labels、Actions を使ってイベント準備を自動化し、これまで手作業で2〜3日かかっていた作業が1つの Issue で自動構築、毎日の申し込み確認、締めくくりまでできるようになった。
Weaveツールを5つ試してみよう——あなた自身のものもぜひ共有してください
WeaveツールがFigma Communityに公開可能に、記事が試す価値のある5つを厳選:ムードボードをリアルな部屋のレンダリングに変えるものから、建築コンセプトスケッチや次のネイルのプレビューまで。
DatabricksとRedisによるリアルタイムパーソナライゼーションの実現
Spark の Real-Time Mode が連続計算を担い、Redis がミリ秒単位の読み取りを担う。この役割分担により、パーソナライズ推薦と不正スコアリングをリクエストパス内に収めている。記事には実行可能なサンプルリポジトリも付属。
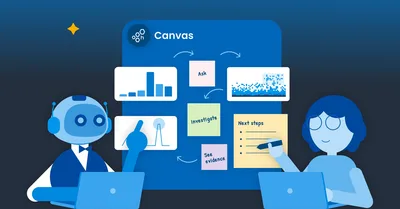
Canvas が AI Agent 開発のフィードバックループをどう駆動するか
Honeycomb Canvas はテレメトリ、GitHub、Linear、Slack を一つのループにつなぎ、それを使って自社の調査エージェントを開発し、ユーザーより先に問題を発見する。
AIエージェントで複雑なレガシーコードをモダナイズ
Mistralが欧州のエネルギー事業者による40,000行のFortran 77からC++への移行を支援:まず数値一致性検証台を構築し、100以上のagentでドキュメントを補完し、最終的に「人間が操作するコーディング—テスト—レビューagentワークフロー」という中間路線に落ち着かせ、完全自律ではなかった。
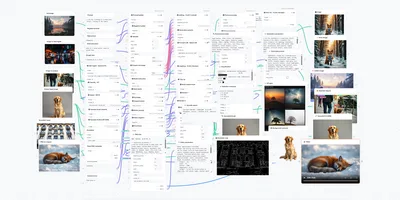
Gradio Workflow で AUTOMATIC1111 を再構築する
Hugging Face は AUTOMATIC1111 のほとんどの機能を同じ Gradio ワークフローキャンバス上に再構築しました。11 本のメディアパイプライン、73 個のノードで、テキストから画像生成、高解像度修復、画像から画像生成、プロンプトマトリクス、VLM 逆推論、検出からマスクへの変換、アノテーター、PNG Info、画像から動画への変換をカバーし、各出力ノードは自動的に REST エンドポイントと MCP ツールにもなります。
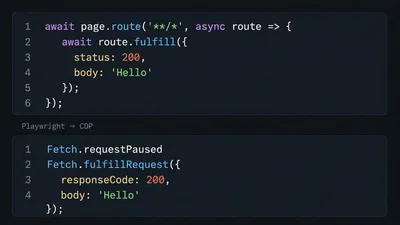
Playwrightのルートからブラウザプロトコルまで:リクエストインターセプトの仕組み
Playwright の page.route() が異なるブラウザでリクエストをインターセプトする方法と、Chromium DevTools Protocol だけで同じインターセプトを実現する方法。
これまでデータを取得するにはプログラマーが必要だったが、今は一言で済む。
かつて素人スクレイパーを阻んでいた技術的障壁は、たまたま大規模言語モデルが最も得意とする種類のタスクにそれぞれ対応している。長年防御に携わってきた人物がそれらを一つずつ分解し、どの壁がどこで崩れたのか、そして防御がなぜ形骸化している可能性があるのかを説明する。
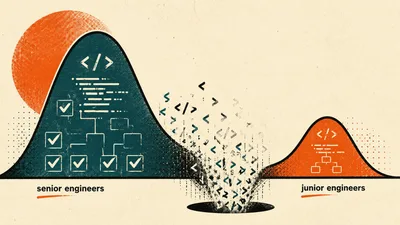
AIは劣悪なエンジニアリングをさらに高くつくものにしている
AIは劣悪なエンジニアを加速させ、Faros AIのデータはPRレビュー時間が441.5%増加したことを示し、JetBrainsは手戻り量が14倍の差があることを記録している。
なぜAIコーディングアシスタントは同じミスを繰り返すのか:結果を受け取るのは誰なのか?
エラーを記録することとエラーから学ぶことは別物だ。6つのagent memoryシステムのうち4つは否定的な判定を含むフィードバック入力を公開しているが、Mnemoverse自身が公表した測定ではこのシグナルはほとんど呼び出されていない。
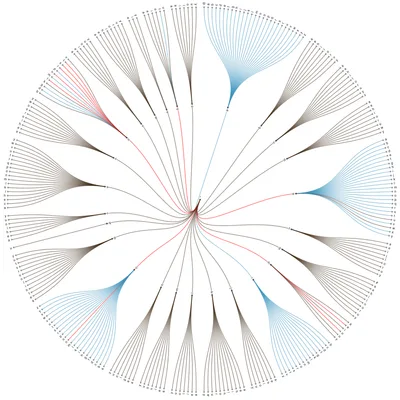
a か an か:3 万語を走らせたら、例外は 129 語だけだった
英語の a/an は文字ではなく音で決まる。unicorn は a、hour は an。著者は cmudict で初音と頭文字の規則を比較し、32,455 語から例外を抽出、最終的に 25 行の Python ルールに落とし込んだ。
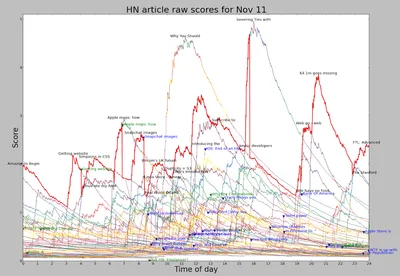
Hacker News のランキングは実際どう決まるか:スコア、論争、ペナルティ
著者は数日間 HN の上位 60 記事を追跡して逆解析した。公開式はほぼ正確だが、フロントページの 20% はペナルティを受け、タイトルに NSA があると 0.4 倍、コメントが票より多く 40 件に達すると「論争」判定で一瞬で消える。
なぜRust LSPの構築は難しいのか · Rust Glancer
ずっと昔、強力なmatkladがRustツールチェーンの仕組みについて素晴らしい記事をいくつか書いた。良い時代だったが、最後のrust-analyzerブログは2023年で止まっている。
AIにUIを作らせるが、選択問題だけをやらせる
大規模モデルにUIのJSONを直接書かせると、存在しないコンポーネントをでっち上げたり、勝手に文言を作ったり、壊れたとしても結果が返ってくるまで分からない。json-renderは発想を変え、UI構築を2つの有限な選択肢に分解し、モデルは選ぶだけ、コードが組み立てる。
TypeSafeのAIユースケースマップとリスク評価チェックリスト:10の「判断形態」
TypeSafeはAIの意思決定をコードの制御フローに組み込み、リアルタイム適用の遅延はわずか150ms、ビッグデータ処理コストを100分の1に削減。
GitHub CopilotランタイムをRustに移行し、Copilotを使用する
エージェントが登場する前は、この規模の書き換えは手が出なかった。Copilotエージェントランタイムを80万行の本番Rustコードに移植するのに実際にかかったコストを以下に示す。
同じリンカで2つのベンチマークが正反対の結論:Wild作者が項目ごとに分解して自分で確認
Moldが最近リンカベンチマークを更新し、初めてWildを対象に含めた。このベンチマークではWildはMoldよりかなり遅く、8月4日の前回リリース時にWildが最新で公表したベンチマーク結果とは逆である。