a か an か:3 万語を走らせたら、例外は 129 語だけだった
英語の a/an は文字ではなく音で決まる。unicorn は a、hour は an。著者は cmudict で初音と頭文字の規則を比較し、32,455 語から例外を抽出、最終的に 25 行の Python ルールに落とし込んだ。
日本語
コピー
英語には、語の前に置ける不定冠詞 a がある。たとえば a raccoon。だが一部の語では an を使う。たとえば an apple。私たちが使っている規則は、母音で始まる語に an を付ける、というものだ。
テキストを手続き的に生成するとき、どの冠詞を使うべきかを教えてくれる関数 a_or_an("apple") が欲しい。簡単に見える。最初の文字が母音かどうかを調べればいい。だがこの規則が適用されるのは話し言葉の語であって、書き言葉の語ではない。たとえば私たちは an unicorn ではなく a unicorn と言う。<unicorn> は子音音(「yoo-ni-korn」)で始まるからだ。
正しい「最初の音」の規則を実装するには発音辞書が必要になる。誤った「最初の文字」規則がどれくらい近いのか気になったので、cmudict(https://github.com/cmusphinx/cmudict)をダウンロードし、「最初の音」規則と「最初の文字」規則を比べてみた。すると大量の不一致が出た。私はそれらをリストアップし、そのうちいくつかは分析に含めないことにした。
- 固有名詞(3133 語)。名前の厄介な点は、その多くが英語の語ではないため、英語の発音規則に従う必要がないことだ。人名だけでなく、
<nvidia>のような語もある——母音音で始まるが、英語には<nv>で始まる普通の語は存在しない。文中に現れることはあるが(an nvidia employee)、研究する価値はないと判断した。例外リストに入れておけばよい。 - 単一の文字(26 語)。アルファベットの各文字には読み方があり、たとえば
<h>は「aitch」と読む。文中に現れることはあるが(an H was on his shirt)、ハードコードしたリストで扱うのが最善だと判断した。 - 第二の発音(9114 語)。複数の発音を持つ語が多く、cmudict はそのすべてを列挙する。どれが a/an に影響するか見たところ、主なものは
<herb>がアメリカ英語とイギリス英語で異なる発音になることだ。 - 句読点(8574 語)。主に所有格(
<arm's reach>)と短縮形(<don't>)で、扱うことはできたが、26 文字で索引される単純なデータ構造を使いたかったので飛ばした。 - 頭字語(10 語)。cmudict ではこれらは一文字ずつ読み上げられる。たとえば
<eu>は「ee yoo」(cmudict 表記IY UW、ipa/i u/)と綴られる。数は多くなく、ある意味で固有名詞に似ていると思う。 - 手動での除外(2 語):
<nth>と<urman>。 - その他(81852 語)。cmudict にあるが BSD 辞書にはない語で、理由はさまざまだ。
<aesop>のような名前もあれば、<lobsters>のような語形変化、<jr>のような略語もある。簡単に切り分ける方法が見つからなかったので全部除外した。ただしこのプロジェクトを更新するなら、これらの語をもっとよく見るだろう。
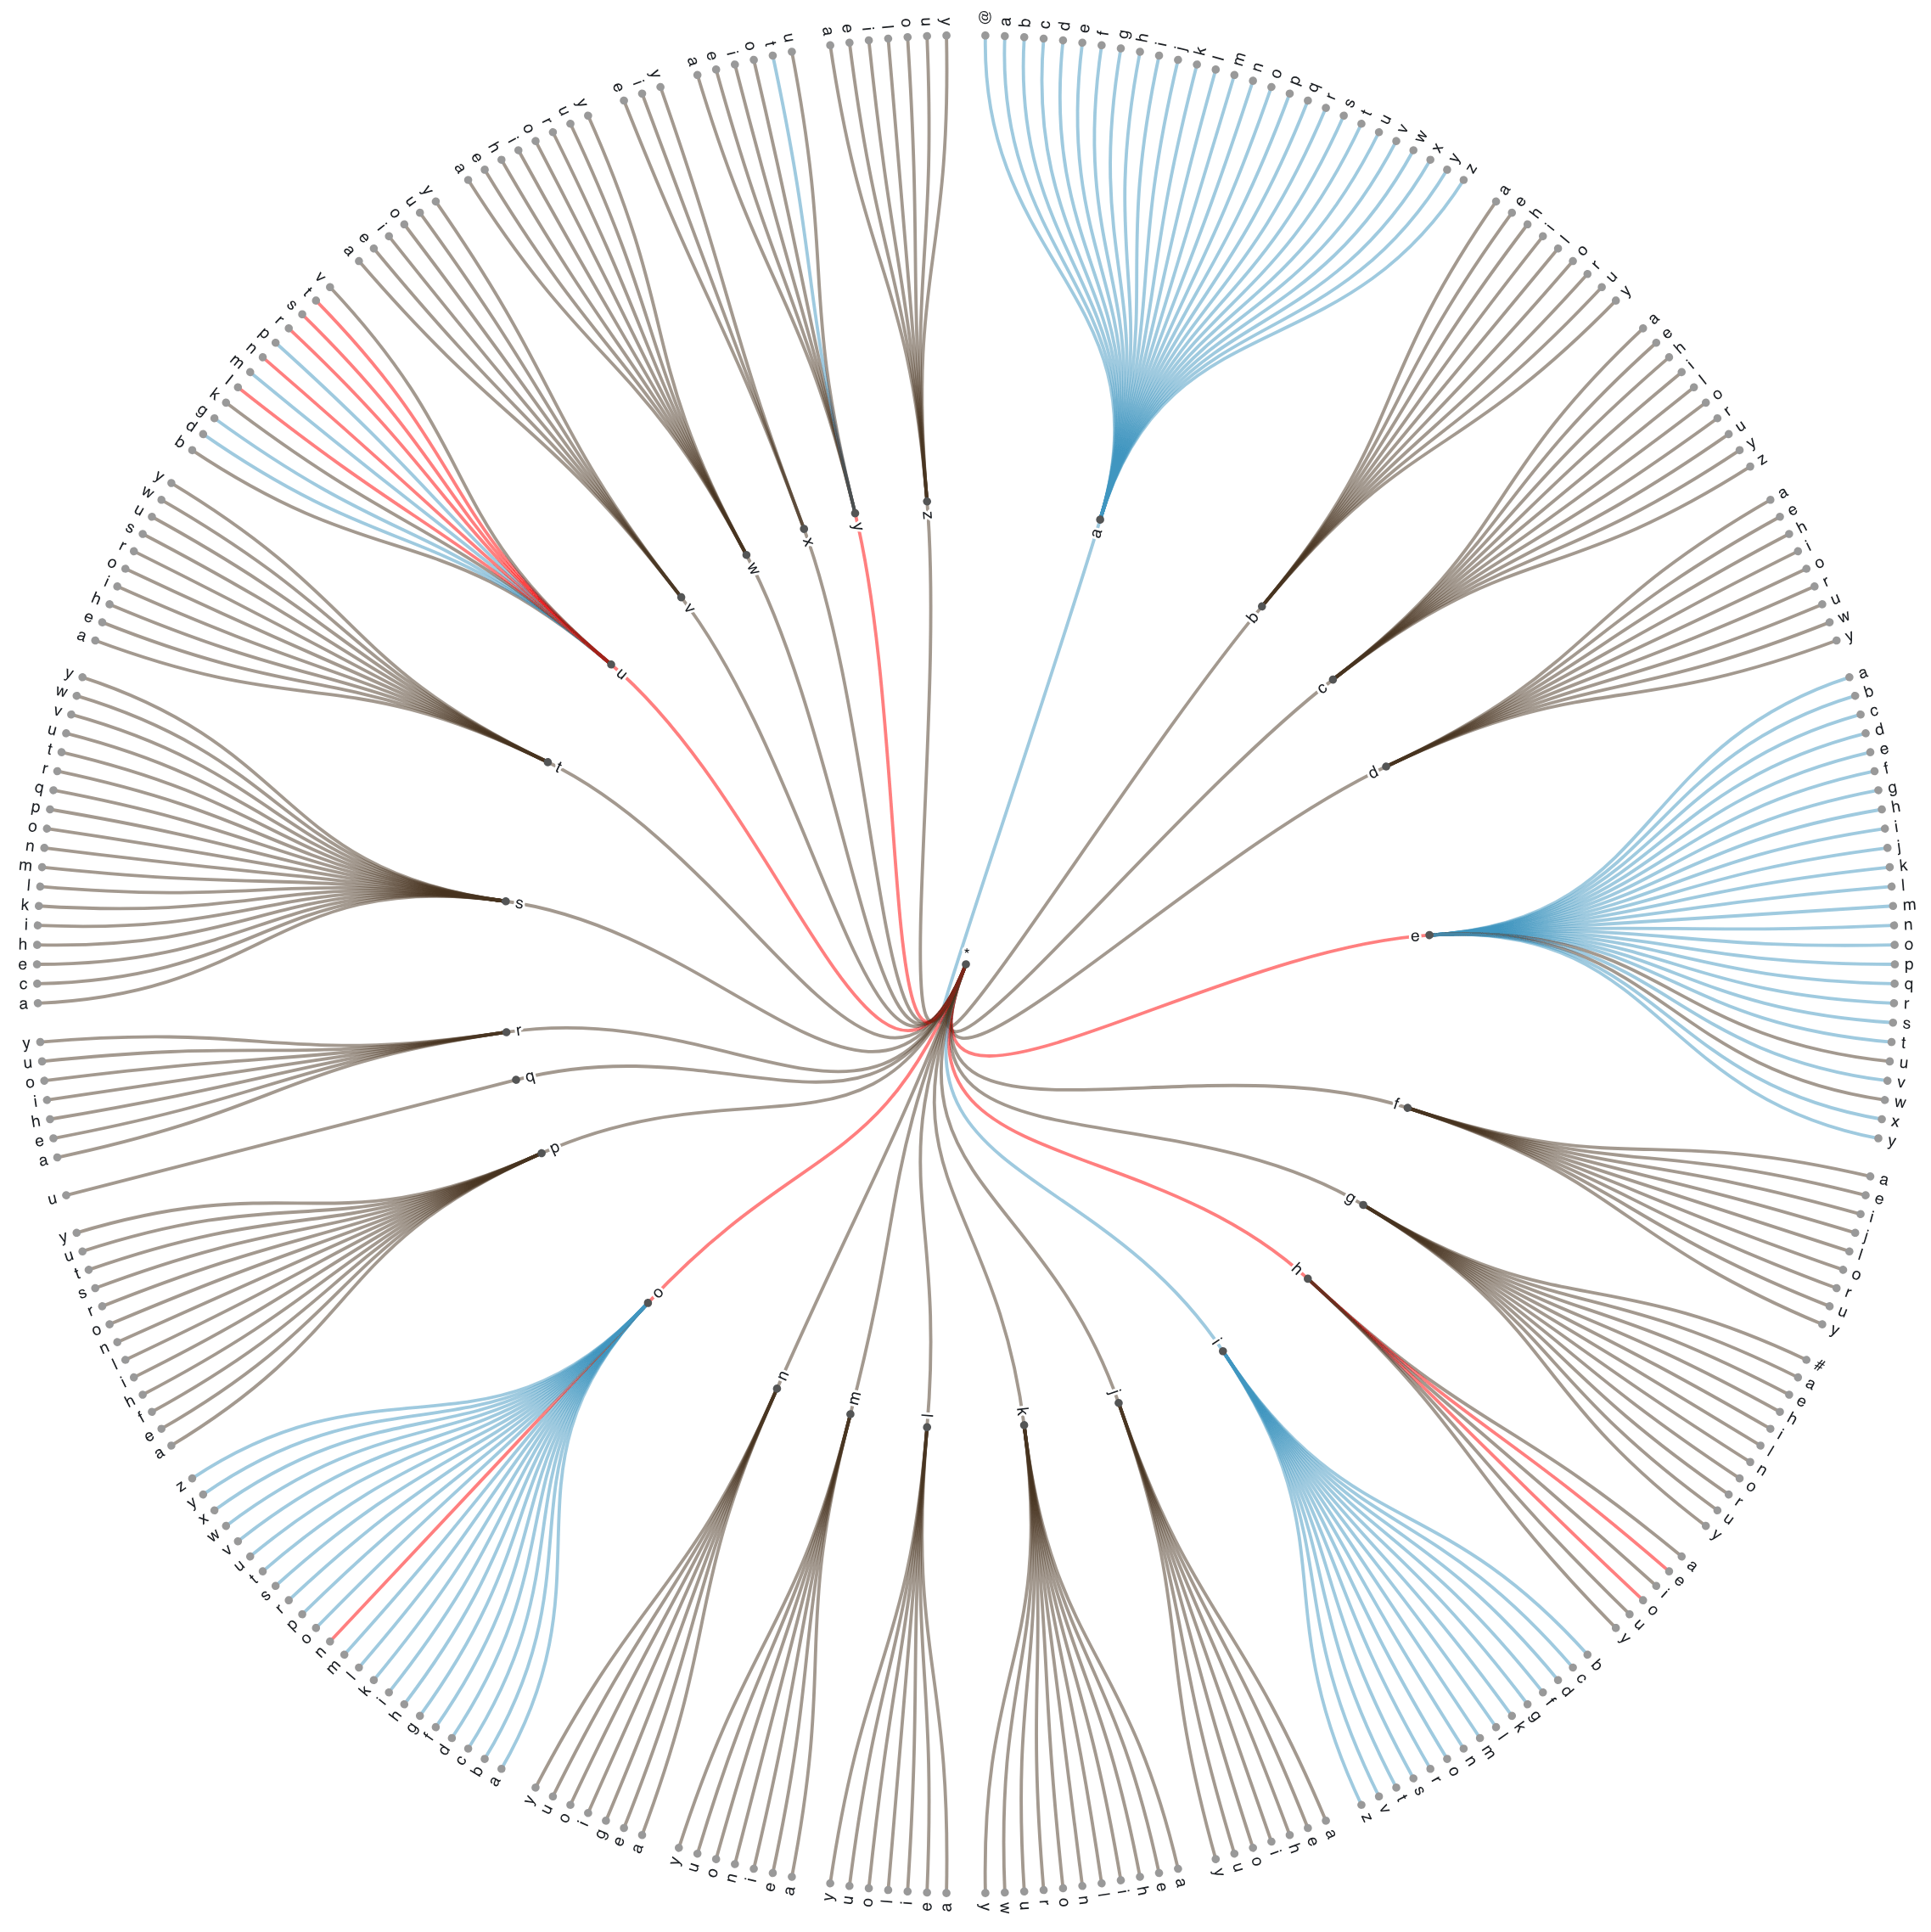
結果として 32455 語が残った。最初の 2 文字について、d3/ObservableHQ で可視化を作った。常に子音音なら線は黒、常に母音音なら青、母音にも子音にもなるなら赤だ。
「語の最初の 2 文字で a か an かを決められるか」を示す可視化
例外がどこに現れるかを示す可視化も作ってみた。
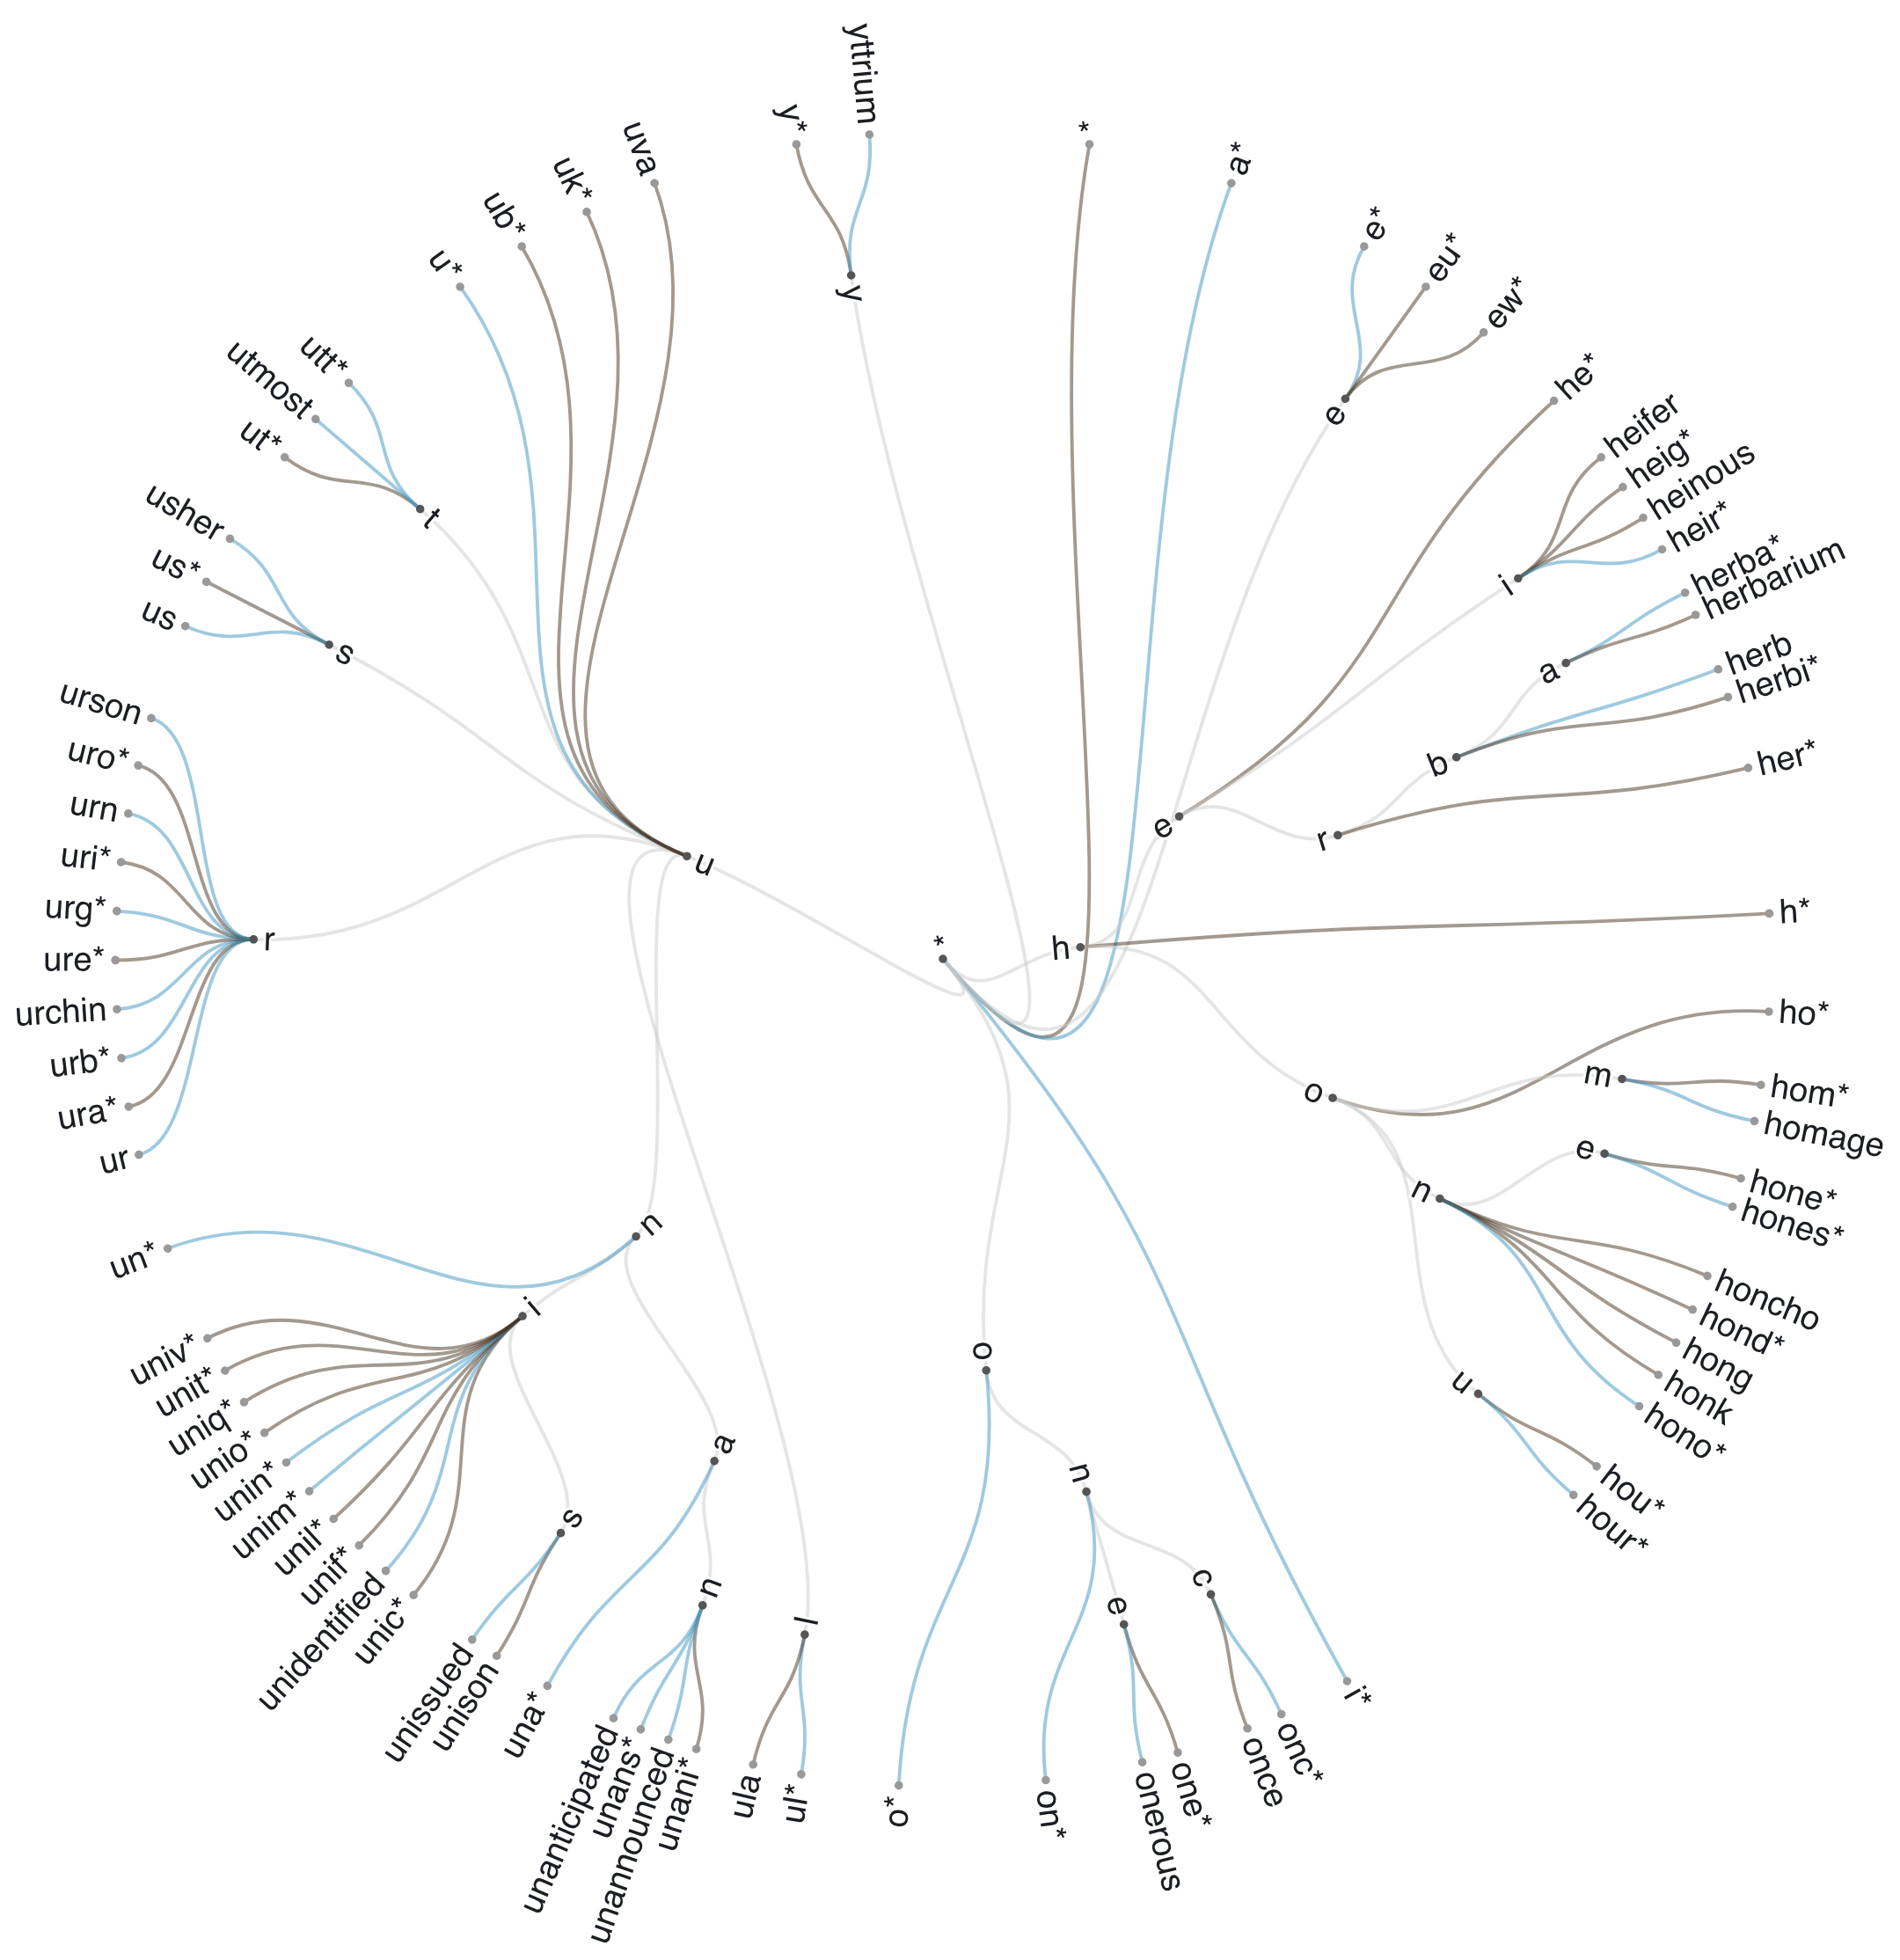
「a か an かを決めるのに何文字見る必要があるか」を示す可視化
これを最小の決定木に圧縮する巧妙なアルゴリズムを思いつきたかった。DFA 最小化と関係するはずだ。だが思いつかなかったので、手作業でルールを書いた。
VOWELS = "aeiou"

def starts_with_vowel(word):
    if word.startswith("eu"): return False
    if word.startswith("ew"): return False
    if word.startswith("heir"): return True
    if word.startswith("herb") and not word.startswith("herbiv") and word != "herbarium" and word != "herbicide": return True
    if word.startswith("homage"): return True
    if word.startswith("hones"): return True
    if word.startswith("hono"): return True
    if word.startswith("hour"): return True
    if word.startswith("once"): return False
    if word.startswith("one") and not word.startswith("onerous"): return False
    if word.startswith("ula"): return False
    if word.startswith("unani"): return False
    if word.startswith("uni") and word[3:4] in "cfloqstv" and word != "unissued": return False
    if word.startswith("ub"): return False
    if word.startswith("uk"): return False
    if word.startswith("ur") and word[2:3] in VOWELS and word != "ur": return False
    if word.startswith("us") and word not in ("us", "usher"): return False
    if word.startswith("ut") and not (word.startswith("utm") or word.startswith("utt")): return False
    if word.startswith("uva"): return False
    if word.startswith("ytt"): return True
return word[0] in VOWELS余談めいた関連話題:再区切り(rebracketing)——ほとんどの人が読めなかった時代、人々は <a napron> を聞いて <an apron> と誤解し、<an ewt> を聞いて <a newt> と誤解した。私たちは <an orange> と言うが、スペイン語では <naranja> である。もともと先頭に <n> があったからだ。
Source: preprocess-cmudict.py