a 还是 an:我把 3 万个单词跑了一遍,只有 129 个需要例外
英语 a/an 取决于读音而非字母:unicorn 用 a、hour 用 an。作者用 cmudict 对比首音与首字母规则,从 32,455 个词里挑出例外,最终用一段 25 行的 Python 规则解决。
中文
复制
英语里有一个不定冠词 a,可以放在词前,比如 a raccoon。但对某些词我们要用 an,比如 an apple。我们使用的规则是以元音开头的词用 an。
做程序化文本生成时,我想要一个函数 a_or_an("apple") 来告诉我该用哪个冠词。这看起来很简单:检查首字母是不是元音就行。但这条规则作用于口语的词,而不是书面的词。比如我们说的是 a unicorn 而不是 an unicorn,因为 <unicorn> 这个词开头是辅音音(「yoo-ni-korn」)。
要实现正确的「首音」规则,我们需要一部发音词典。我很好奇错误的「首字母」规则到底差多远,于是下载了 cmudict(https://github.com/cmusphinx/cmudict),把「首音规则」和「首字母规则」做了对比测试。结果出现了大量不一致。我把它们列出来,并决定其中一些不纳入分析:
- 专有名词(3133 个)。名字的麻烦在于,很多并不是英语词汇,因此不必遵循英语的发音规则。这不只是人名,还有像
<nvidia>这样的词——它以元音音开头,但英语里没有以<nv>开头的普通单词。虽然它们可以出现在句子里(an nvidia employee),我还是决定它们不值得研究,可以放进例外清单。 - 单个字母(26 个)。字母表里每个字母都有读音,比如
<h>读作「aitch」。虽然它们可以出现在句子里(an H was on his shirt),我认为最好用一份硬编码清单处理。 - 次要读音(9114 个)。很多词有多种读音,cmudict 会把每个都列出来。我看了哪些会对 a/an 产生影响,最主要的是
<herb>在美式英语和英式英语里读音不同。 - 标点(8574 个)。主要是所有格(
<arm's reach>)和缩略(<don't>)。虽然我本可以处理,但我想用一个按 26 个字母索引的简单数据结构,所以跳过了它们。 - 首字母缩略词(10 个)。在 cmudict 里这些是按字母逐个拼读的。例如
<eu>拼作「ee yoo」(cmudict 记作IY UW,ipa/i u/)。这类不多,我认为它们在某些方面与专有名词类似。 - 手动排除(2 个):
<nth>和<urman>。 - 其他(81852 个)。这些是 cmudict 里但不在 BSD 词典里的词,原因各异。有些是像
<aesop>这样的名字,有些是像<lobsters>这样的词形变化,有些是像<jr>这样的缩写。我没找到简单的方法进一步区分,于是全部排除。不过如果我要更新这个项目,我会更仔细地看这些词。
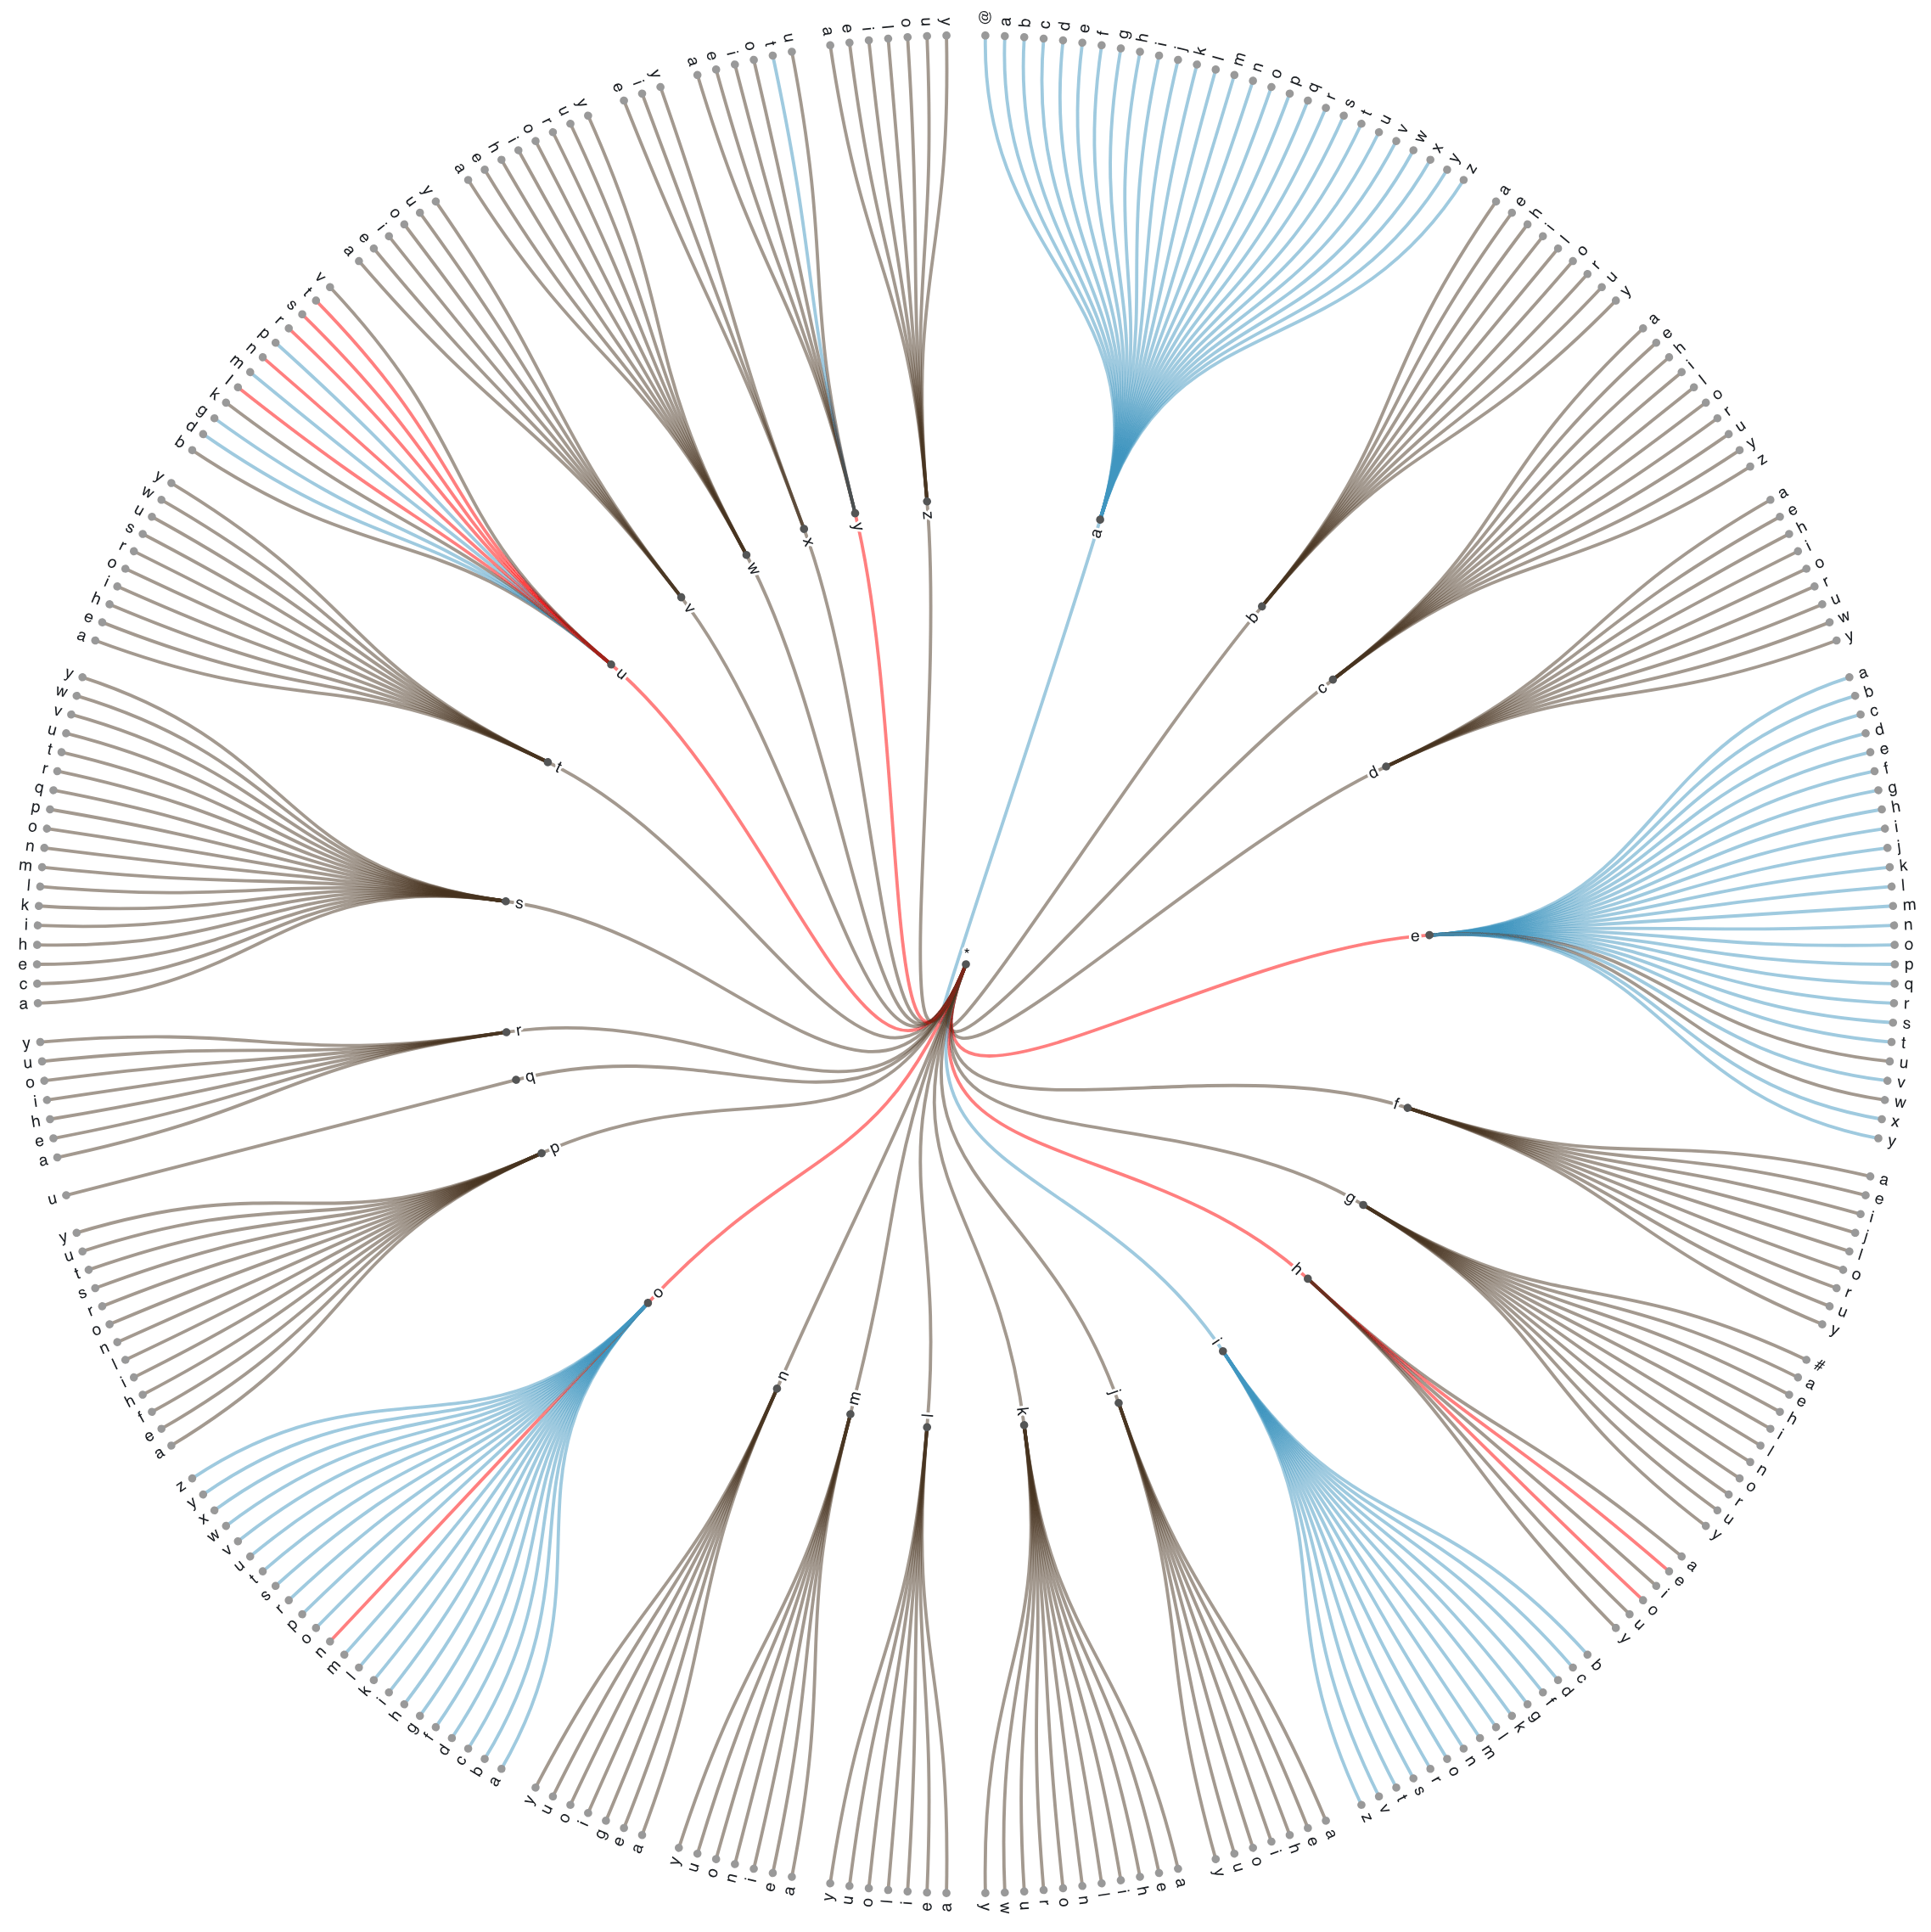
最后剩下 32455 个词。我用 d3/ObservableHQ 做了一个关于前两个字母的可视化:如果前两个字母总是辅音音,线条是黑色;总是元音音则画蓝色;有时元音有时辅音,则画红色:
展示「一个词的前两个字母是否足以判断该用 a 还是 an」的可视化
我还试着做了一张展示例外出现在哪里的可视化:
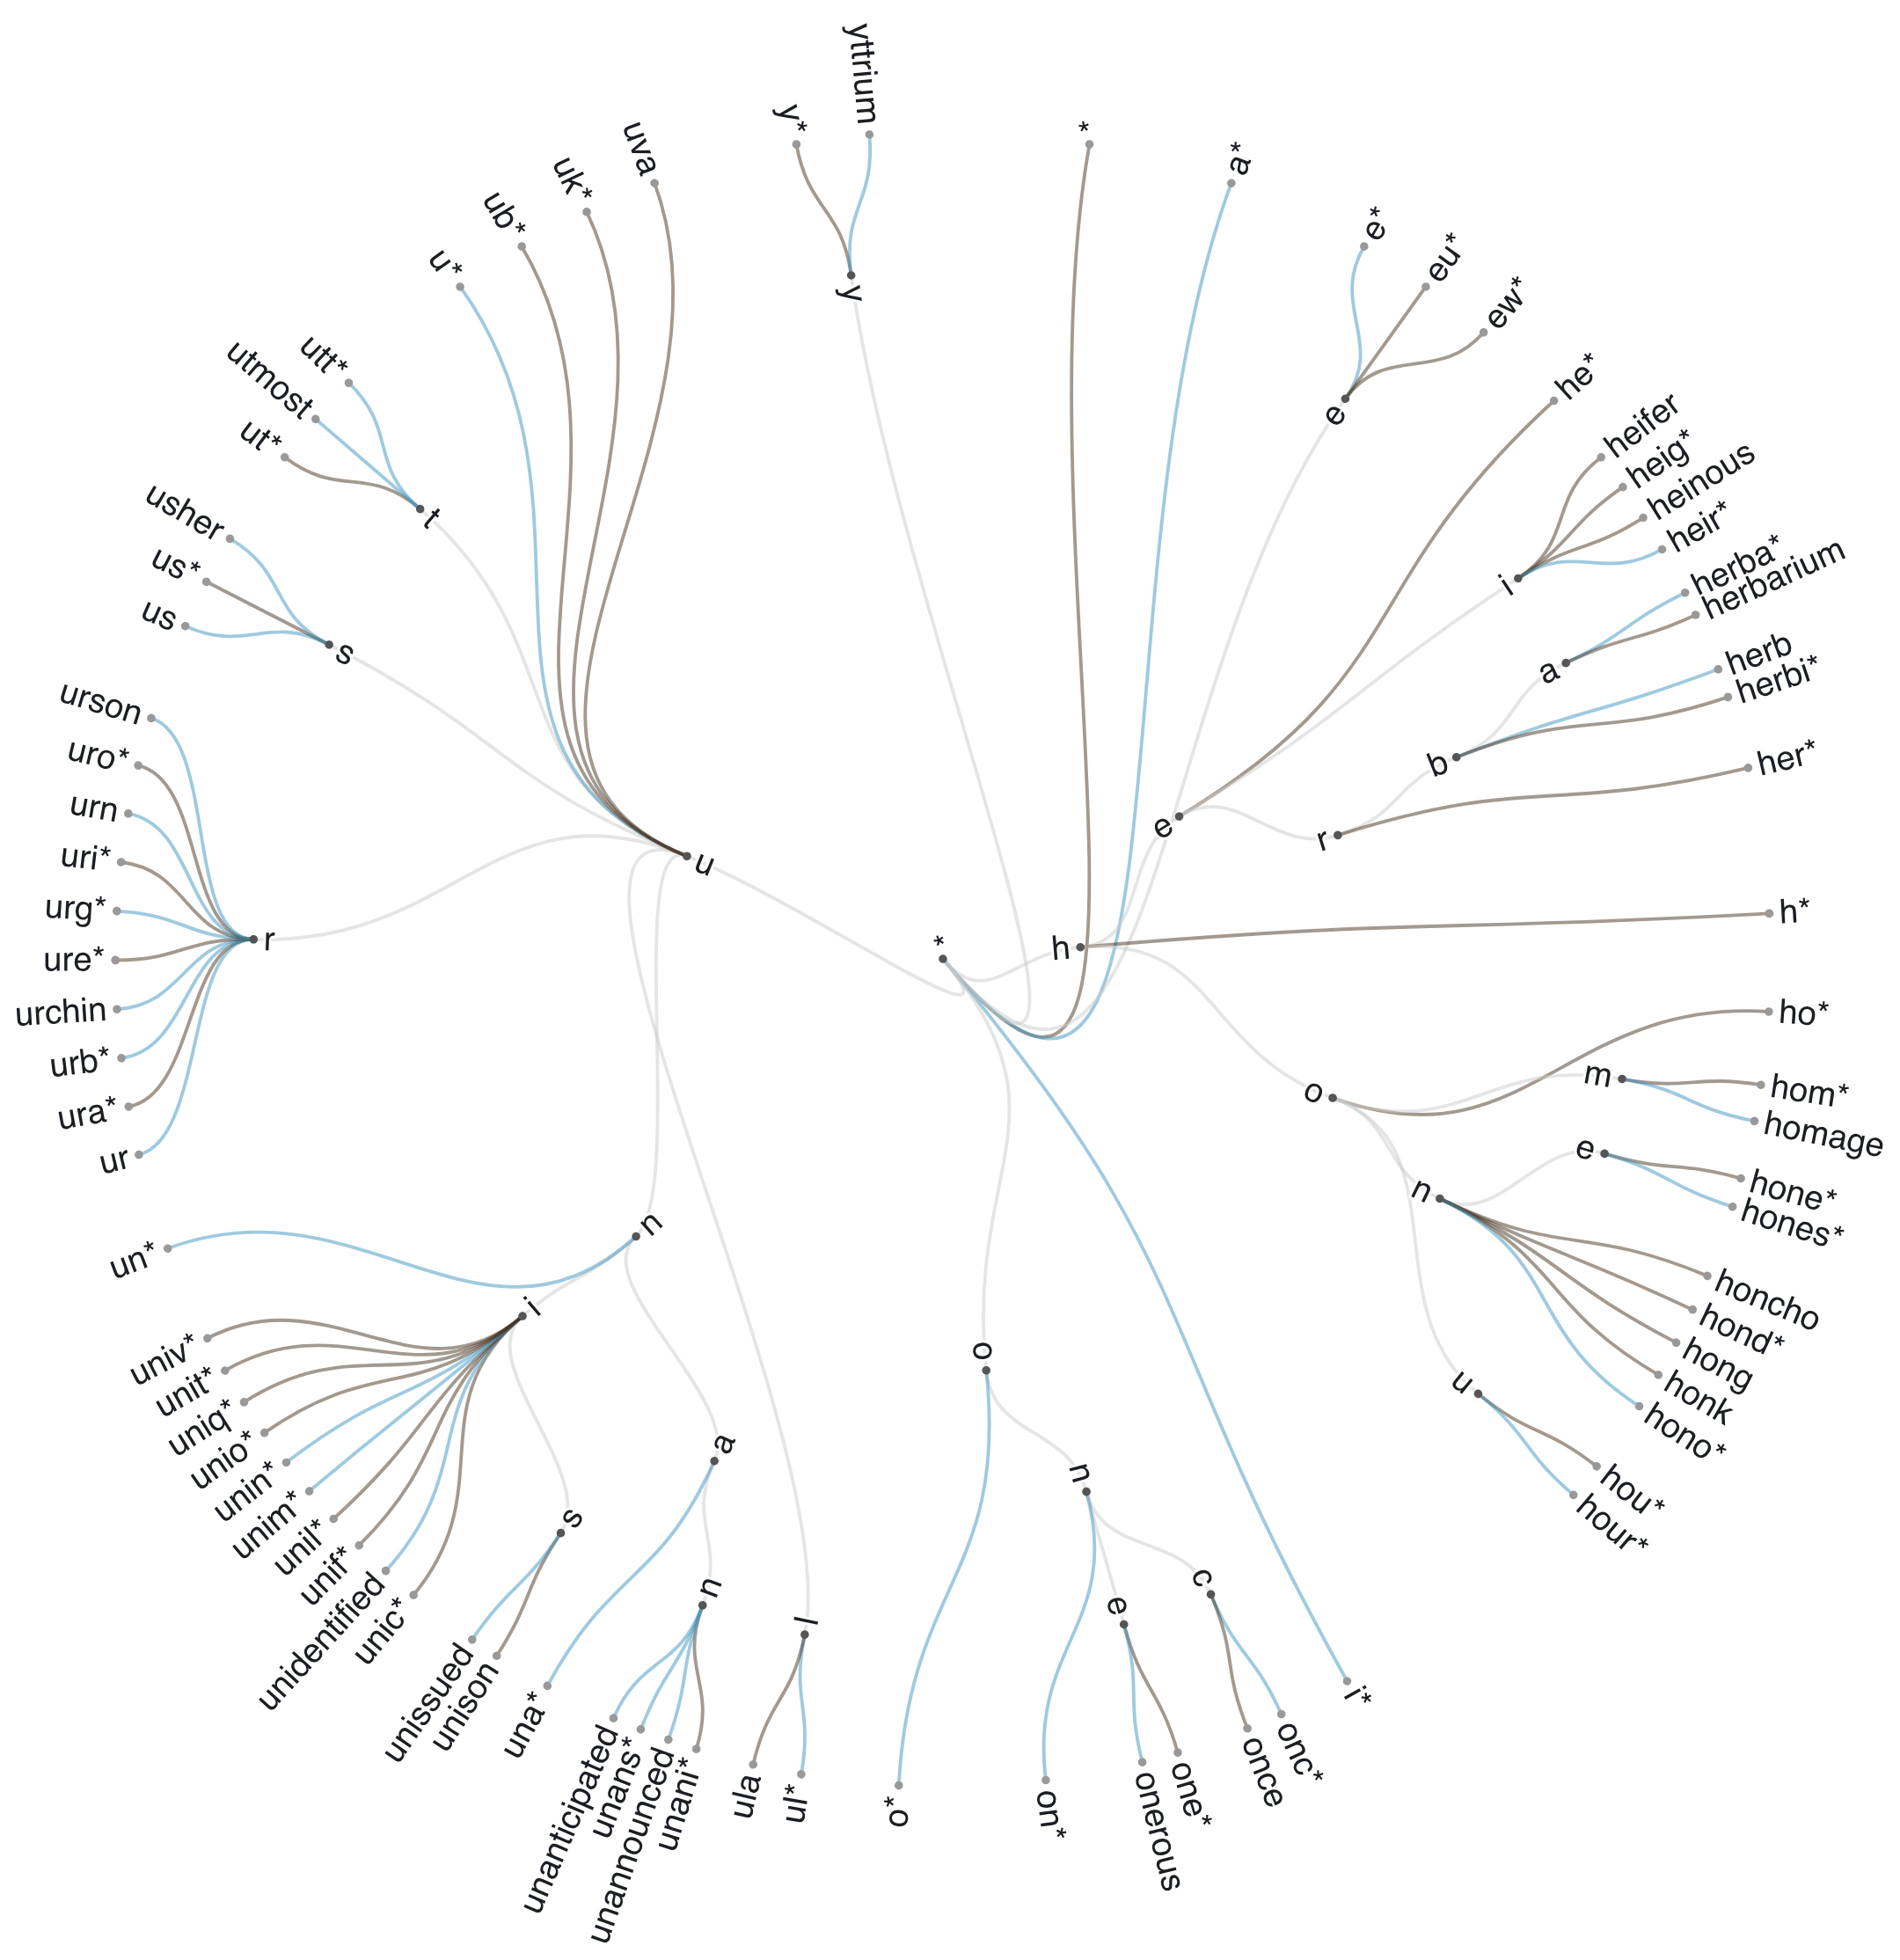
展示「我们需要看多少个字母才能决定 a 或 an」的可视化
我本想找出一个巧妙的算法,把它压缩成一棵最小的决策树——我想那会和 DFA 最小化有关。但我没能想出来,于是手工写了一套规则:
VOWELS = "aeiou"

def starts_with_vowel(word):
    if word.startswith("eu"): return False
    if word.startswith("ew"): return False
    if word.startswith("heir"): return True
    if word.startswith("herb") and not word.startswith("herbiv") and word != "herbarium" and word != "herbicide": return True
    if word.startswith("homage"): return True
    if word.startswith("hones"): return True
    if word.startswith("hono"): return True
    if word.startswith("hour"): return True
    if word.startswith("once"): return False
    if word.startswith("one") and not word.startswith("onerous"): return False
    if word.startswith("ula"): return False
    if word.startswith("unani"): return False
    if word.startswith("uni") and word[3:4] in "cfloqstv" and word != "unissued": return False
    if word.startswith("ub"): return False
    if word.startswith("uk"): return False
    if word.startswith("ur") and word[2:3] in VOWELS and word != "ur": return False
    if word.startswith("us") and word not in ("us", "usher"): return False
    if word.startswith("ut") and not (word.startswith("utm") or word.startswith("utt")): return False
    if word.startswith("uva"): return False
    if word.startswith("ytt"): return True
return word[0] in VOWELS一个沾边的话题:重新切分(rebracketing)——在大多数人还不会阅读的年代,人们听到 <a napron> 会误听成 <an apron>,听到 <an ewt> 会误听成 <a newt>。我们说 <an orange>,而在西班牙语里是 <naranja>,因为那个词原本就带一个前置的 <n>。