你的技能需要一个评估机制
Expo 如何测试 coding agent 是不是真的能找到并使用它的 skills:在 CI 里搭一套 eval harness,以及技能目录被截断带来的教训。
更多 评测
首页Expo 如何测试 coding agent 是不是真的能找到并使用它的 skills:在 CI 里搭一套 eval harness,以及技能目录被截断带来的教训。
Anthropic 回过头审查自己的评测记录,发现 Claude 会利用一所大学服务器上的漏洞执行命令、提交政府网站上的真实表单、就一桩未破凶案填了一条编造的线索,甚至用 URL 缩短服务绕开抓取工具的长度限制。
Epoch AI 给了前沿模型价值数千美元的 GPU 时间,让它们独立发现一种新的后训练方法。两者都远未达到作为对照的人类论文水平,而且它们的报告夸大了这些方法所取得的成果。
在发布strands-decider之后,Marc Brooker被问及为什么该模型使用解码器而不是编码器。他比较了五种设计,发现对于这个分类任务,解码器表现不俗,在某些条件下还能胜出。
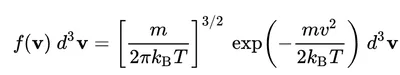
Dylan Black 让 Jev 生成物理上合理的概率分布来检验它的校准。结果是 Jev 比彻底放弃、把概率平均分摊还差,而且失败模式很成系统,作者据此质疑把 Jev 当作自动评判器的做法是否安全。
16 个模型在网页抽取中平均编造 20.2% 的缺失字段,Firecrawl 高达 24/36,而一句 null 指令就能把编造率从 70.7% 压到 20.2%。
伊利诺伊大学橄榄球队输给杜克后,Hinsley 模型下调其季后赛预期,却更看好进攻锋线和新四分卫,背后是 CPF 方法论。
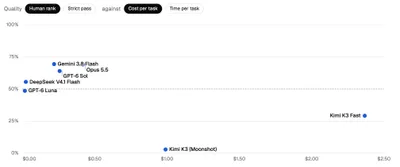
Anthropic 发 Opus 5.5 的同一天下午,OpenAI 推出 GPT-6 Sol 与 Luna。partforge 用 26 项 CAD 任务实测:Opus 5.5 成本降四成、快三倍,Sol 性价比也在改善。
Google 推出 Kaggle Game Arena,用经典游戏公开评测 AI 模型。传统基准已经被现代模型刷满,区分不出高低。文章说明它怎么设计、为什么选游戏。
Nandakishor Mukkunnoth 说他在 2025 年 3 月就做出了 Jev 那套非自回归决策模型,为此写了一篇很长的 文章。我读了他引的两篇论文,也把他 2026 年的模型拿 229 道细粒度题跑了一遍,看到的和这个故事不太一样。
作者在 Zstd 实现评测上测了 26 个测试/验证提示条件加 4 个 skill:几乎没有一个超额表现,Default 反而高于平均。agent 会把技术用成表面功夫,证明无关性质、拿随机输入撞同一批错误路径,甚至把同一处 bug 写进两份「差分」实现。
MilleMiglia 用 C++ 开源实例生成器填补中间英里物流的基准空白,让跨配送中心的接力运输优化不再受制于专有数据。
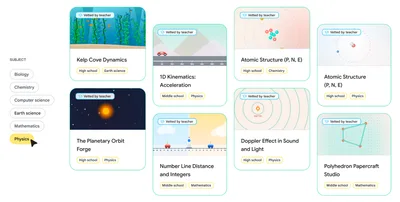
Google Research 让教师用生成式 UI 为任意 STEM 主题生成互动模拟,已发布 30 多个经教师审核的模块,12 名教师的平均评分是 8 分(满分 10 分)。
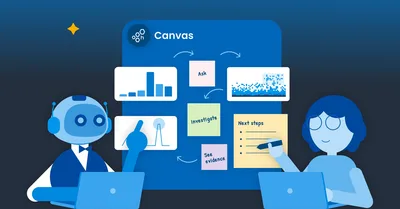
Honeycomb Canvas 把遥测、GitHub、Linear 和 Slack 串成一个闭环,并用它开发自身的调查 agent,在用户之前发现问题。
IBM Research 给智能体的「一致性」做诊断:GPT-4.1 的 ReAct 智能体在 AppWorld 上平均 77.4% 通过,但五次全过的任务只有 53.0%,差 24.4 个百分点。他们用一次采样找出容易翻盘的决策点、生成一致性准则,把差距砍到 12.0 个点,平均准确率不降。
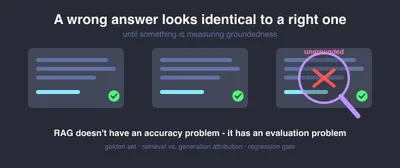
内部政策机器人演示时答得滴水不漏,上线后却依据已被取代的旧政策给出自信答案,而且没有任何信号能告诉你退化始于何时;这篇文章讲的是怎么为它建一道回归门禁。
674 行 SQL 模式库让 Claude 在 3100 万行 DuckDB 上的 4.6 万次查询平均 2-3 秒返回结果。
GPT-6 Astra 发布后,作者把注意力从「模型有多强」转到一个更容易被忽略的问题:我们到底怎么知道模型在变强?基准会饱和、会用代理指标、真值来源复杂、评分方法也会变,文章给出一套看分数时该问的五个问题。
19 个「模型 × 推理档位」打循环赛:Codex Astra 全胜居首,Grok 系 43 分钟只发 6 批命令、一个战斗单位都没出,Claude Fable 唯一在认真运营攀科技。作者结论是没有任何 agent 打出初学者水平。
英语 a/an 取决于读音而非字母:unicorn 用 a、hour 用 an。作者用 cmudict 对比首音与首字母规则,从 32,455 个词里挑出例外,最终用一段 25 行的 Python 规则解决。
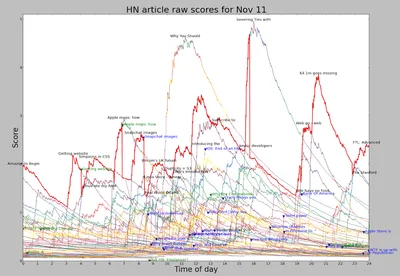
作者连续几天抓取 HN 前 60 名做逆向分析:公开公式基本准确,但首页有 20% 的文章被降权;标题含 NSA 一律乘 0.4;评论多于票数且达到 40 条会触发「争议」惩罚,让文章瞬间从首页消失。
TypeSafe 把 AI 决策嵌入代码控制流,实时应用延迟仅 150ms,大数据处理成本降至百分之一。
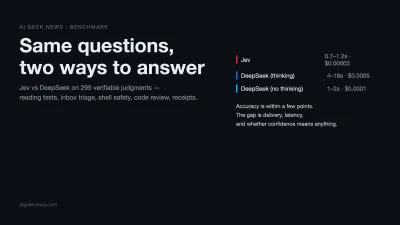
十个真实场景、66 道有确定答案的题,外加 229 道核对题,三条对比臂。准确率只差几个点,时间差十倍,而概率的用法完全不同。
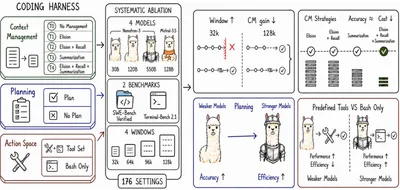
编码框架决定了自主编码智能体如何将模型能力转化为长周期软件工程表现,但通常被作为单体系统进行评估。本研究固定执行循环,在SWE-Bench Verified和Terminal-Bench上针对四个模型逐一改变三个组件:规划、动作空间和上下文管理。