大语言模型可证明推理的进展
Anthropic 的 FlashProve 为每个响应附加一个 zkSNARK,使从未见过权重的用户也能验证是哪个模型生成了这些 token,在单块 H100 上,一个 400B 模型的速度约为每秒 110 个 token。
更多 大模型
首页Anthropic 的 FlashProve 为每个响应附加一个 zkSNARK,使从未见过权重的用户也能验证是哪个模型生成了这些 token,在单块 H100 上,一个 400B 模型的速度约为每秒 110 个 token。
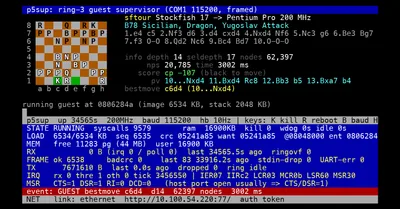
IBM 花了数百万美元打造深蓝,才在 1996 年击败 Kasparov。三十年后,一台 200 MHz 的 Pentium Pro 跑起现代 Stockfish,棋力约 3300 Elo,几乎肯定能赢。
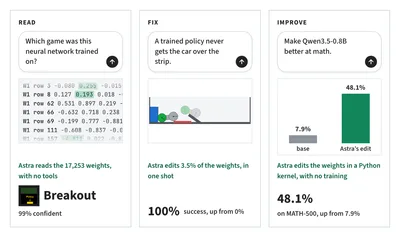
前沿大语言模型能够直接读写神经网络权重。Astra 仅凭原始权重就能识别网络是在哪个游戏上训练的,修复卡住的车辆策略,并将 Qwen3.5-0.8B 的 MATH-500 得分从 7.9% 提升至 48.1%。
Martin Fowler 说,读到 LLM 写的文章时会有一种说不清的抵触,像掉进文字版的恐怖谷,这种反应不是检测工具能安慰的。他给作者的建议很直接,别让模型写初稿,那股腔调在编辑阶段是赶不出去的。
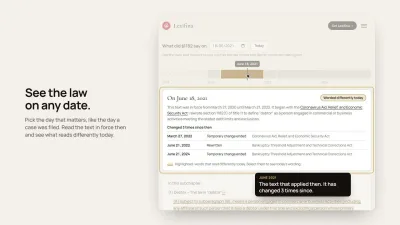
Lexifina 把美国法典九个编的每一次修订按日期重放,再和下一个官方发布点逐字比对,365 处改动里 361 处完全一致。律师挑一个日期,就能看到当天生效的条文,以及哪些措辞今天已经不同。
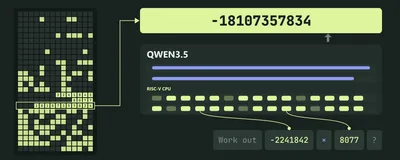
一个实验模型:把 RV32IM 核心编译进 Qwen3.5 4B 的权重,11 层 CPU 在模型的前向传播里执行,寄存器、内存和程序计数器都存在 Gated DeltaNet 的状态矩阵里。大整数运算从 48.6% 提到 100%。
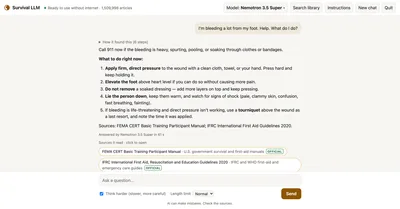
Survival LLM 是免费开源的桌面应用,本地模型在 150 万篇离线资料里检索,包括约 93 万篇维基百科、FEMA 与 CDC 指南、急救手册,每条回答都附上原文段落。作者还贴出一张分档测试表:内存越小,答对的越少。
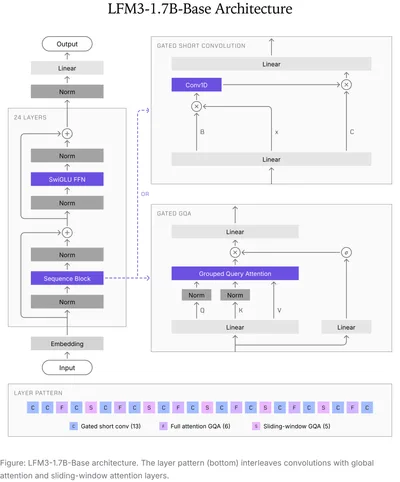
LFM3-1.7B 在 22T token 上预训练,24 层里 13 层是门控短卷积、5 层滑窗注意力、6 层全局注意力,4-bit 量化后约 1 GB,128K 上下文的 KV cache 只要 1.6 GB。同门还有视觉、音频、全模态和两个决策模型。
Sebastian Raschka 为其新书录制了八讲课程,从预训练的 Qwen3 0.6B 出发,依次讲解验证器、推理时扩展、GRPO 与蒸馏,全程使用 PyTorch。
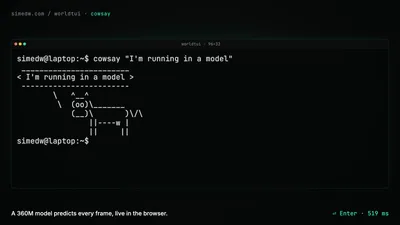
Simon Edwardsson 用逐次按键的方式,让 360M 参数的模型直接预测终端画面,背后没有 shell。行并行解码把整屏重绘从 6.7 秒压到 0.87 秒,最后整套模型以 208 MB 跑在浏览器标签页里。
Mark Bartlett 复现了 esp32-ai 的 TinyStories 模型,发现真正的瓶颈在 PSRAM 带宽,CPU 并不吃紧。五次不改变输出的改动把单 token 时间从 94.7 ms 压到 43.3 ms,生成文本仍逐字节相同。
Shopify 的 Sidekick 把最费 token 的活交给自己后训练的开源模型,GraphQL 子代理换上调过的 Nemotron 3.5 Lightning 后,判分略超前沿模型,快 7 倍、成本低约九成。
Dominik Picheta 造了一门专门跟 LLM 和编码 agent 作对的 esoteric 语言 KillSwitch,又拉来各大模型跑了一轮基准测试。
LLM 现在可以按需生成任何文档,这悄然破坏了科技公司赖以运转的合规、努力与学习的证据。
在 Claude 团队工作的 Felix Rieseberg 给出三种向模型要更多产出的路子:把视角抬高一层、把任务做深、把涉猎范围铺开;顺带讲了为什么 1939 年的 George Dantzig 在这里仍然算数。
把每一层都看作记忆存储,按相似度用键取回值,一个干扰信号比就能算出它能存多少:外积约 64 条,MLP 几千条,自注意力约一百万条。
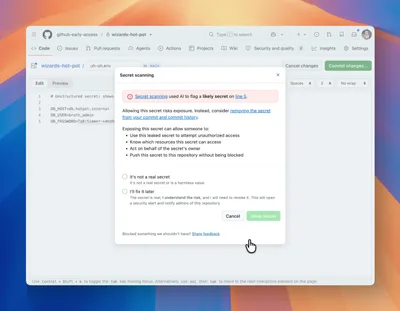
GitHub 用微调过的 ModernBERT 分类器换掉了远程 LLM 密钥扫描器。这个分类器会连候选内容和它周边的代码一起读,接受率提高 11.5%,扫描耗时中位数缩短 86%。
Meta 把广告推荐基础模型的复杂度扩展到 2.5 倍、训练 FLOPs 提升到 4 倍,再把学到的能力迁移进那几百个真正负责实时投放广告的小模型。
Cockroach Labs 如何把 MOLT Sinai 建成一座 AI 编码“教学医院”,不到两天就交付了 IBM Db2 迁移支持。
作者花三个月、约 600–700 亿 token,让 AI agent 把一款 FPS 反编译回 C++。第一个月进展看着漂亮,代码语义却全错,直到换上字节级比对,agent 才第一次有了不会说谎的验收标准。
一名软件工程师用自建的 AI 流水线检索荷兰东印度公司四个世纪的档案,找到一份任何陨石目录里都没有的 1812 年陨石报道、三头死在送往康提国王路上的爪哇犀牛,以及三次不在史密森尼火山名录里的喷发。
Epoch AI 给了前沿模型价值数千美元的 GPU 时间,让它们独立发现一种新的后训练方法。两者都远未达到作为对照的人类论文水平,而且它们的报告夸大了这些方法所取得的成果。
Fabien Sanglard 用 agent.md 让 LLM 生成接近手写水准的代码,告别每次会话重复同样的 code review 意见。
AI 让代码审查与单元测试消亡,写代码的手艺消失,构建软件的能力反而更重要,终端和 PM/设计/工程三人组也将被淘汰。