用 Gradio Workflow 重建 AUTOMATIC1111
Hugging Face 把 AUTOMATIC1111 的大部分功能重建成了同一张 Gradio 工作流画布:11 条媒体流水线、73 个节点,覆盖文生图、高清修复、图生图、提示词矩阵、VLM 反推、检测转遮罩、标注器、PNG Info 与图转视频;每个输出节点还自动变成 REST 端点与 MCP 工具。
中文
复制
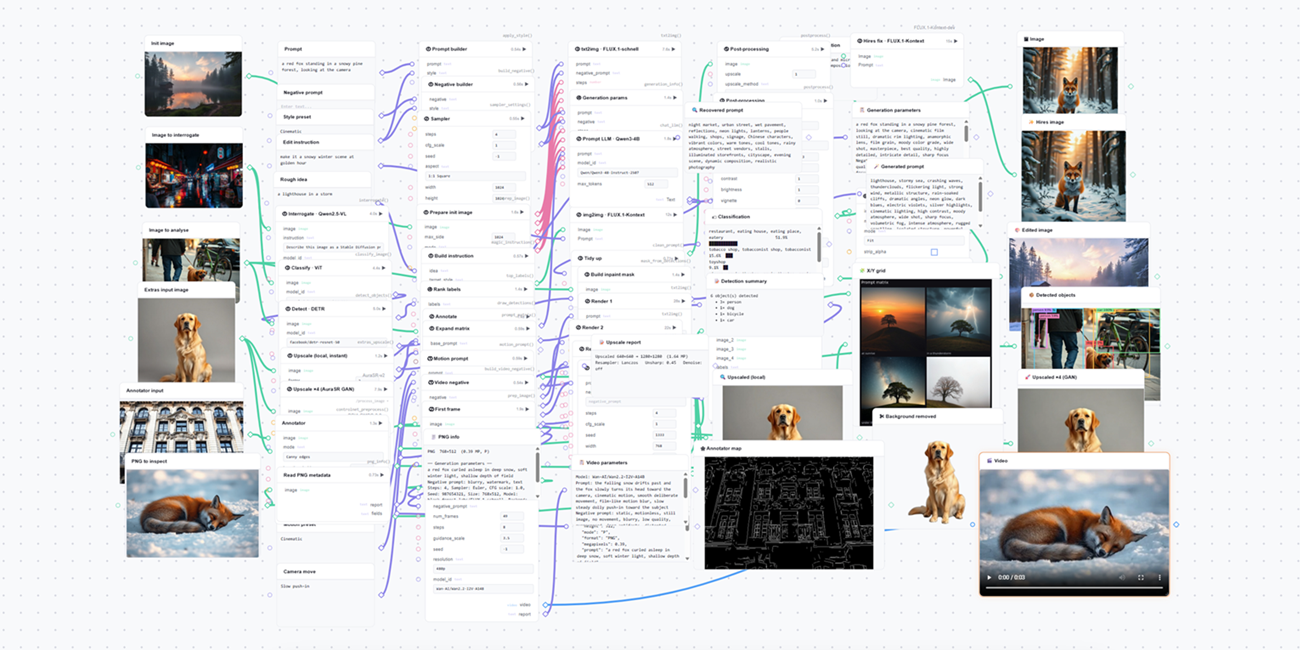
在上一篇里,我们搭了五个小的 gr.Workflow 图,并暗示了要做出像 AUTOMATIC1111 的 stable-diffusion-webui 那样复杂的东西需要什么。这一篇我们带你走一遍 Workflow1111,我们把 AUTOMATIC1111 的大部分功能重建在了同一张工作流画布上。
Workflow1111 是一张由 十一条媒体流水线、用 七十三个节点搭起来的图。它把文生图、高清修复、图生图、提示词矩阵网格、VLM 反推、检测转局部重绘遮罩、ControlNet 风格标注器、背景移除、PNG Info 存储和图片转视频的 SOTA 模型聚在一起。
你可以用 Hugging Face 账号登录、或者提供一个 access token 来运行其中任何一条流水线。登录之后,模型调用用的是你自己的额度。
👉 试试 Workflow1111,或者把这个 Space 复制一份,开始按你的用例重新接线。
我们来走一遍这张画布。
画布上有什么
所有媒体流水线都由上一篇和官方指南里讲过的那四种算子搭成。画布上的每个节点包着一个算子,算子的输入输出就是你可以连边的端口。快速回顾一下这四种算子:fn 是一个 Python 函数,model 是通过 InferenceClient 调用的模型,space 是另一个 Gradio Space,dataset 是 Hub 数据集里的一行。
我们逐条看这些流水线。
文生图
这是核心流水线。它有你在 A1111 的 txt2img 标签页里预期会有的控件:负向提示词、步数、CFG、种子、宽高,还有一个用来选 checkpoint 的 model_id 字段。提示词先经过一个提示词构建的 fn 节点,它把选中的风格预设附加上去并清理文本,然后进入一个 model 节点,通过 Inference Providers 调用那个 checkpoint。输出时有一个后处理的 fn 节点把生成参数写进 PNG 的元数据,这正是后面的 PNG Info 流水线要读回来的东西。
高清修复
在 Automatic1111 里,高清修复先放大 txt2img 的输出,然后跑第二遍去噪。在这里它变成了一条两个节点的绕路。文生图的结果进入一个 FLUX.1-Kontext model 节点,带一条细化指令(「enhance fine detail and micro-texture, keep the composition identical」),回来时更锐利、也更大。
图生图
同一个 Kontext 节点兼作图生图标签页。上传一张图,描述你想要的变化,它返回编辑后的图。
让 LLM 写提示词
从一个粗略的提示词开始,比如「A lighthouse in a storm.」。这条流水线把它发给一个 Qwen3-4B model 节点,再由一个小 fn 节点把回复变成一串干净的标签,最多四十个:「stormy sea, wet rocks, dramatic composition, low angle shot, volumetric lighting, ominous tone」。你可以把任何扩散模型节点接到这个输出上来渲染图片。
这里不涉及自定义节点,和 ComfyUI 不一样。在 Gradio 工作流里,LLM 和扩散模型都是同一张画布上普通的 model 算子。
把图片读回成提示词
这就像 AUTOMATIC1111 的 Interrogate 按钮,只是做反推的是 VLM 而不是 CLIP。Qwen2.5-VL 看着一张夜市照片,写出一段可能生成出它的提示词。一个 ViT 分类器节点读同一张图,返回标签:restaurant 51.9%、tobacco shop 15.6%、toyshop 9.1%。
两个节点用的是同一份图片输入,所以 gr.Workflow 并行运行它们,你拿到两个答案的时间大致等于跑一个的时间。
从检测生成局部重绘遮罩
AUTOMATIC1111 让你手动画局部重绘遮罩。这条流水线改用检测器生成一个。DETR 在一张街景照片里找到六个物体(三个人、一只狗、一辆自行车和一辆汽车),从那里工作流分成两支:一支把检测到的框画在原图上,另一支把它们变成一个可以往下游喂给局部重绘流水线的遮罩。
画框和造遮罩都在本地用 Pillow 和 NumPy 完成。只有那次检测调用离开了这台机器。
提示词矩阵
这就像 AUTOMATIC1111 的提示词矩阵。一个基础提示词「a lone oak tree」被一个 fn 节点与四个后缀(at sunrise、in a thunderstorm、under the Milky Way、in autumn fog)组合,每个变体进入它自己的文生图节点。最后一个节点把四张结果拼成一张接触印相。
gr.Workflow 没有循环算子,所以四个文生图节点并排放在画布上。因为它们的依赖深度相同,它们会并行运行,四张图同时开始生成。
放大与背景移除
这就像 Automatic1111 里的 Extras 标签页。有两个放大器节点,它们走的是不同的路线。第一个是在 fn 节点里做本地的 Lanczos 重采样,不需要网络调用,Pillow 能重采样多快它就多快完成。第二个是 AuraSR ×4,它是画布上第一个 space 节点:它调用 Hub 上的一个 Space,并把结果当作任何其他节点输出一样对待。
背景移除是同样的方式。BRIA RMBG-2.0 是另一个 space 节点,所以整个模型住在它自己的 Space 里,这张画布只是把它调进来。
标注器
Canny、线稿、素描、亮度深度和色调分离,是你在 Automatic1111 里通常从 ControlNet 扩展拿到的预处理器。在这里,每一个都是用纯 NumPy 写的 fn 节点,背后没有模型。在一张预置的建筑立面示例照片上,每个标注器在 CPU 上大约花半秒。
这个应用里有 36 个算子节点,其中 32 个是 fn 节点,而这 32 个里有 22 个完全在进程内运行、不需要网络调用。断网之后,大约三分之二的画布仍然能工作。因为这些都是普通的 Python 函数,你也可以直接测试它们,不涉及画布、服务器或 GPU。
PNG Info
AUTOMATIC1111 把生成细节存在 PNG 的 parameters 文本块里,PNG Info 标签页把它们读回来。Workflow1111 做的是同一件事。文生图流水线上的后处理节点写入元数据,这条流水线把它读出来,包括提示词、负向提示词、步数、CFG、种子、图片尺寸和模型。
图片转视频
PNG Info 读取的那个图片节点同时也喂给一个 Wan 2.2 I2V A14B 节点,由它把图片做成动画;在演示示例里,一只睡着的狐狸醒来并开始活动。这里没有第二个上传框,因为一个参考节点可以喂给任意多个下游流水线,所以一次上传就能让它的元数据被读取、同时被做成动画,全在同一张画布上。
在你自己的 GPU 上跑模型
到目前为止,每一次模型调用都跑在别人的硬件上,通过 Inference Providers 或一个 Space。这就是为什么你不需要自己的 GPU,也能搭出并运行 Workflow1111 这样的东西。
不过 fn 节点就是 Python,所以它同样可以在本地加载一个模型、在你自己的 GPU 上跑。FastVideo/fastvideo-fasth3-preview 就是一个 gr.Workflow 应用,做的正是这件事。它跑 FastH3,那是 MiniMax-H3 的四步蒸馏版,在 ZeroGPU 上生成带音轨的视频。
整个应用归结为一个被绑定的函数:
@spaces.GPU(duration=get_duration, size=GPU_SIZE)
def _generate(prompt_embeds, text_token_tags, height, width, num_frames, seed):
    ...

gr.Workflow(bind={"generate": generate, "status": status}).launch()
ZeroGPU 在函数需要时给它一块 GPU,调用结束就释放。gr.Workflow 完全不需要知道这些。它只是调用那个 fn 节点。
这也不专属于 Spaces。把 bind= 指向一个加载本地 checkpoint 的函数,在你自己的机器上跑 .launch(),Workflow1111 这张画布就能驱动你自己的 GPU。
每个输出都是一个 API
画布上每一个输出节点都会变成一个 REST 端点,不需要手写任何路由。Workflow1111 暴露了九个:/image、/edited_image、/generated_prompt、/recovered_prompt、/detected_objects、/x_y_grid、/upscaled_local、/annotator_map 和 /png_info。
from gradio_client import Client

client = Client("ysharma/Workflow1111", oauth_token="hf_...")

image, params, hires = client.predict(
    "a red fox in a snowy pine forest",  # Prompt
    "",                                  # Negative prompt
    "Cinematic",                         # Style preset
    "enhance fine detail",               # Hires refine instruction
    api_name="/image",
)
同样的端点也是 MCP 工具。用 mcp_server=True 启动(指南),每个输出节点就会作为一个 AI 助手可以调用的工具出现。把 Claude Code、Cursor 或任何 MCP 客户端指向这个服务器 URL:
{
  "mcpServers": {
    "workflow1111": {
      "url": "https://ysharma-workflow1111.hf.space/gradio_api/mcp/",
      "headers": { "X-HF-Token": "hf_..." }
    }
  }
}
现在一个 agent 就能把生成图片、把提示词读回来、或跑一次检测当作更大任务里的步骤,不需要任何胶水代码。每个调用方在 X-HF-Token 头里带上自己的 token,所以这个 Space 自己不持有任何 token。
它和 ComfyUI 的关系
AUTOMATIC1111 给了我们功能清单,但真正会被拿来和 Gradio Workflow 比较的工具是 ComfyUI,因为两者都是节点图。对人们想搭、想交付的很多东西来说,gr.Workflow 覆盖的是同一片地面。
- 一个节点可以是你并不拥有的硬件。 它可以通过 Inference Providers 运行、调用 Hub 上的任何 Space 或任何 API,或者从数据集里取数据。Workflow1111 就是这样在没有自己的 GPU 的情况下跑起来的。
- 每个输出都变成一个有类型的 REST 端点。 端点是从图上生成的。
- 访客可以用自己的身份运行工作流。 打开 OAuth,分享公开 URL,任何人都能登录并使用这个应用,不需要安装任何东西。
- 在同一张画布上混合模型和模态。 扩散模型、LLM、VLM、检测器和视频模型都可以是同一个工作流的一部分。
- 需要定制?写个函数。 自定义节点就是一个 Python 函数,所以 Python 能做的它都能做。
结果就是一条多模型流水线,人们可以在浏览器里打开、登录、立刻使用,并且可以从代码里调用。
搭一个你自己的
Workflow1111 有 73 个节点,但它一开始只有这些:
import gradio as gr

def your_function(text: str) -> str:
    pass

gr.Workflow(bind=[your_function]).launch()
bind= 把你的函数变成节点,edges= 把它们连起来,.launch() 在你的浏览器里打开画布,让你可以继续在那里编辑。准备好之后,gradio deploy 把整个东西放到一个 Space 上。gr.Workflow 指南里有全部细节,包括 JSON schema 和每一种算子类型。
如果你更想从一个已经能跑的东西开始,打开 Workflow1111,点 Duplicate,挑十一条流水线中的一条来改:删节点、换模型、重新接线。如果你更想从小处开始,上一篇里有五个工作流,每个大约一分钟就能跑起来。
不管你搭了什么,发到 X 上并 @ @gradio。我们很乐意帮你扩散。