Gradio Workflow で AUTOMATIC1111 を再構築する
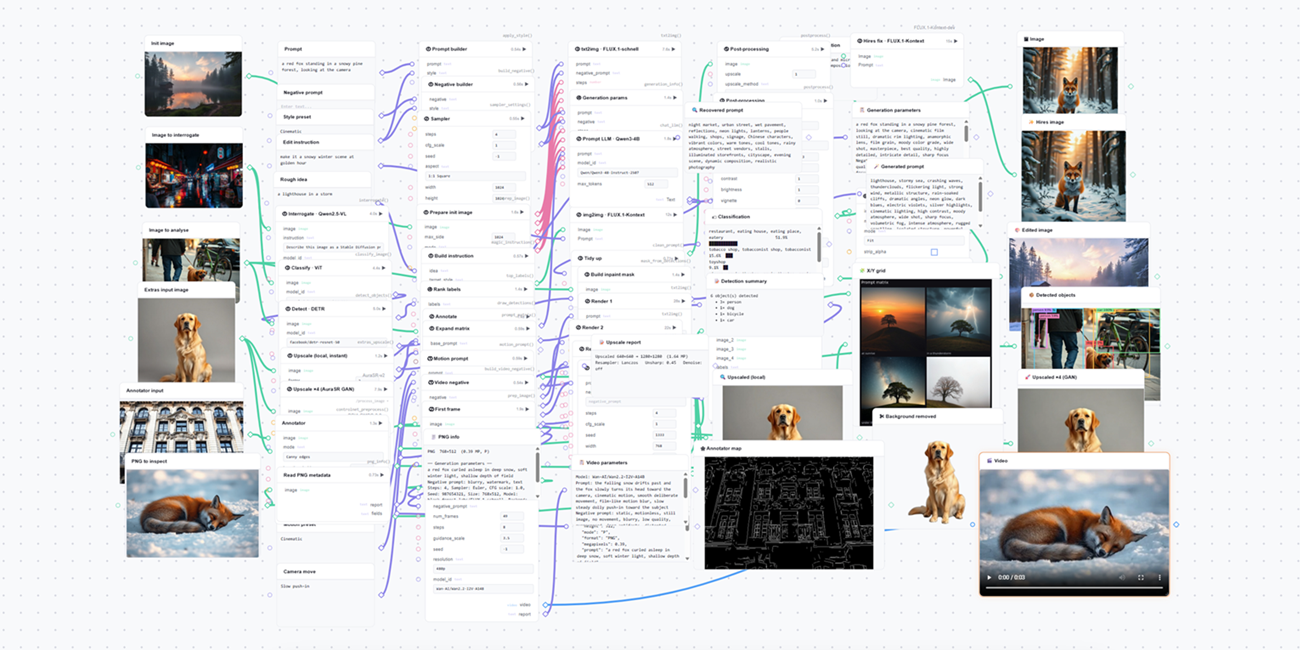
Hugging Face は AUTOMATIC1111 のほとんどの機能を同じ Gradio ワークフローキャンバス上に再構築しました。11 本のメディアパイプライン、73 個のノードで、テキストから画像生成、高解像度修復、画像から画像生成、プロンプトマトリクス、VLM 逆推論、検出からマスクへの変換、アノテーター、PNG Info、画像から動画への変換をカバーし、各出力ノードは自動的に REST エンドポイントと MCP ツールにもなります。
日本語
コピー
Gradio Workflow で AUTOMATIC1111 を作り直す
前回の記事では、小さな gr.Workflow のグラフを5つ組み立て、AUTOMATIC1111 の stable-diffusion-webui のような複雑なものを作るには何が必要かをおぼろげに示した。今回は Workflow1111 を一緒に見ていこう。AUTOMATIC1111 の機能の大部分を、同じワークフローキャンバス上に作り直したものだ。
Workflow1111 は 11本のメディアパイプラインを 73個のノードで組んだ1枚のグラフだ。text-to-image、hires fix、image-to-image、prompt matrix grid、VLM による逆算、検出から inpaint マスクの生成、ControlNet 風のアノテーター、背景除去、PNG Info の保存、image-to-video の SOTA モデルまでを1か所に集めている。
Hugging Face アカウントでログインするか、access token を渡せば、どのパイプラインでも実行できる。ログインすれば、モデル呼び出しは自分のクォータで動く。
👉 Workflow1111 を試す。あるいはこの Space を複製して、自分のユースケースに合わせて配線を組み直してほしい。
キャンバスを見ていこう。
キャンバスの中身
メディアパイプラインはすべて、前回の記事と公式ガイドで説明した4種類の演算子でできている。キャンバス上の各ノードは演算子を1つ包んでいて、演算子の入力と出力がそのまま配線できるポートになる。4種類をおさらいすると、fn は Python 関数、model は InferenceClient 経由で呼び出すモデル、space は別の Gradio Space、dataset は Hub データセットの1行だ。
パイプラインを1本ずつ見ていく。
Text-to-image
これが中心となるパイプラインだ。A1111 の txt2img タブにあるはずのコントロールが揃っている。ネガティブプロンプト、ステップ数、CFG、シード、幅と高さ、そして checkpoint を選ぶ model_id フィールド。プロンプトはまずプロンプト構築用の fn ノードを通り、選んだスタイルプリセットを付加してテキストを整える。次に model ノードへ入り、Inference Providers 経由でその checkpoint を呼び出す。出力側では後処理の fn ノードが生成パラメータを PNG のメタデータに書き込む。これが後段の PNG Info パイプラインで読み戻されるものだ。
Hires fix
Automatic1111 では、hires fix は txt2img の出力をいったん拡大し、2パス目のデノイズを走らせる。ここでは2ノードの寄り道になる。text-to-image の結果が FLUX.1-Kontext の model ノードに入り、精細化の指示(「enhance fine detail and micro-texture, keep the composition identical」)を添えて、よりシャープに、より大きく戻ってくる。
Image-to-image
同じ Kontext ノードが image-to-image タブを兼ねる。画像をアップロードし、欲しい変化を書けば、編集後の画像が返る。
LLM にプロンプトを書かせる
「A lighthouse in a storm.」のような雑なプロンプトから始める。このパイプラインはそれを Qwen3-4B の model ノードに送り、小さな fn ノードが返答を最大40個のきれいなタグの列に変える。「stormy sea, wet rocks, dramatic composition, low angle shot, volumetric lighting, ominous tone」。この出力に任意の拡散モデルノードを繋げば画像をレンダリングできる。
ComfyUI と違い、カスタムノードは関与しない。Gradio ワークフローでは、LLM も拡散モデルも同じキャンバス上の普通の model 演算子だ。
画像をプロンプトに読み戻す
AUTOMATIC1111 の Interrogate ボタンに似ているが、逆算するのは CLIP ではなく VLM だ。Qwen2.5-VL が夜市の写真を見て、それを生成しうるプロンプトを書き出す。ViT 分類器ノードが同じ画像を読み、ラベルを返す。restaurant 51.9%、tobacco shop 15.6%、toyshop 9.1%。
2つのノードは同じ画像入力を共有しているので、gr.Workflow が並列に走らせ、2つの答えをほぼ1回分の時間で受け取れる。
検出から inpaint マスクを生成する
AUTOMATIC1111 では inpaint マスクを手で描く。このパイプラインは代わりに検出器で生成する。DETR が街並みの写真から6つの物体(人3人、犬1匹、自転車1台、車1台)を見つけ、そこからワークフローは2つに分かれる。片方は検出したボックスを元画像に描き、もう片方はそれをマスクに変えて、下流の inpaint パイプラインへ渡せるようにする。
ボックスの描画もマスクの生成も、Pillow と NumPy でローカルに完結する。マシンの外に出るのは検出の呼び出しだけだ。
Prompt matrix
AUTOMATIC1111 の prompt matrix と同じだ。ベースプロンプト「a lone oak tree」を fn ノードが4つのサフィックス(at sunrise、in a thunderstorm、under the Milky Way、in autumn fog)と組み合わせ、各バリアントがそれぞれの text-to-image ノードに入る。最後のノードが4枚の結果を1枚のコンタクトシートに並べる。
gr.Workflow 循環演算子がないので、4つのテキストto画像ノードはキャンバス上に横並びに置かれる。依存の深さが同じなので並列に実行され、4枚の画像が同時に生成され始める。
アップスケールと背景除去
Automatic1111のExtrasタブと同じようなものだ。アップスケーラーは2つあり、それぞれ別のルートを通る。1つ目はfnノード内でローカルのLanczosリサンプリングを行う。ネットワーク呼び出しは不要で、Pillowがリサンプリングできる速さでそのまま終わる。2つ目はAuraSR ×4で、キャンバス上で最初のspaceノードになる。Hub上のSpaceを呼び出し、結果は他のノード出力とまったく同じように扱われる。
背景除去も同じ仕組みだ。BRIA RMBG-2.0も別のspaceノードなので、モデル全体は専用のSpaceの中にあり、このキャンバスはそれを呼び出しているだけになる。
アノテーター
Canny、線画、スケッチ、輝度深度、ポスタライズは、Automatic1111では通常ControlNet拡張から取ってくる前処理だ。ここではどれも純粋なNumPyで書かれたfnノードで、背後にモデルはない。プリセットの建築ファサードのサンプル写真では、各アノテーターはCPUで0.5秒ほどかかる。
このアプリには36個の演算子ノードがあり、うち32個がfnノード、その32個のうち22個は完全にプロセス内で動き、ネットワーク呼び出しを必要としない。ネットを切っても、キャンバスのおよそ3分の2は動き続ける。どれも普通のPython関数なので、キャンバスもサーバーもGPUも介さず直接テストできる。
PNG Info
AUTOMATIC1111は生成の詳細をPNGのparametersテキストチャンクに書き込み、PNG Infoタブがそれを読み戻す。Workflow1111も同じことをする。テキストto画像パイプラインの後処理ノードがメタデータを書き込み、このパイプラインがそれを読み出す。プロンプト、ネガティブプロンプト、ステップ数、CFG、シード、画像サイズ、モデルまで含まれる。
画像to動画
PNG Infoが読むのと同じ画像ノードは、Wan 2.2 I2V A14Bノードにも渡され、こちらが画像をアニメーションにする。デモの例では、眠っていたキツネが目を覚まして動き出す。ここに2つ目のアップロード欄はない。1つの参照ノードを好きなだけ下流のパイプラインに渡せるので、1回のアップロードでメタデータが読み取られ、同時にアニメーションにもなる。すべて同じキャンバス上で。
自分のGPUでモデルを動かす
ここまでのモデル呼び出しはすべて、Inference ProvidersかSpaceを通じて他人のハードウェアで動いていた。だからこそ、自分のGPUがなくてもWorkflow1111のようなものを組み立てて動かせる。
とはいえfnノードはPythonなので、ローカルでモデルを読み込み、自分のGPUで動かすこともできる。FastVideo/fastvideo-fasth3-previewはまさにそれを行うgr.Workflowアプリだ。FastH3を動かす。これはMiniMax-H3の4ステップ蒸留版で、ZeroGPU上で音声トラック付きの動画を生成する。
アプリ全体は、束ねられた1つの関数に帰着する:
@spaces.GPU(duration=get_duration, size=GPU_SIZE)
def _generate(prompt_embeds, text_token_tags, height, width, num_frames, seed):
    ...

gr.Workflow(bind={"generate": generate, "status": status}).launch()ZeroGPUは関数が必要としたときにGPUを渡し、呼び出しが終われば解放する。gr.Workflowはそのことを一切知る必要がない。ただfnノードを呼び出すだけだ。
これはSpaces専用でもない。bind=をローカルのcheckpointを読み込む関数に向け、自分のマシンで.launch()を動かせば、Workflow1111のキャンバスが自分のGPUを駆動する。
すべての出力がAPIになる
キャンバス上の出力ノードはそれぞれRESTエンドポイントになる。ルートを手で書く必要はない。Workflow1111は9つ公開している: /image、/edited_image、/generated_prompt、/recovered_prompt、/detected_objects、/x_y_grid、/upscaled_local、/annotator_map、/png_info。
from gradio_client import Client

client = Client("ysharma/Workflow1111", oauth_token="hf_...")

image, params, hires = client.predict(
    "a red fox in a snowy pine forest",  # Prompt
    "",                                  # Negative prompt
    "Cinematic",                         # Style preset
    "enhance fine detail",               # Hires refine instruction
    api_name="/image",
)同じエンドポイントはMCPツールでもある。mcp_server=Trueで起動すると(ガイド)、各出力ノードがAIアシスタントから呼び出せるツールとして現れる。Claude Code、Cursor、その他のMCPクライアントをこのサーバーURLに向ければいい:
{
  "mcpServers": {
    "workflow1111": {
      "url": "https://ysharma-workflow1111.hf.space/gradio_api/mcp/",
      "headers": { "X-HF-Token": "hf_..." }
    }
  }
}これでagentは、画像生成、プロンプトの読み戻し、検出の実行を、より大きなタスクのステップとして扱える。グルーコードは一切不要だ。各呼び出し元はX-HF-Tokenヘッダーに自分のトークンを載せるので、このSpace自身はトークンを保持しない。
ComfyUIとの関係
機能リストを与えてくれたのはAUTOMATIC1111だが、Gradio Workflowと本当に比較されるのはComfyUIだ。どちらもノードグラフだからだ。人が組みたくて届けたいものの多くで、gr.Workflowは同じ領域をカバーしている。
- ノードは自分が持っていないハードウェアでもいい。 Inference Providers経由で動かしたり、Hub上の任意のSpaceや任意のAPIを呼び出したり、データセットからデータを取ってきたりできる。Workflow1111が自分のGPUなしで動いているのはこういう仕組みだ。
- すべての出力が型付きのRESTエンドポイントになる。 エンドポイントはグラフから生成される。
- 訪問者は自分のIDでワークフローを実行できる。 OAuthを有効にして公開URLを共有すれば、誰でもログインしてこのアプリを使える。インストールは何も要らない。
- 同じキャンバス上でモデルとモダリティを混ぜられる。 拡散モデル、LLM、VLM、検出器、動画モデルがすべて同じワークフローの一部になれる。
- カスタマイズが必要なら、関数を書けばいい。 カスタムノードはPython関数なので、Pythonにできることは何でもできる。
出来上がるのはマルチモデルのパイプラインだ。ブラウザで開いてログインすればすぐ使えるし、コードから呼び出すこともできる。
自分で作る
Workflow1111 には 73 個のノードがあるが、最初はこれだけだった。
import gradio as gr

def your_function(text: str) -> str:
    pass

gr.Workflow(bind=[your_function]).launch()
bind= で関数をノードにし、edges= でそれらをつなぎ、.launch() でブラウザにキャンバスを開けばそのまま編集を続けられる。準備ができたら、gradio deploy で全体を Space に載せる。gr.Workflow ガイドに JSON schema や各オペレータ型を含む詳細がすべて載っている。
すでに動くものから始めたいなら、Workflow1111 を開いて Duplicate をクリックし、11 本のパイプラインから 1 つ選んで手を入れるといい。ノードを消す、モデルを差し替える、配線をやり直す。小さく始めたいなら、前回の記事に 5 つのワークフローがあり、どれも 1 分ほどで動かせる。
何を作ったにせよ、X に投稿して @gradio をメンションしてほしい。喜んで拡散する。