大規模言語モデルにおける証明可能な推論の進展
AnthropicのFlashProveは各応答にzkSNARKを付与し、重みを見ることのないユーザーでもどのモデルがトークンを生成したかを検証可能にします。1台のH100上で400Bモデルを毎秒約110トークンで処理します。
もっと見る LLM
ホームAnthropicのFlashProveは各応答にzkSNARKを付与し、重みを見ることのないユーザーでもどのモデルがトークンを生成したかを検証可能にします。1台のH100上で400Bモデルを毎秒約110トークンで処理します。
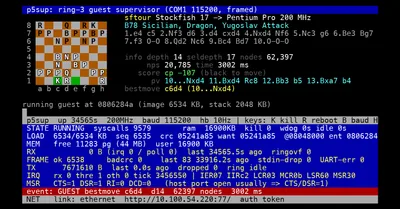
IBM は数百万ドルをかけてディープブルーを作り、1996 年に Kasparov を破った。30 年後、200 MHz の Pentium Pro で現代の Stockfish を動かすと、棋力は約 3300 Elo になり、ほぼ確実に勝てる。
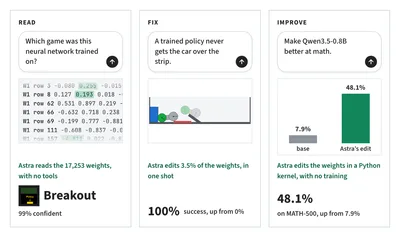
フロンティア LLM はニューラルネットワークの重みを直接読み書きできる。Astra は生の重みからネットワークのゲームを特定し、行き詰まった車のポリシーを修正し、Qwen3.5-0.8B の MATH-500 スコアを 7.9% から 48.1% に引き上げる。
Martin Fowler は、LLM が書いた文章を読むと人の側に固有の反応が起きると言う。文章の恐怖の谷とでもいうべき感覚で、検出ツールでは打ち消せない。著者への助言は明快だ。下書きをモデルに書かせてはいけない。あの文体は編集では追い出せない。
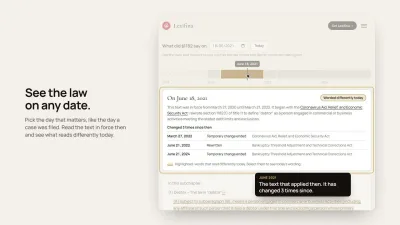
Lexifina はアメリカ法典9つの編について改正をすべて日付順に再生し、次の公式リリースポイントと一字一句突き合わせた。365 件の変更のうち 361 件が完全一致。日付を選べば、その日に効いていた条文が読める。
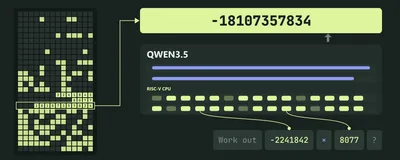
Qwen3.5 4B の重みに RV32IM の CPU コアをコンパイルし、11 層がモデルの順伝播の中で動く。レジスタもメモリもプログラムカウンタも Gated DeltaNet の状態行列に載せる。大きな整数の演算は 48.6% から 100% になった。
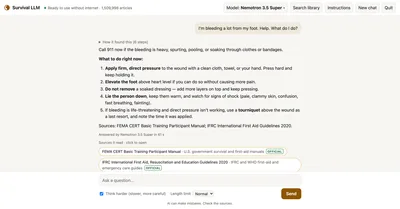
Survival LLM は無料のオープンソースのデスクトップアプリ。ローカルモデルが約93万件のWikipedia、FEMAとCDCのガイド、応急処置マニュアルなど150万件のオフライン資料を検索し、回答ごとに根拠の段落を示す。作者はメモリ別の正答率表も公開している。
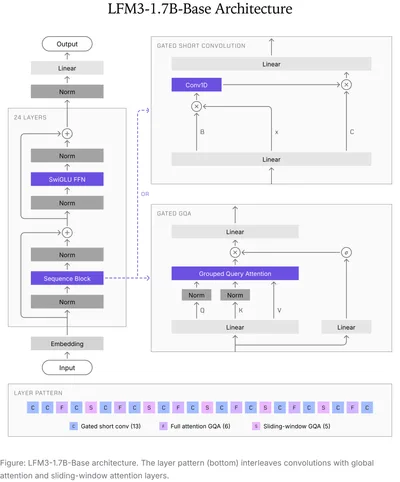
LFM3-1.7B は 22T トークンで事前学習し、24 層のうち 13 層がゲート付き短畳み込み、5 層がスライディングウィンドウ注意、6 層がグローバル注意。4bit で約 1 GB、128K コンテキストの KV キャッシュは 1.6 GB に収まる。視覚・音声・オムニ・判断の各モデルも同じ骨格から派生した。
Sebastian Raschka が新著に合わせて 8 回の講義を収録した。事前学習済みの Qwen3 0.6B から出発し、検証器、推論時のスケーリング、GRPO、蒸留を PyTorch で順に実装していく。
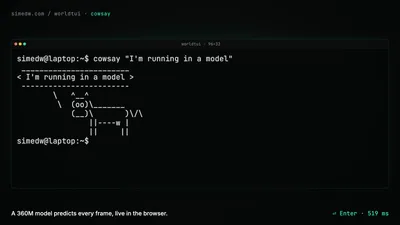
Simon Edwardsson は 360M パラメータのモデルを微調整し、シェルなしでキー入力ごとにターミナル画面の内容を予測した。並列デコードにより、完全な再描画が 6.7 秒から 0.87 秒に短縮され、システム全体は現在 208 MB でブラウザタブ内で動作している。
Mark Bartlett は esp32-ai の TinyStories モデルを再現し、律速は PSRAM の帯域で CPU は余っていたと特定した。出力を変えない 5 つの変更で 1 トークンあたり 94.7 ms を 43.3 ms に短縮した。
Shopify の Sidekick は最もトークンを消費する作業を自社でポストトレーニングしたオープンモデルに任せている。GraphQL サブエージェントを調整済みの Nemotron 3.5 Lightning に置き換えたところ、スコアはフロンティアモデルをわずかに上回り、7 倍速く、コストは約 9 割削減された。
Dominik Picheta は、LLM とコーディングエージェントをできる限り困らせるよう設計した esoteric 言語 KillSwitch を作り、主要モデルでベンチマークを取った。
LLM は今やあらゆる文書をオンデマンドで生成でき、テック企業が依拠するコンプライアンス・努力・学習の証拠を静かに損なっている。
Claude の開発に携わる Felix Rieseberg が、モデルにもっと多くを求める三つの方向を挙げる。視座を一段上げること、同じ題を深く掘ること、扱う領域を広げること。1939 年の George Dantzig が今も効く理由も添えている。
各層を記憶ストアと見なすと、1 つの干渉信号比からどれだけ記憶できるかが分かる。外積は約 64 件、MLP は数千件、自己注意は約 100 万件。
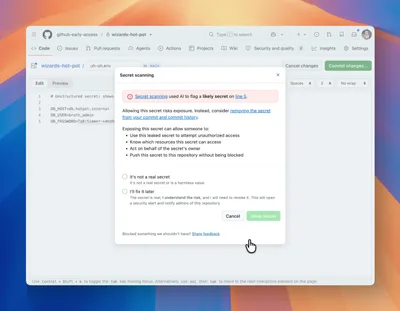
GitHub はリモート LLM のシークレットスキャナーを、微調整した ModernBERT 分類器に置き換えた。候補と周辺コードをまとめて読んで判断する方式で、受理率は 11.5% 上がり、スキャン時間の中央値は 86% 短くなった。
Meta は広告推薦の基盤モデルの複雑さを 2.5 倍、学習 FLOPs を 4 倍に広げ、そこで学んだものを、実際にリアルタイムで広告を配信している数百の小規模モデルへ転移させた。
Cockroach Labs は、IBM Db2 移行サポートを2日足らずで提供した AI コーディングの「教育病院」MOLT Sinai をどう作ったのか。
筆者は3か月と600〜700億トークンを投じ、AIエージェントにFPSゲームをC++へ逆コンパイルさせた。最初の1か月は進捗が順調に見えて意味的には間違いだらけで、バイト単位の照合を入れて初めて、嘘をつかない合格判定を得た。
ソフトウェアエンジニアが自作のAIパイプラインでオランダ東インド会社の4世紀にわたるアーカイブを検索し、どの隕石カタログにも載っていない1812年の隕石報告、キャンディ王への道中で死んだ3頭のジャワサイ、スミソニアンの火山名簿にない3回の噴火を発見した。
Epoch AIは最先端モデルに数千ドル相当のGPU時間を与え、新しいポストトレーニング手法を独自に発見させた。どちらも対照となる人間の論文水準には遠く及ばず、報告書はこれらの手法が達成した成果を誇張していた。
Fabien Sanglard は agent.md で LLM に手書きに近いコードを生成させ、毎回のセッションで同じ code review の指摘を繰り返すのをやめた。
AIはコードレビューと単体テストを消滅させ、コードを書く職人技は失われ、ソフトウェアを構築する能力の方がむしろ重要になり、ターミナルとPM/デザイン/エンジニアの三人組も淘汰される。