vLLM x Novita AI:Chord、Kimi K2.x 向けのより高速な INT4 MoE。H200 で最大 1.3 倍、未調整の B300 で 2.15 倍の向上
Novita AIがChordをオープンソース化、W4A16 MoE CUDAカーネル群。公開されているHummingと比較し、層ごとの実測でH200ではレイテンシ最大1.33倍削減、未チューニングのB300では最大2.15倍削減。
日本語
コピー
概要
Novita AI は Chord をオープンソース化した。BF16 アクティベーション、INT4 重み、group-32 scale を対象とする高性能な W4A16 MoE CUDA カーネルである。Kimi K2.x の推論 shape に合わせて設計されており、indexed パスは Humming 互換の humming インポートルートを公開し、互換性のある vLLM バージョンでは --quantization humming で選択する。grouped カーネルの vLLM Humming バックエンドへの統合はまだ進行中だ。
公開版 Humming の対応パスおよびレイヤー単位で比較した実測値は次のとおり。
- H200 EP8 prefill で 1.11–1.20x、H200 TP8 単一インスタンス推論で 1.17–1.33x。
- H200 EP8 decode で 1.16–1.24x、うち down 段は 1.31x。
- B300 EP8 decode で 1.81–2.15x。比較対象は Humming のデフォルトである未チューニングの設定戦略。
- grouped パスは H200 EP8 の prefill と decode でそれぞれ 1.00–1.31x と 1.16–1.35x。同じ計測表を EP16 で測ると 1.18–1.34x、EP32 では 1.13–1.30x。
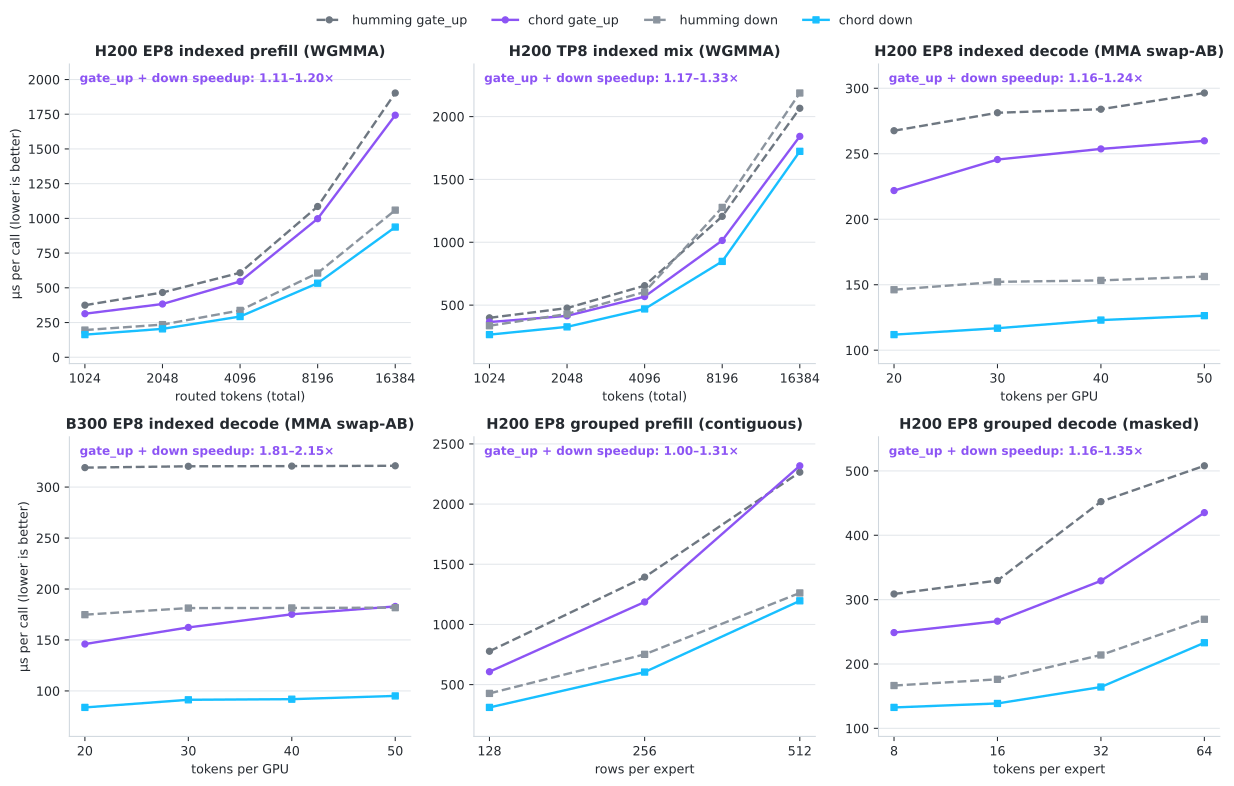
公開版 Humming と Chord の、6 つの実測推論シナリオにおける 1 回の呼び出しあたりのレイテンシ対トークン数。低いほど良い
図 1. 6 つの実測シナリオにおける 1 回の呼び出しあたりのレイテンシを公開版 Humming と比較したもの。低いほど良い。各パネルは個別に読む必要がある。B300 decode のパネルは未チューニングの Humming デフォルト設定との比較であり、公開版 Humming は SM100/SM103 のチューニング表を提供していない。一方、H200 のパネルはすべてチューニング済み同士の比較である。グラフは Chord リポジトリ から。完全な表は docs/performance.md を参照。
これらの数字の背景にある考え方はこうだ。単一の W4A16 MoE カーネルがすべてのリクエストに適合することはありえない。expert あたりのルーティングトークン数は prefill と decode の間で桁がいくつも変わり、どのスケジューリングが勝つかを決めるのは総トークン数ではなくこの量である。Chord は実際に渡された shape に応じてスケジューリングを選ぶ。
ここまでがカーネルレベルの測定結果であり、あらゆるワークロードで同じエンドツーエンドの効果が得られることを約束するものではない。完全な表、shape の定義、計測方法は docs/performance.md と docs/benchmarking.md にある。本記事のコードとカーネルの表は 7ca91d8(2026 年 9 月 14 日)に対応する。
2 つのカーネル系列
現在の main ブランチは、互いに独立した 2 つの系列を提供する。
indexedは Humming 由来のパス。vLLM のsorted_ids/expert_ids/num_tokens_paddedルーティングを消費し、H200 EP8 prefill、H200 TP8 単一インスタンス serving、H200 EP8 decode、B200/B300 EP8 decode をカバーする。grouped_contiguous(prefill)とgrouped_masked(decode)は 2 つ目の SM90 系列で、DeepGEMM から派生している。grouped routing(m_indicesまたはexpert_layout)を消費し、packed weight のレイアウトも異なる。
vLLM 統合
パッケージをインストールし、既存の Humming バックエンドを選択する:
pip install git+https://github.com/novitalabs/chord.git
# Do not co-install inclusionAI/humming: Chord intentionally owns that import name (for indexed path, grouped integration is WIP).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# or select moe_backend="humming" in the vLLM configuration
このディストリビューションは chord と humming の両方のモジュールルートを提供する。vLLM の lazy facade は humming.{dtypes,config,layer,schema,utils.weight} を解決する。後述の WNA16 group-scale サポートを備えたブランチでは、デフォルトの indexed パスがこの既存統合をそのまま使えるため、Chord 向けにフレームワークへパッチを当てる必要はない。同梱のスキーマは uint4、group-32、BF16 scales、および Kimi K2.x が使う compressed-tensors pack-quantized INT4 group-32 checkpoint 形式をサポートする。サポート外の量子化方式は読み込み時にエラーになり、誤ったカーネルを黙って選ぶことはない。
vLLM Humming バックエンドとの grouped 統合はまだ開発中。 単体の grouped operator API は次のとおり。
TP8 は引き続き indexed h200_tp8 プロファイルである。1 つの TP8 重みが両方のフェーズを処理する必要があるためだ。
その他のデプロイ上の注意:
- プロファイルの選択は、フレームワークがすでに渡してきた projection shape から EP8 か TP8 かを判断する。indexed プロファイルに Chord 固有の shard パラメータは不要。grouped プロファイルは EP のみをサポートし、SM90 では EP8/EP16/EP32 に対応する。
- trusted routing validation を無効にすると、indexed の高速パスは vLLM がオーバーアロケートした
moe_align_block_sizebuffer をそのまま消費でき、routed count を host に読み戻さないため CUDA Graph で捕捉できる。grouped パスも同様に CUDA routing tensor を使うが、valid_shape_m/expected_mは Python 側のヒューリスティックな入力である。 - Humming を明示的に選択する(
moe_backend="humming"または--quantization humming)。vLLM の自動 WNA16 優先順位では別のバックエンドが先に選ばれる可能性がある。VLLM_HUMMING_USE_F16_ACCUMとVLLM_BATCH_INVARIANTはオフのままにする。どちらのバックエンドもこれらの compute オプションを実装していない。 - デフォルトの統合では、
VLLM_HUMMING_MOE_GEMM_TYPEは indexed の挙動を保つ。#48918 の汎用 WNA16 group-scale サポートより前の vLLM ブランチでは、group-32 key を_supports_quant_schemeに追加する必要があるかもしれない。
Kernel 最適化
インデックス化 kernel
インデックス化系列は公開されている inclusionAI/humming のコミット 4351af3 に由来する。以下の負荷レンジが異なる kernel 構成を決めており、これらの構成は重みのパッキング前に選択される:
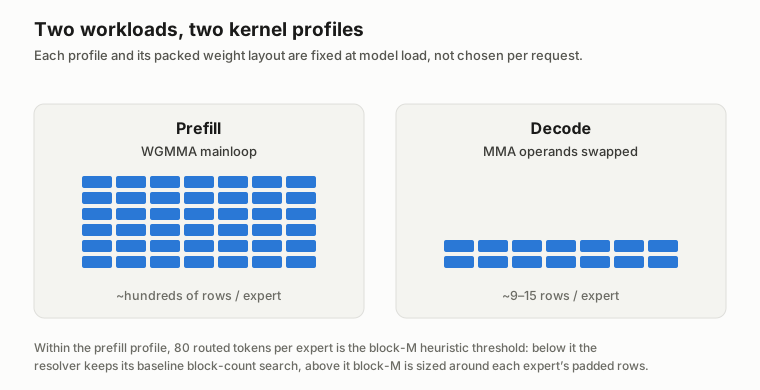
図 2. 典型的な prefill と decode の負荷。9–15 rows/expert は decode テストケースの注記であり、80 tokens/expert は prefill の block-M ヒューリスティック閾値である。どちらも prefill と decode の間の実行時切り替えを定義するものではない。構成と重みレイアウトはモデルロード時に固定され、token 数はそれぞれの構成内でスケジューリングを調整するだけである。
H200 prefill と TP8
- バッチ
waitWGMMA パイプライン。 1 つの WGMMA グループを in flight に保ったまま、次のバッチのロードと逆量子化を行う。公開されているスキャン範囲では、gate/up が約 3–6%、down が約 1–5% 向上する。出力はビット単位で一致する。仕組みは後述する。 - tokens-per-expert による block-M の選択。 インデックス化 MoE の padding とレジスタプレッシャーは、ルーティングされた総 M だけでなく、各 expert にルーティングされる token 数(
tok_e)に依存する。H200 EP8 のリゾルバはこの量をモデル化し、TP8 用には独立した、よりフラットなウィンドウを保持する。 - 有界な 2-CTAs/SM ウィンドウ。 単一 CTA がレイテンシ制約となる中規模 tile では、128 レジスタの起動上限が常駐 warp 数を増やし、
cp.asyncgather と逆量子化を隠蔽する。この戦略は実測された block-M/block-N ウィンドウ内でのみ有効で、ウィンドウ外では従来の occupancy 選択が使われる。 - 形状認識型の stream-K ゲーティング。 中程度の K を持つ down 投影では、通常の M×N グリッドが埋まった時点で stream-K を無効にし、split/reduction のオーバーヘッドを避ける。深い K の gate/up と、TP8 で投影ごとに分かれるクロスオーバーでは、有益な場合にこれを維持する。
tok_e のルールは意図的に説明しやすくしてあるが、MoE 形状にしか適用できない。各 expert にルーティングされる token 数が約 80 未満の場合、リゾルバはベースラインの block 数探索をそのまま使う。それを超えると、expert ごとの padding 後の行数とレジスタ上限を中心に block_m を決定する。TP8 がよりフラットなウィンドウを使うのは、その狭い中間次元では N tile が少なくなり、1 つの SM を埋めるのに足りないからである:
# Conceptual form of the H200 EP8 indexed prefill heuristic.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
WGMMA のメインループも非同期依存関係の管理をバッチ化している。命令グループごとに待つのではなく、1 回の warp-K イテレーション後にコミットし、1 グループを in flight に保ちながら次の共有メモリロードと INT4 逆量子化を開始する:
# Simplified steady state; prologue and stage management omitted.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # shared memory -> registers
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # one group may remain in flight
    dequantize_next_in_alternate_buffer()  # dequant + group scale
epilogue:
    wait_group<0>()
重みレジスタのダブルバッファリングにより、次のロードと逆量子化が未完了の WGMMA グループと重なる。アキュムレータは epilogue まで消費されず、最後の drain は未完了の WGMMA 操作すべてを待つ必要がある。
H200 と Blackwell の indexed decode
各 expert に数行しかルーティングされない場合、WGMMA パスは barrier 制約を受ける。decode profile は MMA オペランドを交換し、逆量子化後の重みを MMA-M オペランドに置き、m16n8k16 を使い、block-M 8 で 4 CTAs/SM をサポートする。9–15 tokens/expert では、半静的 token-tile スケジューリングが実測 186 µs、完全動的スケジューリングが 216 µs だった。先に減算してからスケールする逆量子化を nibble 抽出に融合しても、未融合時の BF16 丸め順序が保たれる。同じ MMA 命令ファミリが SM100/SM103 向けにコンパイルされる。より大きな Blackwell decode 形状では、より幅の広い非可換 MMA tile を使う。これらの token 数では tcgen05 kernel は不要である。
グループ化 SM90 kernel
グループ化バックエンドは別の kernel ファミリであり、indexed kernel の別名ではない。DeepGEMM の Hopper GEMM 基盤を W4A16 専用にし、Chord の JIT と launcher に接続する。どちらのモードも TMA、warp-specialized WGMMA、group-32 逆量子化を使うが、ルーティング方法と物理的な重みレイアウトが異なる:
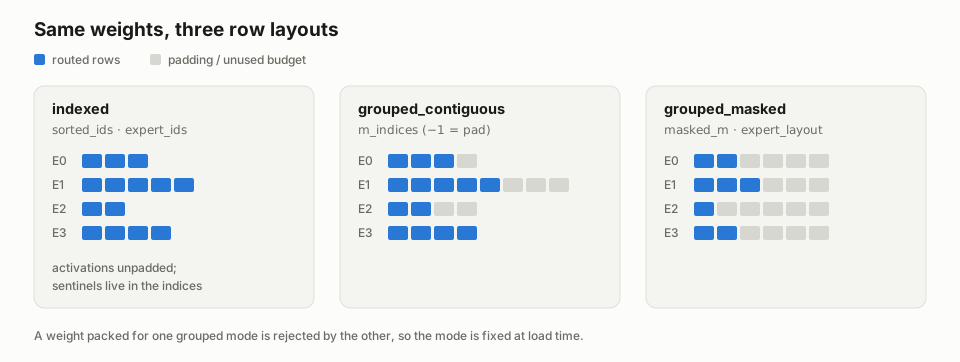
図 3. padding がどこに入るか。Indexed は活性を padding しない。ルーティングインデックスが padding センチネル値を運ぶ。Contiguous は各 expert を 128 行境界まで埋める。masked は expert ごとに固定の行バジェットを確保する。
- Contiguous prefill: 行は expert ごとに連結され、128 行境界まで埋められ、
m_indices(int32、padding 位置は-1)が付く。入力は[m, K]。packer はBLOCK_K=64付きの bit-permuted INT4 buffer を使い、scales を[G, K/32, N](N 連続)に転置する。 - Masked decode: 活性には expert ごとの固定行バジェット(
[G*max_m, K]または[G, max_m, K])があり、masked_m/expert_layoutが有効数を運ぶ。packer はBLOCK_K=128を使う。ヒューリスティックは expert ごとの予想 token 数からBLOCK_Mを選び、wave 占有率でBLOCK_Nを制約し、buffered-K の stage 深度を調整する。
グループ化演算子のエントリポイント(Chord API のみ):
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: unsigned INT4 codes [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
ここで expected_m は選択を起動するための正の Python 整数、masked_m は expert ごとの権威ある有効カウントを保持する。a3 が三次元であってもマスク出力はフラットであり、消費側は expert ごとの有効カウントを超える行を無視しなければならない。
モードは準備済みの重みに記録され、dispatch 時に検査される。したがって prefill-packed の重みを誤って decode kernel に渡すと即座にエラーになる。グループ化 dispatch は SM90 のレイアウト探索を担い、インデックス付きの block_m や tuning_config による上書きは受け付けない。Kernel の解決と cubin のロードは descriptor(および CHORD_W4A16_* のチューニング上書き)ごとにメモ化され、小規模な decode 起動で実測約 30 µs あった host 側の探索の繰り返しを排除する。
グループ化のメインループは persistent かつ warp-specialized である。producer warpgroup が TMA で activation、packed weight、scale tile を運び、consumer warpgroup が WGMMA を実行して BF16 の結果を書き出す。forward パスが見るのはすでに permute 済みの INT4 バイトと MN-major scale であり、キャッシュされた descriptor が各 (mode, M, N, K, expert_count) shape を対応する cubin にマッピングするため、decode 呼び出しのたびにレイアウト探索をやり直す必要はない。
グループ化のヒューリスティクスには、W4A16 のワークロードに特化した選択がいくつかある:
- 連続 prefill は grid が十分大きければ BM128/BK64 を使う。 BM128 は INT4 の逆量子化と scale の持ち上げをより多くの行に薄く広げ、BK64 は各 pipeline stage を十分小さくして shared memory に複数 stage を収められるようにする。小規模な連結問題は BM64 にフォールバックし、M tile が SM を埋められるようにする。BM128/BK128 は shared memory を取りすぎて pipeline が崩壊する。
- マスク decode は K と想定される routed tail から BM を決める。 1 つのマスク group が 2 つ目の M tile にあふれ、K 次元全体を読み直すことがある。深い K の gate/up では、この読み直しを避けるためヒューリスティクスが約
1.3 * expected_m行を上書きする。短い K の down ではもう一度走らせる方が安く、より簡素なceil(1.25 * expected_m, 8)tile の方が pipeline stage の余地を残せる。 - マスク BN は wave を意識する。 BN256 は逆量子化の薄め方を改善するが、N tile が十分多くマシンを埋められる場合にしか効かない。Resolver は埋まらない wave では BN128 を維持する。狭い EP32 gate/up の場合もそうだ。短い K の down 上の大きな BM も BN128 を維持する。深い K の gate/up は、tile がマシンを埋められるなら BN256 を使える。
- Buffered-K の深さは最大値ではなくレイテンシに合わせて調整する。 Decode は通常、buffered K 要素で約 512(
512 / BLOCK_Kstages)を目標にする。大きなマスク tile は約 768 を目標にし、shared memory の制約を受ける。利用可能な shared memory をすべて埋めても、barrier の回収が高くつくだけで、SM あたり 1 block の decode 起動は改善しない。
これらの規則こそ、grouped が indexed のチューニング表を再利用しない理由である。grouped バックエンドは dispatch 時に実際の mode と shape から (BM, BN, BK, cluster, stages) を選ぶ。上で引用した H200 EP8 の範囲では、prefill の優位は 512 rows/expert で縮まる。両実装が同じスループット上限に近づくためだ。tile と pipeline の選択が最も効くのは中小の chunk である。
測定
kernel 表は triton.testing.do_bench を使い、同じ GPU 上で各 Chord パスを対応する公開 Humming バックエンドと比較する。indexed の比較では同じ shape と routing のサンプリングを使い、grouped の比較では expert あたりの行数を揃える。この 2 つのスイートを実行し、純粋な PyTorch リファレンス実装で Chord の出力を検証し、対応 GPU 上でそのタイミング表を出力する:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
以下の集計は完全な表の gate/up と down の呼び出し時間を合計したものである。その加速比は Humming (gate_up + down) / Chord (gate_up + down)。routing、activation、通信は含まない。
| シナリオ | Shape 点 | Humming gate_up + down | Chord gate_up + down | Layer 加速比 |
|---|---|---|---|---|
| H200 EP8 indexed prefill | 2048 tokens | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexed mix | 8192 tokens | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexed decode | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexed decode | 20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 grouped prefill | 128 rows/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 grouped decode | 32 tokens/expert | 666.3 µs | 493.4 µs | 1.35x |
B300 の比較には限定を明示的に付けている。公開版 Humming には SM100/SM103 のチューニングテーブルがなく、デフォルトの時間は未チューニングの参考値にすぎない。H200 indexed の比率はチューニング済み同士の比較だ。
どちらの系列も同じ公開版 Humming 4351af3 に対して測定している。grouped の各行が比較しているのは Humming 自身の grouped_contiguous/grouped_masked パスであり、indexed パスではない。このバックエンドが置き換える契約がそちらだからだ。Humming は両方を GemmType の値として公開し、個別の CUDA ファイルではなく汎用カーネルのディスパッチ経由で切り替える。benchmarks/bench_humming.py では --gemm_type grouped_contiguous か --gemm_type grouped_masked で選択する。両側の expert あたり行数は 128 行のタイル境界の倍数で揃えており、Humming 側は --balanced、Chord 側は tests/test_w4a16_grouped.py でアラインされたケースを使う。したがって各行はどちらの実装にとっても同一の GEMM shape であり、padding にタイルを消費しない。
エンドツーエンドのサービング
以前のサービングレポートでは Kimi-K2.6 上で indexed TP8 パスを検証した。構成は 8×H200、TP8 + DCP8、FP8 KV cache、リクエストは ShareGPT 由来。両バックエンドは同じ --quantization humming コマンドを使っている。
| 指標 | Humming | Chord | 変化 |
|---|---|---|---|
| 平均 TTFT | 2022 ms | 1849 ms | −8.6% |
| Prefill 入力 + 出力スループット | 20,716 tok/s | 22,712 tok/s | +9.6% |
| Decode 出力スループット、batch 8 | 483 tok/s | 503 tok/s | +4.1% |
| Decode 出力スループット、batch 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| Decode 出力スループット、batch 128 | 2514 tok/s | 2715 tok/s | +8.0% |
Prefill は出力トークンを 1 つだけ生成し、prefix caching は無効にする。Decode は 2 ラウンド目で同じプロンプト群を再利用し、この時点で prefix cache は完全に温まっている。レポートはまた、OCRBench と GSM8K で Humming に対する精度の後退がないことも確認している。
次のステップ
- vLLM の Humming バックエンドとの grouped 統合を完了させる。 contiguous と masked のカーネルを既存のフレームワーク統合から使えるようにする。
- B200/B300 向け EP8 prefill カーネルを公開する。 内部テストでは動作する実装がすでにあり、性能も良好で、カーネルと benchmark を後続リリースで公開する予定だ。
Chord を試す
Chord は GitHub で公開している:novitalabs/chord。ドキュメントはクイックスタート、最適化、性能、チューニングの内部、benchmark の方法をカバーしている。issue の報告やフィードバック、他のデプロイ環境での benchmark 結果の共有を歓迎する。
謝辞
Chord の indexed パスは inclusionAI/Humming を基にしており、grouped SM90 バックエンドは DeepGEMM の Hopper GEMM 基盤を W4A16 に特化したものだ。Chord は Apache-2.0 ライセンスで公開している。リポジトリ内の出典表示に、保持している上流コンポーネントとライセンス表示を記載している。
Chord を構築しオープンソース化した Novita AI チームに感謝する。また、vLLM のメンテナと vLLM コミュニティ全体に感謝する。議論やレビュー、そして量子化と MoE バックエンドの基盤があってこそ、この統合は実現できた。