vLLM x Novita AI:Chord,为 Kimi K2.x 打造的更快 INT4 MoE。在 H200 上最高提升 1.3 倍,在未调优的 B300 上提升 2.15 倍
Novita AI 开源了 Chord,一套 W4A16 MoE CUDA 内核。与公开的 Humming 相比,逐层实测在 H200 上延迟最多降低 1.33 倍,在未调优的 B300 上最多降低 2.15 倍。
中文
复制
摘要
Novita AI 开源了 Chord,一个面向 BF16 激活、INT4 权重和 group-32 scale 的高性能 W4A16 MoE CUDA 算子。它针对 Kimi K2.x 的推理 shape 构建,其 indexed 路径暴露了与 Humming 兼容的 humming 导入根,在兼容的 vLLM 版本上通过 --quantization humming 选择。grouped 算子与 vLLM Humming 后端的集成仍在进行中。
按层对比公开版 Humming 的对应路径,实测结果如下:
- H200 EP8 prefill 上为 1.11–1.20x,H200 TP8 单实例推理为 1.17–1.33x。
- H200 EP8 decode 上为 1.16–1.24x,其中 down 阶段达到 1.31x。
- B300 EP8 decode 上为 1.81–2.15x,对比的是 Humming 默认的未调优配置策略。
- grouped 路径在 H200 EP8 的 prefill 和 decode 上分别为 1.00–1.31x 和 1.16–1.35x;同样的测试表在 EP16 上测得 1.18–1.34x,在 EP32 上测得 1.13–1.30x。
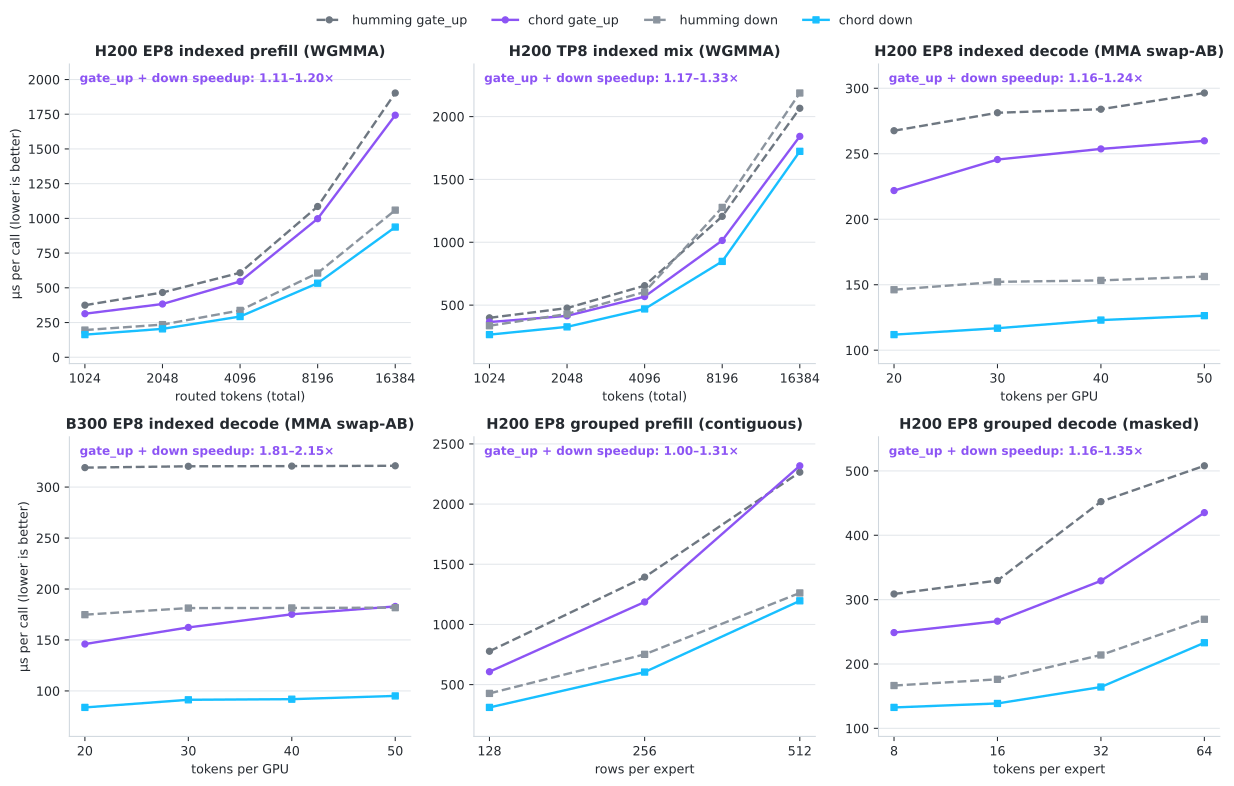
公开版 Humming 与 Chord 在六个实测推理场景下的单次调用延迟随 token 数的变化;越低越好
图 1. 六个实测场景下单次调用延迟与公开版 Humming 的对比,越低越好。每个面板需单独解读:B300 decode 面板对比的是未调优的 Humming 默认配置,因为公开版 Humming 并未提供 SM100/SM103 的调优表,而所有 H200 面板都是调优对调优。图表来自 Chord 仓库;完整表格见 docs/performance.md。
这些数字背后的思路是:单个 W4A16 MoE 算子不可能适配所有请求。每个 expert 的路由 token 数在 prefill 和 decode 之间会相差几个数量级,决定哪种调度胜出的是这个量,而不是总 token 数。Chord 根据实际拿到的 shape 来选择调度。
以上是算子层面的测量结果,并不承诺每个工作负载都能获得同样的端到端收益。完整表格、shape 定义和计时方法见 docs/performance.md 和 docs/benchmarking.md。本文中的代码和算子表格对应 7ca91d8(2026 年 9 月 14 日)。
两个 kernel 系列
当前 main 分支同时提供两个相互独立的系列:
indexed是源自 Humming 的路径。它消费 vLLM 的sorted_ids/expert_ids/num_tokens_padded路由,覆盖 H200 EP8 prefill、H200 TP8 单实例 serving、H200 EP8 decode 以及 B200/B300 EP8 decode。grouped_contiguous(prefill)和grouped_masked(decode)是第二个 SM90 系列,派生自 DeepGEMM。它们消费 grouped routing(m_indices或expert_layout),并使用不同的 packed weight 布局。
vLLM 集成
安装该包并选择已有的 Humming 后端:
pip install git+https://github.com/novitalabs/chord.git
# Do not co-install inclusionAI/humming: Chord intentionally owns that import name (for indexed path, grouped integration is WIP).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# or select moe_backend="humming" in the vLLM configuration
该发行版同时提供 chord 和 humming 两个模块根。vLLM 的 lazy facade 会解析 humming.{dtypes,config,layer,schema,utils.weight};在具备下文所述 WNA16 group-scale 支持的分支上,默认的 indexed 路径可以直接使用这套已有集成,无需针对 Chord 打框架补丁。随包提供的 schema 支持 uint4、group-32、BF16 scales,以及 Kimi K2.x 使用的 compressed-tensors pack-quantized INT4 group-32 checkpoint 格式;不支持的量化方案会在加载时报错,而不是悄悄选错 kernel。
与 vLLM Humming 后端的 grouped 集成仍在开发中。 独立的 grouped operator API 如下所示。
TP8 仍然是 indexed h200_tp8 profile,因为一份 TP8 权重必须同时服务两个阶段。
其他部署细节:
- Profile 选择会根据框架已经传入的 projection shape 判断是 EP8 还是 TP8;indexed profile 不需要 Chord 特有的 shard 参数。Grouped profile 仅支持 EP,在 SM90 上支持 EP8/EP16/EP32。
- 在关闭 trusted routing validation 时,indexed 快速路径可以直接消费 vLLM 超额分配的
moe_align_block_sizebuffer,无需把 routed count 读回 host,因此仍可被 CUDA Graph 捕获。Grouped 路径同样使用 CUDA routing tensor,而valid_shape_m/expected_m是 Python 侧的启发式输入。 - 显式选择 Humming(
moe_backend="humming"或--quantization humming);vLLM 的自动 WNA16 优先级可能先选中其他后端。保持VLLM_HUMMING_USE_F16_ACCUM和VLLM_BATCH_INVARIANT关闭,因为两个后端都没有实现这些 compute 选项。 - 默认集成下,
VLLM_HUMMING_MOE_GEMM_TYPE保持其 indexed 行为。早于 #48918 中通用 WNA16 group-scale 支持的 vLLM 分支,可能需要把 group-32 key 加入_supports_quant_scheme。
Kernel 优化
索引化 kernel
索引化系列源自公开的 inclusionAI/humming 提交 4351af3。下面的负载区间决定了不同的 kernel 配置,这些配置在权重打包之前就已选定:
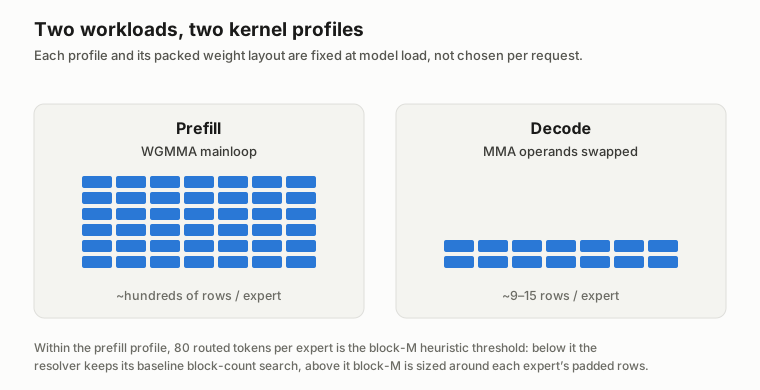
图 2. 典型的 prefill 与 decode 负载。9–15 rows/expert 标注的是一个 decode 测试用例;80 tokens/expert 是 prefill 的 block-M 启发式阈值。两者都不定义 prefill 与 decode 之间的运行时切换:配置和权重布局在模型加载时固定,token 数量只会在各自配置内调整调度。
H200 prefill 与 TP8
- 批量
waitWGMMA 流水线。 一个 WGMMA 组保持 in flight,同时进行下一批加载与反量化,在已发布的扫描范围内,gate/up 约提升 3–6%,down 约提升 1–5%。输出逐位一致;机制见下文。 - 按 tokens-per-expert 选择 block-M。 索引化 MoE 的 padding 与寄存器压力取决于每个 expert 被路由到的 token 数(
tok_e),而不只是总路由 M。H200 EP8 的解析器会对该量建模,并为 TP8 保留一组独立的、更平坦的窗口。 - 有界的 2-CTAs/SM 窗口。 对于单个 CTA 受延迟约束的中等尺寸 tile,128 寄存器的启动上限会提高常驻 warp 数,从而掩盖
cp.asyncgather 与反量化。该策略只在实测的 block-M/block-N 窗口内生效;窗口之外仍沿用原有的占用选择。 - 形状感知的 stream-K 门控。 中等 K 的 down 投影在普通 M×N 网格填满后关闭 stream-K,避免 split/reduction 开销。深 K 的 gate/up 以及 TP8 中按投影区分的交叉点则在有益时保留它。
tok_e 规则刻意做得易于解释,但只适用于 MoE 形状。每个 expert 路由到的 token 数低于约 80 时,解析器沿用基线的 block 数搜索;高于该点则围绕每个 expert 的 padding 后行数与寄存器上限来确定 block_m。TP8 使用更平坦的窗口,因为其狭窄的中间维度留下的 N tile 更少,不足以填满一个 SM:
# Conceptual form of the H200 EP8 indexed prefill heuristic.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
WGMMA 主循环同样对异步依赖管理做了批处理。它不等每一组指令,而是在一次 warp-K 迭代后提交,让一组保持 in flight,同时启动下一次共享内存加载和 INT4 反量化:
# Simplified steady state; prologue and stage management omitted.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # shared memory -> registers
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # one group may remain in flight
    dequantize_next_in_alternate_buffer()  # dequant + group scale
epilogue:
    wait_group<0>()
权重寄存器的双缓冲让下一次加载和反量化与尚未完成的 WGMMA 组重叠。累加器直到 epilogue 才被消费,最后的 drain 仍需等待所有未完成的 WGMMA 操作。
H200 与 Blackwell 的 indexed decode
当每个 expert 只有几行被路由到时,WGMMA 路径受 barrier 限制。decode profile 交换了 MMA 操作数,让反量化后的权重占据 MMA-M 操作数,使用 m16n8k16,并以 block-M 8 支持 4 CTAs/SM。在 9–15 tokens/expert 下,半静态 token-tile 调度实测 186 µs,完全动态调度为 216 µs。将先减后缩的反量化融合进 nibble 提取,保持了未融合时的 BF16 舍入顺序。同一族 MMA 指令会为 SM100/SM103 编译;更大的 Blackwell decode 形状使用更宽的非交换 MMA tile。在这些 token 数量下不需要 tcgen05 kernel。
分组 SM90 kernel
分组后端是另一族 kernel,而非 indexed kernel 的第二个名字。它把 DeepGEMM 的 Hopper GEMM 基础设施专门用于 W4A16,并接入 Chord 的 JIT 和 launcher。两种模式都使用 TMA、warp-specialized WGMMA 和 group-32 反量化,但路由方式和物理权重布局不同:
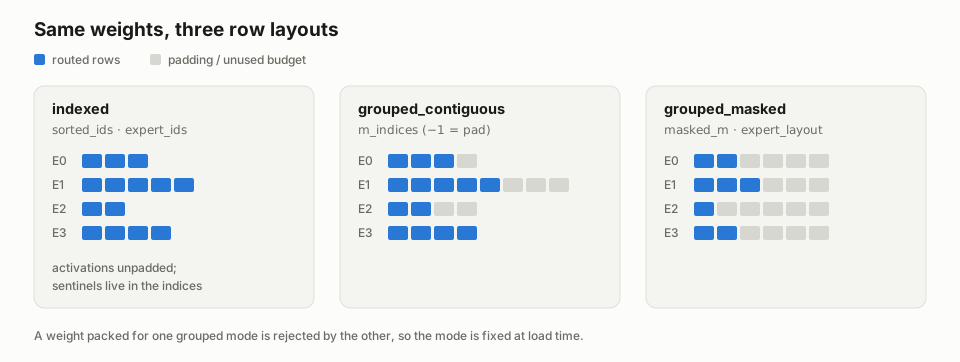
图 3. padding 在哪里。Indexed 不对激活做 padding;它的路由索引携带 padding 哨兵值。Contiguous 把每个 expert 补齐到 128 行边界;masked 为每个 expert 预留固定的行预算。
- Contiguous prefill: 行按 expert 拼接,补齐到 128 行边界,并附带
m_indices(int32,padding 处为-1)。输入为[m, K];packer 使用带BLOCK_K=64的 bit-permuted INT4 buffer,并把 scales 转置为[G, K/32, N](N 连续)。 - Masked decode: 激活有固定的每 expert 行预算(
[G*max_m, K]或[G, max_m, K]),masked_m/expert_layout携带有效数量。其 packer 使用BLOCK_K=128;启发式根据每个 expert 的预期 token 数选择BLOCK_M,用 wave 占用率约束BLOCK_N,并调整 buffered-K 的 stage 深度。
分组算子入口(仅 Chord API):
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: unsigned INT4 codes [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
其中 expected_m 是用于启动选择的正 Python 整数;masked_m 保存每个 expert 的权威有效计数。即使 a3 是三维的,掩码输出也是扁平的,消费方必须忽略超出每个 expert 有效计数的行。
模式记录在准备好的权重中,并在 dispatch 时检查,因此误把 prefill-packed 权重喂给 decode kernel 会直接报错。分组 dispatch 负责 SM90 布局搜索,不接受带索引的 block_m 或 tuning_config 覆盖。Kernel 解析和 cubin 加载按 descriptor(以及 CHORD_W4A16_* 调优覆盖)做记忆化,消除了小型 decode 启动中实测约 30 µs 的重复 host 端搜索。
分组主循环是 persistent 且 warp-specialized 的:一个 producer warpgroup 用 TMA 搬运 activation、packed weight 和 scale tile,consumer warpgroup 执行 WGMMA 并写出 BF16 结果。前向路径看到的是已经 permute 过的 INT4 字节和 MN-major scale,缓存的 descriptor 把每个 (mode, M, N, K, expert_count) shape 映射到对应 cubin,无需在每次 decode 调用时重复布局搜索。
分组启发式中有几项选择专门针对 W4A16 负载:
- 连续 prefill 在 grid 足够大时使用 BM128/BK64。 BM128 让 INT4 反量化和 scale 提升摊薄到更多行上,BK64 则让每个 pipeline stage 足够小,以便在 shared memory 中容纳多个 stage。小规模拼接问题回退到 BM64,让 M tile 仍能填满 SM;BM128/BK128 会占用过多 shared memory,导致 pipeline 崩塌。
- 掩码 decode 根据 K 和预期 routed tail 决定 BM。 一个掩码 group 可能溢出到第二个 M tile,从而重读整个 K 维度。对于深 K 的 gate/up,启发式因此覆盖约
1.3 * expected_m行以避免这次重读。对于短 K 的 down,多跑一遍更便宜,因此更精简的ceil(1.25 * expected_m, 8)tile 能给 pipeline stage 留出更多空间。 - 掩码 BN 感知 wave。 BN256 改善反量化摊薄,但只有在 N tile 足够多、机器能跑满时才有帮助。Resolver 对未填满的 wave 保留 BN128,包括窄的 EP32 gate/up 情形;短 K down 上的大 BM 也保留 BN128。深 K gate/up 在 tile 足够填满机器时仍可使用 BN256。
- Buffered-K 深度按延迟调优,而非取最大值。 Decode 通常以约 512 个 buffered K 元素为目标(
512 / BLOCK_Kstages);大掩码 tile 以约 768 为目标,受 shared memory 限制约束。填满所有可用 shared memory 只会让 barrier 回收更昂贵,而不会改善每 SM 一个 block 的 decode 启动。
这些规则正是 grouped 不复用 indexed 调优表的原因:grouped 后端在 dispatch 时根据实际的 mode 和 shape 选择 (BM, BN, BK, cluster, stages)。在上面引用的 H200 EP8 范围内,prefill 优势在 512 rows/expert 处收窄,因为两种实现都逼近同一个吞吐上限;tile 和 pipeline 的选择在中小 chunk 上影响最大。
测量
kernel 表使用 triton.testing.do_bench,在同一块 GPU 上把每条 Chord 路径与对应的公开 Humming 后端做比较。indexed 对比使用相同的 shape 和 routing 抽样;grouped 对比则匹配每个 expert 的行数。运行这两个套件,用纯 PyTorch 参考实现校验 Chord 的输出,并在受支持的 GPU 上打印它的计时表:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
下面的汇总把完整表中的 gate/up 和 down 调用时间相加。其加速比为 Humming (gate_up + down) / Chord (gate_up + down);不含 routing、activation 和通信。
| 场景 | Shape 点 | Humming gate_up + down | Chord gate_up + down | Layer 加速比 |
|---|---|---|---|---|
| H200 EP8 indexed prefill | 2048 tokens | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexed mix | 8192 tokens | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexed decode | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexed decode | 20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 grouped prefill | 128 rows/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 grouped decode | 32 tokens/expert | 666.3 µs | 493.4 µs | 1.35x |
B300 的对比特意加了限定:公开 Humming 没有 SM100/SM103 调优表,所以它的默认时间只是未调优的参考值。H200 indexed 的比值是调优对调优的比较。
两个系列都针对同一个公开 Humming 版本 4351af3 测量。grouped 各行对比的是 Humming 自己的 grouped_contiguous/grouped_masked 路径,而不是它的 indexed 路径,因为这才是该后端所替代的契约。Humming 把两者都作为 GemmType 的值暴露出来,通过它的通用 kernel 分发,而不是单独的 CUDA 文件,benchmarks/bench_humming.py 用 --gemm_type grouped_contiguous 或 --gemm_type grouped_masked 选择它们。两侧的每 expert 行数都按 128 行 tile 边界的倍数匹配——Humming 侧是 --balanced,Chord 侧是 tests/test_w4a16_grouped.py 中对齐的用例——因此每一行对两种实现都是相同的 GEMM shape,没有 tile 花在 padding 上。
端到端服务
早前一份服务报告在 Kimi-K2.6 上测试了索引化 TP8 路径,配置为 8×H200、TP8 + DCP8、FP8 KV cache,请求来自 ShareGPT。两个后端使用的是同一条 --quantization humming 命令。
| 指标 | Humming | Chord | 变化 |
|---|---|---|---|
| 平均 TTFT | 2022 ms | 1849 ms | −8.6% |
| Prefill 输入 + 输出吞吐 | 20,716 tok/s | 22,712 tok/s | +9.6% |
| Decode 输出吞吐,batch 8 | 483 tok/s | 503 tok/s | +4.1% |
| Decode 输出吞吐,batch 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| Decode 输出吞吐,batch 128 | 2514 tok/s | 2715 tok/s | +8.0% |
Prefill 只生成一个输出 token,并关闭 prefix caching。Decode 在第二轮复用同一批 prompt,此时 prefix cache 已完全预热。报告还确认,在 OCRBench 和 GSM8K 上相对 Humming 没有精度回退。
下一步
- 完成与 vLLM Humming 后端的 grouped 集成,让 contiguous 和 masked 算子可以通过现有的框架集成使用。
- 发布面向 B200/B300 的 EP8 prefill kernel。 内部测试中已有可用的实现,性能表现不错,计划在后续版本中公开 kernel 和 benchmark。
试用 Chord
Chord 已在 GitHub 上开源:novitalabs/chord。文档涵盖快速上手、优化、性能、调优内部机制和 benchmark 方法。欢迎反馈问题、提交 issue,也欢迎在其他部署环境中分享 benchmark 结果。
致谢
Chord 的索引化路径基于 inclusionAI/Humming,grouped SM90 后端则将 DeepGEMM 的 Hopper GEMM 基础设施特化到 W4A16。Chord 以 Apache-2.0 许可发布。仓库中的来源说明记录了保留的上游组件与声明。
感谢 Novita AI 团队构建并开源 Chord,也感谢 vLLM 维护者和更广泛的 vLLM 社区——相关的讨论、review,以及量化和 MoE 后端基础设施,让这次集成成为可能。