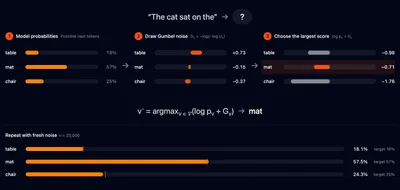
vLLM中的水印技术
文本水印要在输出分布、鲁棒性与检测成本之间权衡。vLLM 这篇讲了红绿列表、Gumbel 噪声采样等几类方案,以及它们各自在什么条件下会被破坏。
文本水印要在输出分布、鲁棒性与检测成本之间权衡。vLLM 这篇讲了红绿列表、Gumbel 噪声采样等几类方案,以及它们各自在什么条件下会被破坏。
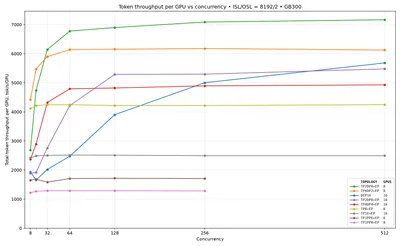
在 GB300 NVL72 上跑 Qwen3.8-2.4T 的 PD 分离部署:高吞吐场景每 GPU 达到 5,000 总 token,低延迟场景每用户 180 个生成 token,两端落在同一条帕累托前沿上。
vLLM 集成 PyNvVideoCodec 硬件解码,视频描述吞吐量在 8 块 GPU 节点上仍可线性扩展。
Novita AI 开源了 Chord,一套 W4A16 MoE CUDA 内核。与公开的 Humming 相比,逐层实测在 H200 上延迟最多降低 1.33 倍,在未调优的 B300 上最多降低 2.15 倍。
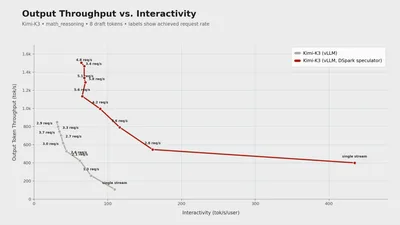
vLLM 把 Speculators 训练库扩展到支持 2.8 万亿参数的 Kimi K3:用 4 位量化的目标模型配一个五层、50 亿参数的 DSpark 草稿模型,数学推理单流交互性从约 110 提到约 435 tok/s/user,并发下相同交互性时输出吞吐最高约 3.5 倍,首 token 中位数只涨 100 毫秒。