我们如何用 GB300 NVL72 训出 Kimi-K3 最快的 DSpark
vLLM 把 Speculators 训练库扩展到支持 2.8 万亿参数的 Kimi K3:用 4 位量化的目标模型配一个五层、50 亿参数的 DSpark 草稿模型,数学推理单流交互性从约 110 提到约 435 tok/s/user,并发下相同交互性时输出吞吐最高约 3.5 倍,首 token 中位数只涨 100 毫秒。
中文
复制
今年六月,DeepSeek 发布了 DSpark,它是 DFlash 块级投机解码算法的扩展。这个新算法承诺更强的 token 间连贯性,因而有更好的接受长度。但对开源社区来说,真正的问题永远是同一个:你能训它、打包它、部署它,而不需要一个博士生盯着 checkpoint 吗?
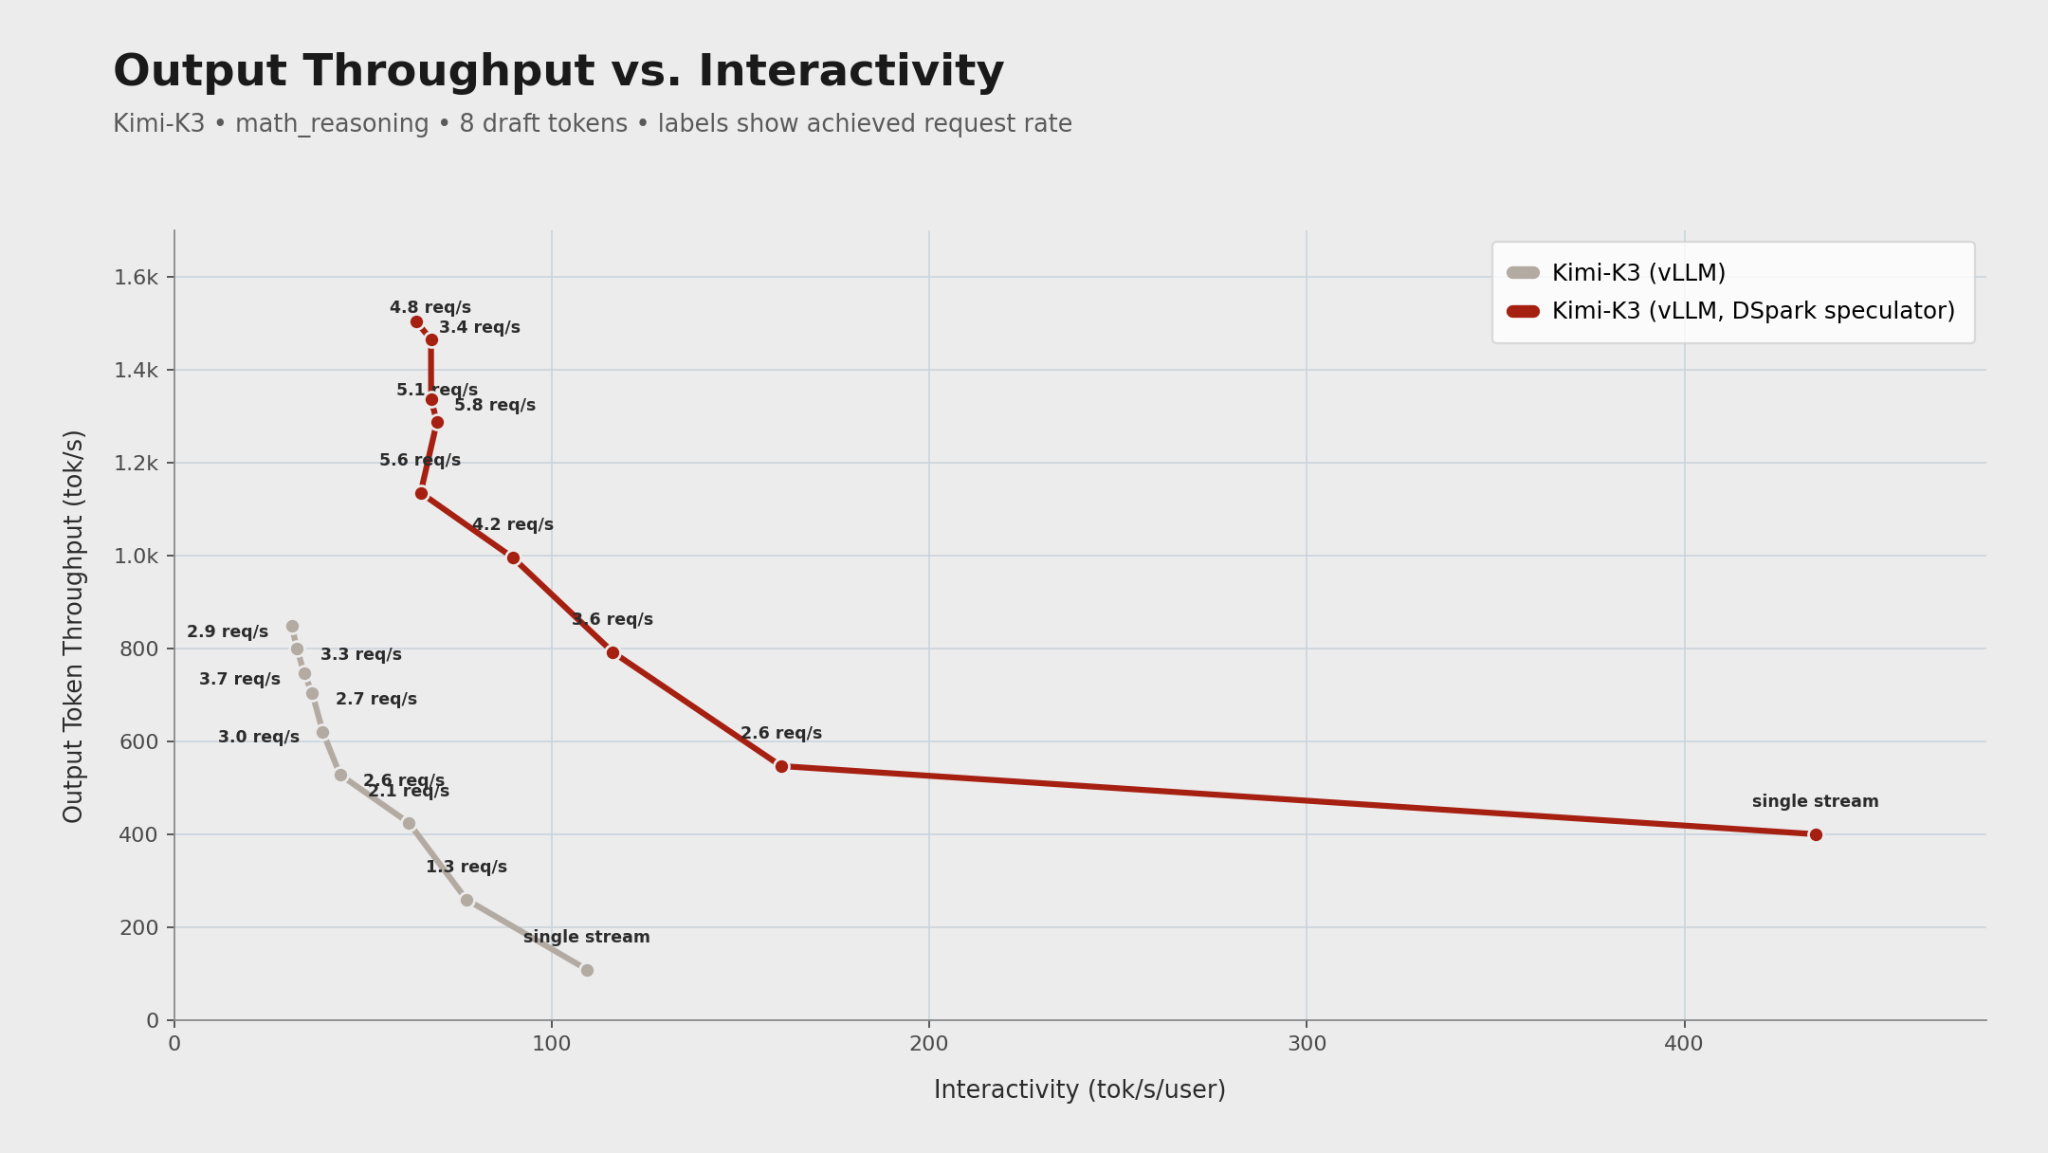
多亏 vLLM 项目的 Speculators 训练库,答案是响亮的「能」。有了 Speculators,用标准的、Hugging Face 兼容的格式训练、打包和部署 DSpark 草稿模型变得很容易,vLLM 能直接加载。这套实现已经在 Qwen3.6-35B-A3B、Gemma-4-31B-it、GLM-5.2 等模型上验证过。本文讲我们如何把训练库扩展到支持 Kimi K3,一个 2.8 万亿参数的前沿模型。我们新的 DSpark 投机器把数学推理上的单流交互性从约 110 tok/s/user 提到约 435 tok/s/user,同时在并发负载下、在相同交互性水平上带来最高约 3.5 倍的输出吞吐。
Kimi K3 在有和没有 DSpark 投机器时的输出吞吐与交互性对比
图 1. Kimi K3 的 DSpark 投机器在数学推理负载上同时提高了单流交互性和总体输出吞吐。
DSpark 是什么
大语言模型每做一次前向传播生成一个 token。投机解码加速这个过程的方式,是让一个轻量的草稿模型提出若干 token,再由完整的目标模型一起验证。
EAGLE-3 是一个很强的基线,但它仍然是自回归地起草:提出七个 token 需要七次串行的起草步骤。DFlash 则用一次非因果的骨干前向传播预测整个块,报告的最高加速比 EAGLE-3 高 2.5 倍。
代价是并行位置之间无法互相作为条件。对于「Thank you!」这样一个提示,模型可能在第一个位置同时倾向于「Of」和「No」,在下一个位置同时倾向于「course」和「problem」,于是产出「Of problem」这样的错配。因为验证会在第一个被拒绝的 token 处停止,一次错误还会让剩下的后缀一并作废,这个问题在 DSpark 论文里被称为_后缀衰减_(suffix decay)。
DSpark 保留了 DFlash 的并行骨干,同时加了两个轻量组件:
- 马尔可夫 logit 偏置头按顺序采样 token,并用上一个被选中的 token 调整每个位置的 logits。它的低秩转移矩阵恢复了重要的局部依赖,而不需要再做一次 transformer 前向传播。
- 置信度头估计每个 token 会被接受的概率。一个感知硬件的调度器用这些估计,在轻负载时验证更长的前缀,在系统繁忙时裁掉不太可能的后缀。
因此 DSpark 通过继承单次骨干前向传播保住了并行起草的主要优势,同时找回了自回归生成的一部分连贯性。在多个 Qwen3 目标模型上,它报告的接受序列比 DFlash 长 16–18%,比 EAGLE-3 长 27–31%。在 DeepSeek-V4 的生产服务中,它在相同吞吐下把每用户生成速度比之前的 MTP-1 基线提高了 60–85%。
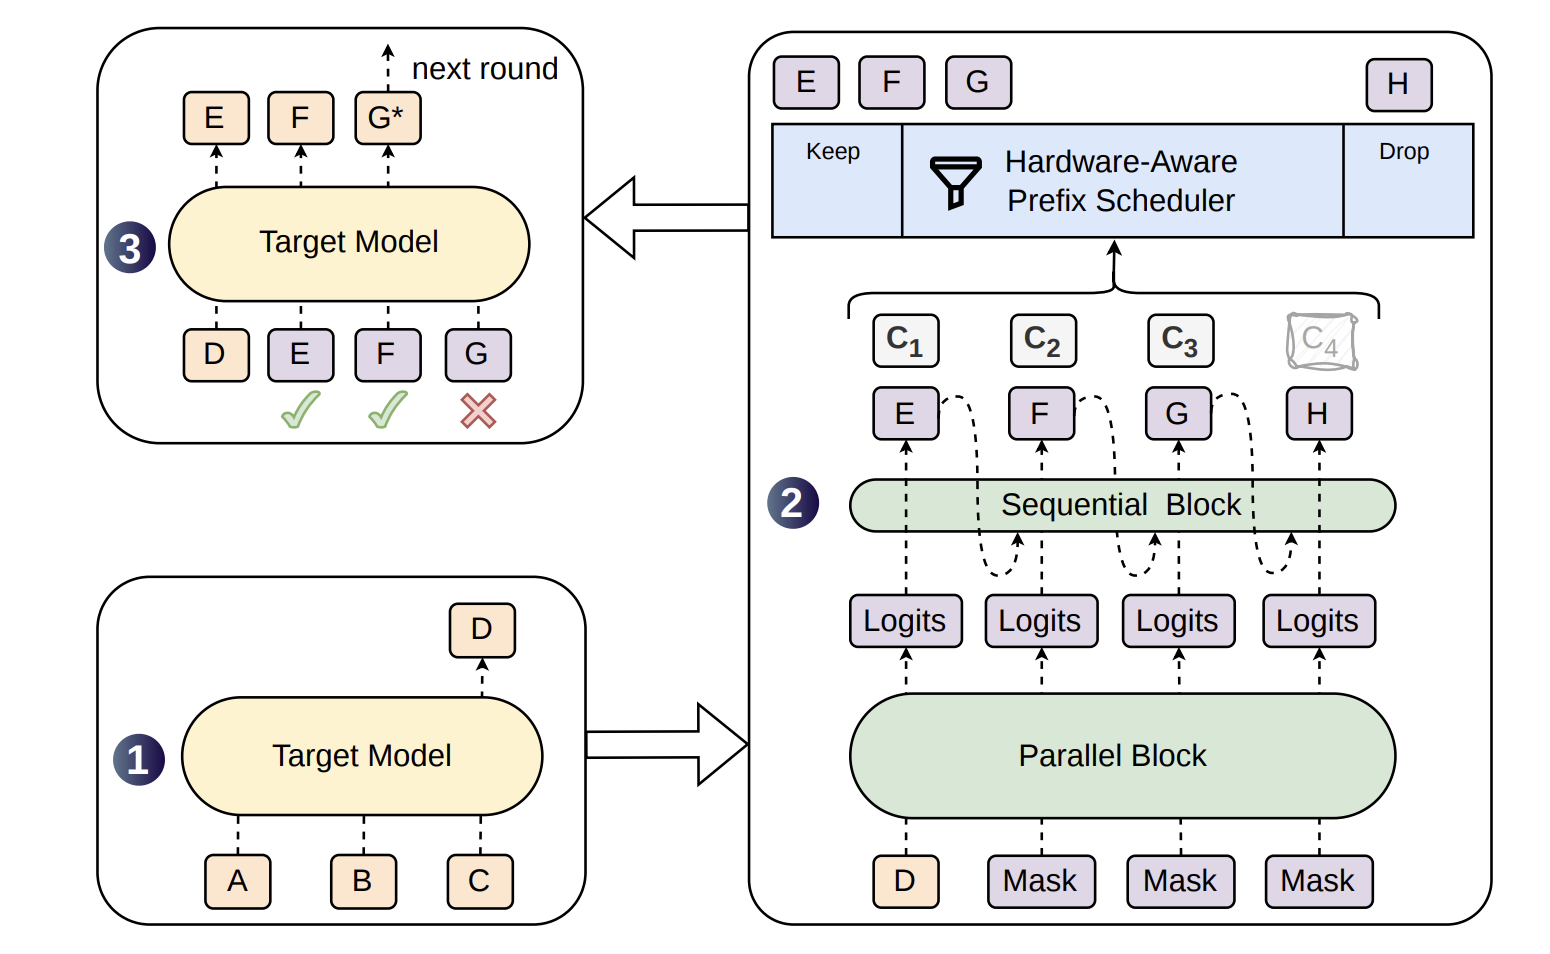
DSpark 架构:并行起草、顺序校正、置信度打分与感知硬件的验证
图 2. DSpark 在目标模型验证之前,把并行块与顺序校正、感知硬件的缀调度结合在一起。
推理时的表现
只有在额外的串行工作仍然远低于再做一次草稿模型前向传播的成本时,DSpark 的半自回归设计才能改善推理。已发布的 Kimi K3 DSpark 投机器使用一个五层、50 亿参数的草稿模型,每个解码步骤提出八个 token。
在九个评测领域上,它达到每轮验证 4.11 个 token 的宏平均接受长度。结构化任务上的表现最强:数学推理 6.42 个 token,HumanEval 4.96,翻译 4.65。加速在请求数较少时尤其明显。
这个模型对长上下文提示效果特别好。在 LongBench-v2 这样一个有难度的领域数据集上,我们的 Kimi K3 DSpark 在 378K token 的提示上达到每次解码迭代最多 5.31 个输出 token。即使在更宽泛的负载上,前 10% 的请求也达到每次迭代至少 3.76 个 token,这说明在真正很长的上下文长度下,深度投机运行仍然可行。
随着同时到达的请求变多,它也能有效扩展。把并发从 1 提到 16,总体输出吞吐从每秒 177 个 token 提到 683 个。
关键在于,负载下响应的启动仍然很快。尽管同时服务的请求数是原来的 16 倍,首 token 时间的中位数只增加了 100 毫秒,从 379 毫秒到 479 毫秒。
部署很简单。按你的硬件和用例,照官方的 vLLM recipe 做就行:
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e GLOO_SOCKET_IFNAME=$IFACE_NAME \
  -e NCCL_SOCKET_IFNAME=$IFACE_NAME \
  -e VLLM_ALLREDUCE_USE_FLASHINFER=1 \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest moonshotai/Kimi-K3 \
  --trust-remote-code \
  --gpu-memory-utilization 0.95 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr $HEAD_IP \
  --load-format fastsafetensors \
  --no-enable-flashinfer-autotune \
  --max-model-len 1048576 \
  --kv-cache-dtype fp8 \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --enable-prefix-caching \
  --attention-backend TOKENSPEED_MLA \
  --prefix-match-unit 128 \
  --reasoning-parser kimi_k3 \
  --language-model-only \
  --speculative-config '{"model":"RedHatAI/Kimi-K3-speculator.dspark", "num_speculative_tokens":8, "method":"dspark", "draft_sample_method":"probabilistic", "rejection_sample_method":"block"}'
硬件配置
这个模型是在 Verda 慷慨提供的一台 GB300 机架上训练的。Verda 是一家欧洲 AI 云,从数据中心到托管服务都自己拥有整套技术栈,并且 100% 使用可再生能源。Verda 是欧洲最早部署 GB300 NVL72 机架的供应商之一。它内部的 AI Lab 也在同一批机架上做推理研究。
这台 GB300 机架保持 NVIDIA 参考设计,裸金属运行、不做虚拟化,操作系统是 Ubuntu 24.04.4 LTS,跑在 NVIDIA 的 64K 页内核 6.14 上。
Verda 把优化精力放在最重要的系统级配置选择上,让研究者能用上前沿级别的环境。这套系统使用 NVIDIA 的 610.57.04 开源内核 GPU 驱动(R610)。CUDA 13.4.0 开发者预览版与 CUDA 13.1 和 12.9 一起安装,NCCL 2.31.2 在系统范围内可用。
选择 CUDA 13.4.0 是因为它新的 Blackwell 编程特性,也因为它是第一个包含 Rubin 支持的工具链(sm_107)。这有助于确保今天在 GB300 上编写和 profiling 的代码,可以面向下一代硬件构建而不出意外的兼容性问题。基于硬件计数器的 GPU profiling 也在不需要 root 权限的情况下可用,让每位研究者都能对训练和推理负载做 profiling。
我们一直在与 Verda 合作,帮助开源的训练和推理基础设施扩展到最新的 GPU 架构,目前重点是从 GB300 到 VR200 的机架级系统。看到这次合作的成果逐渐成形,我们很感激。
大规模提取隐藏状态
投机解码的草稿模型尽管体量小却如此有力,部分原因是它们常常把目标模型的隐藏状态作为输入,用来指导自己的预测。这大大改善了它们的工作上下文,让草稿模型有可能把自己的预测与目标模型紧密对齐。
但有个前提:训练这些草稿模型需要一个由隐藏状态输入和目标模型对数概率输出组成的数据集。所幸 vLLM 有一套隐藏状态提取系统,可以按需为数据集样本取得目标模型的内部隐藏状态。这套系统使用一个假的草稿模型,复用 vLLM 的草稿模型管线来接收目标隐藏状态,并把它们插入一个假注意力层的 KV cache。从那里,一个实现 KVConnector 接口的类可以把隐藏状态取出来并传出 vLLM。目前 vLLM 自带一个 ExampleHiddenStatesConnector 就是做这件事的,它把隐藏状态异步写到磁盘。
这套系统对单节点的「vLLM + 训练」配置效果很好。比如,节点上一半的 GPU 可以专门用于训练,另一半在 vLLM 里服务目标模型并按需提取隐藏状态。这套系统在 Speculators 和 vLLM 里已经得到好几个月的良好支持。但对于 Kimi K3 这样一个 2.8 万亿参数的模型,即使模型权重做了 4 位量化,最先进的加速器也开始撞上显存上限。我们需要一套能扩展到单节点训练之外、并支持训练与隐藏状态提取分离的系统。
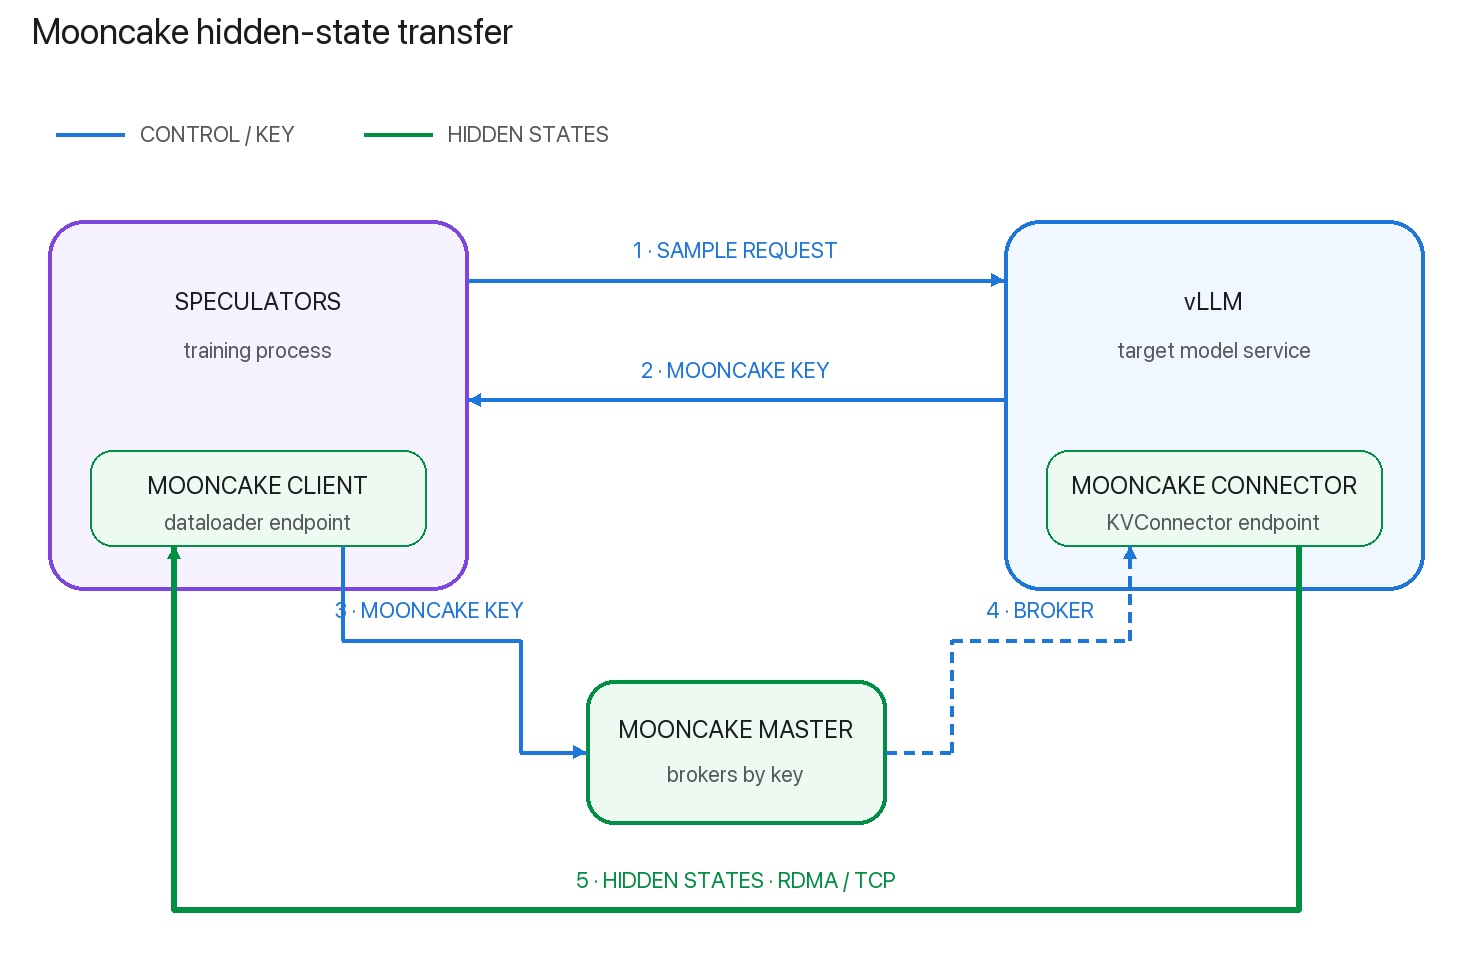
Speculators 训练进程与 vLLM 推理进程之间的 Mooncake 隐藏状态传输
图 3. Mooncake 连接器把控制路径与隐藏状态数据路径分开,用 RDMA 或 TCP 在 vLLM 与 Speculators 的 dataloader 之间传输。
带着这些需求,我们做了 MooncakeHiddenStatesConnector,它用 Mooncake 传输引擎作为后端,在进程之间、跨节点地流式传输隐藏状态。这套新系统用一个 master Mooncake 代理进程来管理与 vLLM 和训练实例之间的通信,后者把自己注册为客户端。设置好之后,训练进程可以向 vLLM 前端发请求,并收到一个 Mooncake store key 作为响应。这个 key 随后被交给 Mooncake master,由它促成一次从 vLLM 引擎到 Speculators dataloader 的传输。这一切都自动发生,由 Mooncake 服务端管理,并且视配置而定,使用高速 RDMA 传输或普通 TCP,在同一个节点或不同节点的进程之间发送数据。
训练 Kimi K3 DSpark
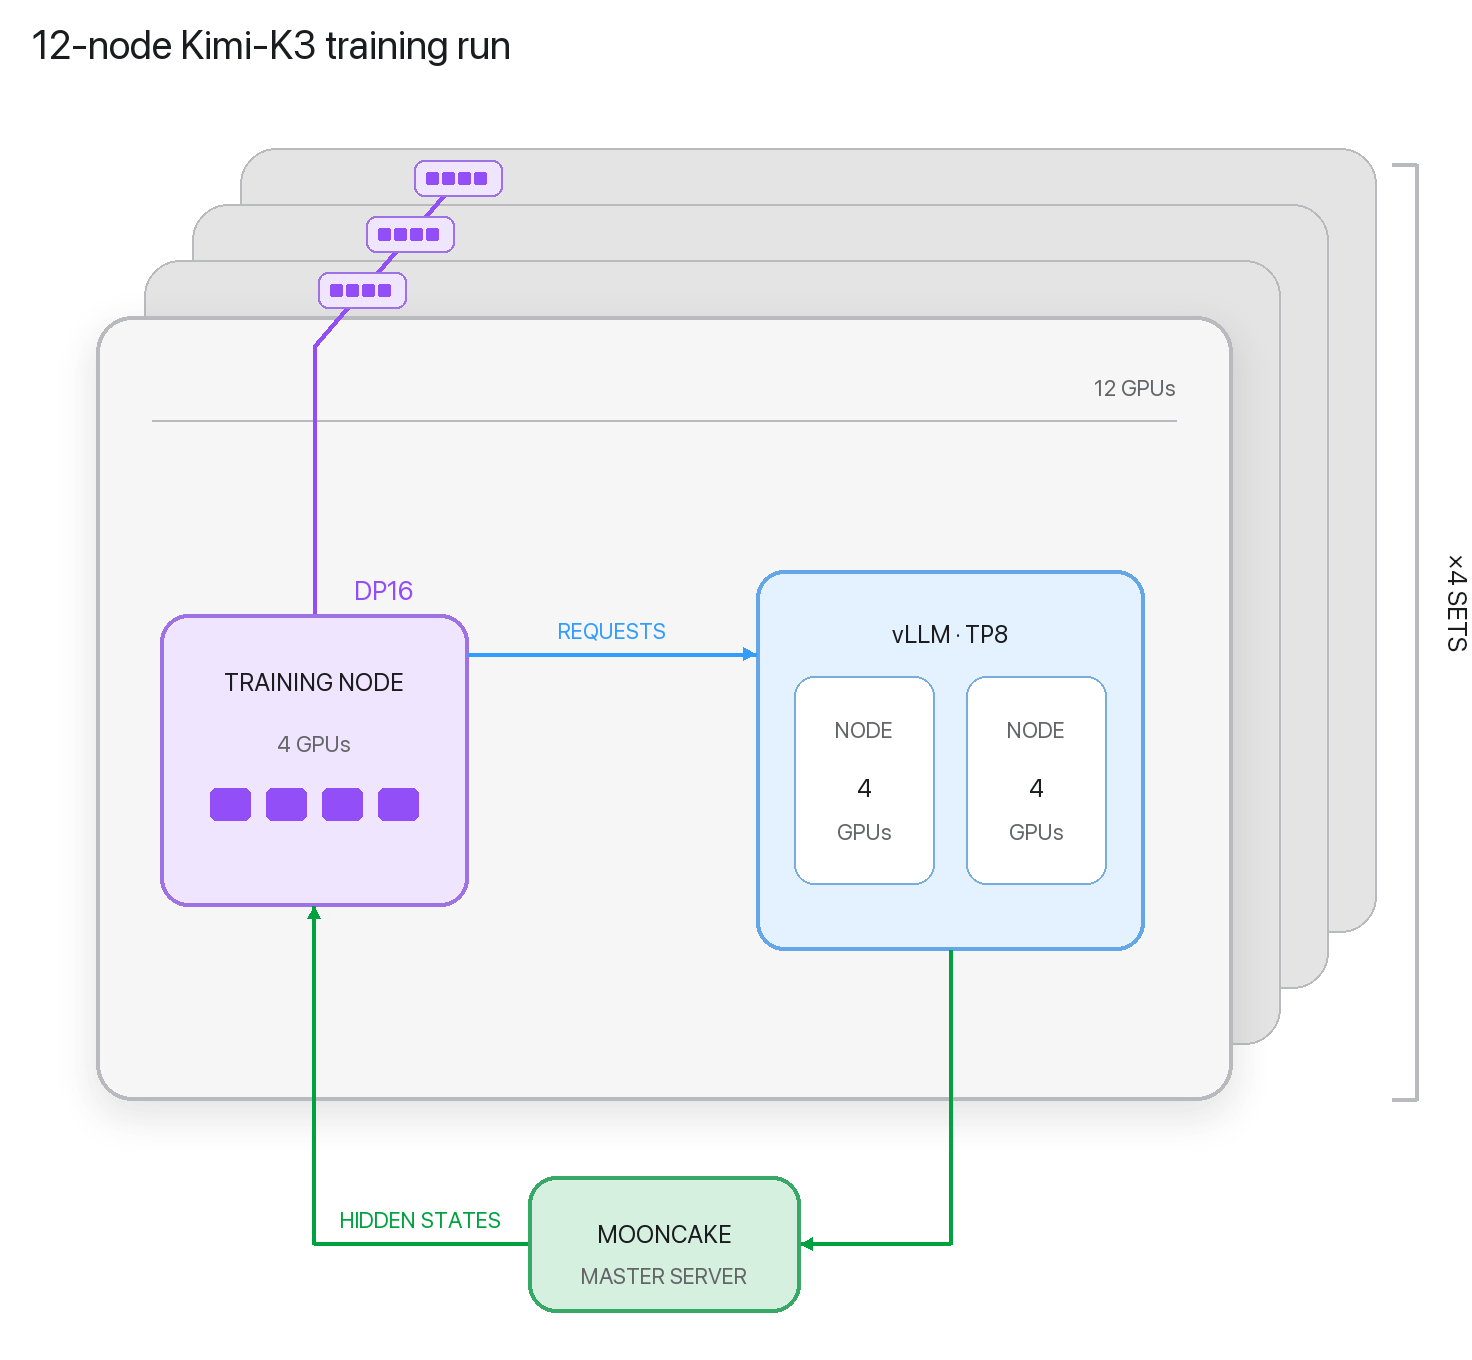
十二节点的 Kimi K3 DSpark 训练拓扑:分离的 vLLM 推理与 Mooncake 传输
图 4. 每四个节点为一组,其中一个四 GPU 节点专门用于训练,两个四 GPU 节点用于 vLLM 推理,隐藏状态由 Mooncake 传输。
有了新的 MooncakeHiddenStatesConnector,我们现在就有了一套能扩展到大模型、多节点训练的系统。即使 Kimi K3 量化到 4 位,这个模型仍然需要至少两个 GB300 节点(每个四块 GPU)来服务。我们试了不同的训练与 vLLM 配置,发现三个节点为一组(两个做推理、一个做训练)能提供最好的吞吐。用 Mooncake 连接器的 Speculators 还有一个好处:想把任意一个组件单独扩上去或缩下来以取得最佳性能,都很容易。
结论
Speculators 是一个开源库,用来构建、训练、评测和分享投机解码模型,它们能直接与 vLLM 这类推理引擎集成。无论你是在训练一个新的草稿模型、探索 DFlash、DSpark 或 DFlash2 这样的算法,还是在改善生产环境的推理性能,我们都欢迎你的想法和贡献。加入 vLLM 社区 Slack,在 #speculators 和 #feat-spec-decode 里找到我们,提问、分享结果、讨论新算法,与社区协作。对代码、文档、示例、模型支持和评测工具的贡献都欢迎。