大语言模型可证明推理的进展
Anthropic 的 FlashProve 为每个响应附加一个 zkSNARK,使从未见过权重的用户也能验证是哪个模型生成了这些 token,在单块 H100 上,一个 400B 模型的速度约为每秒 110 个 token。
更多 推理
首页Anthropic 的 FlashProve 为每个响应附加一个 zkSNARK,使从未见过权重的用户也能验证是哪个模型生成了这些 token,在单块 H100 上,一个 400B 模型的速度约为每秒 110 个 token。
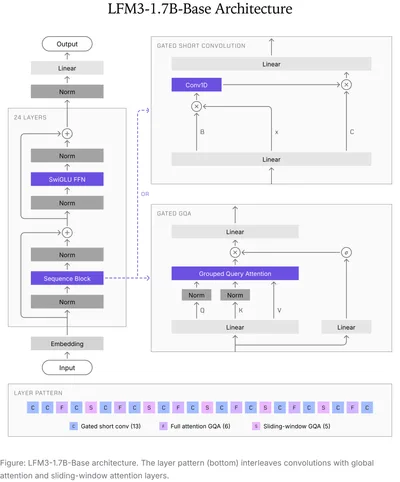
LFM3-1.7B 在 22T token 上预训练,24 层里 13 层是门控短卷积、5 层滑窗注意力、6 层全局注意力,4-bit 量化后约 1 GB,128K 上下文的 KV cache 只要 1.6 GB。同门还有视觉、音频、全模态和两个决策模型。
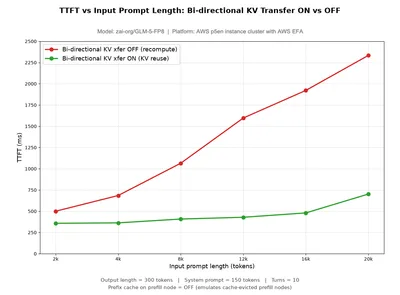
双向 KV 传输让 vLLM 的 prefill 节点在后续对话轮次里复用 decode 节点先前算好的 KV,省掉重复的 prefill 重算,长多轮提示下 TTFT 最多降低 3.3 倍。
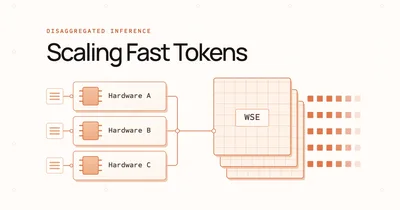
Cerebras 把 prefill 与 decode 拆到不同硬件上:算术强度不同、调度目标也不同,分开后同样的硬件量下吞吐提升 5 倍、生成速度不降。文章从矩阵乘法讲到 KV 传输与异构分离的选型。
Google 这套多智能体框架把长视频生成当成全局优化问题,在数分钟的叙事里保持人物与场景的连贯,而不是逐段生成再拼接。
Modal 与 CMU 的团队把查询规划器和推理引擎合到同一张 GPU 上,让 AI-SQL 跑到每分钟十亿 token;文章讲了现成推理引擎在这类负载上为什么会浪费算力。
Modal 的工程团队拆解如何为万亿参数的编程 agent 服务数万亿 token:从推理基础设施、token 缓存到调度与批处理,逐层讲清支撑这一规模的做法。
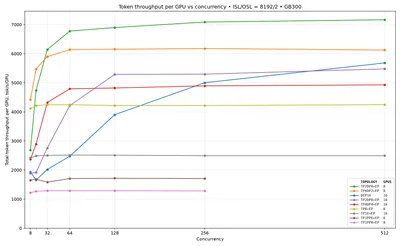
在 GB300 NVL72 上跑 Qwen3.8-2.4T 的 PD 分离部署:高吞吐场景每 GPU 达到 5,000 总 token,低延迟场景每用户 180 个生成 token,两端落在同一条帕累托前沿上。
vLLM 集成 PyNvVideoCodec 硬件解码,视频描述吞吐量在 8 块 GPU 节点上仍可线性扩展。
Gemini 3.8 Live 与 Extended Thinking 发布,语音交互支持复杂推理、实时视觉与后台任务而不打断对话。
Novita AI 开源了 Chord,一套 W4A16 MoE CUDA 内核。与公开的 Humming 相比,逐层实测在 H200 上延迟最多降低 1.33 倍,在未调优的 B300 上最多降低 2.15 倍。
作者认为 Jev 的价值可能主要在推理策略而非模型本身。把回复预填成 choice 字段、再只生成一个受约束的 token,任何 LLM 都能拿到大部分「秘密配方」,他用 Qwen2.5-1.5B 试出了 2 到 3 倍加速。
Google Research 提出 Retrieve-for-Train,用强化学习训练轻量级扩散模型,绕过推理期思考预算,单次前向即可生成连贯的 fan-out 搜索结果。
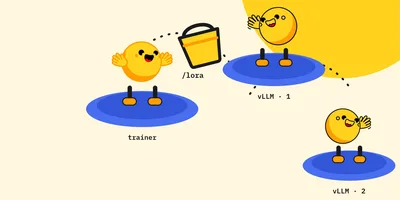
AsyncGRPOTrainer 只训练并同步 rank-1 LoRA adapter,跨 HF Jobs 走 Storage Bucket 而不是 NCCL,500 步训练从 3 小时 27 分压到 53 分。
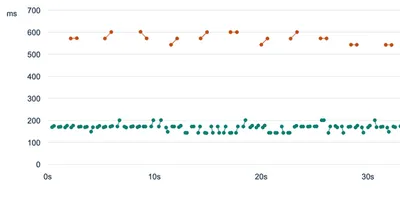
作者把 Qwen3-8B 接成 System One 分类器后试出两招:分层目标(每十秒定战略、每五秒定战术、每 200 毫秒执行)与锦标赛采样(一次喂一百个链接分两轮选),后者在 Wikiracing 里找到了理想的三链接路径。
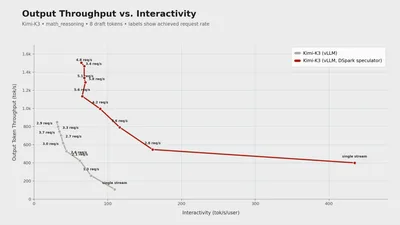
vLLM 把 Speculators 训练库扩展到支持 2.8 万亿参数的 Kimi K3:用 4 位量化的目标模型配一个五层、50 亿参数的 DSpark 草稿模型,数学推理单流交互性从约 110 提到约 435 tok/s/user,并发下相同交互性时输出吞吐最高约 3.5 倍,首 token 中位数只涨 100 毫秒。
IBM Research 给智能体的「一致性」做诊断:GPT-4.1 的 ReAct 智能体在 AppWorld 上平均 77.4% 通过,但五次全过的任务只有 53.0%,差 24.4 个百分点。他们用一次采样找出容易翻盘的决策点、生成一致性准则,把差距砍到 12.0 个点,平均准确率不降。
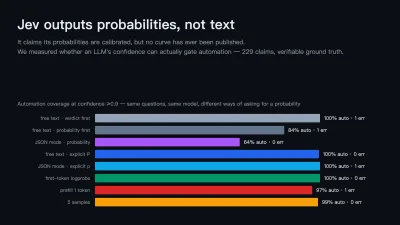
TypeSafe AI 的 Jev 把模型输出从字符串换成带概率的类型化判断,还声称概率是「校准」过的。这个前提没有人给过证据,于是我们拿 229 条有确定答案的声明,量了普通 LLM 的置信度到底能不能用来做自动化。