在HF Jobs上使用LoRA进行异步GRPO:一个存储桶、一个代理,无需NCCL
AsyncGRPOTrainer 只训练并同步 rank-1 LoRA adapter,跨 HF Jobs 走 Storage Bucket 而不是 NCCL,500 步训练从 3 小时 27 分压到 53 分。
中文
复制
TL;DR
AsyncGRPOTrainer现在可以训练 LoRA 适配器,并只把该适配器同步到 vLLM(TRL v1.14)。- rank-1 适配器只有几 MB,因此可以通过挂载到每个 Job 的 Storage Bucket 传输,而不必走 NCCL。训练器和 vLLM 副本作为独立的 Hugging Face Jobs 运行在不同的机器上。
- 副本前面放一个小代理,负责加上认证头、把每个 rollout 路由到已经持有其 KV 前缀的那个副本,并把适配器加载广播到所有副本。
- AsyncGRPO 指标能看出瓶颈在哪。同一套配方跑 500 步,五次运行把耗时从 3 小时 27 分压到 53 分。
LoRA 支持最近通过 PR #7017 进入 TRL 的 AsyncGRPOTrainer,随 TRL v1.14 发布。异步训练器现在可以训练适配器而不是完整模型,并且只把 LoRA 适配器同步到 vLLM。本文介绍一个建立在其之上的真实项目,其中训练和推理不再共用一台机器。
LoRA 训练尤其适合 RL,Thinking Machines 的博客 LoRA Without Regret 已经说明了这一点。他们表明,在策略梯度 RL 中 LoRA 可以追平全量微调,即便 rank 为 1 也是如此。原因在于优势函数每个 episode 只给出 ~O(1) 比特的信息,从总信息量的角度看,每一步能学到的东西并不多。rank-1 适配器的容量足以吸收这些信息。
LoRA 训练还带来一个系统层面的结果。1.5B 模型的 rank-1 适配器只有几 MB,而完整模型约 3 GB。与其在每次更新后把完整的策略发给推理 worker,我们只需发送适配器。vLLM 还能同时加载多个适配器。旧的 rollout 用它开始时的策略跑完,新的 rollout 则使用最新的策略。
TRL 的 AsyncGRPOTrainer 已经把训练和生成分开。训练器和 vLLM 可以跑在不同的机器上,各自按自己的速度运行。在单节点或集群环境中,两个进程共享文件系统或能组成 NCCL 组,这很容易做到。
我们想用 Hugging Face Jobs 跑同一套配置。一个 HF Job 本质上就是一台 VM 上跑一个容器,所以单个 Job 无法拉起多个节点(至少目前还不行)来同时容纳一个 trainer 和一组 vLLM 服务器(单节点最多也就 8xH200)。AsyncGRPOTrainer 正是为这种规模而设计的,于是问题就变成了:如果不再要求 trainer 和推理服务器共处一个节点,我们能走多远?
如果做全权重同步,答案是“走不远”。每次更新都要在机器之间搬运几个 GB 的数据,这在密集集群里正是 NCCL 的用武之地,但 Job 之间无法跨节点通信。既没有共享本地磁盘,显然也没有共享的 localhost。用 LoRA 的话,一次同步只有几 MB。文件系统这块,HF Jobs 提供了由 Storage Buckets 支撑的卷,这些 bucket 可以挂载到每个 Job 上作为 FUSE 文件系统,足以充当节点间的共享 FS。Job 之间完全不需要网络通路。
最终的配置相当精简:
- 一个 trainer Job,用 LoRA(以及 FSDP,后面再细说)跑
AsyncGRPOTrainer, - 两个 vLLM Job,各自服务基础模型加上 trainer 最近发布的 adapter,
- 一个 Storage Bucket,以相同路径挂载到这三个 Job 上,adapter 就是这样从 trainer 传到服务器的,
- 一个 代理服务器。为什么需要它,我们会展开讲,但大致上,我们需要一个代理,把每次 rollout 路由到最可能持有其 KV cache 的那个副本,并把每次 adapter 更新广播给所有 vLLM 副本。
架构:借助 Hugging Face Jobs 和 Storage Buckets 🪣
AsyncGRPOTrainer 中新增的仅同步 adapter 的路径是这样工作的:trainer 不向 vLLM 发送张量。每隔几个优化器 step,它就把 adapter 保存到 <output_dir>/.vllm_lora/trl-policy-v{N} 下,用原子重命名发布该目录,然后把路径发给 vLLM 的 /v1/load_lora_adapter 端点。vLLM 从磁盘加载文件,rollout worker 随后就可以请求 model="trl-policy-v{N}"。
vLLM 的运行时适配器加载机制本就如此。接口接收的是路径而非张量,因此训练器与服务器必须共享同一文件系统。在 Slurm 集群上,这个文件系统就是网络文件系统。在 Jobs 上,我们通过将 Storage Bucket 挂载为每个 Job 中同一路径下的卷来实现同样的效果,前文已提及。底层使用的是 hf-mount,它将 bucket 以 POSIX 文件系统的形式暴露在容器内:
# every Job gets the same bucket at the same absolute path
hf jobs run ... -v hf://buckets/aminediroHF/asyncgrpo-lora-buckets:/lora ...
TRL 和 vLLM 均无需为此做任何改动。训练器写入 /lora/<run>/.vllm_lora/,各服务器从同一路径读取。POST 请求中发送的路径在每个容器内均已有效。
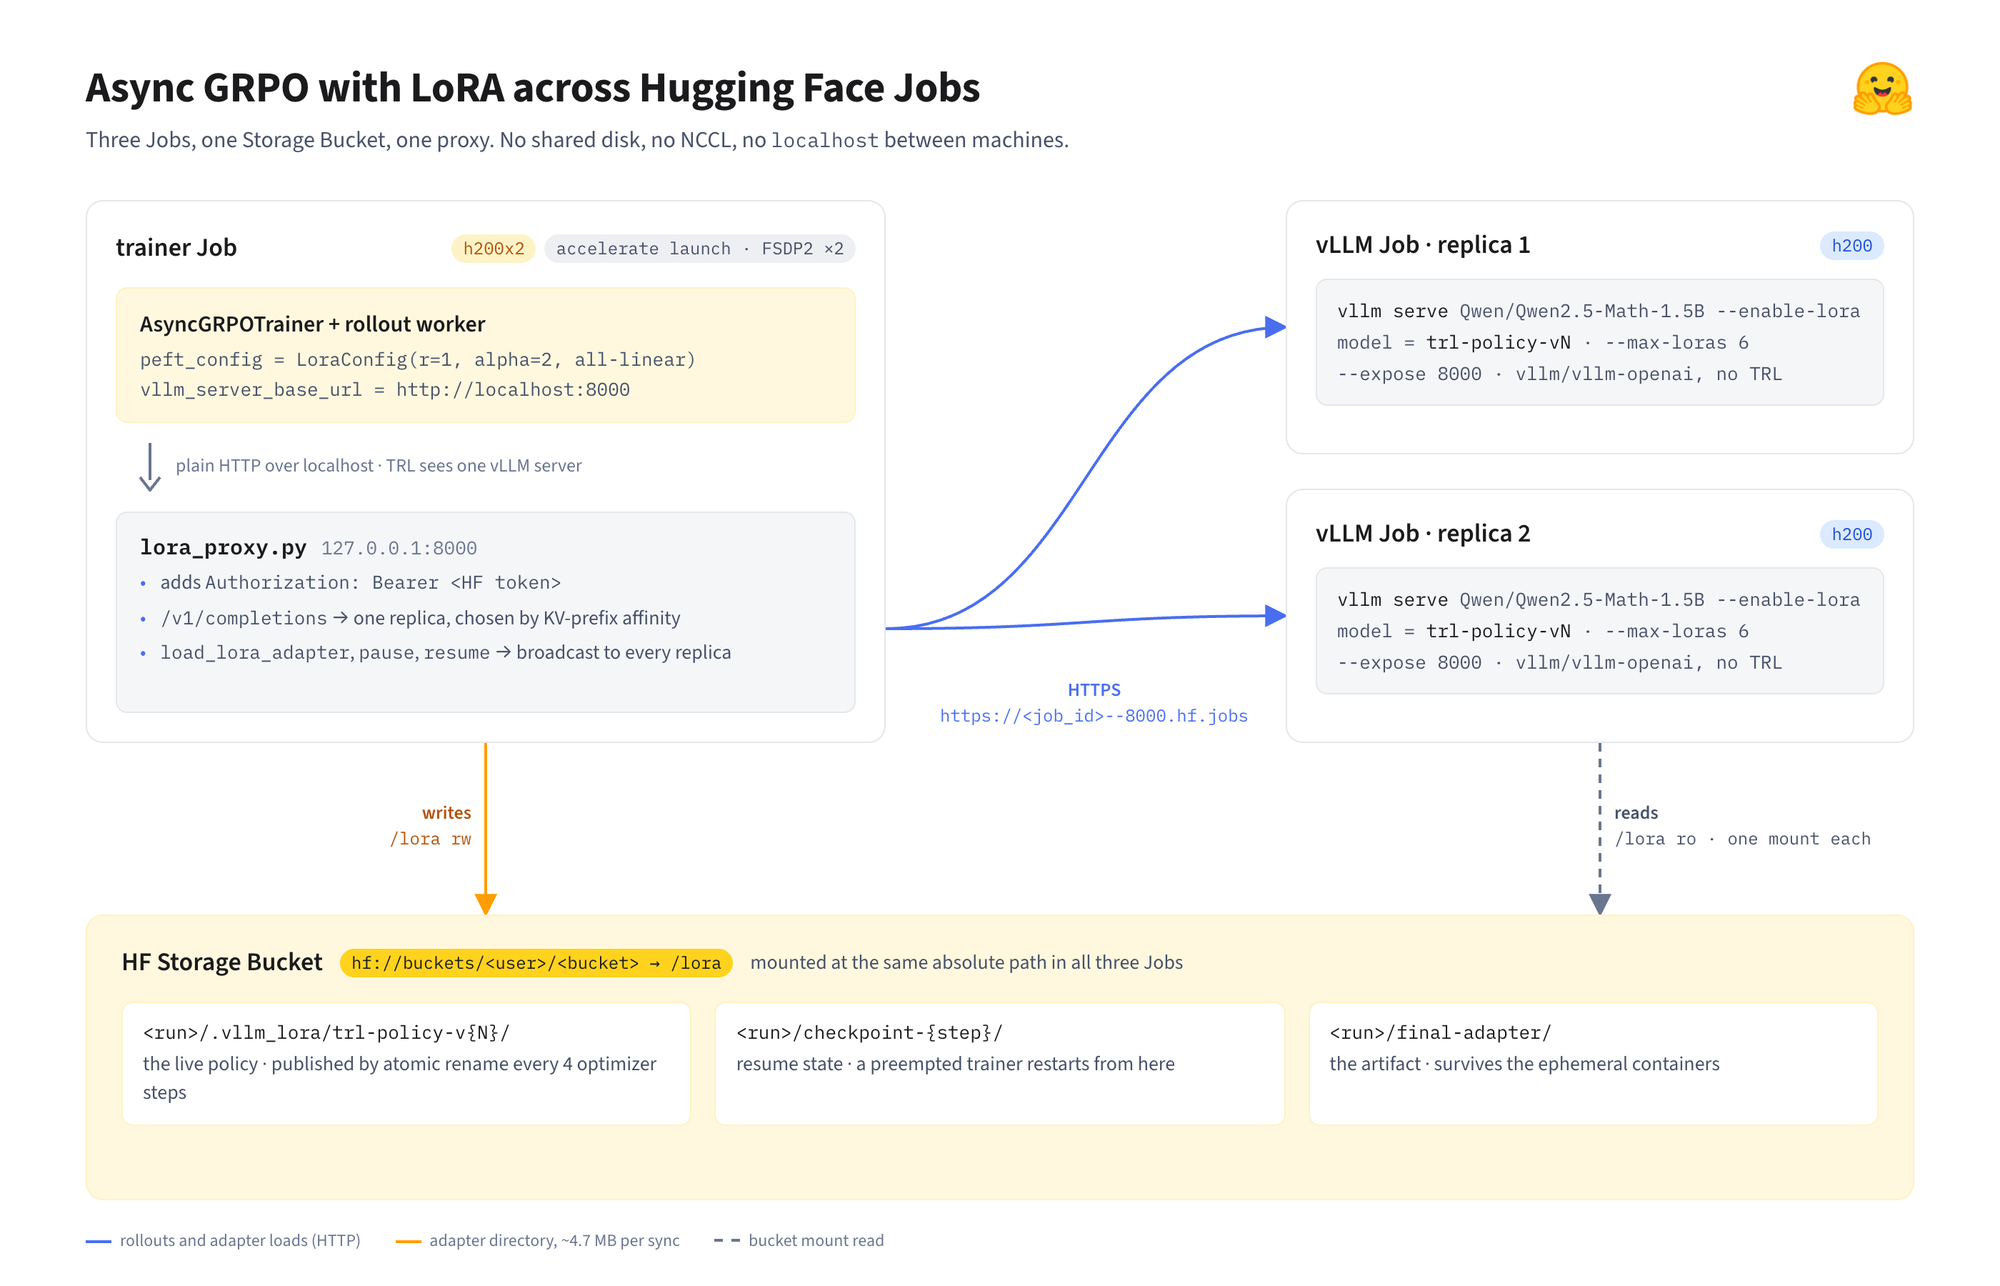
三个 Job 和 bucket。TRL 通过 localhost 与代理通信,代理通过 HTTPS 与副本通信,适配器目录则经由 bucket 挂载传递。
注意,checkpoint 和最终适配器同样存放在 bucket 中。HF Jobs 是临时的,但被抢占的训练器可以恢复训练,因为最终适配器始终会持久化到 bucket,不会随 Job 停止而丢失。
三个 Job
vLLM 副本
每个副本使用一块 GPU 和原版 vllm/vllm-openai 镜像。我们只需启用运行时 LoRA 加载,并预留足够的适配器槽位。
适配器槽位数量由 max_staleness 决定。在 AsyncGRPOTrainer 中,每次权重同步都会将策略版本加一,而 max_staleness 表示一个 rollout 样本最多可以落后当前策略多少个版本,超过则会被训练器丢弃。当 max_staleness=4 时,在 trl-policy-v3 下生成的样本在训练器处于 v7 时仍会被用于训练。一个在 v3 下开始的 rollout 也必须能在 v3 下完成。因此,vLLM 在任何时刻都必须同时服务当前策略以及之前的四个版本。这正是训练器保持注册 max_staleness + 1 个适配器版本、并卸载更旧版本的原因。每次同步都会先加载新版本再卸载最旧的版本,这需要在交换期间多出一个槽位。于是得到 --max-loras 6。如果只有五个,vLLM 会在每次同步时悄悄驱逐一个仍有 rollout 在途的策略。
# --expose 8000                       reachable at https://<job_id>--8000.hf.jobs
# -v ...:/lora:ro                     read-only: the server only reads adapters
# VLLM_ALLOW_RUNTIME_LORA_UPDATING=1  enables /v1/load_lora_adapter
# VLLM_SERVER_DEV_MODE=1              enables /pause, /resume, /server_info (TRL needs all three)
# --max-loras 6                       max_staleness=4 -> 4+2 adapter slots
for replica in 1 2; do
hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN \
    --expose 8000 \
    -v "hf://buckets/${BUCKET}:/lora:ro" \
    -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 \
    -e VLLM_SERVER_DEV_MODE=1 \
    -- vllm/vllm-openai:v0.27.1 \
    vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000 \
        --max-model-len 4096 --logprobs-mode processed_logprobs --generation-config vllm \
        --enable-lora --max-lora-rank 1 --max-loras 6
done
我们把 vLLM 固定在 v0.27.1。vLLM 迭代很快,上面这些 flag 和运行时 LoRA 接口都是该版本提供的,所以要把版本号当作方案的一部分。
还有一种可能的设计:训练器只保留最新的 adapter,并始终用同一个名字发布。我们没有这么做,因为 vLLM 的前缀缓存是按 adapter 名字索引的。如果只有一个名字,换权重之前算出的 KV block 在换完之后仍然会命中,prefill 不会重算,于是一次 rollout 的前缀可能来自上一个策略版本,decode 却来自下一个。训练器根本看不出来,只会表现为 ratio 逐渐偏离 1。带版本号的名字让这种情况不可能发生:一个名字永远对应一组权重,缓存的前缀不可能匹配到更新的版本。
数据集的选择:Sanity set
我们选了 sail/Sanity-Test-R1D-1.5B,也就是 Defeating the Training-Inference Mismatch via FP16(Qi 等,2025)用的数据集。复现代码在 sail-sg/Precision-RL。
作者用 DeepSeek-R1-Distill-Qwen-1.5B 为每道 MATH 题生成 40 个答案,保留成功率在 20% 到 80% 之间的题目,最终得到 1,460 道题。这个数据集非常适合做 RL 验证:对这些题,该模型既不是已经会做,也不是完全没戏,因此模型能在早期拿到不错的训练信号并持续提升。
作为端到端测试,它也很理想:如果某个 vLLM 副本悄悄用 adapter 的名字提供 base model,我们希望几十步之内就能从曲线上看出来。而且这个数据集足够小,不到两小时就能跑完一轮。
超参数同样取自论文在 oat/scripts/lora 里的 LoRA 脚本:Qwen/Qwen2.5-Math-1.5B,LoRA rank 1、alpha 2,学习率 4e-5,每个 prompt 8 个样本,每步 128 个 completion,最多生成 3,000 个 token,上下文 4,096 token。
训练器
训练器用的是同一个 vllm/vllm-openai:v0.27.1 镜像,在上面装了 TRL。我们当时跑的是 PR 分支;同样的代码现在已经进入 TRL v1.14。训练脚本就是一个普通的 AsyncGRPOTrainer 脚本,唯一与 Job 相关的值是输出目录和服务器 URL。
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",       # on the bucket: adapters, checkpoints and the final adapter all land here
    vllm_server_base_url="http://localhost:8000",   # the proxy, not a vLLM Job; TRL never sees the Jobs URLs
    max_staleness=4,
    weight_sync_steps=4,                     # publish an adapter every 4 optimizer steps
    save_strategy="steps", save_steps=50,    # checkpoints go to the same bucket -> resume after preemption
    ...
)
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen2.5-Math-1.5B",
    args=config,
    peft_config=LoraConfig(r=1, lora_alpha=2, target_modules="all-linear"),  # plain LoRA vLLM can serve as-is
    ...
)代理
接下来才是有意思的部分。我们需要在训练器和 vLLM Jobs 之间放一个代理,原因有两个:
-
暴露的 Job 端口要求每个请求都带上
Authorization: Bearer <HF token>头。代理正是添加这个头的地方,这样 TRL 就无需知道它的存在。 -
我们希望让不止一块 GPU 参与生成。在单个 vLLM 服务器上,通常的做法是
--data-parallel-size > 1,但 TRL 在这种模式下拒绝仅适配器同步,理由也很充分:调用/v1/load_lora_adapter只会到达响应它的那个 DP rank,其他 rank 会继续以新的策略名提供基础模型。而在 Jobs 上,这个问题根本不存在,因为每个副本都是独立的机器。因此,数据并行必须上移一层,放到能把适配器加载分发到每个副本的组件里。
于是我们在训练器 Job 的 127.0.0.1:8000 上跑一个小代理,让 TRL 指向它,就像指向单个 vLLM 服务器一样。除了添加请求头,代理在功能上还做两件事:
- 把每个补全请求发往一个副本,选择的标准是让一个 prompt 的八次 rollout 落在其前缀已被缓存的地方(细节见下文)。
- 把每个改变状态的请求,例如适配器加载、暂停和恢复,广播到所有副本,这样同一个策略名在哪里都指同一件事。
按 KV 前缀路由 rollout
简单回顾一下为什么这很重要。生成一次补全分为两个阶段,工作负载特征差别很大:
- prefill 一次性处理整个 prompt,为每个 prompt token 计算注意力的 key 和 value。
- decode 阶段随后一次生成一个 token,每个新 token 都要关注它之前所有 token 的 key 和 value。
这些 key 和 value 就是 KV cache。由于注意力是因果的,一个 token 的 KV 只取决于它之前的 token,与之后的内容无关。因此,共享前缀的两个请求共享该前缀的 KV,而缓存中已有该前缀副本的副本可以完全跳过这部分 prefill。现在要做的就是找到那个副本,让请求落在已经见过其前缀的副本上,从而从中受益。
vLLM 把前缀 KV cache按每 16 个 token 一块存储。由于 GRPO,rollout worker 会发出 G 个使用相同 prompt 的请求(在我们的场景中是 G=8 个)。如果它们都落到同一个副本上,第一个请求会完成 prefill,后面七个直接复用。换成轮询路由,一半请求会打到没有缓存该前缀的副本上,这四个请求就得重做 prefill,白白浪费宝贵的 GPU 算力。
我们的 router 要做的事,就是记录哪个副本见过哪个块哈希。有个细节很重要:哈希是链式的,所以第 3 块的哈希代表的是第 1、2、3 块,而不只是第 3 块。这与因果注意力一致:只有当第 1、2 块也相同时,第 3 块的 KV 才有效。我们还把 adapter 名字作为链的种子,因为 KV cache 也取决于生成它的 adapter:为 policy v3 缓存的前缀,对 policy v4 毫无用处!
两个 prompt、四个请求、两个副本上的路由决策:16-token 块、链式哈希、公共前缀、一次亲和命中、一次溢出。
视频完整演示了选择副本的整个决策过程。下面的步骤用一个真实的 135-token 补全请求作为例子(来自 Sanity 数据集的问题):
1. 把 prompt 切成块。 router 收到 token id 后,按每 16 个 token 一块切开,和 vLLM 一样。它只对完整的块做哈希,所以最后 7 个 token 在这里被忽略。
2. 对前缀做哈希。 每个块都和前一个哈希一起计算,起点是 adapter 种子。因此 h3 按顺序标识第 1、2、3 块。前 k 块相同的两个 prompt,哈希会一直相同到 hk。一旦某一块变了,它之后的每个哈希都会变。这就是我们用 adapter 名字给哈希做种子的原因:同一个 prompt 在 trl-policy-v4 下会从另一个种子开始,无法匹配 v3 的条目。这正是我们想要的,因为旧的 KV 块是用不同的权重算出来的。
3. 比较两个 prompt。 问题 1 有 103 个 token。两个 prompt 都以相同的 23-token 聊天模板开头。它们的第一个块完全相同,但第二个块已经包含了问题文本。哈希从那里开始不同。
4. 记录归属。 对于每个哈希,路由器会记住哪些副本处理过它,以及它后面跟着哪些哈希(后继集合上限为两个,因为我们只需要知道一个块后面有一个还是多个延续)。经过几个 prompt 之后,模板块 h1 同时归属于两个副本,并且已经有多个后继;h2 到 h8 只归属于 A,且各自只有一个后继;h2' 到 h6' 只归属于 B。
实际上,一次运行中的每个 prompt 都以相同的 token 开头。在这里,就是聊天模板和系统提示词,它们构成了全部 1,460 个问题的前 23 个 token。在 agent 场景中,这会是工具描述;在多轮环境中,这会是共享的对话历史。这些块在几秒内就会进入每个副本的缓存,所以靠它们匹配无法判断某个 prompt 究竟在哪里。
如果一个块每个副本都处理过,或者它有多个后继,它就是公共块。路由时会忽略公共块,因为它们无法标识某个特定的 prompt。下面会详细讲!
5. 选择一个副本。 路由器统计每个副本上有多少个开头块匹配,并去掉公共前缀。剩下的就是该 prompt 特有的块数量。然后:
- 如果某个副本有特有块,且它没有被压垮——也就是它领先负载最低的副本不超过 8 个请求——请求就发给它。我们称之为 affinity 命中。
- 如果某个副本有特有块,但领先超过 8 个请求,我们就放弃缓存,把请求发给负载最低的副本。我们称之为 spill。
- 如果没有任何副本有特有块,这就是一个新 prompt。它发给负载最低的副本,并列时轮询。我们称之为 unmatched。
下面是四条请求依次套用该规则的过程。初始状态:副本 A 和 B 各有 3 条请求在途,两边都只认得模板块 h1。
- 请求 1,problem 0,rollout 1。 两个副本都只匹配到一个块,也就是模板,而这个块是公共的。所以没有任何专属块匹配上。请求未被匹配,两个副本负载相同,轮询把它发给 A。路由器记录
h2到h8归 A 所有。A 现在有 4 条请求在途。 - 请求 2,problem 0,rollout 2。 同样的 prompt。A 匹配全部 8 个块,B 只匹配模板。去掉那一个公共块后,A 有 7 个专属块,B 一个也没有。A 只比 B 多 1 条请求,远在 8 的上限之内,所以请求发给 A。这是一次亲和性命中:A 的 KV cache 里已经有整个 prompt。
- 请求 3,problem 1,rollout 1。 新的 prompt。两个副本都只匹配模板块,没有专属块匹配。请求未被匹配,发给负载较低的副本 B——B 有 3 条在途,A 有 5 条。路由器记录
h2'到h6'归 B 所有。 - 请求 4,problem 0,rollout 9。 假设此时 A 已有 12 条请求在途,而 B 回到 3 条。A 仍然持有那 7 个专属块,但它现在比 B 多 9 条请求,超过上限。请求溢出到 B。B 为 problem 0 做一次 prefill,路由器记录
h2到h8同样归 B 所有。至此每个副本都服务过这些块,problem 0 也变成公共块,它后续的 rollout 只按负载分配。
6. 复用 prefill。 请求 2 就是做这一切的理由。它复用了请求 1 算出的 prefill:块 1 到 8 已经在 A 的 KV cache 里,A 直接跳到解码 completion。如果发给 B,B 会把 135 个 token 全部重新 prefill 一遍,而 A 的 cache 闲置不用。请求 3 说明为什么需要 common 这条规则。没有它,共享的 chat template 会让每个新 prompt 看起来都像缓存命中。请求 4 则把负载控制在有界范围内。省下一次 prefill,不值得让某个副本远远落后。
def choose(self, upstreams, model, prompt):
    hashes = self.block_hashes(model, prompt)         # chained blake2b over 16-token blocks, seeded with `model`
    matched = self.matched_prefix(hashes)             # per replica: leading blocks it has served
    common = self.common_prefix_len(hashes)           # leading blocks that identify no prompt (see below)
    specific = [max(0, m - common) for m in matched]  # what actually distinguishes replicas
    least = min(u.inflight for u in upstreams)
    best = max(range(self.n), key=lambda i: (specific[i], -upstreams[i].inflight))

    if specific[best] > 0 and upstreams[best].inflight - least <= self.cfg.imbalance:
        pick = best                                   # affinity: the replica that has this prompt, and is not swamped
    else:
        candidates = [i for i in range(self.n) if upstreams[i].inflight == least]
        pick = candidates[self.rr % len(candidates)]  # spill or new prompt: least-loaded, round robin on ties
        self.rr += 1
    ...record `pick` as an owner of every block, and each block's successor...
    return upstreams[pick]
common 前缀是最棘手的部分。每个请求都以相同的 system prompt 和 chat template 开头。如果只做简单的 longest-prefix match,第一个 replica 几乎会对所有新 prompt 都命中。我们改用 fan-out 来识别共享前缀:一个 block 有多个不同的后继很常见,而总是通向同一个后继的 block 则属于某个特定 prompt。只有共享前缀之后的 block 才算作 affinity。
广播 adapter
proxy 还需要把 adapter 的加载广播到每个 replica。我们把这一操作视为 all-or-nothing。每个 replica 有自己的 bucket mount,所以它们不一定会在同一时刻看到新 adapter。No adapter found for <path> 错误通常意味着某个 bucket mount 还没跟上,我们只重试那个 replica。对于其他错误,我们会从已经接受该 adapter 的 replica 上把它卸载,这样就不会出现某个 policy 名称只存在于部分 replica 上的情况。
async def load_one(u):
    while True:
        status, _, out = await send(u, "POST", "/v1/load_lora_adapter", headers, body)
        if status == 200 or "No adapter found" not in out.decode() or time.monotonic() > deadline:
            return u, status, out
        await asyncio.sleep(cfg.lora_retry_s)          # this replica's mount has not seen the directory yet

results = await asyncio.gather(*(load_one(u) for u in ups))
if any(st != 200 for _, st, _ in results):
    await asyncio.gather(*(send(u, "POST", "/v1/unload_lora_adapter", headers, unload) for u, st, _ in results if st == 200))
    return web.Response(status=504 if timed_out else st, text="rolled back on the others")
我们也用同样的方式广播 /pause、/resume 和 /v1/unload_lora_adapter。/health 只有在每个 replica 都健康时才返回 200。/server_info 和 /v1/models 只需要一个应答。从 TRL 的角度看,proxy 就是一个 data_parallel_size=1 server,所以它选择 adapter-only sync。
我们一开始担心用 Python asyncio 写的 proxy 会成为瓶颈。并不会(至少在这个规模下)。同时在途的非流式 JSON 请求最多 128 个,而路由只计算几个哈希。一个线程就能轻松处理。如果要做更精细的路由器来应对更大的流量,大概得用更快的语言来写(我们看到你了 🦀)。
完整运行结果
下面的数字来自 trainer 在 trackio 上的 logged metrics。这次运行使用 Qwen/Qwen2.5-Math-1.5B、在 all-linear 上的 LoRA r=1,每步 128 个 completion,每个 prompt 8 个 rollout。运行 500 步,每 50 步保存一次 checkpoint。trainer 使用一个 h200x2 Job,两个 vLLM replica 各使用一个 h200 Job。三者同时运行每小时约 $20。
权重同步
| 每次同步,trainer 时钟,共 126 次同步 | 之前 | 现在(p50) |
|---|---|---|
| 整个同步 | 30.8 s | 8.5 s(最小 6.6,最大 9.2) |
| 其中:暂停两个 replica | 0.3 s | 0.3 s |
| adapter all-gather 并保存到 bucket | 0.6 s | 1.1 s |
| 两个 replica 接受 adapter | ~29 s | ~7 s |
252 次 adapter 加载全部成功 🎉:126 次同步乘以 2 个副本。其中 6 次在第二次尝试时成功,246 次在第三次成功。
路由
运行结束时,经过 64,728 次 rollout,代理的计数器显示:
routed [31928, 32800] affinity 54712 spilled 820 unmatched 9196
每个 prompt 有 8 次 rollout,那么八个请求中至少有一个必然是冷启动。理论下限因此是 12.5%。路由器得到 14.2% 未匹配请求、84.5% 亲和命中、1.3% 溢出。除非我们开始用基于真实测量负载的更深层推理侧指标来考察每个副本的负载,否则这里已经没有多少可优化的空间了。
时间都花在哪
第一个配置有个很明显的问题:瓶颈是训练器,不是生成。在 500 步中,我们有:
| 每个优化器步,p50 | |
|---|---|
| step | 22.9 s |
| forward + backward | 21.9 s |
| 等待 rollout | 0.02 s |
| rollout 队列占用 | 512 中的 476 |
| 训练器 MFU | 3.9% |
rollout 队列始终是满的,worker 大部分时间被背压阻塞。第二个副本在这个配置下基本没用。后文会看到我们如何通过一系列运行把瓶颈在训练和生成之间来回移动,最终让运行快了 3.9 倍。
奖励
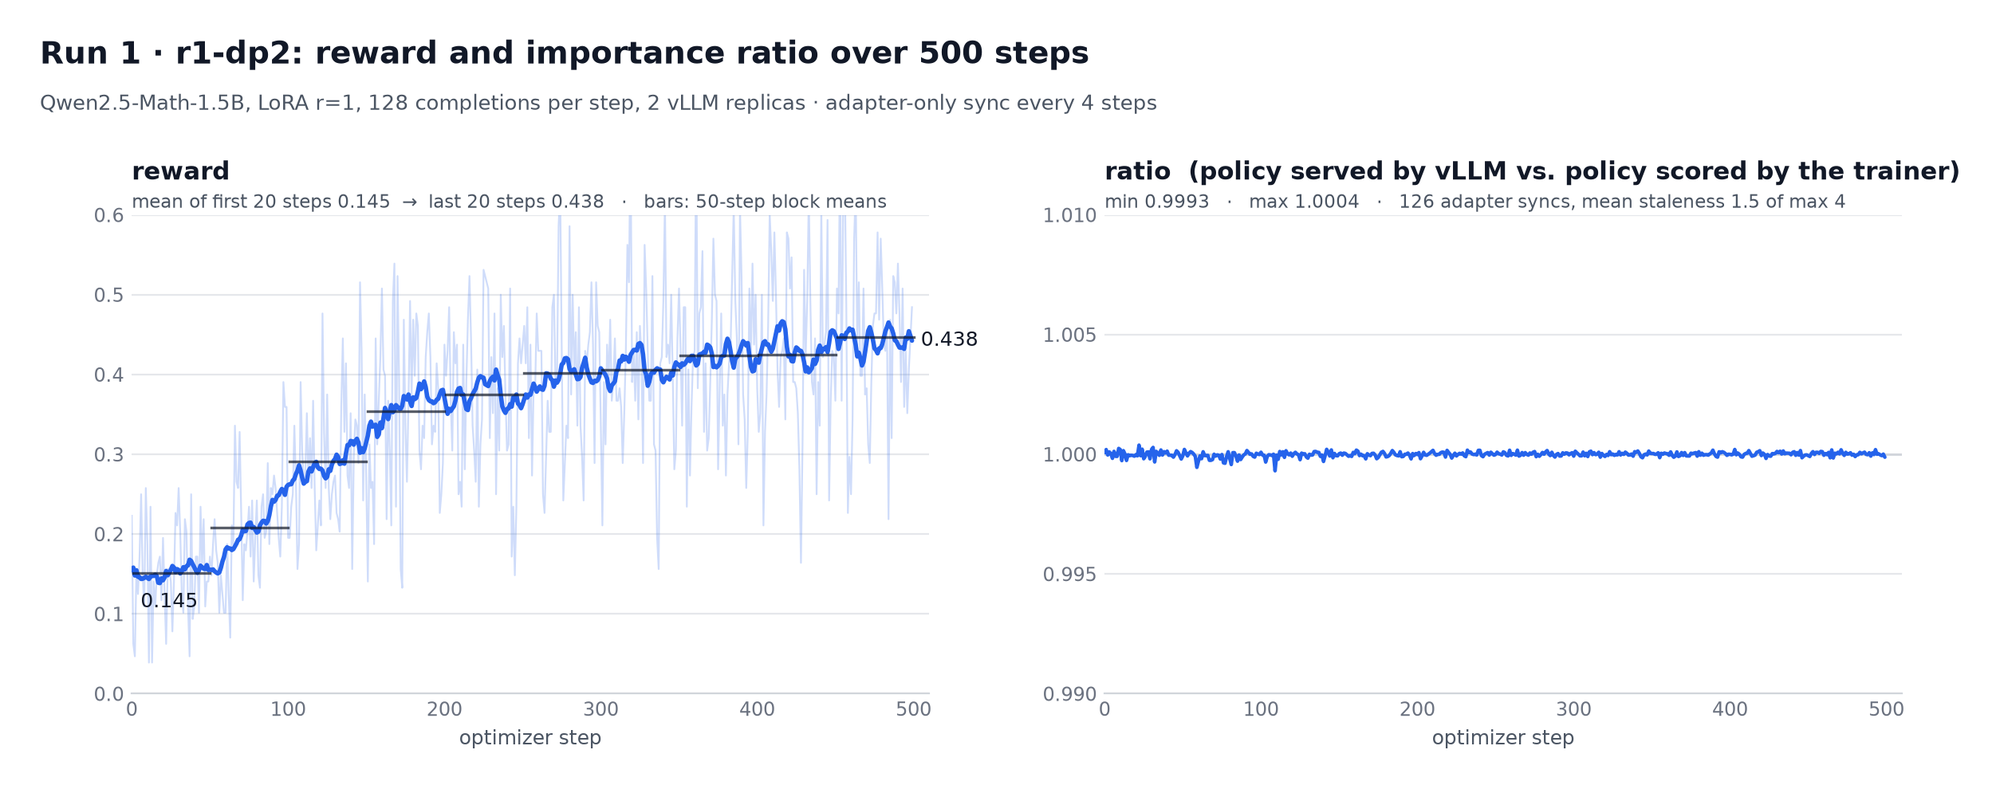
图 1。trackio 运行 r1-dp2。面板:reward 及其 20 步滚动均值和 50 步分块均值,以及 ratio,坐标轴为 0.99 到 1.01。奖励在 500 步中从 0.15 爬升到 0.44;ratio 全程保持在 0.9993 到 1.0004 之间。
500 步耗时 3 小时 27 分钟。平均奖励从前 20 步的 0.145 升到后 20 步的 0.438。对这个测试更重要的是,ratio 每一步都保持在 1.000!vLLM 服务的策略始终与训练器用来给 rollout 打分的策略一致。这一点在全部 126 次同步中都成立。平均陈旧度为 1.5 个策略版本,上限为 4。trackio 仪表盘 有完整曲线。
我们有了 LoRA AsyncGRPO 确实可行的铁证!接下来看看最近的详细 AsyncGRPO 指标,了解如何改进训练运行。
追着瓶颈打乒乓球
异步 RL 是训练与生成之间的一条流水线。只让一侧变快,另一侧跟不上,等于白干。好在 AsyncGRPOTrainer 里补了足够多的计时和指标,这个问题现在能直接看出来。
有用的指标都写在 Logged metrics 一节里。perf/rollout_wait_s 告诉我们 trainer 等样本等了多久。rollout/backpressure_s 告诉我们生成端等 rollout 队列腾出空位等了多久。这两个指标方向正好相反,不该同时高。再结合队列长度,就能判断是哪一侧慢。
我们跑了五组实验。每一组都从上一轮 dashboard 里暴露出的问题出发。除非另有说明,模型、recipe 和三 Job 的布局保持不变。下面的名字就是 trackio 的 run 名。
怎么看 dashboard
我们始终盯着这四组指标:
perf/step_s和perf/fwd_bwd_s:一个 optimizer step 要多久,其中 forward+backward 占多少。如果一步的耗时几乎等于 forward+backward,那 trainer 显然是算力受限。perf/rollout_wait_s:trainer 在开始一步之前,坐着等样本等了多久。接近零,说明生成跑在训练前面,样本随时可取,拿来就能训。sample/rollout_queue_size对比queue_maxsize:两侧之间的缓冲区。满了说明生成被限流;空了说明 trainer 在挨饿。rollout/backpressure_s和rollout/score_block_s:rollout worker 因为缓冲区满而被阻塞了多久。worker 是一条两级流水线:生成把完成的 group 交给打分阶段,打分把打完分的样本推进 rollout 缓冲区。缓冲区一满,打分阶段就无法入队、被阻塞,这就是rollout/backpressure_s。接着打分阶段不再消费自己的输入队列,生成也就交不出下一个 group,这就是rollout/score_block_s。两者是同一个卡顿,先在打分阶段出现,再往上传导到生成。
诊断很简单:队列满、rollout wait 为零、backpressure 高,说明 trainer 太慢。队列空、rollout wait 上升、没有 backpressure,说明生成太慢。把 perf/mfu_wall_clock 和 perf/mfu_fwd_bwd 放在一起比,还能看出 trainer 的 GPU 有多少时间是在干等,而不是在训练。
第 1 次运行,r1-dp2:跟不上节奏的训练器
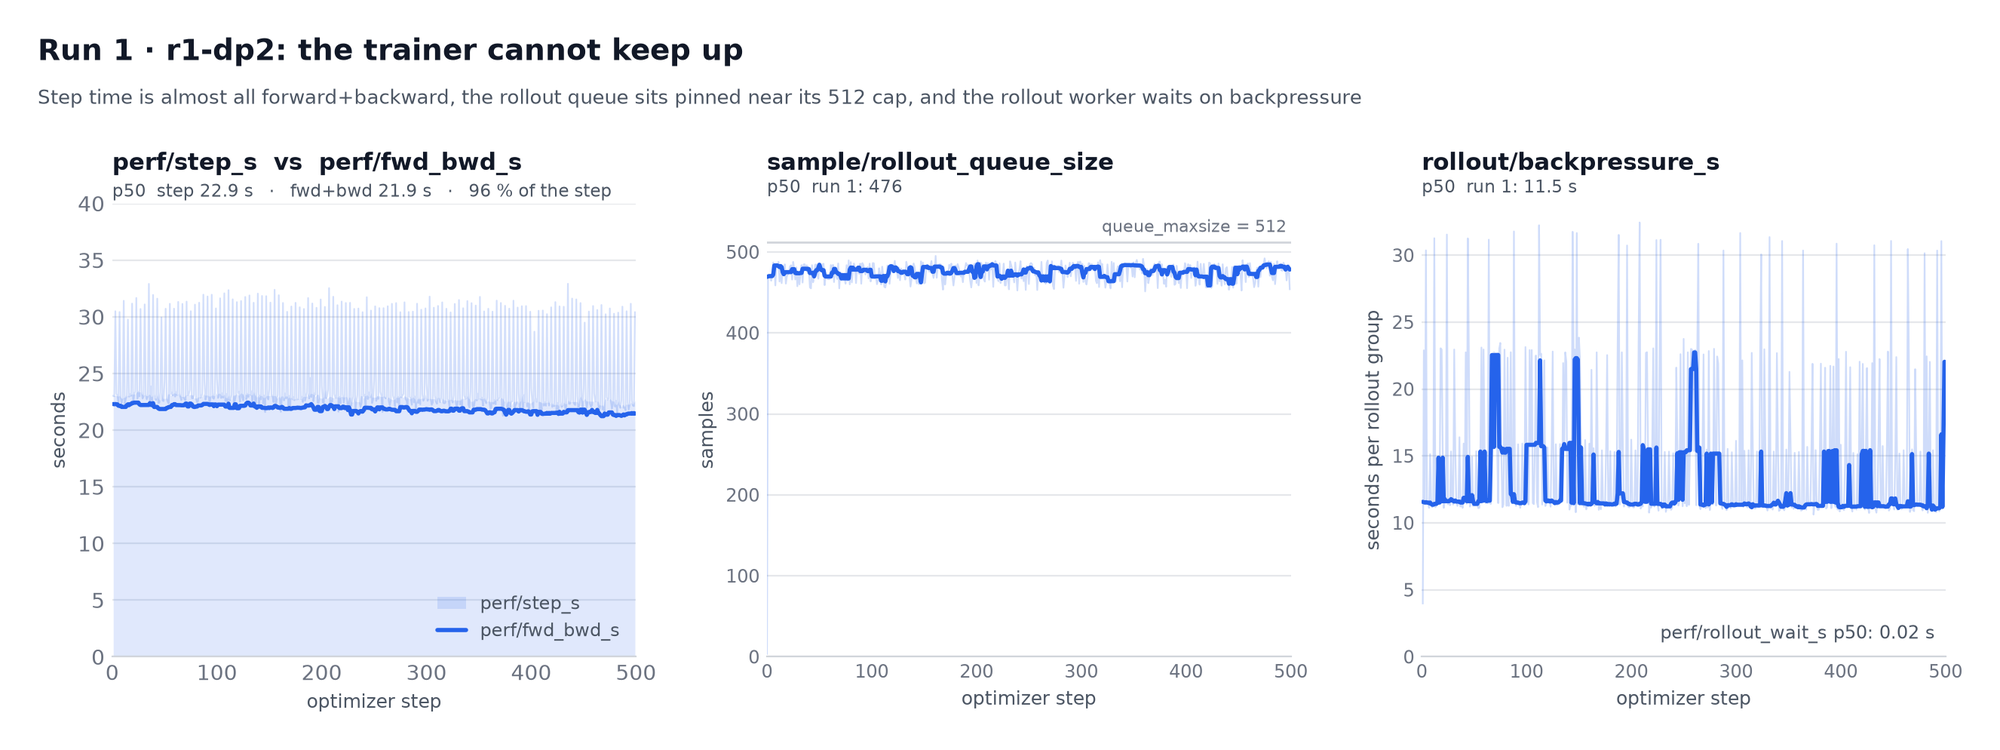
图 2。trackio 运行 r1-dp2。面板:perf/step_s、perf/fwd_bwd_s、sample/rollout_queue_size、rollout/backpressure_s。步进时间与 forward+backward 几乎完全重叠;队列一直卡在 512 中的 476 附近,背压从未低于每个 rollout 组 11 秒:训练器受限。
perf/step_s 为 22.9 秒,perf/fwd_bwd_s 为 21.9 秒。forward 和 backward 占步进时间的 96%。队列始终是满的,训练器等待 rollout 只花 0.02 秒,而 rollout worker 每组有 15 秒被背压阻塞。两个 vLLM 副本的生成速度快于训练器的消费速度。报告的 4.6k tokens/s 并不是它们的实际上限;它们只是没地方放更多输出。
批处理指标解释了 3.9% 这个糟糕的 MFU。batch/microbatches_per_step 为 64,batch/samples_per_row 为 1.0。每个 rank 处理一条约 1.2k token 的序列,每步 64 次。这来自参考配方的 per_device_train_batch_size=1。对于 H200 上的 1.5B 模型,这完全是延迟受限。
第 2 次运行,r1-dp2-tb16k:打包 microbatch
解决办法不是改 batch size。我们保持每个优化器步 128 条 completion,只改变它们在 GPU 上的排布方式:不再让每个 microbatch 放一条序列,而是把多条序列密集地打包进每一行。训练器通过 token-budget batching 支持这一点。设置 token_budget > 0 后,它会把多个样本打包成每个 rank 一行、无 padding。一个优化器步处理 gradient_accumulation_steps 行。我们设置 token_budget=16384 和 gradient_accumulation_steps=6。
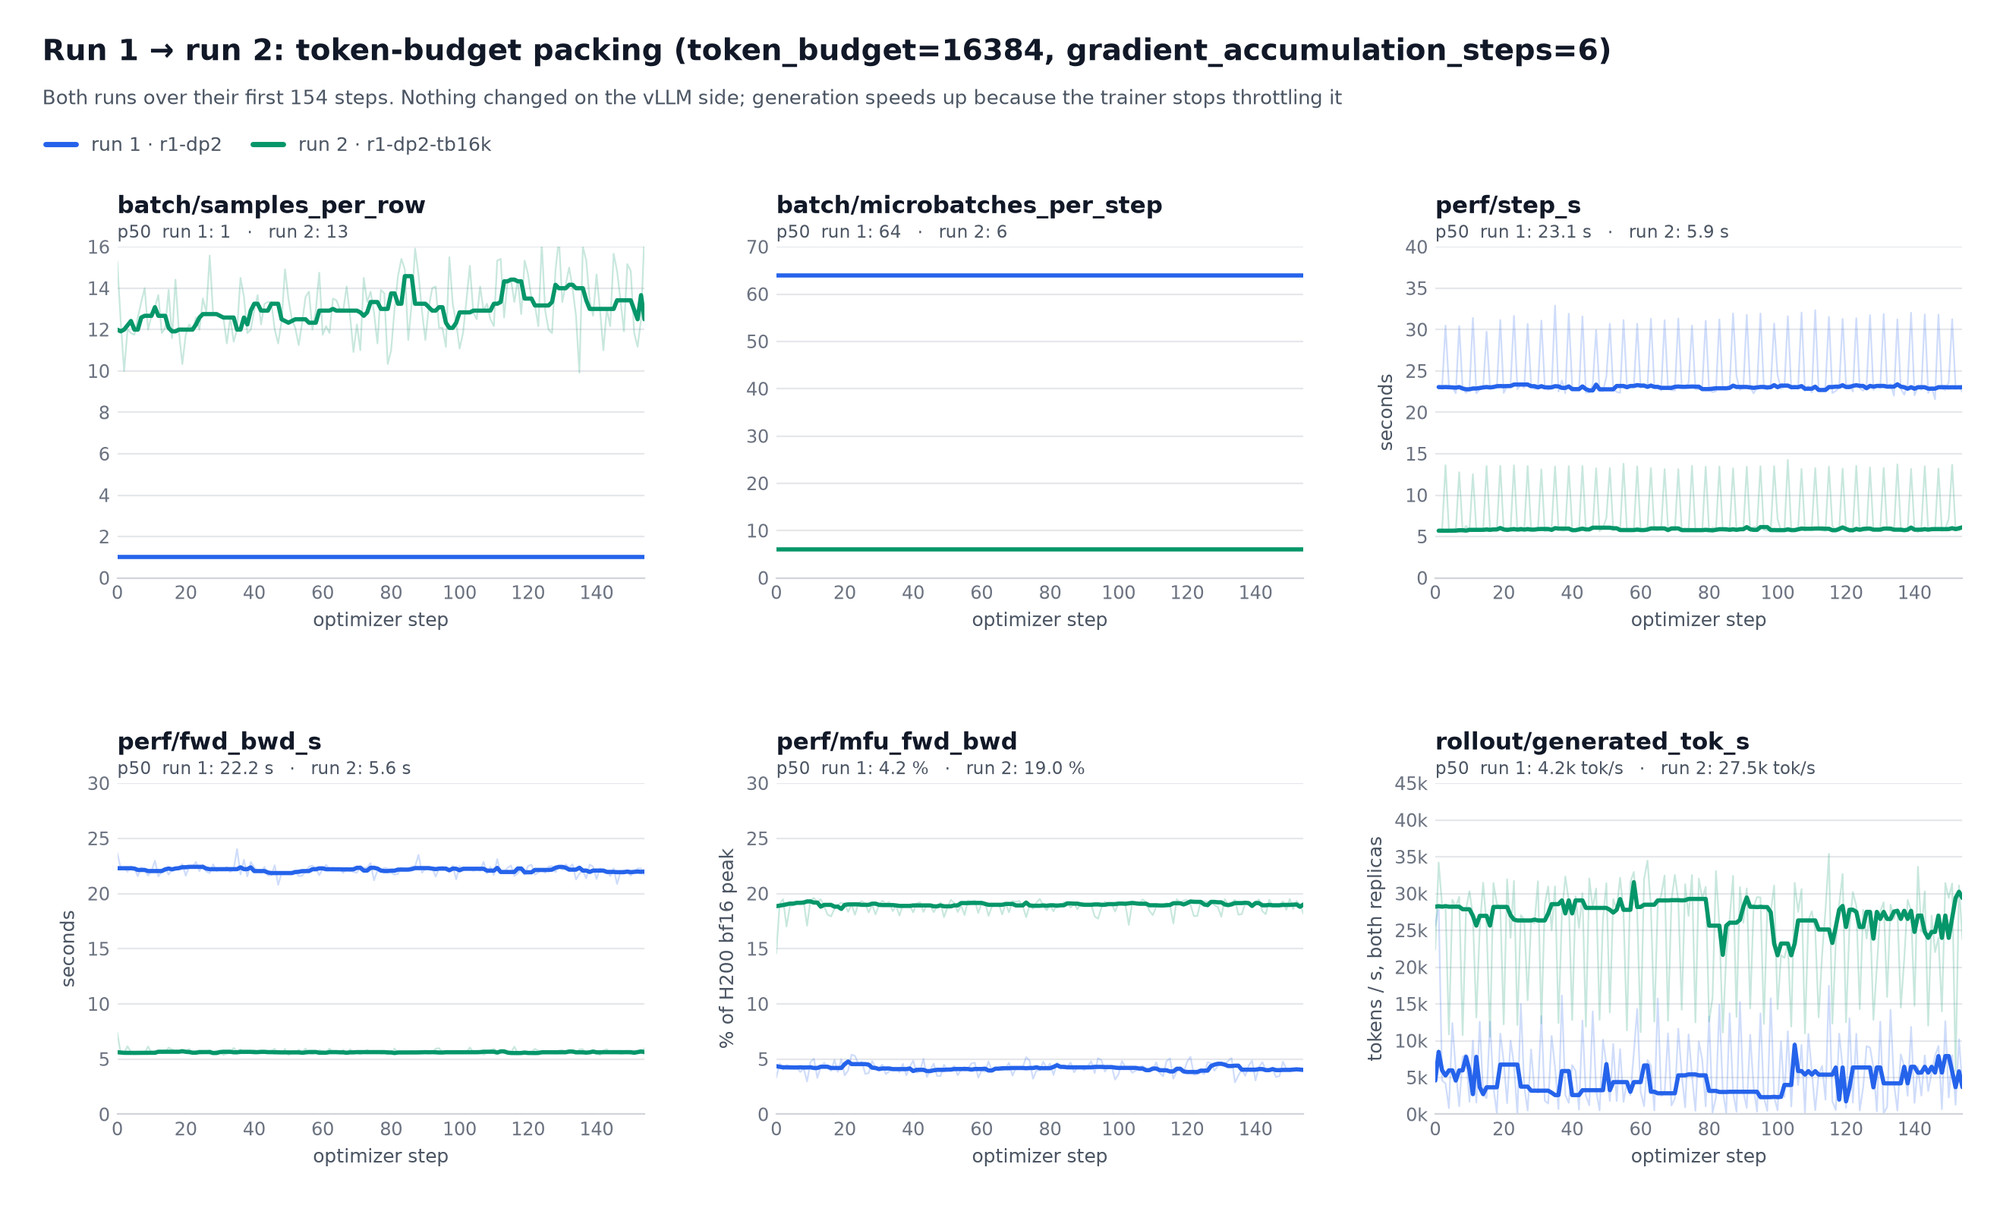
图 3。trackio 运行 r1-dp2 和 r1-dp2-tb16k 叠加显示各自前 154 步。面板:batch/samples_per_row、batch/microbatches_per_step、perf/step_s、perf/fwd_bwd_s、perf/mfu_fwd_bwd、rollout/generated_tok_s。打包把每行样本数从 1 提到 13,microbatch 从 64 降到 6,步进时间从 23 秒降到 5.9 秒,生成速度从 4.2k 提到 27.5k tok/s,而 vLLM 侧没有任何改动。
batch/samples_per_row 从 1.0 升到约 12.7,microbatch 数量从 64 降到 6。行填充率达到 95%!forward 和 backward 从 21.9 秒降到 5.6 秒,MFU 从 3.9% 升到 19%。现在每步训练约 150 个样本,因为行的打包效果比平均长度估计预测的更好。
生成速度也从 4.6k tokens/s 跃升到 25k tokens/s,而 vLLM 这边我们什么都没改。队列不再始终满载,副本终于能跑起来了。这就是我们不喜欢孤立地优化流水线各阶段的原因。必须把整个系统放在一起评估,因为一个慢阶段会掩盖它前面所有环节的真实性能。
Run 3,r1-dp2-tb16k-nockpt:别再重算前向
perf/fwd_s 是 1.34 s,而 perf/fwd_bwd_s 是 5.6 s。正常的反向大约是前向的两倍,而基础权重冻结后应该接近一倍。3.2 这个比值很可疑。
原因是 AsyncGRPOConfig 默认等于 gradient_checkpointing=True。每个 microbatch 在反向时都会重算一遍前向。这也解释了为什么一行 16k token 在 141 GB 的 H200 上只占 25 GB!对这个训练器来说这是内存优化,但在这个具体场景里我们不需要:模型足够小,把激活值留着给反向用也能塞进显存。
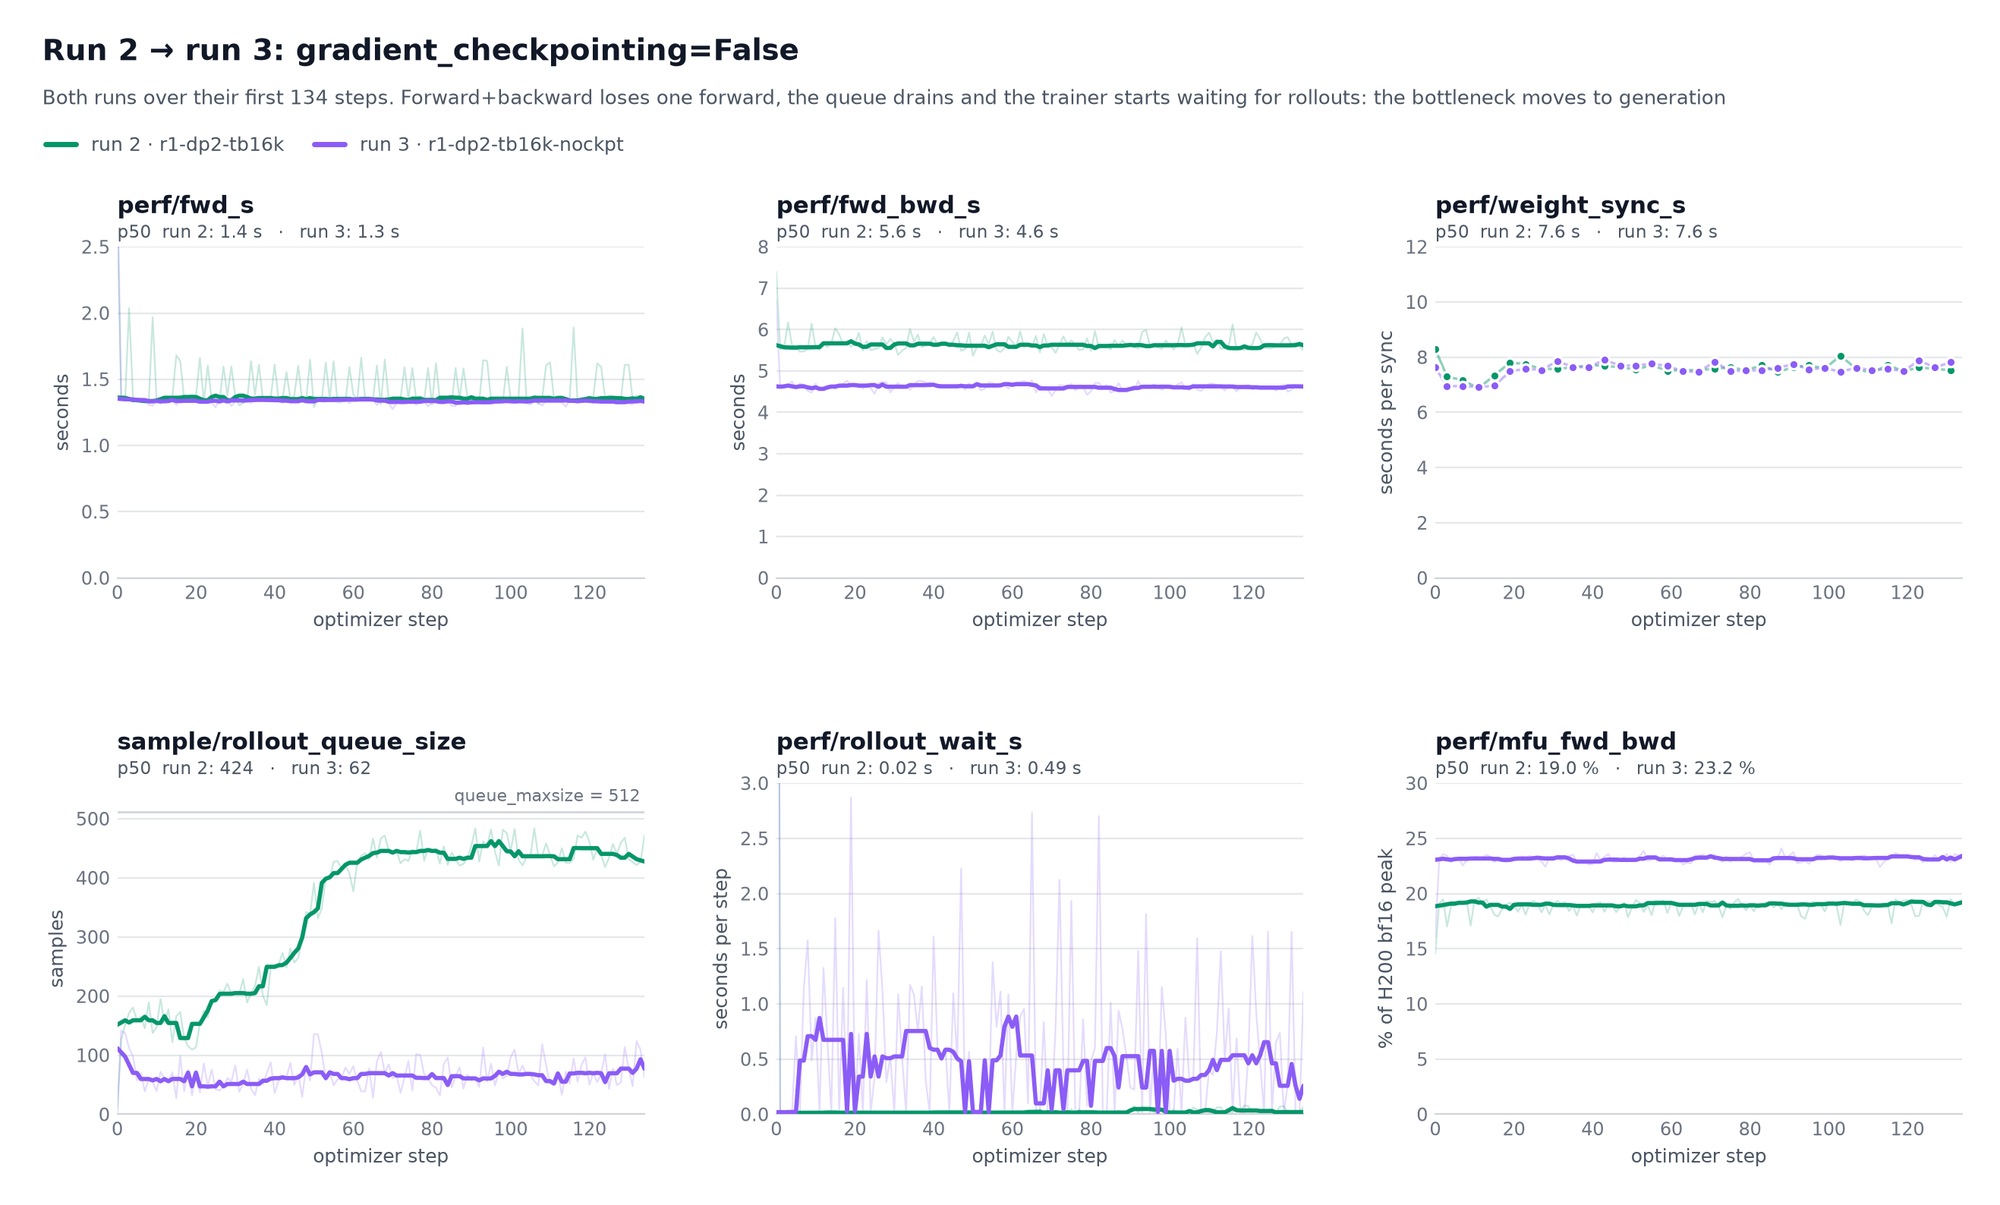
图 4。trackio 把 r1-dp2-tb16k 和 r1-dp2-tb16k-nockpt 的前 134 步叠在一起。面板:perf/fwd_s、perf/fwd_bwd_s、perf/weight_sync_s、sample/rollout_queue_size、perf/rollout_wait_s、perf/mfu_fwd_bwd。前向+反向少了一次前向;队列从约 420 降到约 60,rollout 等待从 0.02 s 升到 0.5 s:瓶颈转移到了生成。
用上 gradient_checkpointing=False 后,前向和反向降到 4.6 s,几乎正好少了一次前向,MFU 达到 23%。队列现在降到 71,rollout 等待从 0.04 s 升到 0.6 s。训练器消费样本的速度快于两个副本生成样本的速度。我们_成功_把瓶颈挪到了生成上。
这又暴露出两项开销。每四步一次 7.6 秒的权重同步,现在占了 25% 的墙钟时间。之前每步要 23 秒时它只占 8%。另外,反向仍然比前向慢 2.5 倍。基础权重冻结的情况下,每步大约有 2 秒不像正常的模型计算。
Run 4,r1-dp3-tb16k-nockpt:三个副本,以及一个意外
既然生成现在太慢,我们就加了第三个副本。同时把代理里的 adapter 重试间隔从 2 s 降到 0.5 s,并关掉 fsdp_reshard_after_forward,看看反向里多出来的那 2 秒是不是 FSDP2 的 re-gather 造成的。
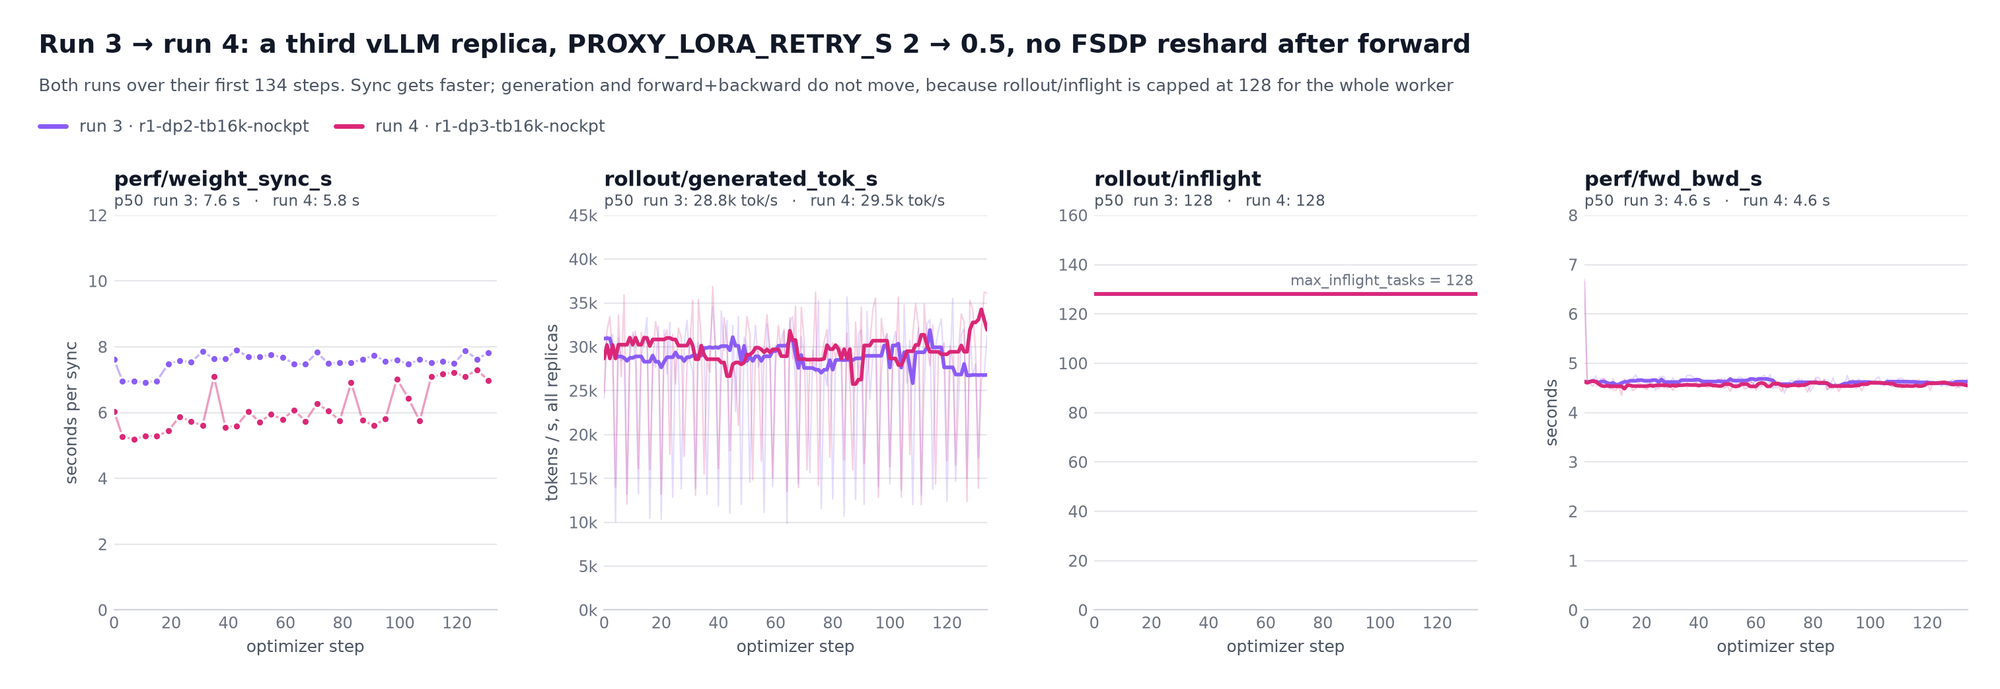
图 5。trackio 的 r1-dp2-tb16k-nockpt 与 r1-dp3-tb16k-nockpt 两次运行叠加,取前 134 步。各面板依次为 perf/weight_sync_s、rollout/generated_tok_s、rollout/inflight、perf/fwd_bwd_s。权重同步从 7.6 s 降到 5.8 s;生成与 forward+backward 没有变化;两次运行的 rollout/inflight 都是 128,这正是第三个副本撞上的上限。
权重同步从 7.6 s 降到 5.8 s,缩短重试确实有用。Forward 和 backward 仍是 4.6 s,可以排除 resharding 的嫌疑。生成速度只从 25k 升到 26k tokens/s。第三个副本基本什么也没干。
原因就摆在 rollout/inflight 里:每次运行都是 128。代理显示这些请求在三个副本上的分布是 44 + 43 + 41。max_inflight_tasks 限制的是整个 rollout worker 的并发数,而不是每个副本。1.5B 模型跑在 H200 上,43 条和 130 条并发序列的每 token 开销几乎一样。把 128 个请求分到三张 GPU 上,吞吐量和分到两张上差不多。
所以瓶颈不在 vLLM,而在我们自己客户端的一个常量。当初设得保守,是因为不知道几百个长 HTTPS 请求走公网 Jobs 代理会是什么表现。到这时为止,已经有 130,000 次 rollout 完成穿过这个代理,一次传输错误都没出过。
运行 5,r1-dp3-inflight384:放开在途请求上限
只改 max_inflight_tasks=384 和 queue_maxsize=768,别的都不动。
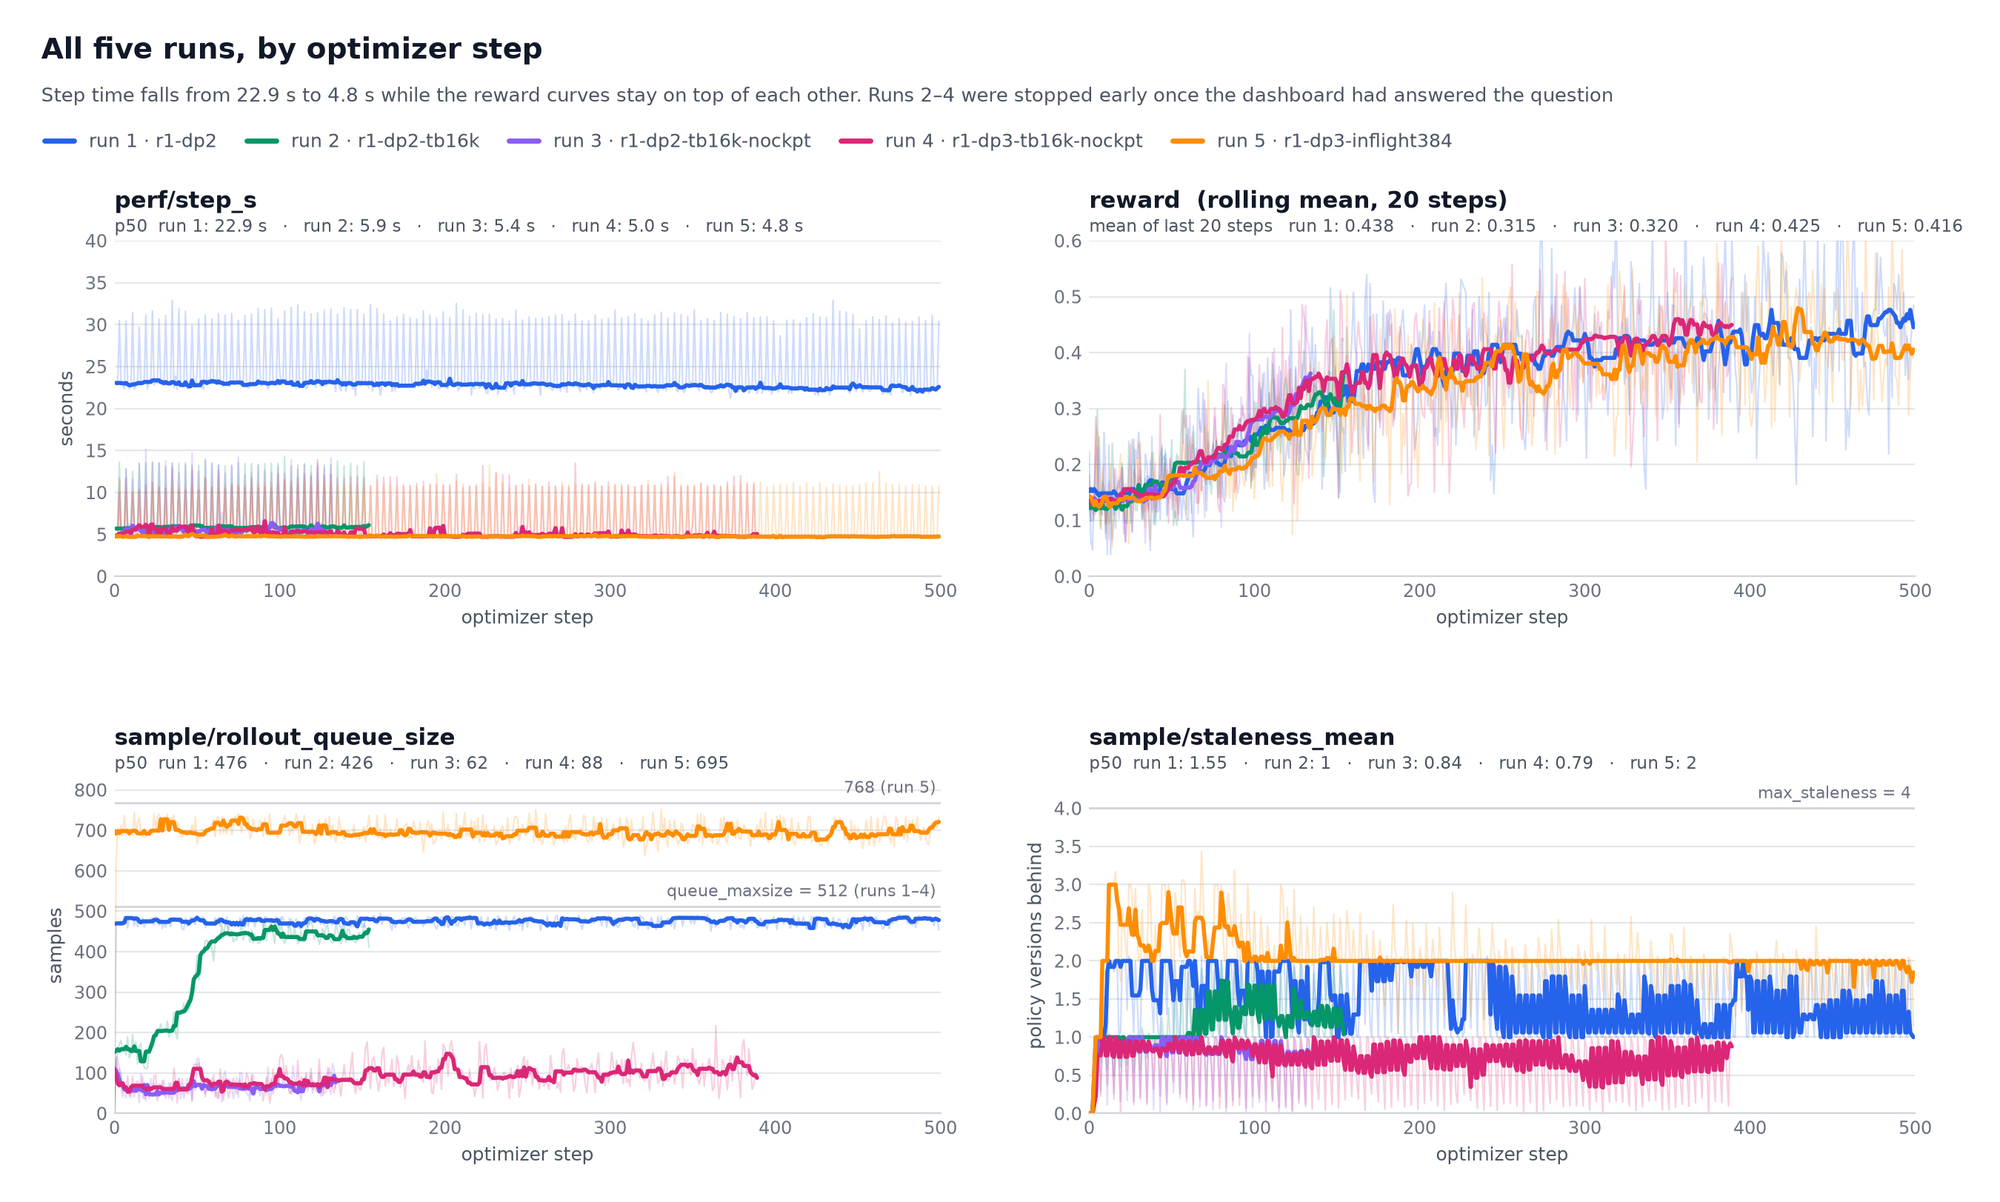
图 6。trackio 全部五次运行(r1-dp2、r1-dp2-tb16k、r1-dp2-tb16k-nockpt、r1-dp3-tb16k-nockpt、r1-dp3-inflight384)叠加,横轴为步数。各面板依次为 perf/step_s、reward、sample/rollout_queue_size、sample/staleness_mean。整组运行下来,单步时间从 22.9 s 降到 4.8 s,而 reward 曲线始终叠在一起;最后一次运行的队列重新填到 768 中的约 690,staleness 稳定在 2。运行 2 到 4 在仪表盘给出答案后就提前停掉了。
384 个请求在途时,每个副本分到 128 个。队列很快填到 768 中的约 690,并一直保持在这个水平。背压回到 5 秒,rollout 等待降到 0.03 秒。训练重新成为瓶颈!Forward 和 backward 占 4.6 秒,权重同步摊下来 1.5 秒,单步时间中位数 4.8 秒。
平均陈旧度从 1.5 个版本升到 2.0 个版本,因为样本在更大的队列里等得更久。这仍然低于 max_staleness=4,而 ratio 依然非常接近 1.000。
记分牌
| 500 步 | run 1 r1-dp2 | run 5 r1-dp3-inflight384 |
|---|---|---|
| 墙钟时间 | 3 小时 27 分 | 53 分 |
perf/step_s,p50 | 22.9 s | 4.8 s |
perf/fwd_bwd_s,p50 | 21.9 s | 4.6 s |
perf/mfu_fwd_bwd | 3.9 % | 23.5 % |
batch/samples_per_step | 128 | 168 |
| 训练样本数 | 64 000 | 84 078 |
perf/weight_sync_s,p50 | 8.5 s | 6.2 s |
sample/staleness_mean | 1.5 | 2.0 |
| reward,前 20 步 → 后 20 步 | 0.145 → 0.438 | 0.145 → 0.416 |
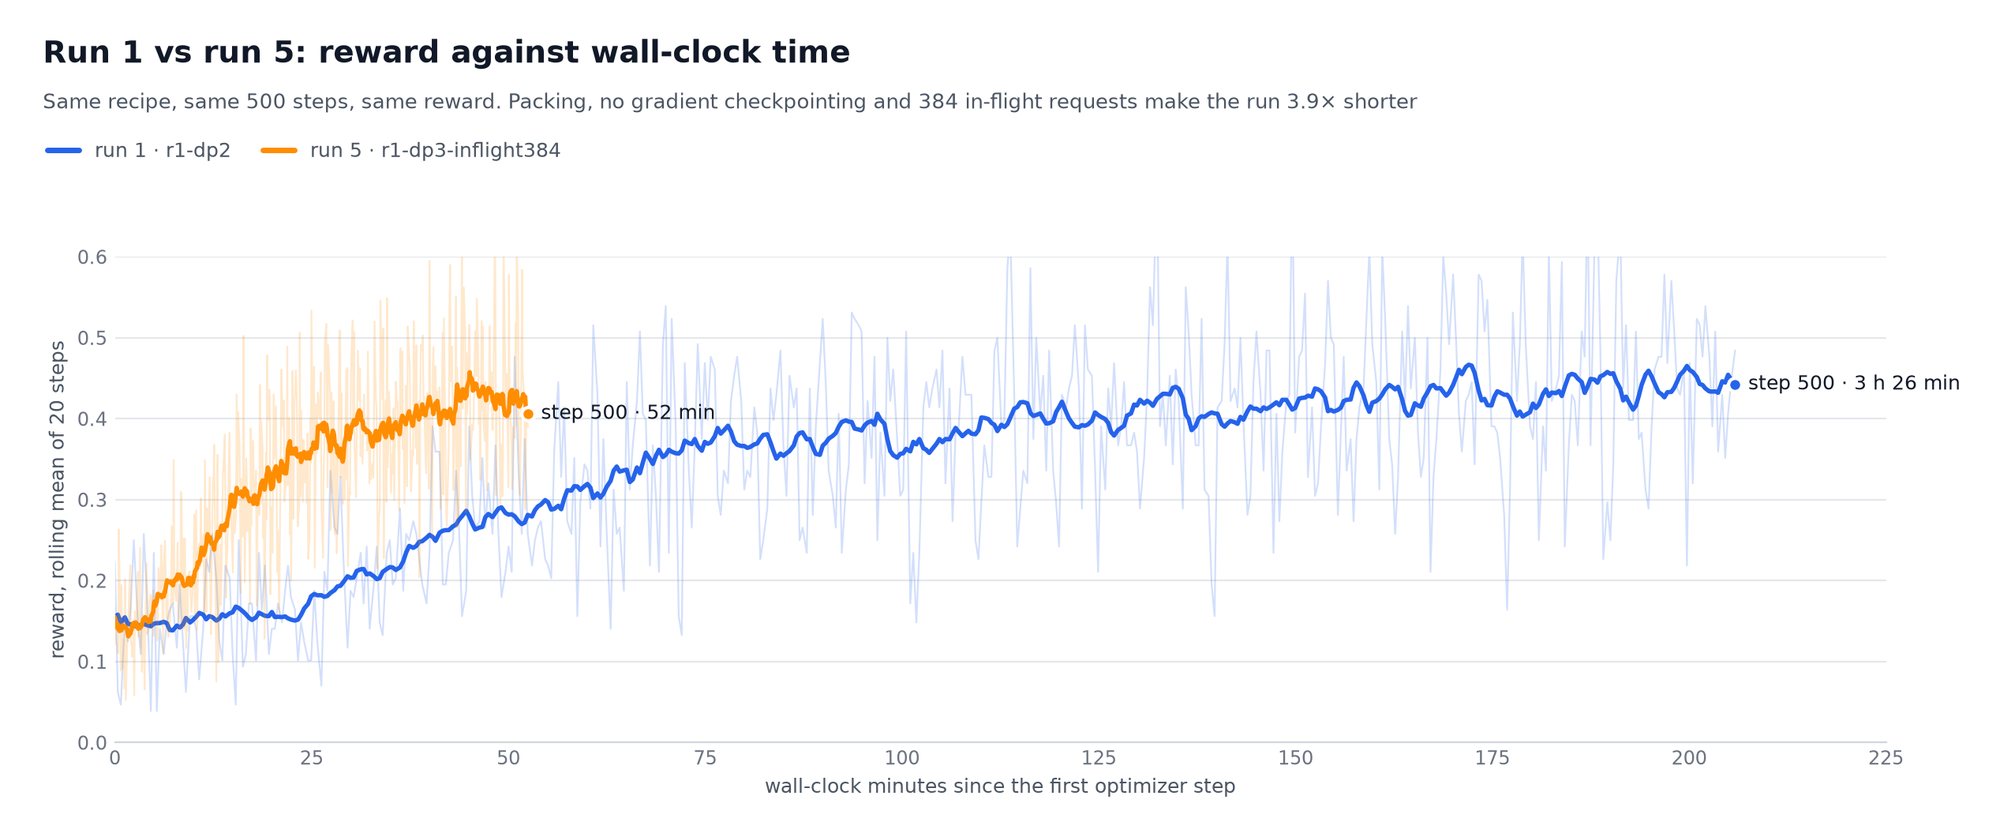
图 7。trackio 运行 r1-dp2 和 r1-dp3-inflight384,reward 对自第一次优化器步以来的墙钟分钟数。同样的配方、同样的 500 步、同样的最终 reward;run 5 用 52 分钟到达,而不是 3 小时 26 分。
最终这次运行快了 3.9 倍,训练样本多了 31 %,reward 曲线基本一致。packing、关掉 checkpointing、提高 in-flight 上限带来了这个差别。每一次,dashboard 都在头十分钟内把问题指了出来。
试一试
git clone https://github.com/AmineDiro/hfjobs-lora-buckets && cd hfjobs-lora-buckets
hf auth login
MAX_STEPS=20 RUN_TAG=smoke ./run_all.sh --wait        # ~15 min, three Jobs, cancels the servers when done
MAX_STEPS=500 ./run_all.sh --wait                     # run 1: the reference batch shape, ~3.5 h
TOKEN_BUDGET=16384 GRAD_ACCUM=6 GRADIENT_CHECKPOINTING=0 PROXY_LORA_RETRY_S=0.5 \
  MAX_INFLIGHT=384 QUEUE_MAXSIZE=768 MAX_STEPS=500 ./run_all.sh --wait   # run 5: same recipe, ~55 min
参考资料
- John Schulman 等,LoRA Without Regret,Thinking Machines Lab,2025 年 9 月。论证 rank-1 LoRA 在策略梯度 RL 中可与全量微调持平,以及原因。
- TRL,
AsyncGRPOTrainer及其记录的指标。 - TRL PR #7017:为
AsyncGRPOTrainer提供 PEFT/LoRA 支持,并只同步 adapter 到 vLLM,已在 TRL v1.14 发布。 - Hugging Face Jobs 和 Storage Buckets;
hf-mount。 hf-mount-repro:用两个脚本复现 30 秒负缓存卡顿。- 本文中每次运行的 trackio dashboard。
- Penghui Qi、Zichen Liu、Xiangxin Zhou、Tianyu Pang、Chao Du、Wee Sun Lee、Min Lin,Defeating the Training-Inference Mismatch via FP16,arXiv:2510.26788,2025。Sanity 数据集
sail/Sanity-Test-R1D-1.5B和 LoRA 配方sail-sg/Precision-RL、oat/scripts/lora/bf16_grpo_tis_lora.sh的来源。
@article{qi2025precisionrl,
  title={Defeating the Training-Inference Mismatch via FP16},
  author={Qi, Penghui and Liu, Zichen and Zhou, Xiangxin and Pang, Tianyu and Du, Chao and Lee, Wee Sun and Lin, Min},
  journal={arXiv preprint arXiv:2510.26788},
  year={2025}
}