HF Jobs上でLoRAを使った非同期GRPO:バケット1つ、プロキシ1つ、NCCL不要
AsyncGRPOTrainer が rank-1 LoRA adapter だけを学習・同期し、HF Jobs 間は NCCL ではなく Storage Bucket 経由。500 ステップの学習が 3 時間 27 分から 53 分に短縮。
日本語
コピー
TL;DR
AsyncGRPOTrainerLoRA アダプタを学習し、そのアダプタだけを vLLM に同期できるようになった(TRL v1.14)。- rank-1 のアダプタは数 MB しかないため、NCCL を使わず、各 Job にマウントした Storage Bucket 経由で転送できる。trainer と vLLM レプリカは別々のマシン上で、独立した Hugging Face Jobs として動く。
- レプリカの手前に小さなプロキシを置き、認証ヘッダを付与し、各 rollout をその KV プレフィックスをすでに保持しているレプリカへルーティングし、アダプタのロードを全レプリカにブロードキャストする。
- AsyncGRPO のメトリクスを見ればボトルネックがどこか分かる。同じレシピで 500 ステップを回し、5 回の実行で所要時間を 3 時間 27 分から 53 分に短縮した。
LoRA 対応は最近 PR #7017 で TRL の AsyncGRPOTrainer に入り、TRL v1.14 としてリリースされた。非同期トレーナーは完全なモデルではなくアダプタを学習し、LoRA アダプタだけを vLLM に同期できる。本記事では、その上に構築した実プロジェクトを紹介する。学習と推論が同じマシンを共有しなくなった構成だ。
LoRA 学習は RL と特に相性がいい。Thinking Machines のブログ LoRA Without Regret がそれを示している。彼らによれば、方策勾配 RL では rank が 1 であっても LoRA はフル微調整に並ぶ。理由は、アドバンテージ関数が 1 エピソードあたり ~O(1) ビットの情報しか与えないため、総情報量から見て 1 ステップで学べることは多くないからだ。rank-1 アダプタの容量でその情報を吸収しきれる。
LoRA 学習にはシステム面の帰結もある。1.5B モデルの rank-1 アダプタは数 MB だが、完全なモデルは約 3 GB ある。更新のたびに完全なポリシーを推論ワーカーへ送る代わりに、アダプタだけを送ればいい。vLLM は複数のアダプタを同時にロードできる。古い rollout は開始時のポリシーで最後まで走り、新しい rollout は最新のポリシーを使う。
TRL の AsyncGRPOTrainer はすでに学習と生成を分離している。trainer と vLLM は別々のマシンで動かせ、それぞれ自分のペースで進められる。単一ノードやクラスタ環境なら、両プロセスがファイルシステムを共有するか NCCL グループを組めるので、これは簡単だ。
同じ構成を Hugging Face Jobs で動かしたい。HF Job は要するに 1 台の VM 上で 1 つのコンテナを動かすものなので、単一の Job で複数ノードを立ち上げて(少なくとも現時点では)trainer と vLLM サーバ群を同居させることはできない(単一ノードでも 8xH200 が上限だ)。AsyncGRPOTrainer はまさにこの規模向けに設計されている。そこで問いはこうなる。trainer と推論サーバが同じノードにいることをやめたら、どこまで行けるのか。
完全な重み同期なら答えは「大して行けない」。更新のたびに数 GB のデータをマシン間で運ぶ必要があり、密集したクラスタではそこが NCCL の出番だが、Job 間ではノードをまたいだ通信ができない。共有ローカルディスクもなければ、当然 localhost も共有されていない。LoRA なら 1 回の同期は数 MB で済む。ファイルシステムについては、HF Jobs が Storage Buckets に支えられたボリュームを提供しており、この bucket を各 Job に FUSE ファイルシステムとしてマウントできる。ノード間の共有 FS としては十分だ。Job 間にネットワーク経路は一切要らない。
最終的な構成はかなり簡素だ。
- trainer Job を 1 つ。LoRA(および FSDP。詳細は後述)で
AsyncGRPOTrainerを回す。 - vLLM Job を 2 つ。それぞれベースモデルと、trainer が最後に公開した adapter を配信する。
- Storage Bucket を 1 つ。3 つの Job に同じパスでマウントし、adapter はこれを通って trainer からサーバへ渡る。
- プロキシサーバ を 1 つ。なぜ必要かは改めて説明するが、おおまかに言えば、各 rollout をその KV cache を保持している可能性が最も高いレプリカへルーティングし、adapter の更新を全 vLLM レプリカへブロードキャストするためにプロキシが要る。
アーキテクチャ:Hugging Face Jobs と Storage Buckets で 🪣
AsyncGRPOTrainer に追加された adapter のみを同期する経路はこう動く。trainer は vLLM にテンソルを送らない。数オプティマイザ step ごとに adapter を <output_dir>/.vllm_lora/trl-policy-v{N} 以下に保存し、ディレクトリをアトミックなリネームで公開し、そのパスを vLLM の /v1/load_lora_adapter エンドポイントへ送る。vLLM はファイルをディスクからロードし、その後 rollout worker が model="trl-policy-v{N}" を要求できる。
vLLM の実行時 adapter ロードはもともとこうなっている。インターフェースが受け取るのはテンソルではなくパスなので、trainer とサーバは同じファイルシステムを共有していなければならない。Slurm クラスタではそれがネットワークファイルシステムだ。Jobs では、前述のとおり Storage Bucket を各 Job の同じパスにボリュームとしてマウントすることで同じことを実現する。裏では hf-mount が使われており、bucket を POSIX ファイルシステムとしてコンテナ内に公開する。
# every Job gets the same bucket at the same absolute path
hf jobs run ... -v hf://buckets/aminediroHF/asyncgrpo-lora-buckets:/lora ...
TRL も vLLM も、そのために変更を加える必要はない。トレーナーが /lora/<run>/.vllm_lora/ に書き込み、各サーバーが同じパスを読み取る。POST リクエストで送信されるパスは、どのコンテナ内でもすでに有効だ。
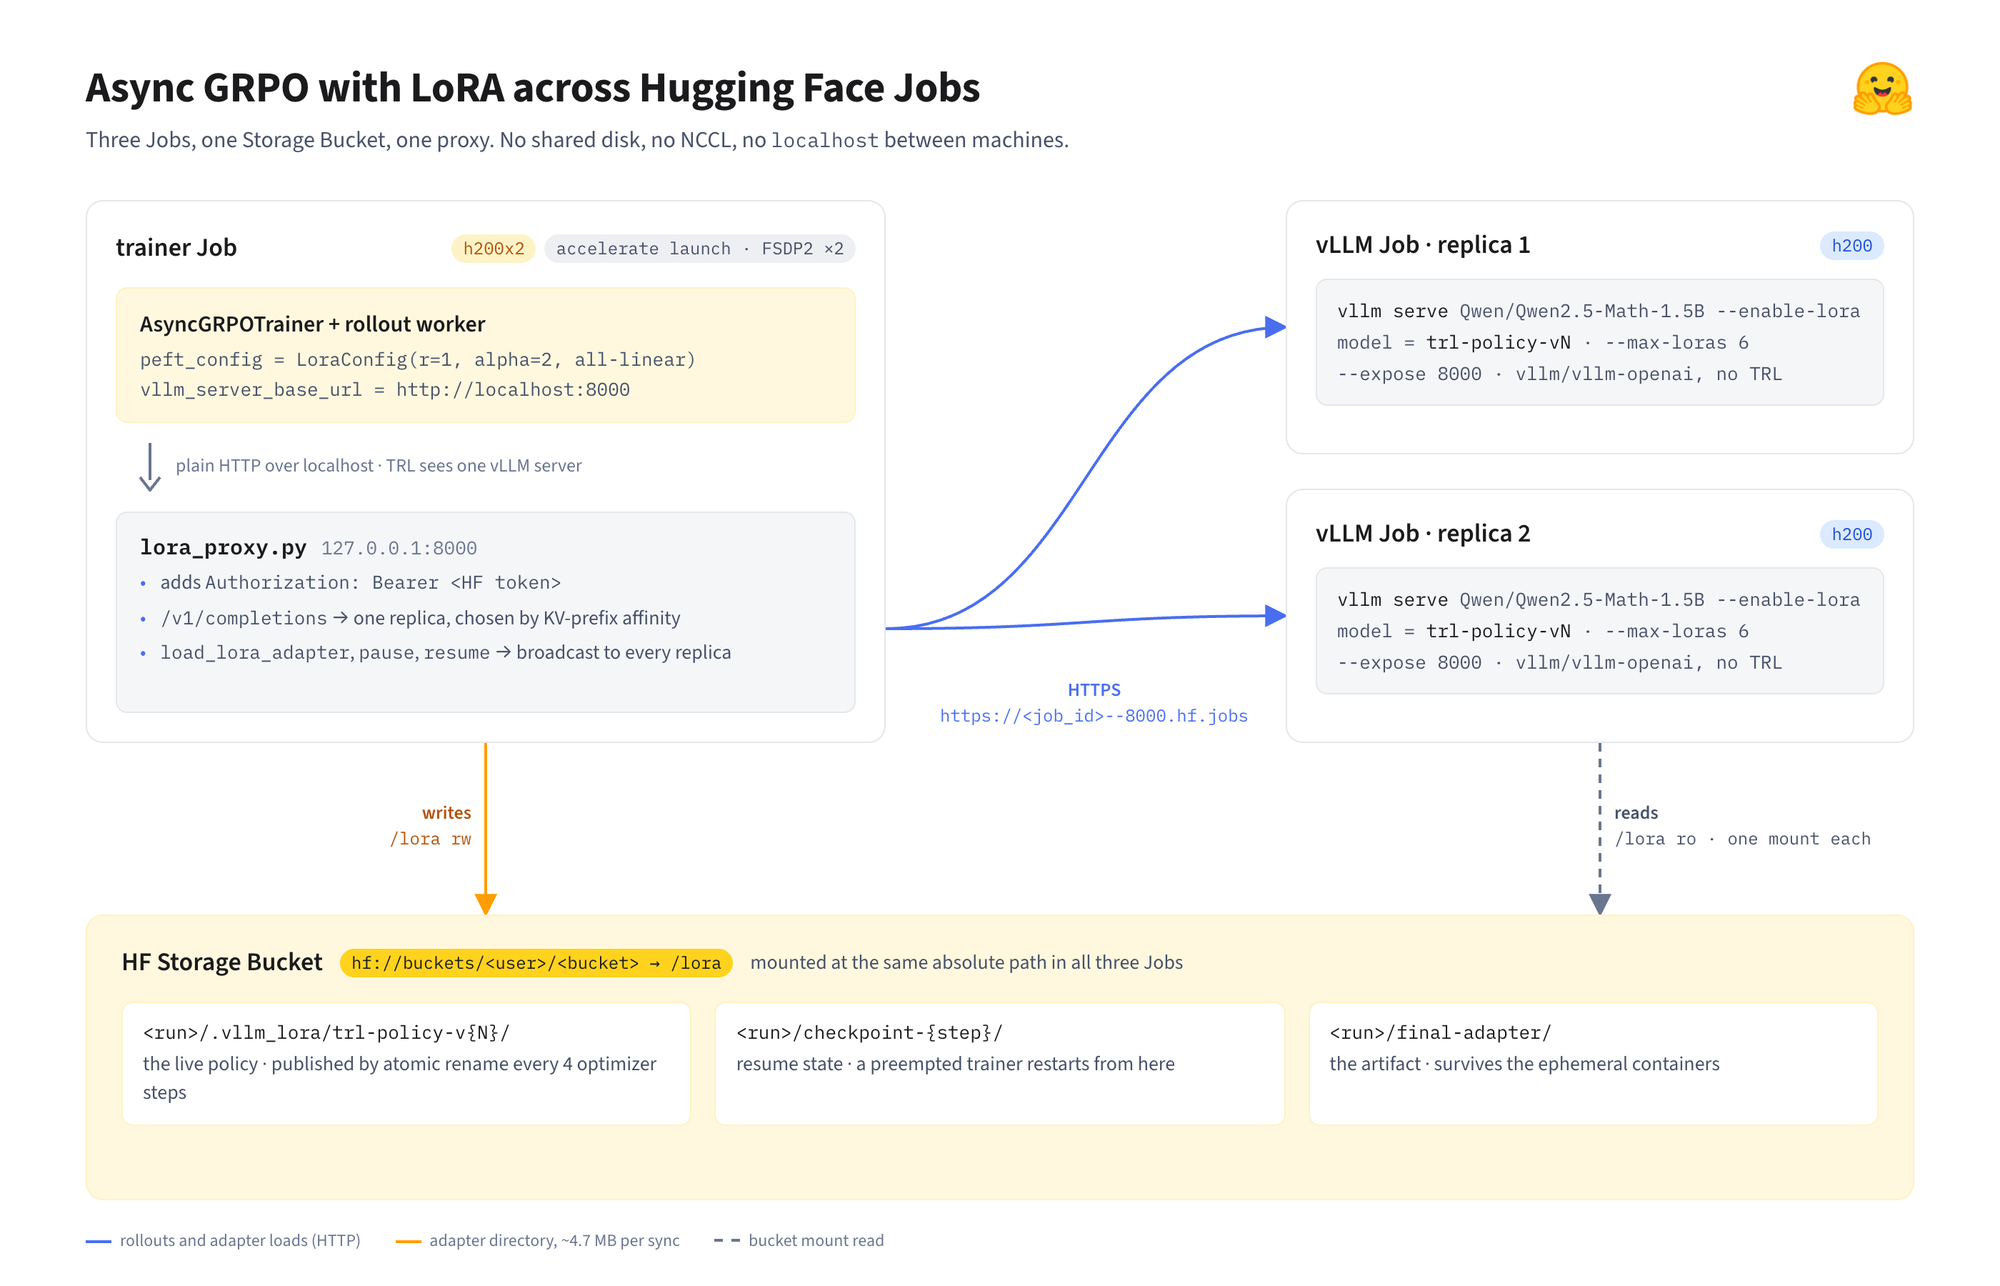
3 つの Job と bucket。TRL は localhost 経由でプロキシと通信し、プロキシは HTTPS でレプリカと通信し、アダプタのディレクトリは bucket のマウント経由で受け渡される。
チェックポイントと最終アダプタも同様に bucket に置かれる点に注意してほしい。HF Jobs は一時的だが、プリエンプトされたトレーナーはトレーニングを再開できる。最終アダプタは常に bucket へ永続化されるため、Job が停止しても失われないからだ。
3 つの Job
vLLM レプリカ
各レプリカは GPU 1 基と、素の vllm/vllm-openai イメージを使用する。必要なのはランタイム LoRA ロードを有効にし、アダプタのスロットを十分に確保することだけだ。
アダプタのスロット数は max_staleness で決まる。AsyncGRPOTrainer では、重みを同期するたびにポリシーのバージョンが 1 つ増え、max_staleness は 1 つの rollout サンプルが現在のポリシーより最大で何バージョン遅れてもよいかを表し、それを超えるとトレーナーが破棄する。max_staleness=4 のとき、trl-policy-v3 で生成されたサンプルは、トレーナーが v7 にあってもトレーニングに使われる。v3 で始まった rollout も v3 で完了できなければならない。つまり vLLM は常に、現在のポリシーと過去 4 バージョンを同時に配信する必要がある。だからトレーナーは max_staleness + 1 個のアダプタバージョンを登録したままにし、古いものをアンロードする。同期のたびに新しいバージョンをロードしてから最も古いものをアンロードするので、入れ替え中にもう 1 つスロットが必要になる。よって --max-loras 6 となる。5 つしかないと、vLLM は同期のたびに、まだ rollout が進行中のポリシーを 1 つ黙って追い出す。
# --expose 8000                       reachable at https://<job_id>--8000.hf.jobs
# -v ...:/lora:ro                     read-only: the server only reads adapters
# VLLM_ALLOW_RUNTIME_LORA_UPDATING=1  enables /v1/load_lora_adapter
# VLLM_SERVER_DEV_MODE=1              enables /pause, /resume, /server_info (TRL needs all three)
# --max-loras 6                       max_staleness=4 -> 4+2 adapter slots
for replica in 1 2; do
hf jobs run --detach --flavor h200 --timeout 8h --secrets HF_TOKEN \
    --expose 8000 \
    -v "hf://buckets/${BUCKET}:/lora:ro" \
    -e VLLM_ALLOW_RUNTIME_LORA_UPDATING=1 \
    -e VLLM_SERVER_DEV_MODE=1 \
    -- vllm/vllm-openai:v0.27.1 \
    vllm serve Qwen/Qwen2.5-Math-1.5B --host 0.0.0.0 --port 8000 \
        --max-model-len 4096 --logprobs-mode processed_logprobs --generation-config vllm \
        --enable-lora --max-lora-rank 1 --max-loras 6
done
vLLM は v0.27.1 に固定している。vLLM のイテレーションは速く、上記のフラグとランタイム LoRA インターフェースはこのバージョンが提供するものなので、バージョン番号は設計の一部として扱うべきだ。
別の設計もありえた。トレーナーが最新のアダプタだけを保持し、常に同じ名前で公開するやり方だ。採用しなかったのは、vLLM のプレフィックスキャッシュがアダプタ名でインデックスされるからだ。名前が 1 つだけだと、重みを差し替える前に計算した KV block が差し替え後もヒットし、prefill が再計算されない。その結果、1 回の rollout のプレフィックスが前のポリシーバージョン由来で、decode は次のバージョン由来、ということが起こりうる。トレーナーからはまったく見えず、ratio が徐々に 1 からずれる形で現れるだけだ。バージョン付きの名前ならこれが起こりえない。1 つの名前は常に 1 組の重みに対応し、キャッシュされたプレフィックスがより新しいバージョンにマッチすることはない。
データセットの選択:Sanity set
選んだのは sail/Sanity-Test-R1D-1.5B、Defeating the Training-Inference Mismatch via FP16(Qi ら、2025)が使ったデータセットだ。再現コードは sail-sg/Precision-RL にある。
著者らは DeepSeek-R1-Distill-Qwen-1.5B で MATH の各問題につき 40 個の解答を生成し、成功率が 20% から 80% の間にある問題だけを残して、最終的に 1,460 問を得た。このデータセットは RL の検証にうってつけだ。これらの問題に対して、このモデルはすでに解けるわけでも、まったく歯が立たないわけでもない。だからモデルは序盤から良い訓練信号を得て、伸び続けられる。
エンドツーエンドのテストとしても理想的だ。もしどこかの vLLM レプリカが、アダプタの名前で base model を黙って配信していたら、数十ステップのうちに曲線から見えてほしい。しかもこのデータセットは十分小さく、1 周を 2 時間足らずで回せる。
ハイパーパラメータも論文の oat/scripts/lora にある LoRA スクリプトから取っている。Qwen/Qwen2.5-Math-1.5B、LoRA rank 1、alpha 2、学習率 4e-5、プロンプトあたり 8 サンプル、1 ステップあたり 128 completion、最大生成 3,000 token、コンテキスト 4,096 token。
トレーナー
トレーナーは同じ vllm/vllm-openai:v0.27.1 イメージを使い、その上に TRL をインストールしている。当時は PR ブランチを動かしていた。同じコードは今では TRL v1.14 に入っている。トレーニングスクリプトは普通の AsyncGRPOTrainer スクリプトで、Job に関係する値は出力ディレクトリとサーバー URL だけだ。
from peft import LoraConfig
from trl.experimental.async_grpo import AsyncGRPOConfig, AsyncGRPOTrainer

config = AsyncGRPOConfig(
    output_dir="/lora/sanity-lora-r1",       # on the bucket: adapters, checkpoints and the final adapter all land here
    vllm_server_base_url="http://localhost:8000",   # the proxy, not a vLLM Job; TRL never sees the Jobs URLs
    max_staleness=4,
    weight_sync_steps=4,                     # publish an adapter every 4 optimizer steps
    save_strategy="steps", save_steps=50,    # checkpoints go to the same bucket -> resume after preemption
    ...
)
trainer = AsyncGRPOTrainer(
    model="Qwen/Qwen2.5-Math-1.5B",
    args=config,
    peft_config=LoraConfig(r=1, lora_alpha=2, target_modules="all-linear"),  # plain LoRA vLLM can serve as-is
    ...
)プロキシ
ここからが面白い部分だ。トレーナーと vLLM Jobs の間にプロキシを挟む必要がある。理由は二つある。
-
公開されている Job のポートは、すべてのリクエストに
Authorization: Bearer <HF token>ヘッダーを要求する。プロキシはまさにこのヘッダーを付ける場所であり、TRL はその存在を知らなくて済む。 -
生成に複数の GPU を使いたい。単一の vLLM サーバーでは、通常
--data-parallel-size > 1を使うが、TRL はこのモードでのアダプターのみの同期を拒否する。理由はもっともで、/v1/load_lora_adapterを呼び出しても応答した DP rank にしか届かず、他の rank は新しいポリシー名でベースモデルを提供し続けるからだ。Jobs では各レプリカが独立したマシンなので、この問題はそもそも存在しない。したがってデータ並列は一段上に上げ、アダプターのロードを各レプリカに配るコンポーネントに持たせる必要がある。
そこでトレーナー Job の 127.0.0.1:8000 上で小さなプロキシを動かし、TRL を単一の vLLM サーバーに向けるのと同じようにそこへ向ける。ヘッダーの付与以外に、プロキシは機能的に二つのことをする。
- 各補完リクエストを一つのレプリカへ送る。レプリカの選択基準は、ある prompt の 8 回の rollout が、そのプレフィックスがすでにキャッシュされている場所に収まるようにすることだ(詳細は後述)。
- アダプターのロード、一時停止、再開など、状態を変えるリクエストはすべてのレプリカへブロードキャストする。こうすることで、同じポリシー名がどこでも同じものを指すようになる。
KV プレフィックスによる rollout のルーティング
なぜこれが重要かを簡単に振り返る。補完の生成は二つのフェーズに分かれ、ワークロードの性質が大きく異なる。
- prefill はprompt 全体を一度に処理し、prompt の各トークンについて attention の key と value を計算する。
- 続く decode フェーズはトークンを一つずつ生成し、新しい各トークンはそれより前のすべてのトークンの key と value に注目する。
この key と value が KV cache だ。attention は因果的なので、あるトークンの KV はそれより前のトークンだけに依存し、後ろの内容には関係しない。つまり同じプレフィックスを共有する二つのリクエストはそのプレフィックスの KV を共有し、そのプレフィックスのコピーをすでにキャッシュに持つレプリカはこの部分の prefill を完全にスキップできる。あとはそのレプリカを見つけ、プレフィックスをすでに見たレプリカにリクエストを落として恩恵を受けるだけだ。
vLLM はプレフィックス KV cacheを 16 トークンごとのブロック単位で保存する。GRPO により、rollout worker は同じ prompt を使う G 個のリクエストを発行する(今回のケースでは G=8 個)。すべてが同じレプリカに落ちれば、最初のリクエストが prefill を済ませ、残り七つはそのまま再利用する。ラウンドロビンでルーティングすると、半分のリクエストはそのプレフィックスをキャッシュしていないレプリカに当たり、その四つは prefill をやり直すことになり、貴重な GPU 計算を無駄にする。
私たちの router がやることは、どのレプリカがどのブロックハッシュを見たかを記録することだ。ここで重要な細部がある。ハッシュは連鎖するので、第 3 ブロックのハッシュは第 1、2、3 ブロックを表し、第 3 ブロックだけを表すのではない。これは因果的 attention と一致する。第 3 ブロックの KV が有効なのは、第 1、2 ブロックも同じときだけだ。さらにアダプター名を連鎖のシードにしている。KV cache はそれを生成したアダプターにも依存するからだ。policy v3 のためにキャッシュされたプレフィックスは、policy v4 には何の役にも立たない。
二つの prompt、四つのリクエスト、二つのレプリカ上でのルーティング判断:16 トークンのブロック、連鎖ハッシュ、共通プレフィックス、一度のアフィニティヒット、一度のオーバーフロー。
動画ではレプリカを選ぶ判断プロセス全体を実演している。以下の手順では、実際の 135 トークンの補完リクエスト(Sanity データセットの質問)を例に使う。
1. prompt をブロックに切る。 router は token id を受け取ると、vLLM と同じように 16 トークンごとに切る。ハッシュ化するのは完全なブロックだけなので、最後の 7 トークンはここでは無視される。
2. プレフィックスをハッシュ化する。 各ブロックは前のハッシュと一緒に計算され、起点はアダプターのシードだ。したがって h3 は第 1、2、3 ブロックを順に識別する。最初の k ブロックが同じ二つの prompt は、hk までハッシュが一致する。あるブロックが変われば、それ以降のハッシュはすべて変わる。アダプター名をハッシュのシードにしているのはこのためだ。同じ prompt でも trl-policy-v4 では別のシードから始まり、v3 のエントリとは一致しない。古い KV ブロックは別の重みで計算されているのだから、これは望ましい挙動だ。
3. 二つの prompt を比較する。 問題 1 は 103 トークンある。どちらの prompt も同じ 23 トークンのチャットテンプレートで始まる。最初のブロックは完全に同じだが、二番目のブロックにはすでに問題文が含まれている。ハッシュはそこから分岐する。
4. 記録の帰属。 ハッシュごとに、ルーターはどのレプリカがそれを処理したか、そしてその後にどのハッシュが続くか(後続集合は最大 2 つ。あるブロックの後に続きが 1 つか複数かだけ分かればよい)を記憶する。いくつかの prompt を経た後、テンプレートブロック h1 は両方のレプリカに帰属し、後続も複数ある。h2 から h8 は A だけに帰属し、それぞれ後続は 1 つ。h2' から h6' は B だけに帰属する。
実際には、1 回の実行におけるすべての prompt が同じトークンで始まる。ここではチャットテンプレートとシステムプロンプトで、1,460 問すべての先頭 23 トークンを構成する。agent の場面ならツール記述、マルチターンなら共有の会話履歴がこれにあたる。これらのブロックは数秒で各レプリカのキャッシュに入るので、これらで一致を見ても、ある prompt がどこにあるかは分からない。
あるブロックをすべてのレプリカが処理した場合、あるいは後続が複数ある場合、それは共通ブロックだ。ルーティングでは共通ブロックを無視する。特定の prompt を識別できないからだ。詳しくは後述する。
5. レプリカを選ぶ。 ルーターは各レプリカで先頭ブロックがいくつ一致したかを数え、共通プレフィックスを除く。残りがその prompt 固有のブロック数だ。そして:
- あるレプリカに固有ブロックがあり、かつそれが圧迫されていなければ——つまり負荷が最も低いレプリカを 8 リクエスト以上は上回っていなければ——リクエストはそこへ送られる。これを affinity ヒットと呼ぶ。
- 固有ブロックはあるが 8 リクエストを超えて先行しているなら、キャッシュは諦め、負荷が最も低いレプリカへ送る。これを spill と呼ぶ。
- どのレプリカにも固有ブロックがなければ、それは新しい prompt だ。負荷が最も低いレプリカへ送り、同点ならラウンドロビンで選ぶ。これを unmatched と呼ぶ。
以下は 4 つのリクエストにこの規則を順に適用したものだ。初期状態:レプリカ A と B はそれぞれ 3 リクエストが処理中で、どちらもテンプレートブロック h1 しか認識していない。
- リクエスト 1、problem 0、rollout 1。 両レプリカとも一致するブロックはテンプレート 1 つだけで、これは共通ブロックだ。よって固有ブロックは 1 つも一致しない。リクエストは unmatched で、両レプリカの負荷は同じなので、ラウンドロビンで A に送られる。ルーターは
h2からh8を A のものとして記録する。A は処理中が 4 リクエストになる。 - リクエスト 2、problem 0、rollout 2。 同じ prompt。A は 8 ブロックすべてに一致し、B はテンプレートだけに一致する。その共通ブロック 1 つを除くと、A には固有ブロックが 7 つ、B には 1 つもない。A は B より 1 リクエスト多いだけで、上限 8 に遠く及ばない。よってリクエストは A に送られる。affinity ヒットだ。A の KV cache にはすでに prompt 全体がある。
- リクエスト 3、problem 1、rollout 1。 新しい prompt。両レプリカともテンプレートブロックにしか一致せず、固有ブロックは一致しない。リクエストは unmatched で、負荷が低い方の B に送られる——B は処理中 3、A は 5。ルーターは
h2'からh6'を B のものとして記録する。 - リクエスト 4、problem 0、rollout 9。 この時点で A は処理中 12 リクエスト、B は 3 に戻っているとする。A は依然として固有ブロック 7 つを持つが、B より 9 リクエスト多く、上限を超えている。リクエストは B へ spill する。B は problem 0 の prefill を 1 回行い、ルーターは
h2からh8も B のものとして記録する。これで両レプリカがこれらのブロックを処理したことになり、problem 0 も共通ブロックになる。以降の rollout は負荷だけで振り分けられる。
6. prefill を再利用する。 リクエスト 2 こそがこの仕組み全体の目的だ。リクエスト 1 が計算した prefill を再利用する。ブロック 1 から 8 はすでに A の KV cache にあり、A はそのまま completion のデコードへ進む。B に送っていれば、B は 135 トークンすべてを prefill し直し、A の cache は遊んでいた。リクエスト 3 は common の規則がなぜ要るかを示す。これがなければ、共有の chat template のせいで新しい prompt がすべてキャッシュヒットに見えてしまう。リクエスト 4 は負荷を有界に保つ。prefill 1 回の節約のために、あるレプリカを大きく遅らせる価値はない。
def choose(self, upstreams, model, prompt):
    hashes = self.block_hashes(model, prompt)         # chained blake2b over 16-token blocks, seeded with `model`
    matched = self.matched_prefix(hashes)             # per replica: leading blocks it has served
    common = self.common_prefix_len(hashes)           # leading blocks that identify no prompt (see below)
    specific = [max(0, m - common) for m in matched]  # what actually distinguishes replicas
    least = min(u.inflight for u in upstreams)
    best = max(range(self.n), key=lambda i: (specific[i], -upstreams[i].inflight))

    if specific[best] > 0 and upstreams[best].inflight - least <= self.cfg.imbalance:
        pick = best                                   # affinity: the replica that has this prompt, and is not swamped
    else:
        candidates = [i for i in range(self.n) if upstreams[i].inflight == least]
        pick = candidates[self.rr % len(candidates)]  # spill or new prompt: least-loaded, round robin on ties
        self.rr += 1
    ...record `pick` as an owner of every block, and each block's successor...
    return upstreams[pick]
common プレフィックスが最も厄介な部分だ。どのリクエストも同じ system prompt と chat template で始まる。単純な longest-prefix match だけなら、最初の replica がほぼすべての新しい prompt でヒットしてしまう。そこで fan-out を使って共有プレフィックスを識別する。ある block に異なる後続が複数あるのはよくあることで、常に同じ後続へ向かう block は特定の prompt に属する。affinity として数えるのは共有プレフィックスより後ろの block だけだ。
adapter のブロードキャスト
proxy は adapter のロードを各 replica にブロードキャストする必要もある。この操作は all-or-nothing として扱う。replica ごとに bucket mount が異なるため、新しい adapter が見えるタイミングも揃うとは限らない。No adapter found for <path> エラーは通常、どこかの bucket mount がまだ追いついていないことを意味するので、その replica だけをリトライする。それ以外のエラーでは、その adapter をすでに受け入れた replica からアンロードする。こうすれば、ある policy 名が一部の replica にしか存在しないという状態は起きない。
async def load_one(u):
    while True:
        status, _, out = await send(u, "POST", "/v1/load_lora_adapter", headers, body)
        if status == 200 or "No adapter found" not in out.decode() or time.monotonic() > deadline:
            return u, status, out
        await asyncio.sleep(cfg.lora_retry_s)          # this replica's mount has not seen the directory yet

results = await asyncio.gather(*(load_one(u) for u in ups))
if any(st != 200 for _, st, _ in results):
    await asyncio.gather(*(send(u, "POST", "/v1/unload_lora_adapter", headers, unload) for u, st, _ in results if st == 200))
    return web.Response(status=504 if timed_out else st, text="rolled back on the others")
同じやり方で /pause、/resume、/v1/unload_lora_adapter もブロードキャストする。/health は全 replica が健全なときだけ 200 を返す。/server_info と /v1/models は 1 台の応答で足りる。TRL から見れば proxy はただの data_parallel_size=1 server なので、adapter-only sync を選ぶ。
Python asyncio で書いた proxy がボトルネックになるのではと最初は心配した。ならない(少なくともこの規模では)。同時に飛ぶ非ストリーミング JSON リクエストは最大 128 で、ルーティングはハッシュをいくつか計算するだけ。1 スレッドで余裕でさばける。より細かいルーターで更大的流量をさばくなら、たぶんもっと速い言語で書くことになるだろう(見てるぞ 🦀)。
実行結果の全体
以下の数字は trainer が trackio に 記録した metrics から取っている。この実行では Qwen/Qwen2.5-Math-1.5B、all-linear 上の LoRA r=1 を使い、1 ステップあたり 128 completion、1 prompt あたり 8 rollout。500 ステップ走らせ、50 ステップごとに checkpoint を保存。trainer は h200x2 Job を 1 つ、2 つの vLLM replica はそれぞれ h200 Job を 1 つ使う。3 つを同時に動かして 1 時間あたり約 $20。
重みの同期
| 1 同期あたり、trainer クロック、計 126 同期 | 以前 | 現在(p50) |
|---|---|---|
| 同期全体 | 30.8 s | 8.5 s(最小 6.6、最大 9.2) |
| うち:2 replica の一時停止 | 0.3 s | 0.3 s |
| adapter の all-gather と bucket への保存 | 0.6 s | 1.1 s |
| 2 replica が adapter を受け入れる | ~29 s | ~7 s |
252 回の adapter ロードがすべて成功 🎉:126 同期 × 2 レプリカ。うち 6 回は 2 回目の試行で成功し、246 回は 3 回目で成功した。
ルーティング
実行終了時、64,728 回の rollout を経て proxy のカウンターはこうなっていた:
routed [31928, 32800] affinity 54712 spilled 820 unmatched 9196
1 prompt に 8 rollout なら、8 リクエストのうち少なくとも 1 つは必ずコールドスタートになる。理論上の下限は 12.5%。ルーターは 14.2% が未マッチ、84.5% がアフィニティヒット、1.3% がオーバーフローだった。実際に計測した負荷に基づく、より深い推論側の指標で各レプリカの負荷を見るようになるまでは、ここに最適化の余地はほとんどない。
時間はどこに消えているか
最初の構成には明らかな問題があった。ボトルネックは生成ではなく trainer だった。500 ステップで:
| 1 optimizer step あたり、p50 | |
|---|---|
| step | 22.9 s |
| forward + backward | 21.9 s |
| rollout の待ち | 0.02 s |
| rollout キューの占有 | 512 中 476 |
| trainer MFU | 3.9% |
rollout キューは常に満杯で、worker はほとんどの時間をバックプレッシャーで塞がれていた。この構成では 2 つ目のレプリカはほぼ無意味。後の章で、一連の実行を通じてボトルネックを訓練と生成の間で行き来させ、最終的に実行を 3.9 倍速くした話が出てくる。
報酬
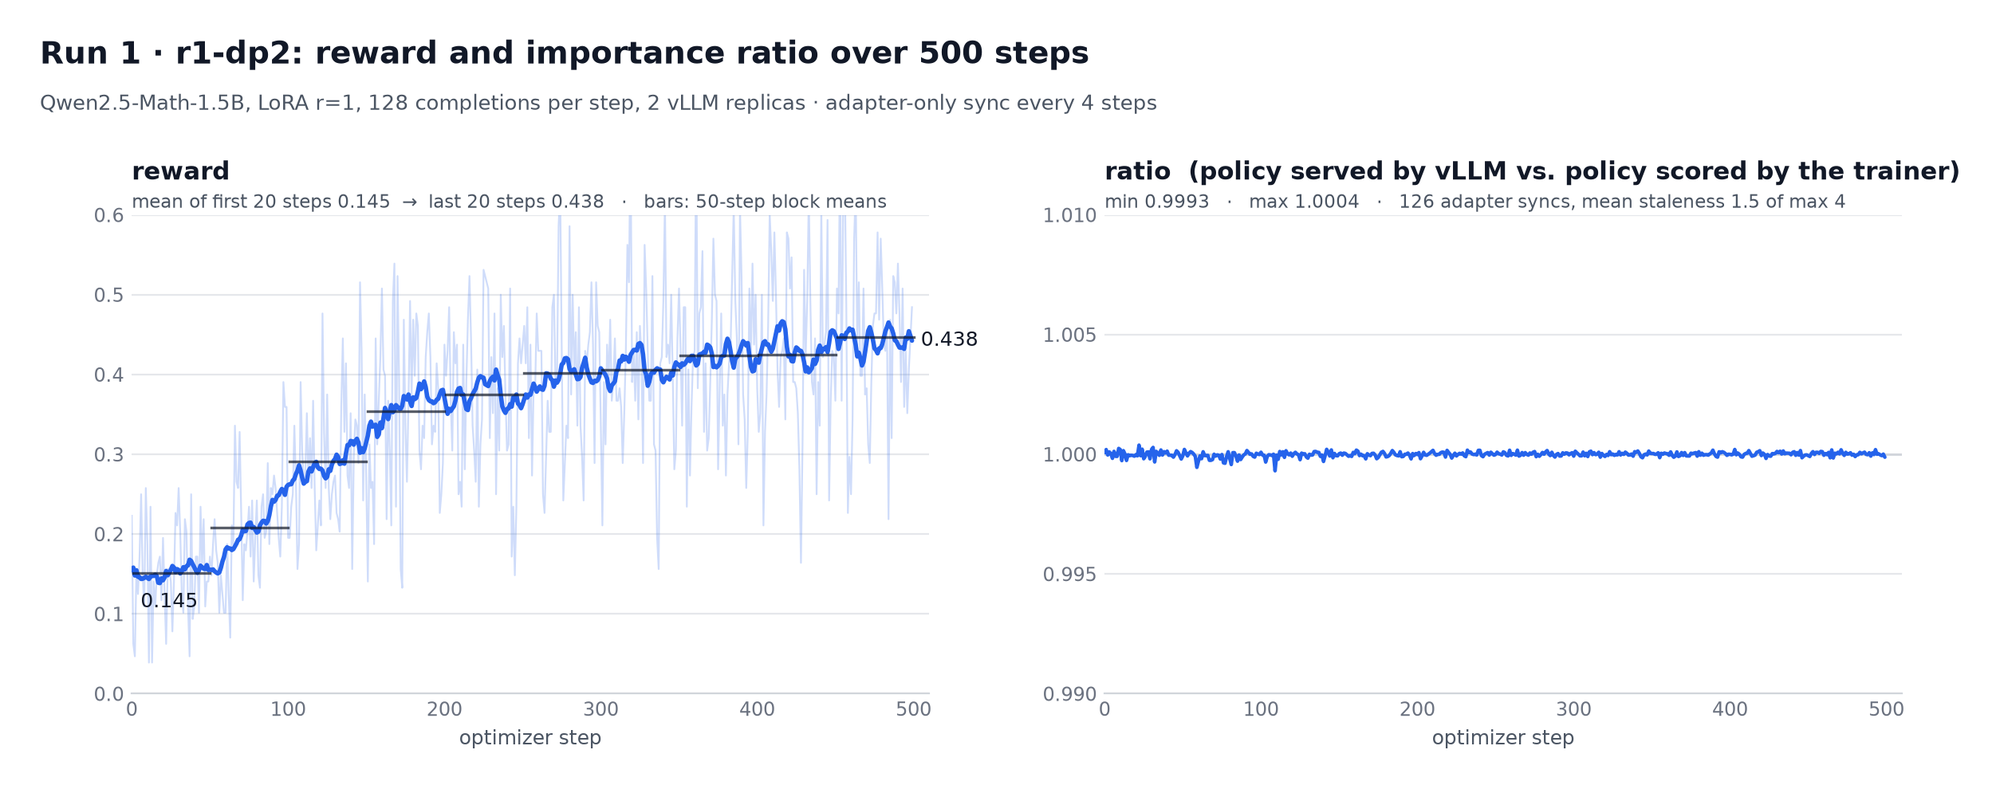
図 1。trackio 実行 r1-dp2。パネル:reward とその 20 ステップ移動平均および 50 ステップ区間平均、そして ratio(軸は 0.99 から 1.01)。報酬は 500 ステップで 0.15 から 0.44 へ上昇;ratio は終始 0.9993 から 1.0004 の間に収まっている。
500 ステップに 3 時間 27 分。平均報酬は最初の 20 ステップの 0.145 から最後の 20 ステップの 0.438 へ上昇した。このテストでより重要なのは、ratio が毎ステップ 1.000 を保ったことだ! vLLM がサービングするポリシーは、trainer が rollout を採点するのに使うポリシーと常に一致していた。これは 126 回の同期すべてで成り立った。平均 staleness は 1.5 ポリシーバージョン、上限は 4。trackio ダッシュボード に完全な曲線がある。
LoRA AsyncGRPO が確かに動くという鉄証が得られた! 次は最近の詳細な AsyncGRPO 指標を見て、訓練実行をどう改善するかを考える。
ボトルネックを巡るピンポン
非同期 RL は訓練と生成の間のパイプラインだ。片側だけ速くしても、もう片側が追いつかなければ無駄になる。幸い AsyncGRPOTrainer には十分なタイミングと指標が入っていて、この問題が直接見えるようになった。
役に立つ指標は Logged metrics の節に書いてある。perf/rollout_wait_s は trainer がサンプルをどれだけ待ったかを教えてくれる。rollout/backpressure_s は生成側が rollout キューの空きをどれだけ待ったかを教えてくれる。この 2 つは向きが正反対で、同時に高くなることはない。キュー長と組み合わせれば、どちら側が遅いか判断できる。
5 つの実験を回した。どれも前のラウンドで dashboard から見えた問題を出発点にしている。特に断りのない限り、モデル、recipe、3 ジョブのレイアウトは変えていない。以下の名前は trackio の run 名そのままだ。
dashboard の読み方
常にこの 4 組の指標を見ていた。
perf/step_sとperf/fwd_bwd_s:optimizer step にどれだけかかり、そのうち forward+backward がどれだけを占めるか。1 ステップの所要時間がほぼ forward+backward と等しければ、trainer は明らかに計算律速だ。perf/rollout_wait_s:trainer がステップを始める前に、サンプルを待って座っている時間。ほぼゼロなら生成が訓練より先を走っていて、サンプルはいつでも取り出せ、来たものをそのまま訓練に使える。sample/rollout_queue_sizeとqueue_maxsizeの比較:両者の間のバッファ。満杯なら生成が絞られており、空なら trainer が飢えている。rollout/backpressure_sとrollout/score_block_s:rollout worker がバッファ満杯でブロックされた時間。worker は 2 段のパイプラインだ。生成が完成した group をスコアリング段に渡し、スコアリングがスコア済みサンプルを rollout バッファに押し込む。バッファが満杯になるとスコアリング段は enqueue できずブロックする。これがrollout/backpressure_sだ。するとスコアリング段は自分の入力キューを消費しなくなり、生成も次の group を渡せなくなる。これがrollout/score_block_s。どちらも同じ詰まりで、まずスコアリング段に現れ、そこから上流の生成へ伝播する。
診断は単純だ。キューが満杯、rollout wait がゼロ、backpressure が高いなら trainer が遅すぎる。キューが空、rollout wait が上昇、backpressure なしなら生成が遅すぎる。perf/mfu_wall_clock と perf/mfu_fwd_bwd を並べて比べれば、trainer の GPU が訓練ではなく待ちぼうけにどれだけ費やされているかも見えてくる。
1 回目の run、r1-dp2:ペースに追いつけない trainer
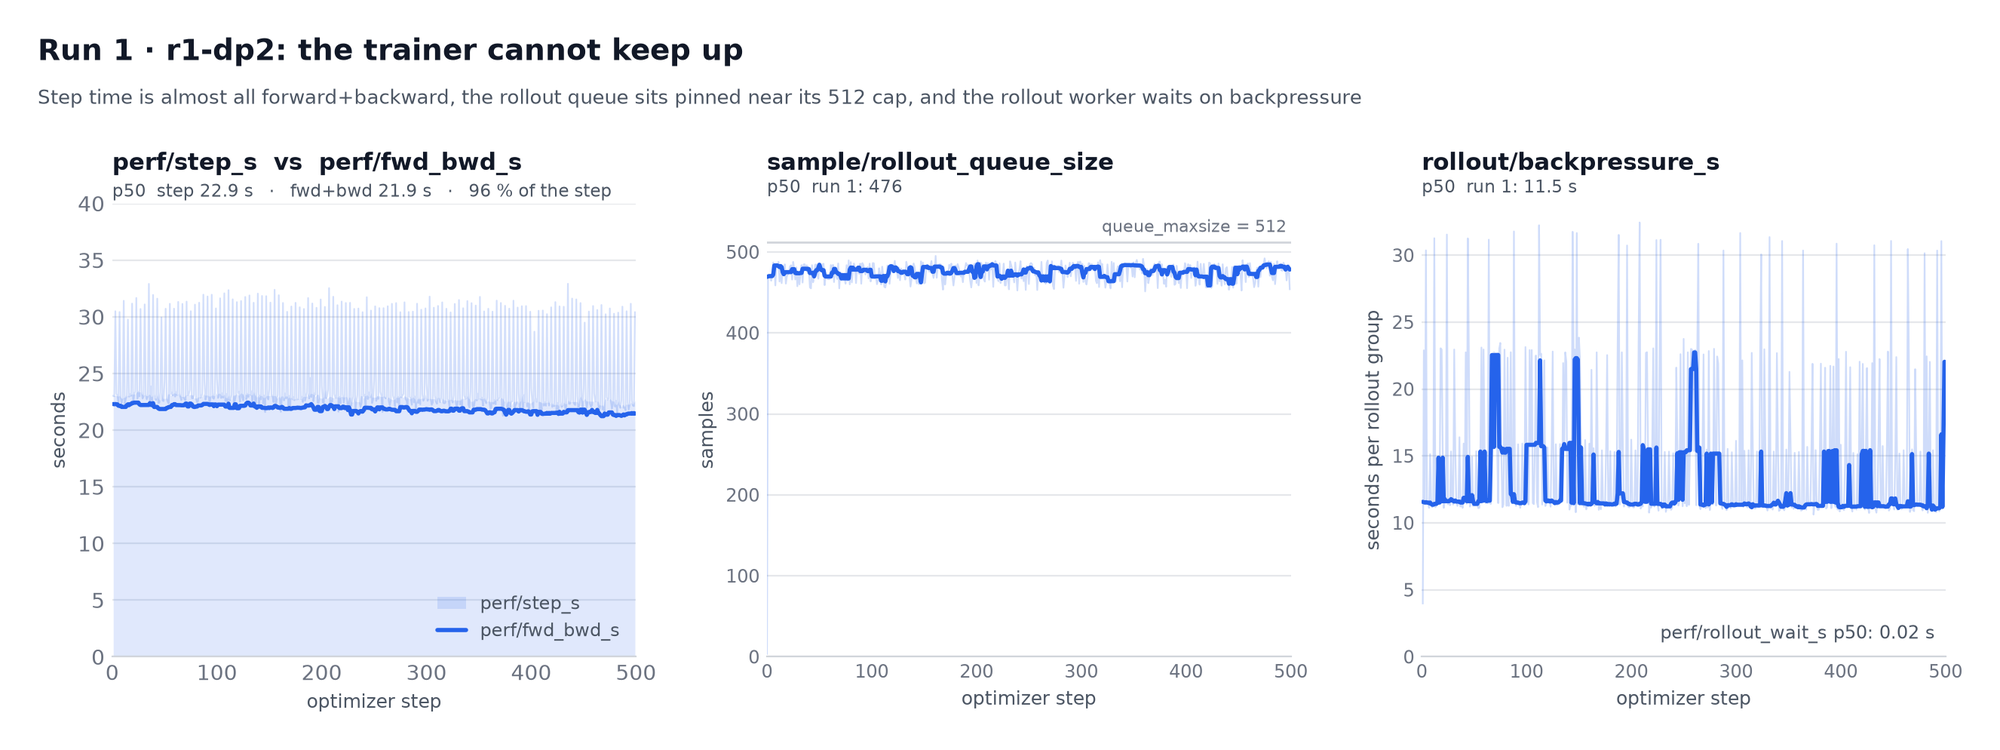
図 2。trackio run r1-dp2。パネル:perf/step_s、perf/fwd_bwd_s、sample/rollout_queue_size、rollout/backpressure_s。ステップ時間と forward+backward がほぼ完全に重なる。キューは 512 のうち 476 あたりで張り付いたまま、backpressure は rollout group あたり 11 秒を下回らない。trainer 律速だ。
perf/step_s は 22.9 秒、perf/fwd_bwd_s は 21.9 秒。forward と backward がステップ時間の 96% を占める。キューは常に満杯で、trainer が rollout を待つのは 0.02 秒だけ、一方 rollout worker は group あたり 15 秒を backpressure でブロックされている。2 つの vLLM レプリカは trainer が消費するより速く生成している。報告された 4.6k tokens/s は実際の上限ではない。出力の置き場所がないだけだ。
バッチ処理の指標が、この 3.9% というお粗末な MFU を説明する。batch/microbatches_per_step は 64、batch/samples_per_row は 1.0。各 rank が約 1.2k token の系列を 1 本処理し、それが 1 ステップに 64 回。これは参照 recipe の per_device_train_batch_size=1 から来ている。H200 上の 1.5B モデルにとって、これは完全にレイテンシ律速だ。
2 回目の run、r1-dp2-tb16k:microbatch をパッキングする
解決策は batch size を変えることではない。optimizer step あたり 128 completion という数を保ったまま、GPU 上での並べ方だけを変えた。microbatch ごとに系列 1 本を入れるのをやめ、複数の系列を各行に稠密にパッキングする。trainer はこれを token-budget batching でサポートしている。token_budget > 0 を設定すると、複数のサンプルを rank ごとに 1 行へ padding なしでパッキングする。1 optimizer step で gradient_accumulation_steps 行を処理する。token_budget=16384 と gradient_accumulation_steps=6 を設定した。
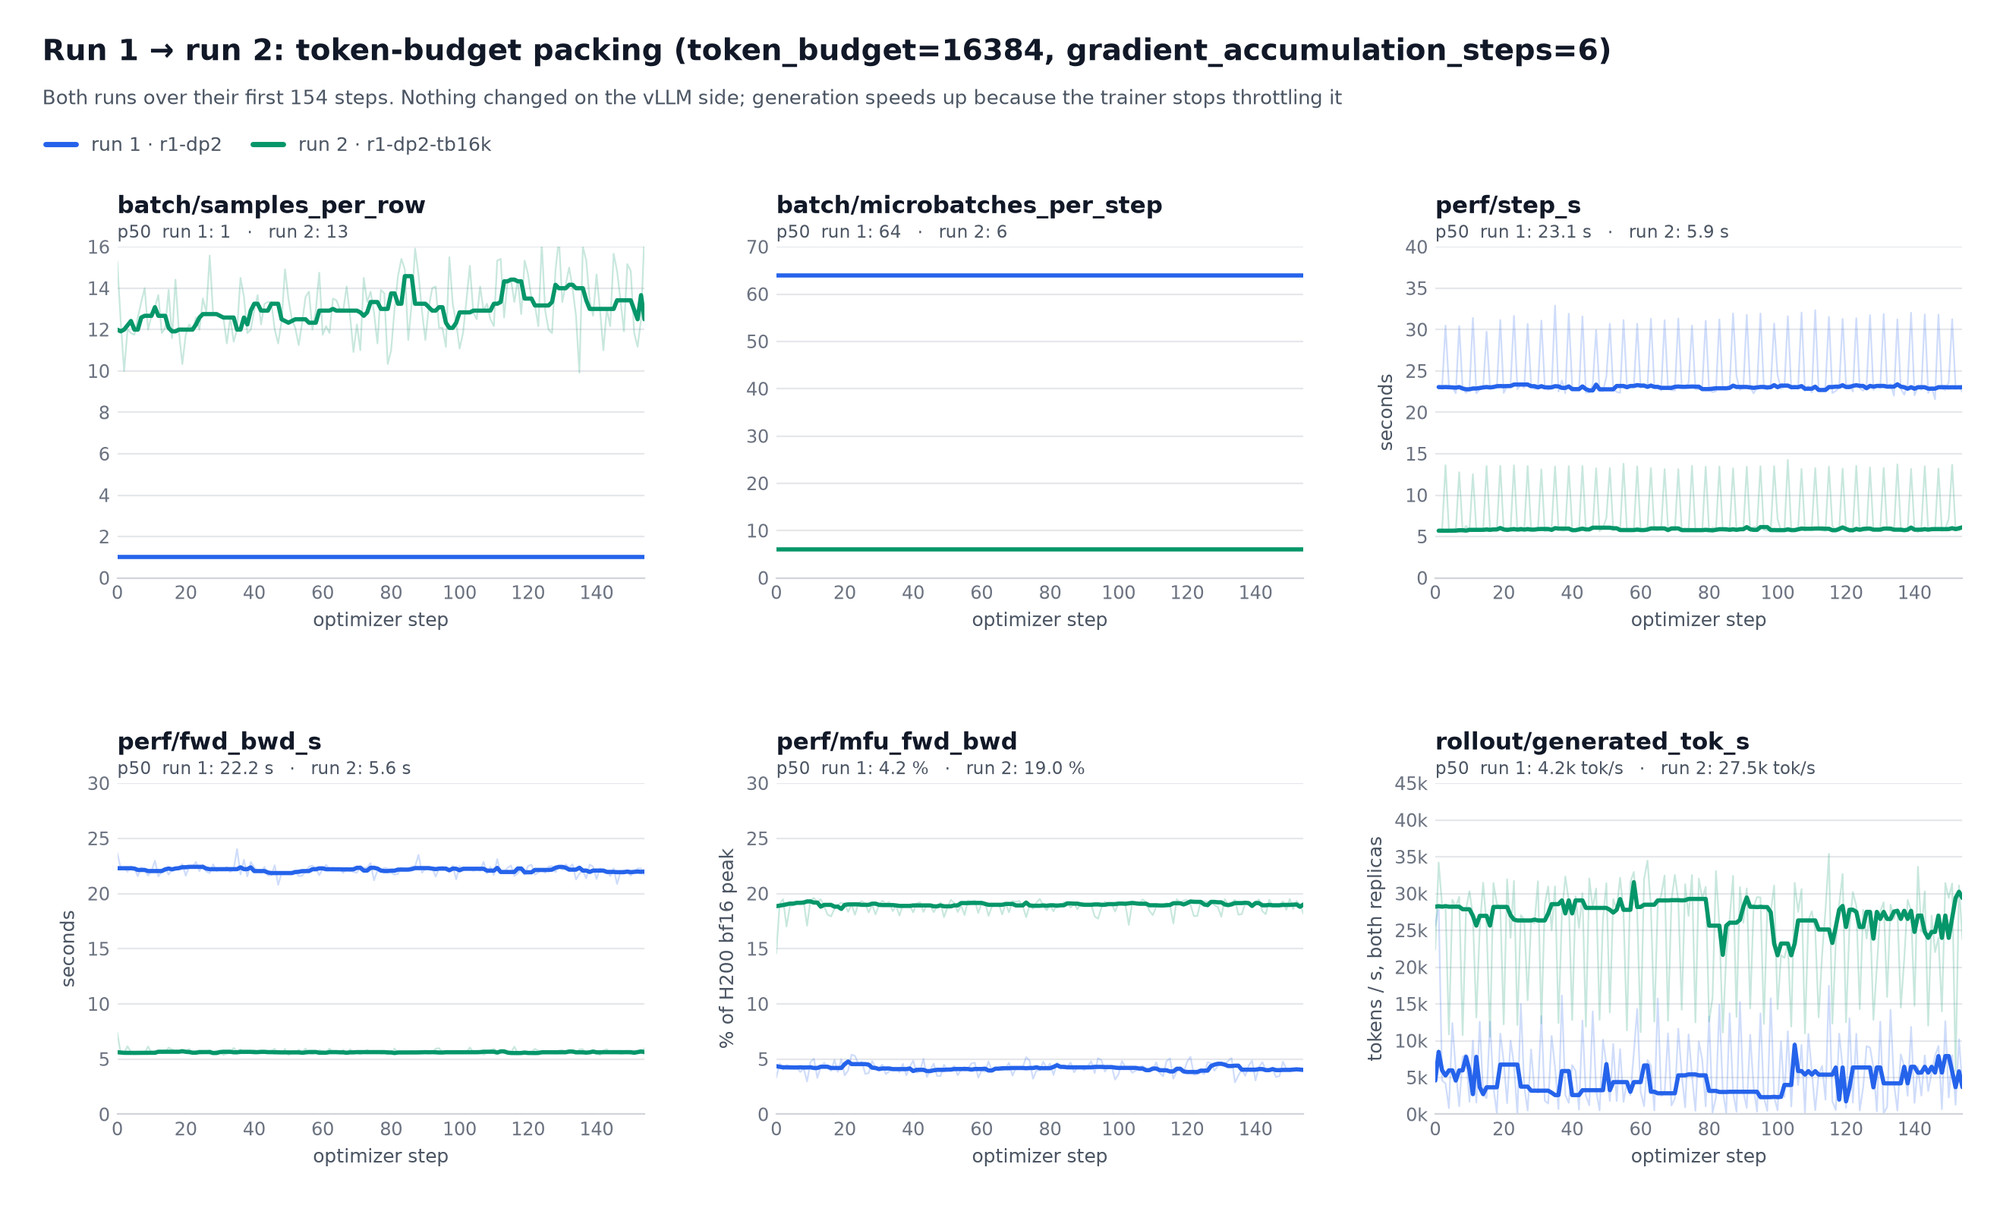
図 3。trackio run r1-dp2 と r1-dp2-tb16k をそれぞれ最初の 154 ステップまで重ねて表示。パネル:batch/samples_per_row、batch/microbatches_per_step、perf/step_s、perf/fwd_bwd_s、perf/mfu_fwd_bwd、rollout/generated_tok_s。パッキングで 1 行あたりのサンプル数が 1 から 13 に、microbatch が 64 から 6 に、ステップ時間が 23 秒から 5.9 秒に、生成速度が 4.2k から 27.5k tok/s に増えた。vLLM 側は何も変えていない。
batch/samples_per_row は 1.0 から約 12.7 に上がり、microbatch 数は 64 から 6 に減った。行の充填率は 95% に達した。forward と backward は 21.9 秒から 5.6 秒に縮み、MFU は 3.9% から 19% に上がった。1 ステップあたり約 150 サンプルを訓練している。行のパッキングが平均長の見積もりよりもうまく効いているためだ。
生成速度も 4.6k tokens/s から 25k tokens/s へ跳ね上がった。vLLM 側は何も変えていないのに。キューが常に満杯ではなくなり、レプリカがようやく走り出した。パイプラインの各段を切り離して最適化するのが好きになれない理由がこれだ。システム全体をまとめて評価しないといけない。遅い段が 1 つあると、その上流すべての本当の性能が覆い隠されてしまうから。
Run 3、r1-dp2-tb16k-nockpt:前向き計算を再実行しない
perf/fwd_s は 1.34 秒、perf/fwd_bwd_s は 5.6 秒。通常、逆伝播は前向き計算の約 2 倍の時間がかかり、ベース重みを凍結すればほぼ 1 倍になるはずだ。3.2 という比率は不自然だ。
原因は AsyncGRPOConfig がデフォルトで gradient_checkpointing=True になっていることにある。マイクロバッチごとに逆伝播時に前向き計算をやり直していた。16k token の 1 行が 141 GB の H200 上で 25 GB しか占めないことも、これで説明がつく。このトレーナーにとってはメモリ最適化だが、今回のケースでは不要だった。モデルが十分小さく、活性値を逆伝播用に保持しても VRAM に収まるからだ。
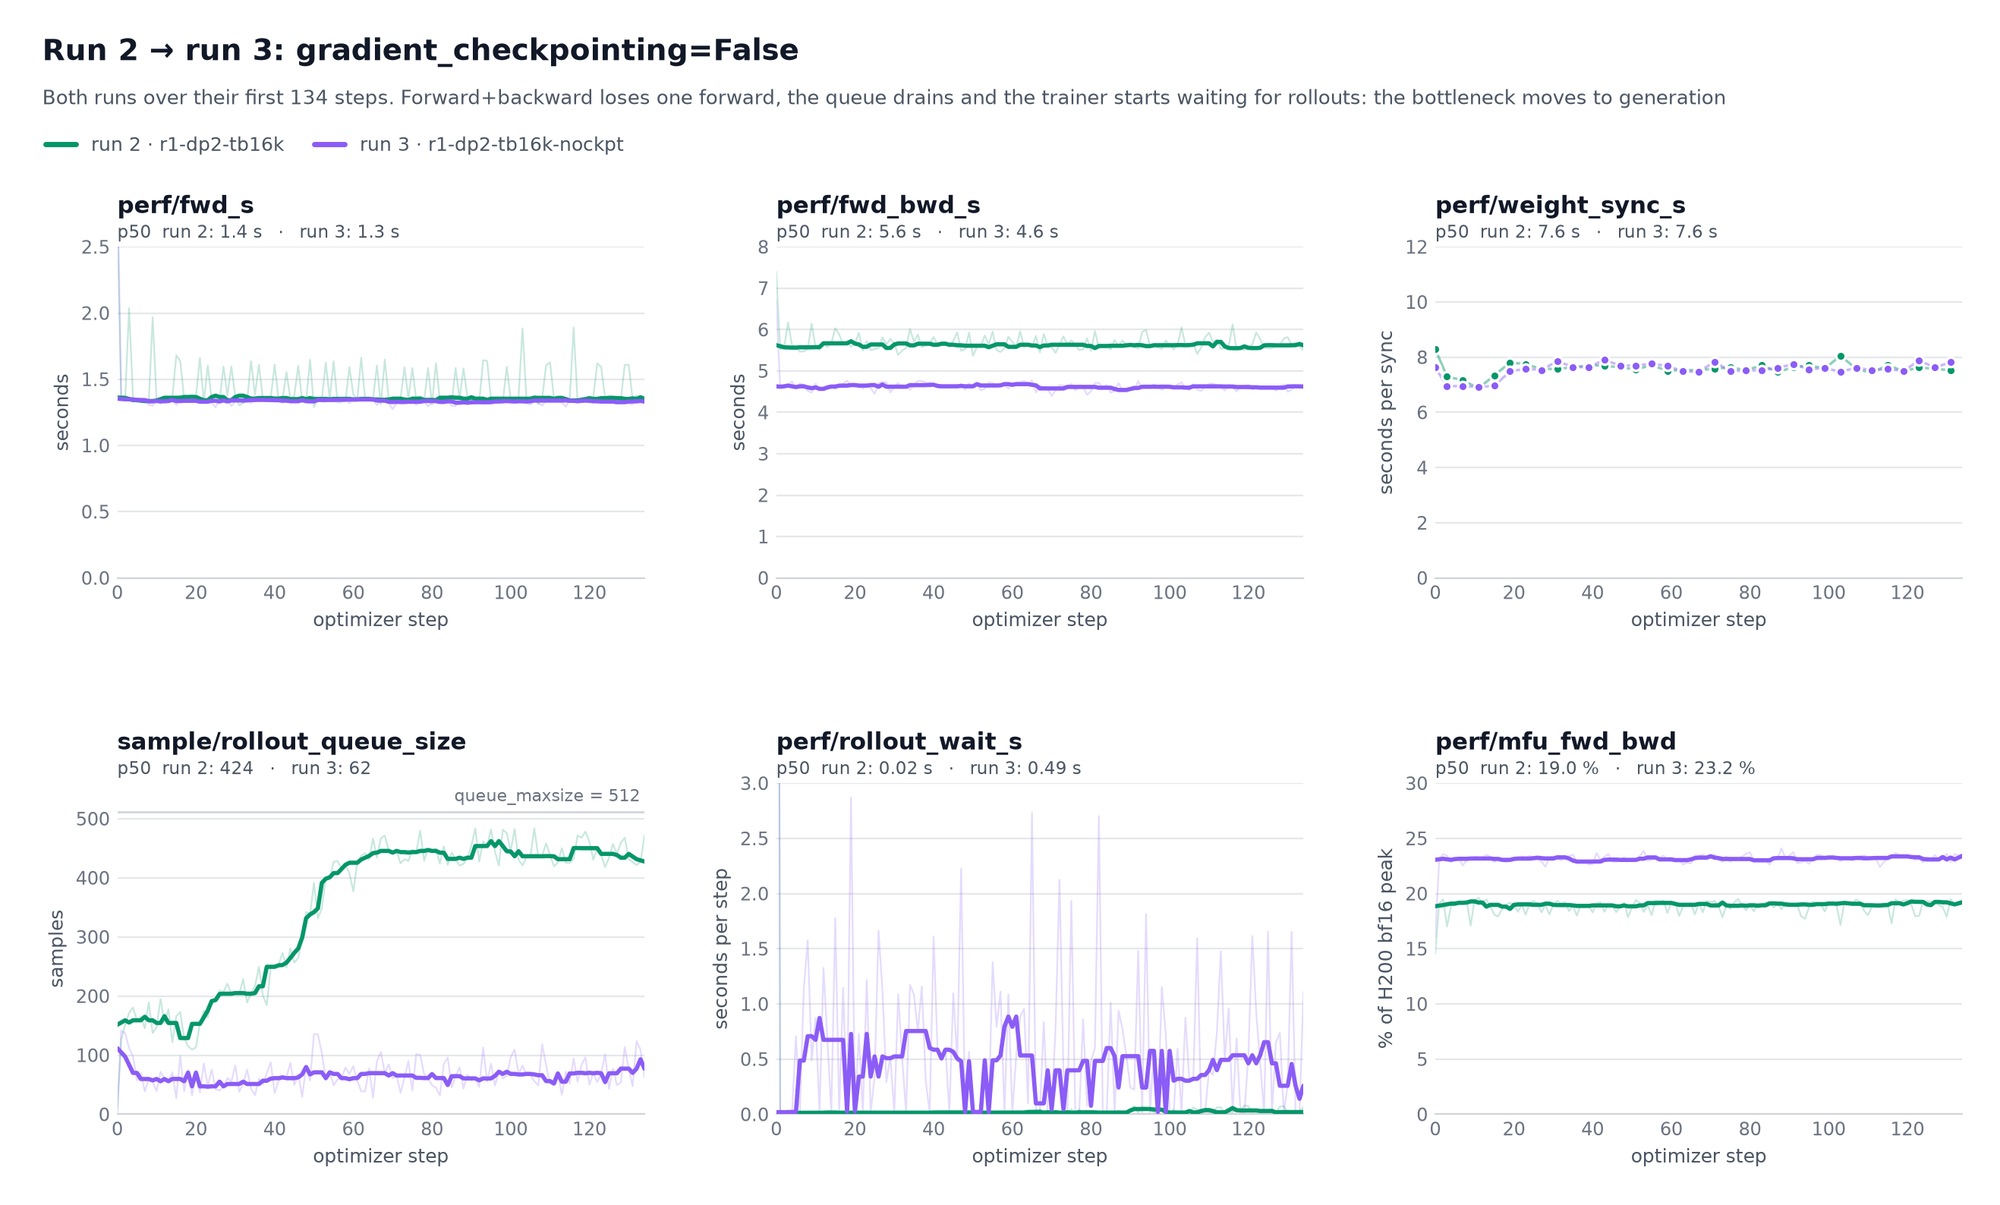
図 4。trackio が r1-dp2-tb16k と r1-dp2-tb16k-nockpt の最初の 134 ステップを重ねて表示。パネルは perf/fwd_s、perf/fwd_bwd_s、perf/weight_sync_s、sample/rollout_queue_size、perf/rollout_wait_s、perf/mfu_fwd_bwd。forward+backward から前向き計算が 1 回減り、キューは約 420 から約 60 に下がり、rollout 待ちは 0.02 秒から 0.5 秒に上昇。ボトルネックが生成側に移った。
gradient_checkpointing=False を有効にすると、forward と backward は 4.6 秒に下がり、ほぼ前向き計算 1 回分の削減に一致する。MFU は 23% に達した。キューは 71 まで下がり、rollout 待ちは 0.04 秒から 0.6 秒に上昇。トレーナーがサンプルを消費する速度が、2 レプリカがサンプルを生成する速度を上回った。ボトルネックを生成側に_移すことに成功_したわけだ。
ここで新たに 2 つのオーバーヘッドが露呈する。4 ステップごとに 1 回、7.6 秒の重み同期が入り、これが壁時計時間の 25% を占めるようになった。以前は 1 ステップ 23 秒だったので 8% に過ぎなかった。もう 1 つ、backward が依然として forward の 2.5 倍遅い。ベース重みが凍結されている以上、1 ステップあたり約 2 秒は通常のモデル計算とは言えない。
Run 4、r1-dp3-tb16k-nockpt:3 レプリカ、そして予想外の結果
生成が遅くなったので、3 つ目のレプリカを追加した。同時にプロキシの adapter リトライ間隔を 2 秒から 0.5 秒に短縮し、fsdp_reshard_after_forward を切って、backward で余分にかかる 2 秒が FSDP2 の re-gather によるものか確かめた。
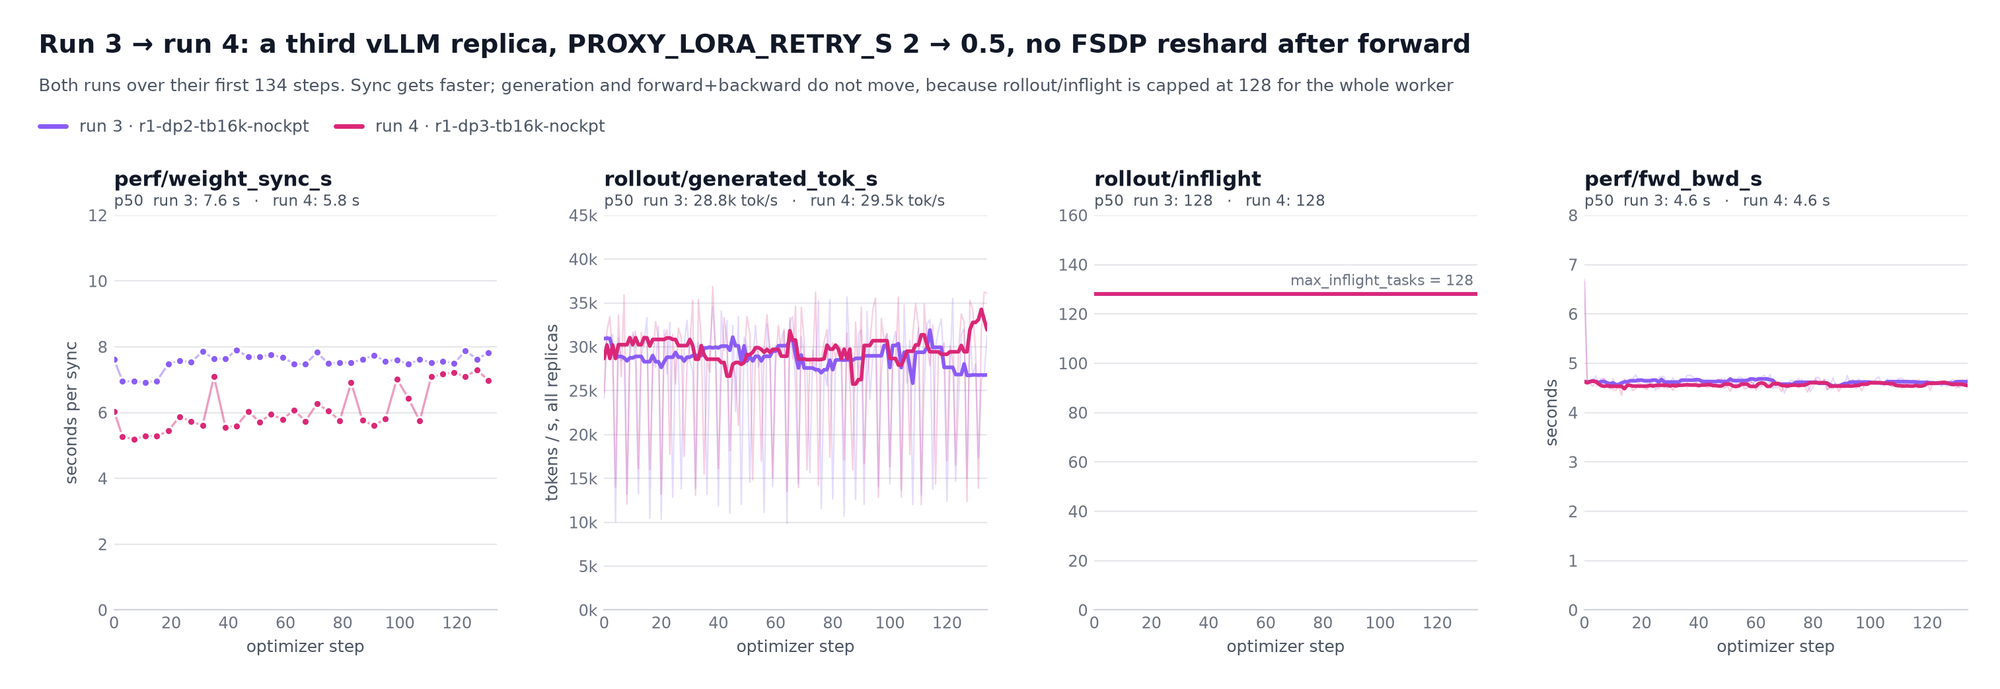
図 5。trackio の r1-dp2-tb16k-nockpt と r1-dp3-tb16k-nockpt の 2 回の実行を最初の 134 ステップで重ねて表示。各パネルは perf/weight_sync_s、rollout/generated_tok_s、rollout/inflight、perf/fwd_bwd_s。重み同期は 7.6 秒から 5.8 秒に短縮。生成と forward+backward は変化なし。両実行とも rollout/inflight は 128 で、これが 3 つ目のレプリカがぶつかった上限そのものだった。
重み同期は 7.6 秒から 5.8 秒に下がり、リトライ短縮は効いた。Forward と backward は 4.6 秒のままで、resharding の疑いは晴れた。生成速度は 25k から 26k tokens/s に上がっただけ。3 つ目のレプリカはほぼ何もしていない。
答えは rollout/inflight にそのまま出ていた。どの実行も 128 だ。プロキシはこれらのリクエストを 3 レプリカに 44 + 43 + 41 で分散していた。max_inflight_tasks が制限しているのは rollout worker 全体の並列数で、レプリカごとではない。1.5B モデルを H200 で動かす場合、43 並列と 130 並列では 1 token あたりのコストがほぼ同じになる。128 リクエストを 3 枚の GPU に分けても、2 枚に分けたときとスループットは変わらない。
つまりボトルネックは vLLM ではなく、自分たちのクライアント側にある定数だった。数百本の長い HTTPS リクエストが公網の Jobs プロキシを通ったときにどうなるか分からなかったので、保守的に設定していた。この時点で 130,000 回の rollout がこのプロキシを通過しており、転送エラーは一度も起きていない。
Run 5、r1-dp3-inflight384:在途リクエスト上限を解放する
max_inflight_tasks=384 と queue_maxsize=768 だけを変更し、他は一切触らない。
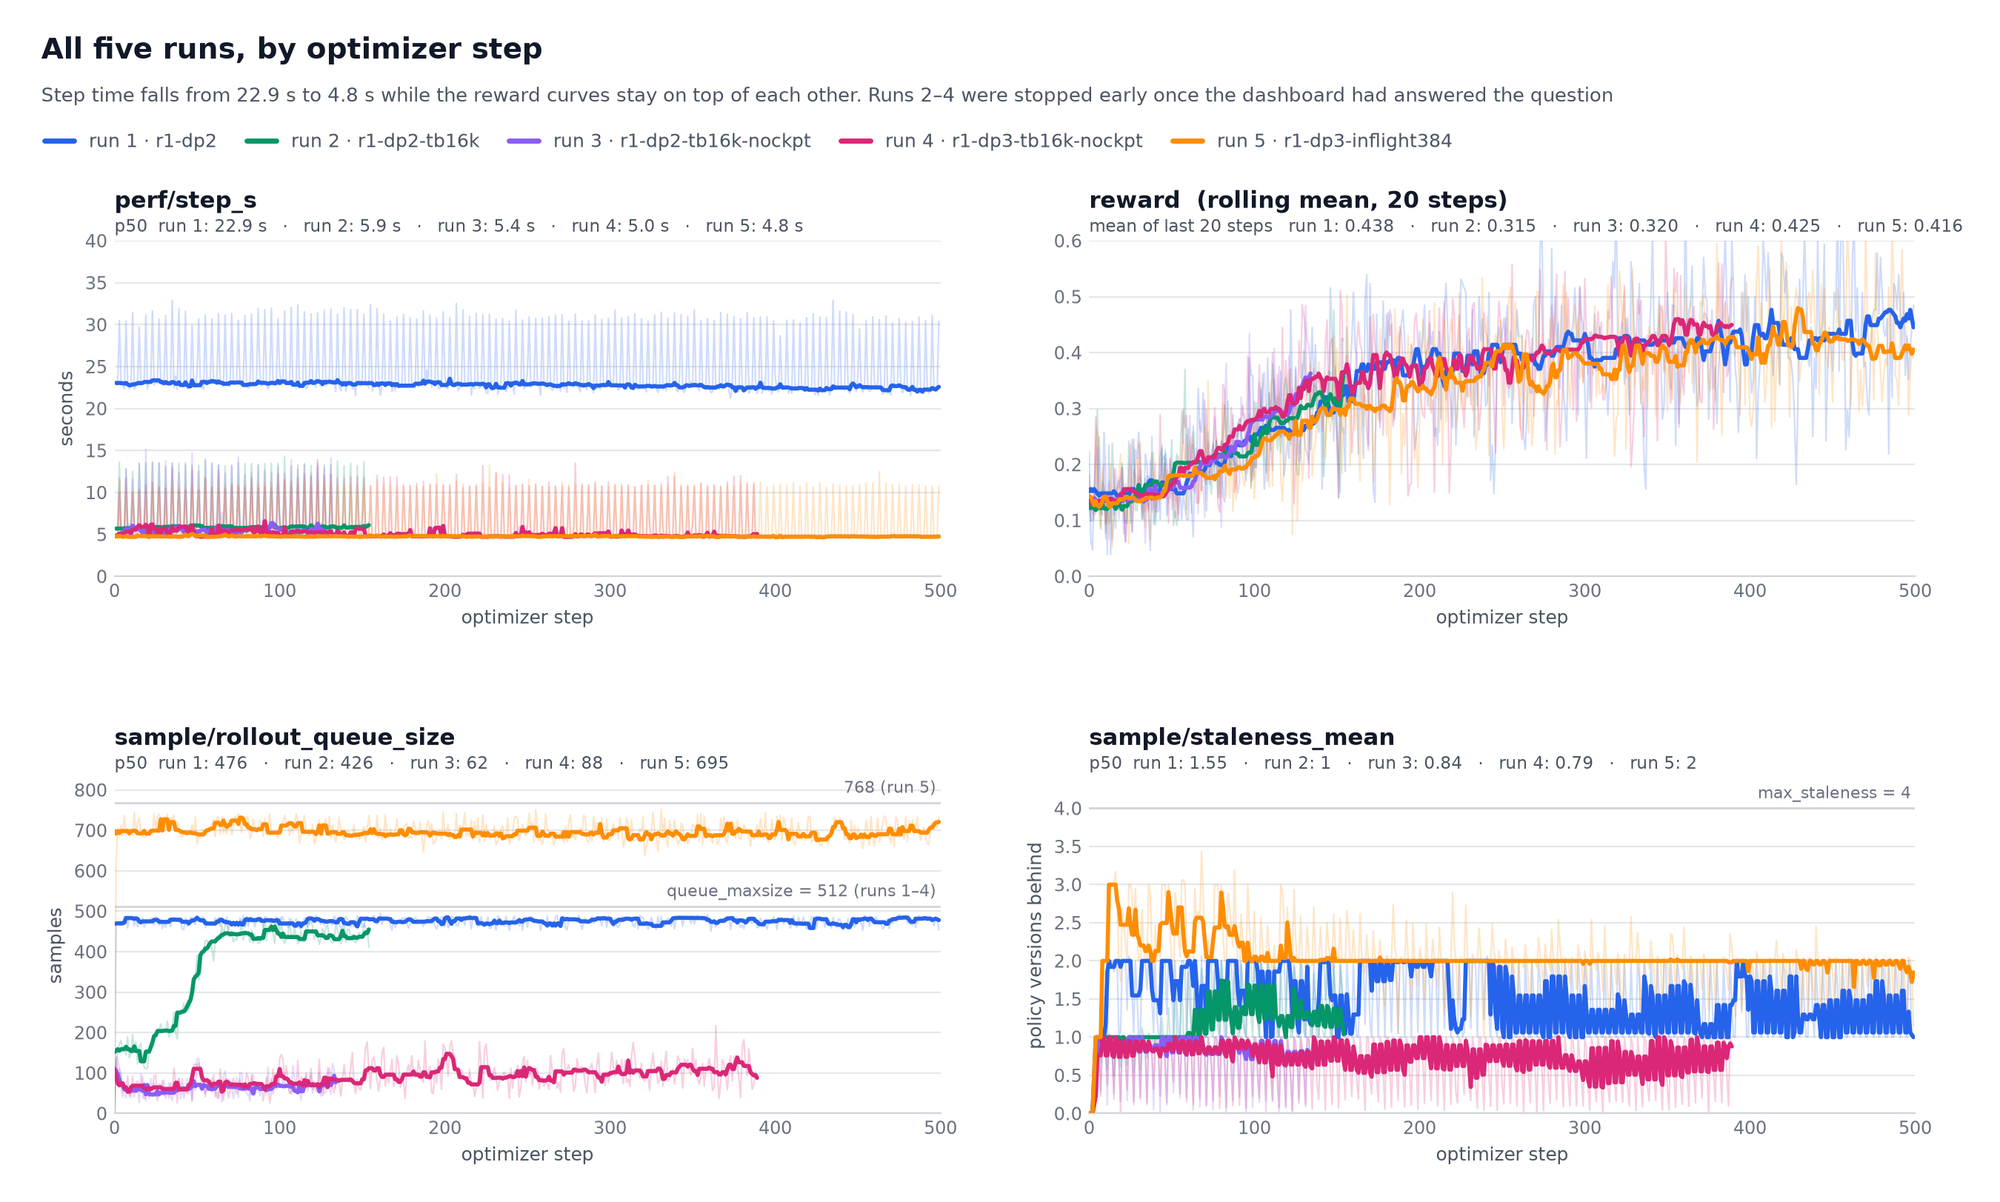
図 6。trackio の全 5 回の実行(r1-dp2、r1-dp2-tb16k、r1-dp2-tb16k-nockpt、r1-dp3-tb16k-nockpt、r1-dp3-inflight384)をステップ数を横軸に重ねて表示。各パネルは perf/step_s、reward、sample/rollout_queue_size、sample/staleness_mean。実行全体を通じて 1 ステップの時間は 22.9 秒から 4.8 秒に短縮され、reward 曲線は終始重なったまま。最後の実行ではキューが 768 のうち約 690 まで再び埋まり、staleness は 2 で安定。Run 2 から 4 はダッシュボードが答えを出した時点で早期に停止した。
384 リクエストが在途のとき、各レプリカには 128 が割り当てられる。キューはすぐに 768 のうち約 690 まで埋まり、その水準を維持した。背圧は 5 秒に戻り、rollout 待ちは 0.03 秒に下がった。トレーニングが再びボトルネックになった。Forward と backward が 4.6 秒、重み同期が平均 1.5 秒、1 ステップの時間中央値は 4.8 秒。
平均 staleness は 1.5 バージョンから 2.0 バージョンに上がった。サンプルがより大きなキューで長く待つためだ。それでも max_staleness=4 を下回っており、ratio は依然として 1.000 に非常に近い。
スコアボード
| 500 ステップ | run 1 r1-dp2 | run 5 r1-dp3-inflight384 |
|---|---|---|
| 壁時計時間 | 3 時間 27 分 | 53 分 |
perf/step_s、p50 | 22.9 秒 | 4.8 秒 |
perf/fwd_bwd_s、p50 | 21.9 秒 | 4.6 秒 |
perf/mfu_fwd_bwd | 3.9 % | 23.5 % |
batch/samples_per_step | 128 | 168 |
| トレーニングサンプル数 | 64 000 | 84 078 |
perf/weight_sync_s、p50 | 8.5 秒 | 6.2 秒 |
sample/staleness_mean | 1.5 | 2.0 |
| reward、最初の 20 ステップ → 最後の 20 ステップ | 0.145 → 0.438 | 0.145 → 0.416 |
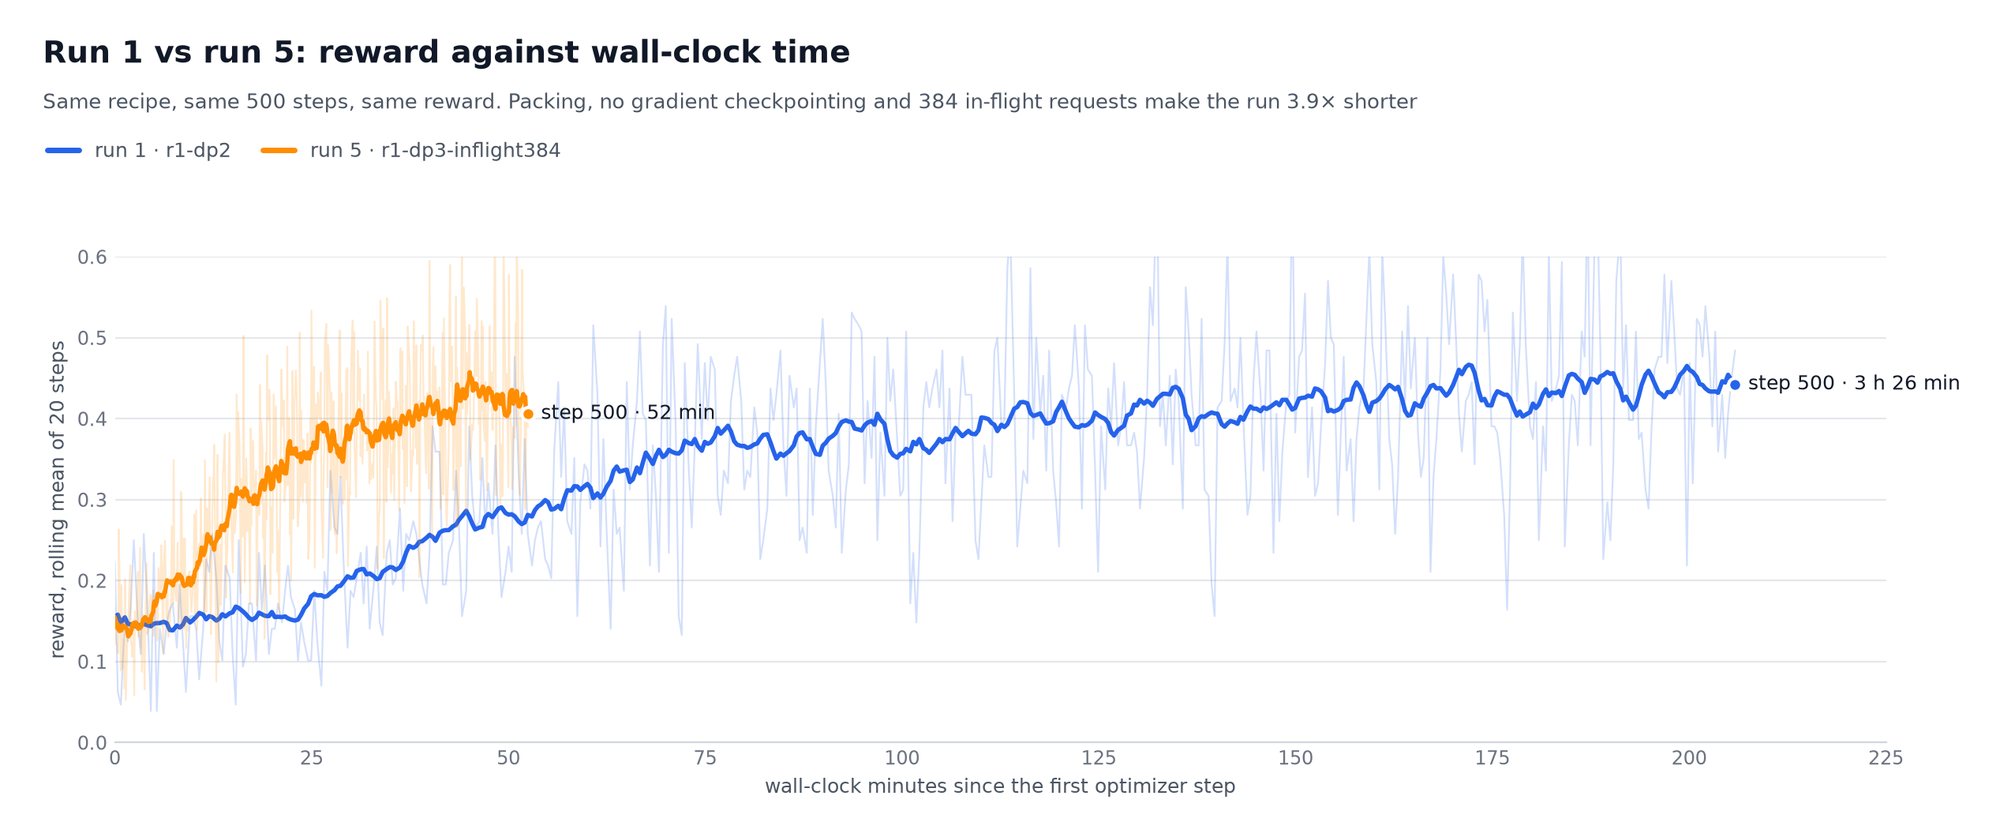
図 7。trackio の run r1-dp2 と r1-dp3-inflight384 における、最初のオプティマイザステップ以降の wall-clock 分に対する reward。同じレシピ、同じ 500 ステップ、同じ最終 reward。run 5 は 3 時間 26 分ではなく 52 分で到達した。
最終的にこの run は 3.9 倍速く、学習サンプルは 31 % 多く、reward 曲線はほぼ一致した。packing、checkpointing の無効化、in-flight 上限の引き上げがこの差を生んだ。そのいずれの場合も、dashboard は最初の 10 分以内に問題を指し示した。
試してみる
git clone https://github.com/AmineDiro/hfjobs-lora-buckets && cd hfjobs-lora-buckets
hf auth login
MAX_STEPS=20 RUN_TAG=smoke ./run_all.sh --wait        # ~15 min, three Jobs, cancels the servers when done
MAX_STEPS=500 ./run_all.sh --wait                     # run 1: the reference batch shape, ~3.5 h
TOKEN_BUDGET=16384 GRAD_ACCUM=6 GRADIENT_CHECKPOINTING=0 PROXY_LORA_RETRY_S=0.5 \
  MAX_INFLIGHT=384 QUEUE_MAXSIZE=768 MAX_STEPS=500 ./run_all.sh --wait   # run 5: same recipe, ~55 min
参考資料
- John Schulman ほか、LoRA Without Regret、Thinking Machines Lab、2025 年 9 月。rank-1 LoRA が方策勾配 RL で全量ファインチューニングと同等になり得ること、およびその理由を論じている。
- TRL、
AsyncGRPOTrainerと記録されている指標。 - TRL PR #7017:
AsyncGRPOTrainerに PEFT/LoRA サポートを追加し、adapter のみを vLLM に同期する。TRL v1.14 でリリース済み。 - Hugging Face Jobs と Storage Buckets、
hf-mount。 hf-mount-repro:2 つのスクリプトで 30 秒のネガティブキャッシュのスタールを再現する。- 本記事の各 run の trackio dashboard。
- Penghui Qi、Zichen Liu、Xiangxin Zhou、Tianyu Pang、Chao Du、Wee Sun Lee、Min Lin、Defeating the Training-Inference Mismatch via FP16、arXiv:2510.26788、2025。Sanity データセット
sail/Sanity-Test-R1D-1.5Bと LoRA レシピsail-sg/Precision-RL、oat/scripts/lora/bf16_grpo_tis_lora.shの出典。
@article{qi2025precisionrl,
  title={Defeating the Training-Inference Mismatch via FP16},
  author={Qi, Penghui and Liu, Zichen and Zhou, Xiangxin and Pang, Tianyu and Du, Chao and Lee, Wee Sun and Lin, Min},
  journal={arXiv preprint arXiv:2510.26788},
  year={2025}
}