大規模言語モデルにおける証明可能な推論の進展
AnthropicのFlashProveは各応答にzkSNARKを付与し、重みを見ることのないユーザーでもどのモデルがトークンを生成したかを検証可能にします。1台のH100上で400Bモデルを毎秒約110トークンで処理します。
もっと見る 推論
ホームAnthropicのFlashProveは各応答にzkSNARKを付与し、重みを見ることのないユーザーでもどのモデルがトークンを生成したかを検証可能にします。1台のH100上で400Bモデルを毎秒約110トークンで処理します。
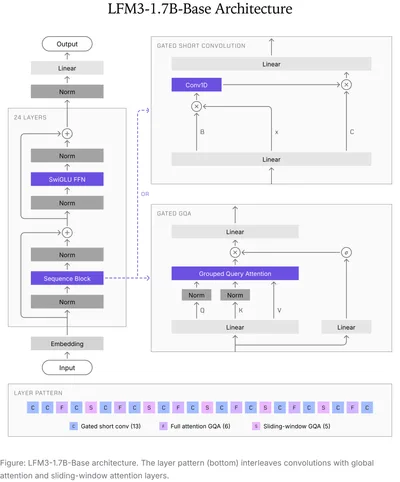
LFM3-1.7B は 22T トークンで事前学習し、24 層のうち 13 層がゲート付き短畳み込み、5 層がスライディングウィンドウ注意、6 層がグローバル注意。4bit で約 1 GB、128K コンテキストの KV キャッシュは 1.6 GB に収まる。視覚・音声・オムニ・判断の各モデルも同じ骨格から派生した。
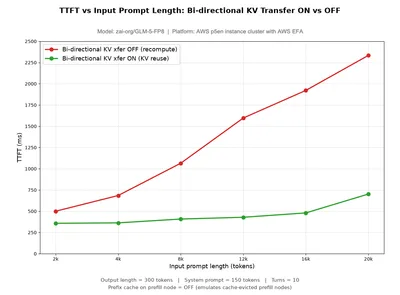
双方向 KV 転送により、vLLM の prefill ノードは後続の会話ターンで decode ノードが以前に計算した KV を再利用でき、冗長な prefill 再計算を削減して、長いマルチターンプロンプトで TTFT を最大 3.3 倍下げる。
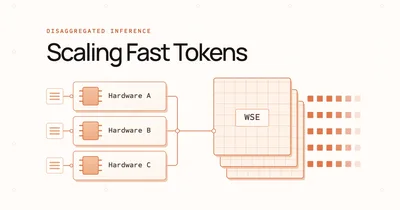
Cerebras は prefill と decode を異なるハードウェアに分離:演算強度が異なり、スケジューリング目標も異なるため、分離後は同じハードウェア量でスループットが5倍向上し、生成速度は低下しない。記事は行列積から KV 転送と異種分離の選定までを解説。
Google のマルチエージェントの枠組みは、長尺の動画生成を大局的な最適化問題として扱う。数分の物語を通して人物と場面の一貫性を保つ。
ModalとCMUのチームは、クエリプランナーと推論エンジンを同じGPU上に統合し、AI-SQLを毎分10億トークンで実行できるようにした。記事では、既製の推論エンジンがこの種のワークロードでなぜ計算資源を無駄にするのかを解説している。
Modal のエンジニアチームが、兆パラメータ級のコーディング agent に兆単位のトークンを供給する方法を解説する。推論基盤、トークンキャッシュ、スケジューリングまでを層ごとに分解する。
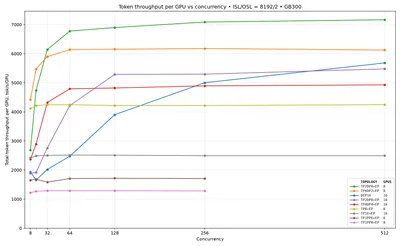
GB300 NVL72 上で Qwen3.8-2.4T を PD 分離でサービングした結果。高スループット側では GPU あたり毎秒 5,000 トークン、低遅延側ではユーザーあたり 180 トークンに達し、両端が同じパレート前沿に乗る。
vLLM が PyNvVideoCodec ハードウェアデコードを統合し、動画記述のスループットは 8 GPU ノードでも線形にスケールします。
Gemini 3.8 Live と Extended Thinking がリリース、音声対話で複雑な推論、リアルタイムビジョン、バックグラウンドタスクを会話を中断せずにサポート。
Novita AIがChordをオープンソース化、W4A16 MoE CUDAカーネル群。公開されているHummingと比較し、層ごとの実測でH200ではレイテンシ最大1.33倍削減、未チューニングのB300では最大2.15倍削減。
著者は、Jev の価値は主にモデル自体ではなく推論戦略にある可能性があると考えている。返信を choice フィールドに事前入力し、制約されたトークンを 1 つだけ生成すれば、どの LLM でも「秘密のレシピ」の大部分が得られる。彼は Qwen2.5-1.5B で 2〜3 倍の高速化を試し出した。
Google Research の Retrieve-for-Train は、軽量な拡散モデルを強化学習で一度だけ訓練し、 推論時の思考予算を迂回して一貫した fan-out 検索結果を 1 回の順伝播で生成する。
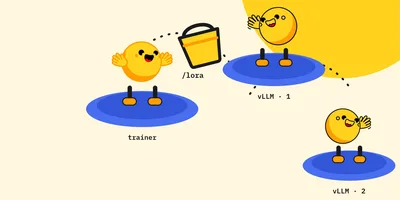
AsyncGRPOTrainer が rank-1 LoRA adapter だけを学習・同期し、HF Jobs 間は NCCL ではなく Storage Bucket 経由。500 ステップの学習が 3 時間 27 分から 53 分に短縮。
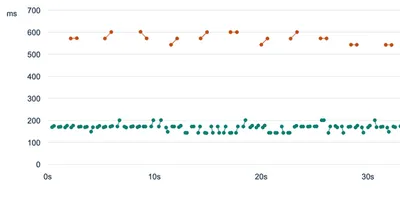
著者はQwen3-8BをSystem One分類器として接続した後、2つの手法を試した。階層的目標(10秒ごとに戦略、5秒ごとに戦術、200ミリ秒ごとに実行)とトーナメントサンプリング(一度に100個のリンクを2ラウンドで選別)で、後者はWikiracingで理想的な3リンク経路を見つけた。
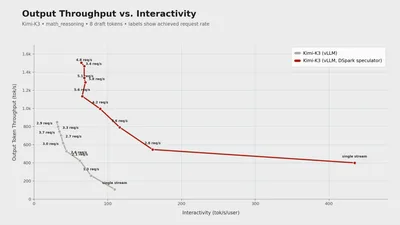
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。
IBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
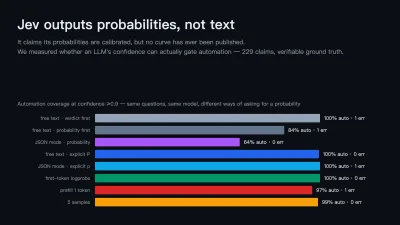
TypeSafe AI の Jev はモデル出力を文字列から確率付きの型付き判断に置き換え、その確率は「校准」済みだと主張している。この前提を裏付ける証拠は誰も示していない。そこで確定した答えのある 229 件の主張を使い、通常の LLM の信頼度が自動化に使えるかどうかを測った。