あなたのエージェントは今回満点で合格したが、次回もそうなるだろうか?
IBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
日本語
コピー
あなたのエージェント、今回は満点だった。次もそうなるか?
エージェントはリハーサルでは完璧に動いたのに、本番のデモでは別の経路をたどり、同じタスクに失敗した。
舞台の上なら気まずいだけだ。本番環境では信頼性の問題になる。一度成功したワークフローが、次にユーザーが同じリクエストを投げたときに失敗するかもしれない。金融取引の照合や、契約書に特定の義務が含まれているかの確認といった重要な作業では、これがそのまま業務の停止につながりかねない。
ほとんどのベンチマークは、この揺らぎを平均値の裏に隠している。AppWorld で GPT-4.1 を使った ReAct エージェントは、5 回の繰り返しのうち 77.4% の実行が成功した。しかし、5 回すべて成功したタスクは 53.0% しかない。これが 24.4 ポイントの一貫性ギャップだ。
ほとんどのベンチマークが報告するのは前者の数字だ。私たちは後者の数字を測る仕組みを作り、それを改善した。
以前の記事で、ALTK-Evolve を紹介した。エージェント自身の過去の軌跡を再利用可能なガイドラインに変え、そのガイドラインを自動で蒸留して推論時に注入し直すシステムだ。タスク成功率は確かに上がるが、それらの結果が問うていたのは平均的なケースにすぎない。本記事では一貫性ガイドラインを紹介する。altk-evolve における新しいガイドライン種別で、私たちが一貫性アナライザー(Consistency Analyzer)と呼ぶ診断ツールの上に成り立ち、このギャップに直接切り込む。
TL;DR
- 精度は信頼性の問題を覆い隠す。 平均 77.4% の成功率を持つ ReAct エージェント(GPT-4.1、AppWorld
test_normal)でも、5 回の繰り返しすべてに成功するタスクは 53.0% にとどまる。これが 24.4 ポイントの一貫性ギャップだ。難しいタスクではこの差が 30 ポイントに達することもある。 - そのための診断ツールを作った。 一貫性アナライザーは、エージェント自身が記録した軌跡をリサンプリングし、ひっくり返りやすい意思決定点、つまりモデルがもう 1 トークン違うサンプリングをしていたら別の選択をしていたであろうステップを特定する。必要なのは軌跡 1 本だけで、正解も要らない。軌跡内の各意思決定点について、タスク全体を端から端まで再実行するのではなく、1 リクエストで k 個の補完(デフォルト k=5)をリサンプリングする。
- この診断をガイドラインに変えると、ギャップが半減する。24.4 ポイントから 12.0 ポイントへ(同一タスクの Pass⁵ は +16.0 ポイント、類似タスクは +13.0 ポイント)。しかも平均精度は一切落ちない。
- 手法と評価の全体は arXiv の技術レポートにある。
ほとんど誰も報告しない指標
標準的なエージェント評価が報告するのは Mean@k だ。ベンチマークを k 回走らせ、通過率を平均する。k はたいてい 3、ときには 1 のこともある。これがどのリーダーボードにも載っている数字であり、実務で「精度 77%」と言ったときに意味するものでもある。
Mean@k が答えるのは「このエージェントは平均してどれくらい優れているか」だ。ユーザーが本当に気にする問いには答えていない。まったく同じ問題をもう一度投げたら、また解けるのか? それに答えるには Pass^k が要る。k 回の実行ですべて成功したタスクの割合だ。
⚠️ Pass^k は Pass@k ではない。 おなじみの Pass@k は楽観的で、k 回の試行のうち少なくとも 1 回成功するかを問う。検証して再試行できる状況では、これが正しい問いだ。Pass^k はその裏返しの悲観版で、毎回成功しなければならない。同じ文字で、正反対の問い。常に Pass^k ≤ Mean@k ≤ Pass@k が成り立つ。
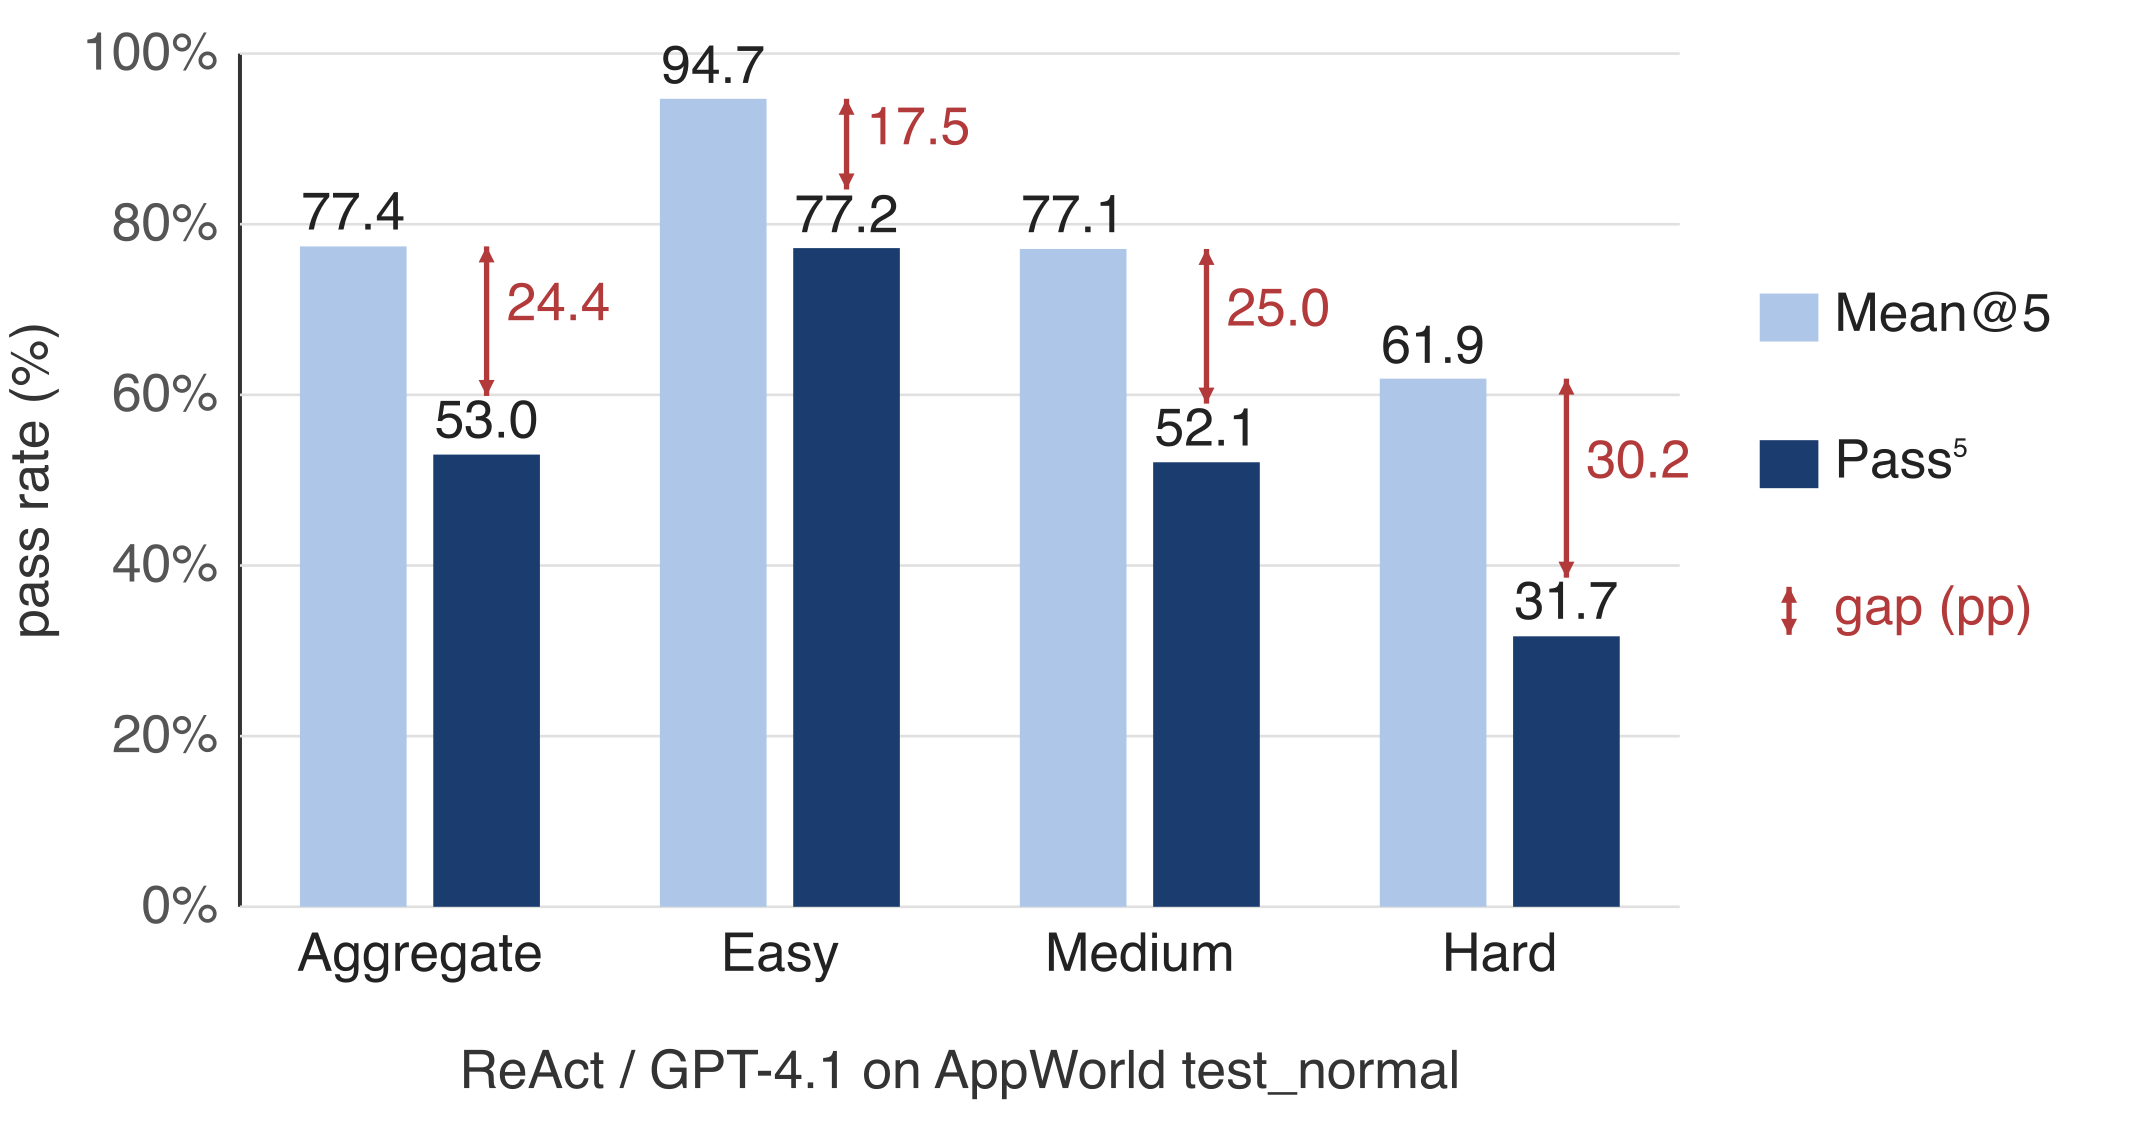
GPT-4.1 をバックエンドにした ReAct エージェントが 77.4% の Mean@5 を出すのは、確かに強い。だが Pass^5 は 53.0% しかない。ベンチマークのタスクのほぼ 4 分の 1 は、このエージェントが解けるときもあれば解けないときもあるタスクであり、しかもタスク自体は 2 回の実行の間で何も変わっていない。この差、つまり Mean@k から Pass^k を引いたものを、私たちは一貫性ギャップと呼ぶ。
これはより大きなモデルなら直る類の能力問題ではない。直交する軸だ。エージェントは能力が高く、同時に不安定でありうる。
エージェントはなぜひっくり返るのか:尖った決定と平坦な決定
LLM エージェントが何かを決めるとき、どの API を呼ぶか、どんな引数を渡すか、リトライするかどうか、その決定はすべて次のトークンに関する確率分布から来ている。重要なのはその分布の形だ。尖った分布は確率質量の大半を 1 つのトークンに載せる。後続の候補は大きく差をつけられ、同じ選択が何度も何度も現れる。平坦な分布は、ほぼ並んだいくつかのトークンに同程度の質量をばらまく。どれが勝つかはほぼコイントスだ。
形が、結果を変えるのにどれだけノイズが必要かを決める。尖った分布はしぶとい。GPU の浮動小数点演算の非結合性やリクエストのバッチ処理など、プラットフォーム側の効果で数値はわずかに揺れるが、明らかな勝者を入れ替えるにはまったく足りない。平坦な分布は、まさにそうした揺らぎの影響を受けやすい。ほぼ並んだ候補は小さな摂動で順位が入れ替わりうる。そして 1 本の軌跡は数十の決定をつなぐので、各ステップのわずかな翻盤確率が積み上がり、ある 1 回の実行が別の経路をたどる確率は無視できないものになる。24 ポイントの差はこうして生まれる。
これで、この問題がデコード設定では治らない理由も説明がつく。貪欲法も固定シードも、決めているのは分布がどうやって1つのトークンになるかだけで、分布そのものについては何も言っていない。ホスト型エンドポイントでは確率が実行ごとにわずかに揺れる。だから同じプロンプト、同じモデル、温度ゼロでも、今日はほぼ並んだ候補のこちら側に解け、明日はあちら側に解ける。
私たちの設定: ReAct エージェントは温度 0.0 で動いている。つまり上の揺らぎはどれも普通のサンプリング由来ではない。
まず診断し、それから直す
ここで問題は検索になる。ある与えられた軌跡のなかで、どのステップが平坦なのか。それが分かったとして、次にどうするのか。
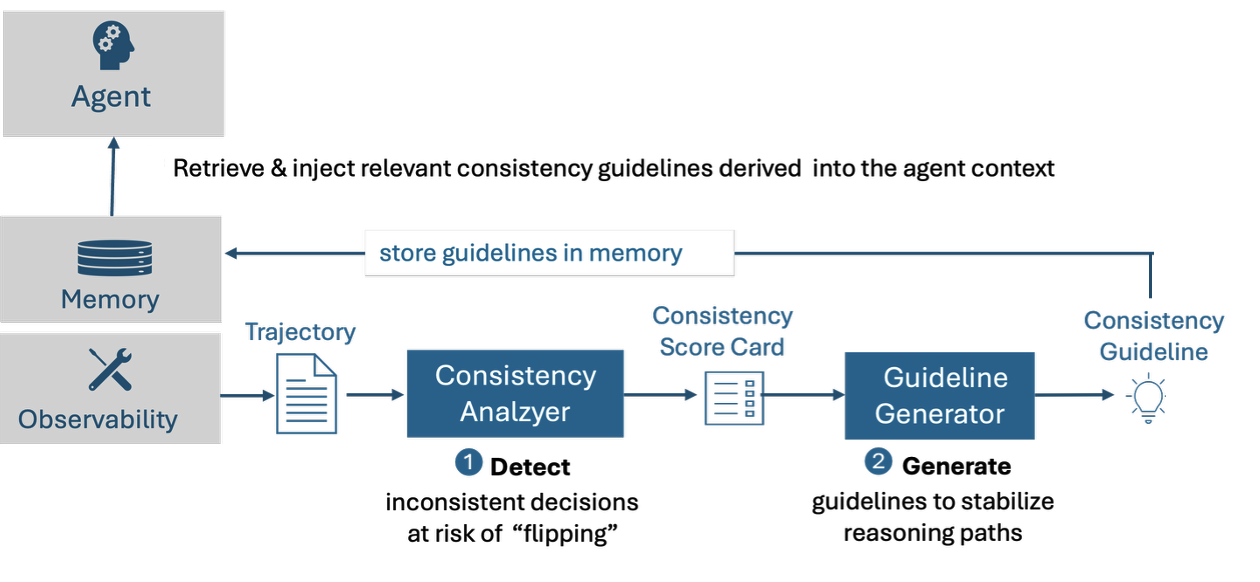
一貫性基準は2段階のパイプラインから生まれる。ALTK-Evolve の既存の仕組みに接続するが、何を書くかを決めるソース信号だけが新しい。
1. 検出:一貫性アナライザー。
記録された軌跡を渡すと、アナライザーは各意思決定ステップを制御されたリサンプリングで再生し、その時点でのモデルの出力が実際にどれだけ揺れるかを測る。具体的には、意思決定ステップごとにモデル呼び出しが1回増える。オフラインで1度だけ行い、リクエスト時にサンプリングパラメータを設定して k 個の補完を1回で引く(デフォルト k=5)。しかも再生するのは記録済みのコンテキストに対してであり、新しいツール呼び出しでも、新しい環境とのやり取りでも、タスクを端から端まで走らせ直すことでもない。こうして各意思決定ステップの一貫性スコアが得られ、スコアカードに書き込まれる。次回の実行でひっくり返るリスクのある意思決定が正確に特定できる。検出は完全にブラックボックスだ。logits も、モデル内部の情報も、手持ちの軌跡の外側に足す計装も要らない。
2. 生成:狙いを定めた基準。
印を付けられたステップはそれぞれ一貫性基準の候補になる。ALTK-Evolve の標準フォーマットを使うので、既存の保存・検索パイプラインにそのまま乗る。以下は実例で、AppWorld のタスク「How many activities are done in my bucket list as per my SimpleNote note?」の軌跡から GPT-4.1 が生成したものだ。
[基準 1] ノート本文でチェックボックス風のマーカーを数えるときは、単純な部分文字列カウントではなく、行頭にアンカーした正規表現で照合する。ノートの見出しが図例の行でこのマーカー記号を繰り返すことが多いからだ。 [基準 2] ノート関連のクエリでは、必ず検索結果を確認する。複数マッチしていないか調べ、先に進む前に正しいノートであることを確かめる。
ここにタスク固有の細かい知識は一切ない。文字列カウントのバグと未確認の検索結果は、多くの AppWorld タスクに現れる、不確実性の高い意思決定ポイントだ。まさにそこが要点で、アナライザーが狙うのは不安定さであって失敗ではない。だから今回たまたま正解したが次は間違えやすいステップを捕まえられる。
2分間のデモを見る:このタスクでのエージェントの5並列実行は、カウント戦略の不確実性のせいで3対2に割れた。上の基準をコンテキストに入れてもう一度走らせると、5回すべてが一致した。
結果:ギャップは縮まり、精度は落ちない
AppWorld test_normal(168タスク)で評価した。GPT-4.1 上の ReAct エージェントを使い、各タスクで1本のベースライン軌跡から一貫性基準を生成し、それを5回の新規実行でテストする。
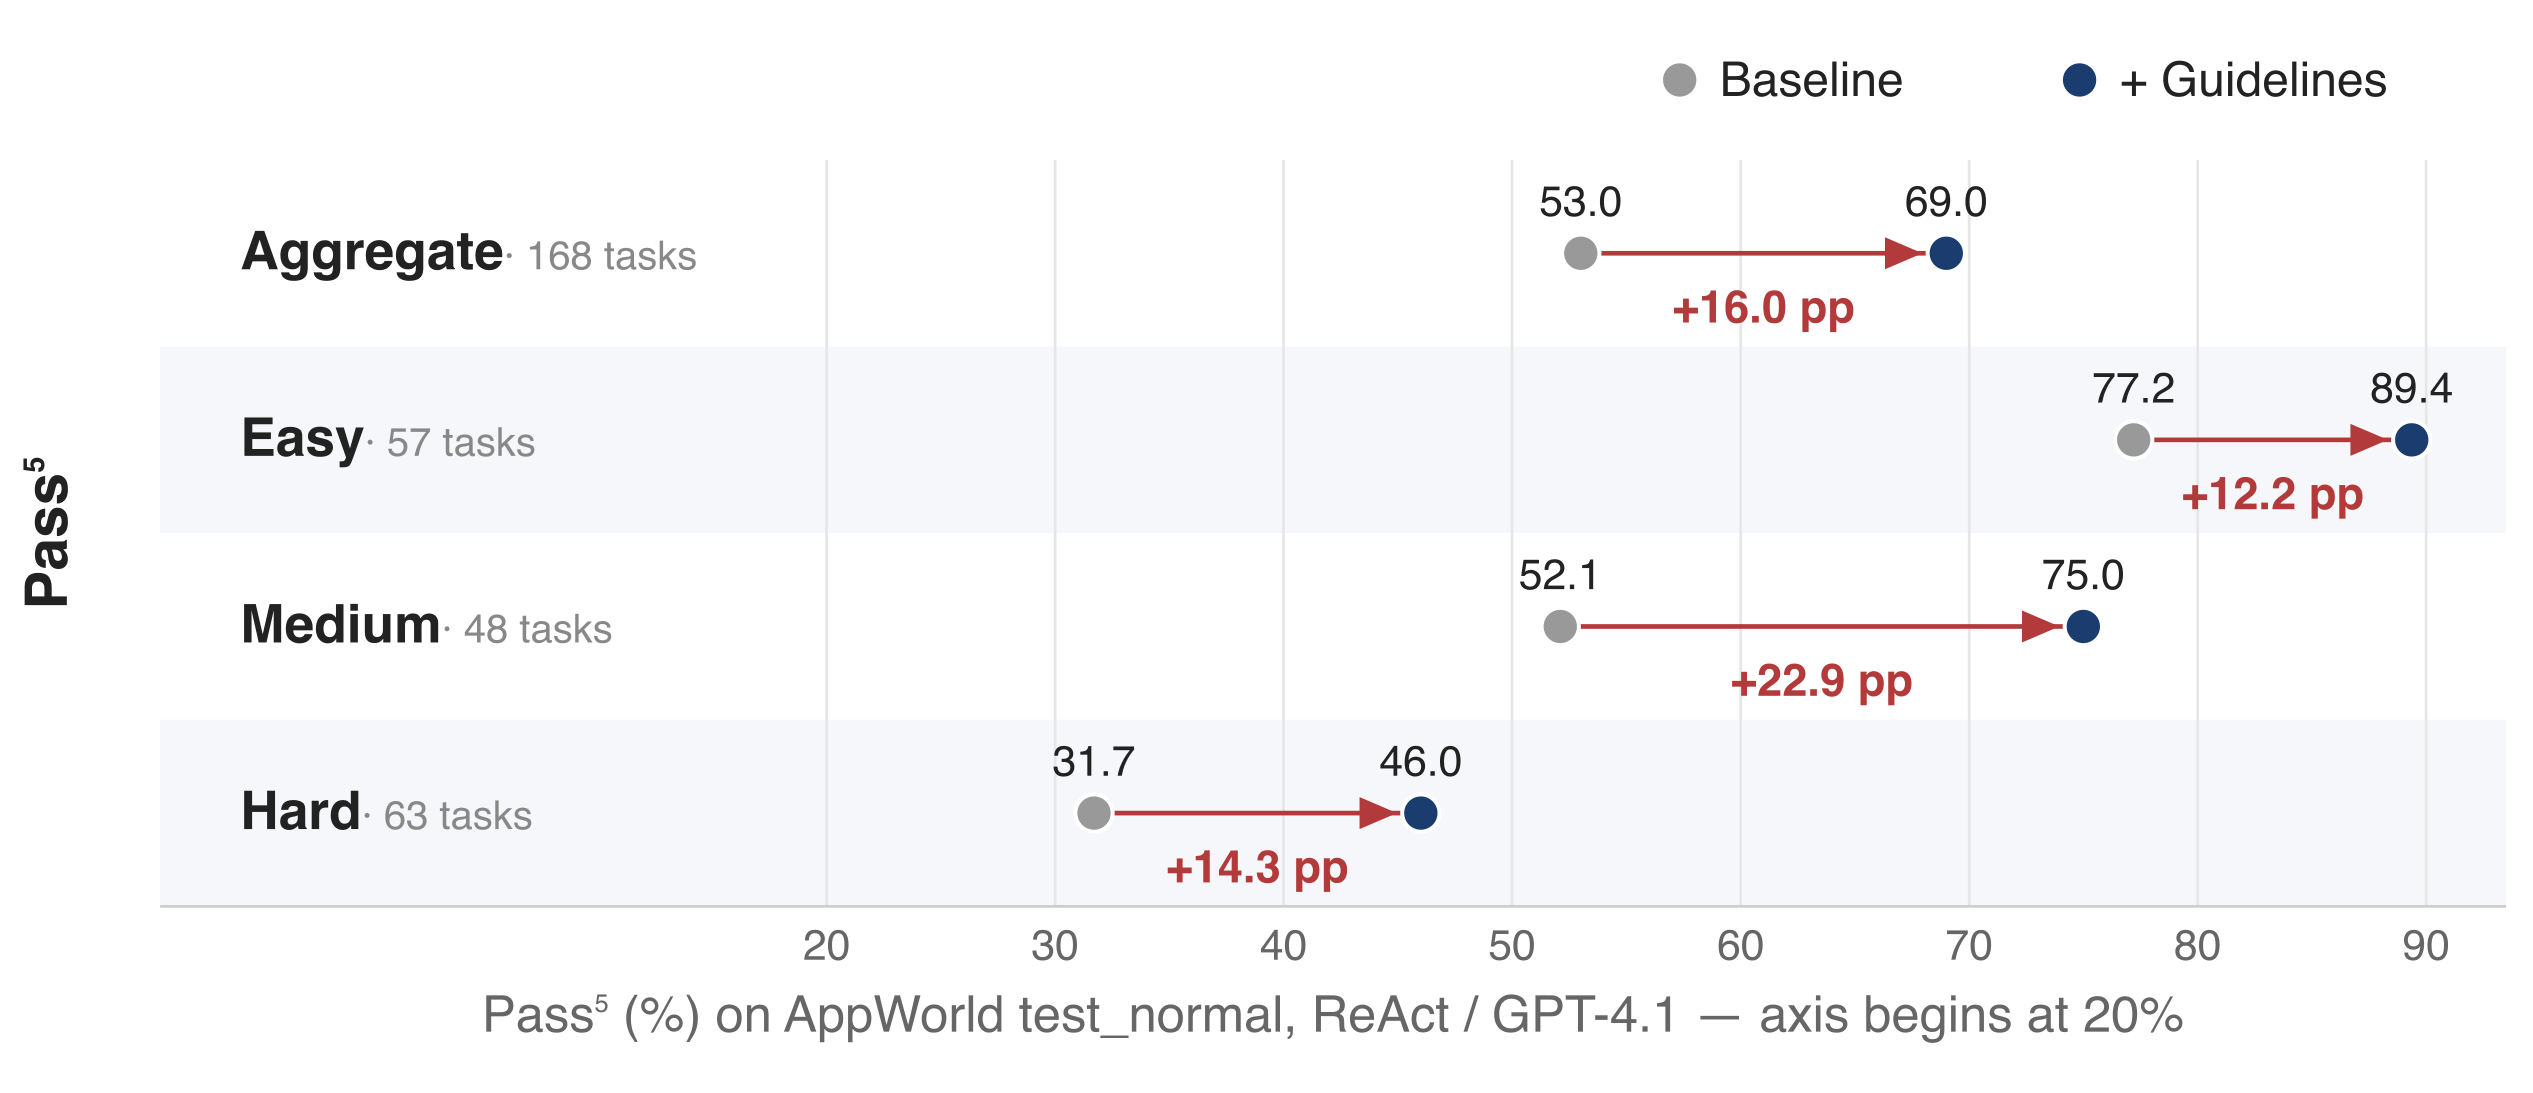
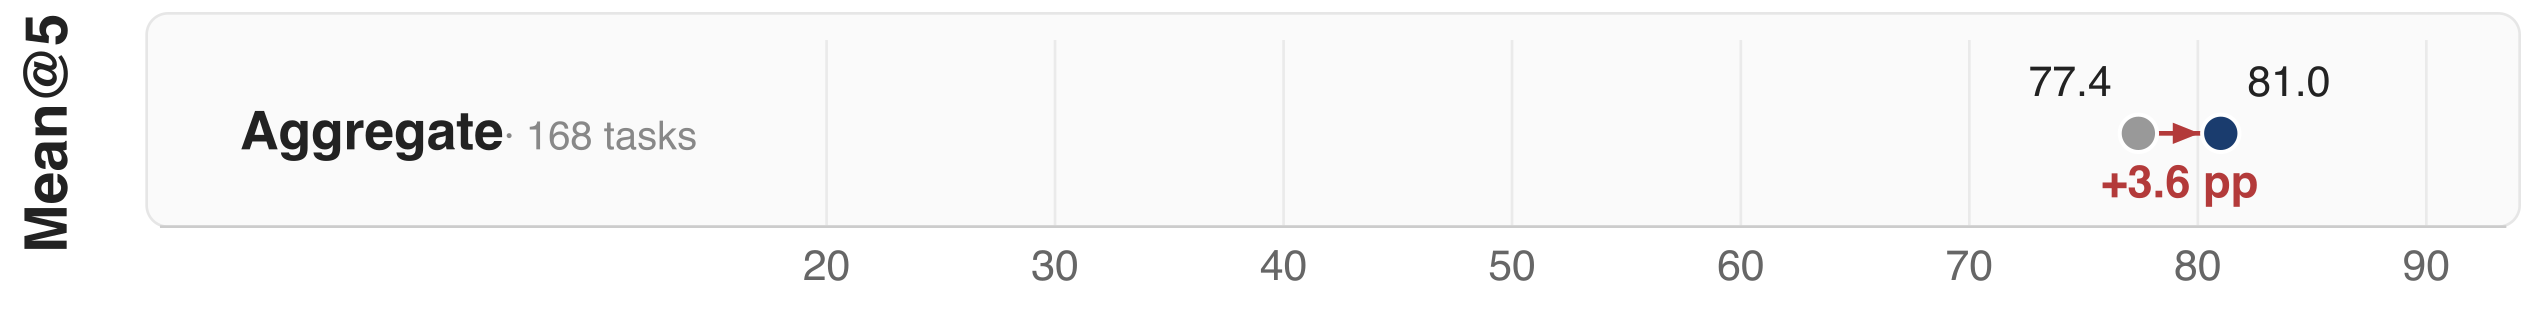
Mean@5(%)。集計値で、上の Pass^5 と同じ土俵。
一貫性ギャップはおよそ半分になった。 集計の Pass^5 は 53.0% から 69.0% へ上がり、同時に Mean@5 も 77.4% から 81.0% へ上がった。「能力がありそう」と「当てにできる」の距離は 24.4 ポイントから 12.0 ポイントへ縮まった。以前は不安定だったタスクのうち、ほぼ3分の1が、エージェントが毎回通るタスクになった。
中位と困難が最も恩恵を受けた。 中位は +22.9 ポイント(相対 +44%)、困難は +14.3 ポイント(相対 +45%)。相対幅はほぼ同じで、絶対値では中位が上回る。簡単は +12.2 ポイントで、そもそも伸びしろが最も小さい。これは一貫性基準がまさに狙ってやることだ。エージェント自身の不確実性が結果に漏れ出している特定の意思決定ポイントを見つけ、安定させる。
Mean@5 は一度も下がらなかった。 平均精度を保つことは加点要素ではなく必須条件だ。Mean@5 を犠牲にして Pass^5 を押し上げるシステムは、信頼性のなさを別の場所へ移しただけで、直してはいない。どの難易度帯でも、平均精度は維持または向上した。
基準は汎化する。1本の軌跡に当てるパッチではない
同じ AppWorld シナリオの別の、しかし関連するタスク(基準を掘り出したシナリオの別バリアント)に適用しても、一貫性基準は Pass^5 を +13.0 ポイント押し上げた。同タスクの数字よりわずか3ポイント低いだけだ。1回の実行から得た基準は、その実行に当てるパッチではない。移せる何かを捉えている。
より鋭い証拠は、より弱いモデル gpt-oss-120b から得られた。同じタスクで Pass^5 ははるかに低いベースラインから +6.0 ポイント上昇し(10.1% → 16.1%)、興味深いことに、類似タスクへの汎化の数値(+8.7 ポイント)は同じタスクでの伸びを実際に上回っている。つまりこれらのルーブリックが捉えているのは、特定の軌跡の細部を丸暗記したものではなく、真に再利用可能な失敗パターンだということだ。
エージェントを本番に出すなら
- Pass^k と Mean@k を一緒に報告する。 平均値では、信頼できるエージェントと運が良かっただけのエージェントを区別できない。k=3 でも、自分が抱えていることに気づいていなかったギャップが露呈する。
- このギャップは難易度が上がるほど広がると想定しておく。 最も難しいティアこそ、単一の平均値が最も人を誤らせる場所だ。
- まず大きなモデルを探しに行かない。 一貫性と能力は直交している。強いモデルは Mean@k を押し上げるが、一貫性のギャップが縮まるとは限らない。
- 診断にグレーダーもリアルタイムのリプレイも要らない。 各意思決定ステップで LLM を1回余分に呼ぶだけで足りる(デフォルトでは k=5 個の補完をサンプリング)。正解は不要で、タスクを環境に対して再実行する必要もない。だからこそ本番トラフィック上で使える。そこではエンドツーエンドのリプレイを1回行うことすらままならないことが多いのだから。
試してみる
ALTK-Evolve を試す:このオープンソースリポジトリには、これらの実験で使った一貫性アナライザーと一貫性ルーブリックの生成が含まれている。あるいは arXiv の技術レポートを読んで、手法の全体像を確認してほしい。
自分のタスクで再現できない精度の数字に心当たりがあるなら、ぜひ聞かせてほしい。あなたのエージェントにおける一発逆転しやすい挙動の具体例は、私たちが次に何をするかを形作る、まさにそういう種類のフィードバックだ。issue か discussion を立ててほしい。
付録:これらの指標を理解する
- Mean@k。 タスクを k 回実行し、平均通過率を報告する。ほとんどのベンチマークが「精度」と呼んでいるものだ。
- Pass^k。 エージェントが k 回すべての独立した実行で成功したタスクの割合。常に Mean@k 以下。ユーザーが同じクエリを2回実行したときに体験する結果でもある。
- Pass@k。 k 回の実行のうち少なくとも1回成功すること。楽観的な側の対応物で、コード生成系の論文でよく見かける。
- 一貫性ギャップ。 Mean@k − Pass^k。単位はパーセントポイント。
関連成果物と参考資料
- ALTK-Evolve オープンソースリポジトリ:github.com/AgentToolkit/altk-evolve
- 技術レポート:arXiv
- 一貫性ルーブリックのデモ:2分の動画