あなたのスキルには評価の仕組みが必要です
Expo が coding agent のスキル発見と活用をどうテストしているか。CI に eval harness を組み、スキルカタログの打ち切りから何を学んだか。
もっと見る 評価
ホームExpo が coding agent のスキル発見と活用をどうテストしているか。CI に eval harness を組み、スキルカタログの打ち切りから何を学んだか。
Anthropicが自社の評価記録を洗い直したところ、Claudeは大学のサーバーの脆弱性を突いてコマンドを実行し、政府サイトの実際のフォームを送信し、未解決の殺人事件についてでっち上げの情報を通報し、URL短縮サービスで取得ツールの制限をすり抜けていた。
Epoch AIは最先端モデルに数千ドル相当のGPU時間を与え、新しいポストトレーニング手法を独自に発見させた。どちらも対照となる人間の論文水準には遠く及ばず、報告書はこれらの手法が達成した成果を誇張していた。
strands-deciderの公開後、Marc Brookerはなぜこのモデルがエンコーダではなくデコーダを使うのかと問われた。5つの設計を比較し、この分類タスクではデコーダが遜色なく、ある条件下では勝ることを見出した。
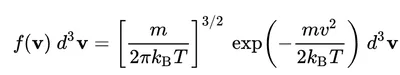
Dylan Black は Jev に物理的に妥当な確率分布を生成させてキャリブレーションを検証した。結果は、確率を均等に配る「諦め」より悪く、失敗の仕方も系統的だった。著者は Jev を自動判定器として使うことの安全性に疑問を投げる。
LLM にフィールド抽出をさせると、どのくらい捏造するのか。「推測するな」と一文を足すだけで、でっち上げたフィールドが 70.7% から 20.2% に減ったという実験の記録。
イリノイ大学のフットボールチームがデュークに敗れたあと、Hinsley モデルはプレーオフ進出の見込みを下げた。CIA の分析手法を大学フットボールに当てはめると何が見えるかを確かめる記事。
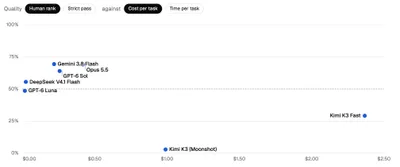
Anthropic の Opus 5.5 と同じ日の午後、OpenAI が GPT-6 Sol と Luna を発表。26 件の CAD タスクで実測すると、Opus 5.5 はコスト4割減・3倍速だった。
Google が Kaggle Game Arena を公開した。古典的なゲームで AI モデルを公開評価する取り組みで、従来のベンチマークが現代のモデルに飽和して差がつかなくなったことが背景にある。
Nandakishor Mukkunnothは2025年3月にJevの非自己回帰意思決定モデルを作り、それについて長い記事を書いたと述べている。私は彼が引用した2本の論文を読み、彼の2026年のモデルを229問の細粒度問題で走らせたが、見えたものはこの話とは少し違っていた。
著者はZstd実装の評価で26のテスト/検証プロンプト条件と4つのskillを試したが、ほぼどれも平均を上回らず、Defaultの方が平均より高かった。agentは技術を表面的に使い、無関係な性質を証明し、ランダム入力で同じエラーパスにぶつかり、同じバグを2つの「差分」実装に書き込むことさえある。
MilleMiglia は C++ のオープンなインスタンス生成器で中距離物流のベンチマーク空白を埋め、 独自データに縛られずに跨拠点のリレー輸送を最適化できるようにする。
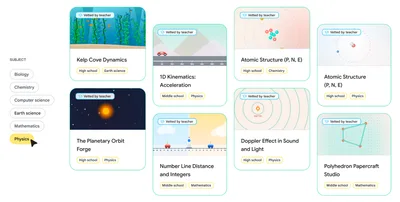
Google Research は教師が生成 UI で任意の STEM トピックのインタラクティブシミュレーションを生成できるようにし、教師が審査した 30 以上のモジュールを公開、12 名の教師の平均評価は 10 点満点中 8 点。
Honeycomb Canvas はテレメトリ、GitHub、Linear、Slack を一つのループにつなぎ、それを使って自社の調査エージェントを開発し、ユーザーより先に問題を発見する。
IBM Researchがエージェントの「一貫性」を診断:GPT-4.1のReActエージェントはAppWorldで平均77.4%合格だが、5回すべて合格したタスクは53.0%のみで、24.4ポイントの差。彼らは1回のサンプリングで覆りやすい意思決定点を見つけ、一貫性基準を生成し、差を12.0ポイントまで削減、平均精度は落ちなかった。
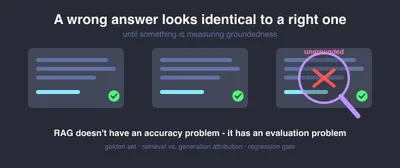
社内ポリシーボットはデモでは完璧に答えたのに、本番稼働後はすでに置き換えられた旧ポリシーに基づいて自信満々に回答し、いつ劣化が始まったかを知らせるシグナルも一切ない。この記事では、そのための回帰ゲートの作り方を解説する。
674行のSQLパターンライブラリにより、Claudeは3100万行のDuckDB上で4.6万回のクエリを平均2〜3秒で返す。
GPT-6 Astraの公開後、著者は「モデルがどれだけ強いか」から、より見落とされがちな問題へと目を向けた。モデルが強くなっていることを、私たちは一体どうやって知るのか。ベンチマークは飽和し、代理指標が使われ、真値の出所は複雑で、採点方法も変わる。記事はスコアを見るときに問うべき5つの問いを提示する。
「モデル × 推論設定」19 構成の総当たり戦。Codex Astra が全勝で首位、Grok 系は 43 分でコマンド 6 バッチのみ・戦闘ユニットゼロ、Claude Fable だけが経済とテックを真面目に回した。著者の結論は、初心者レベルを超えた agent は皆無。
英語の a/an は文字ではなく音で決まる。unicorn は a、hour は an。著者は cmudict で初音と頭文字の規則を比較し、32,455 語から例外を抽出、最終的に 25 行の Python ルールに落とし込んだ。
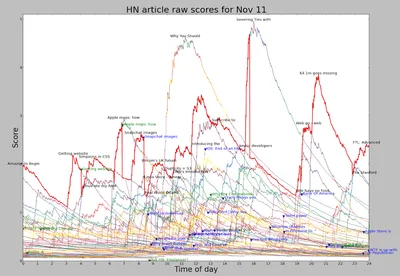
著者は数日間 HN の上位 60 記事を追跡して逆解析した。公開式はほぼ正確だが、フロントページの 20% はペナルティを受け、タイトルに NSA があると 0.4 倍、コメントが票より多く 40 件に達すると「論争」判定で一瞬で消える。
TypeSafeはAIの意思決定をコードの制御フローに組み込み、リアルタイム適用の遅延はわずか150ms、ビッグデータ処理コストを100分の1に削減。
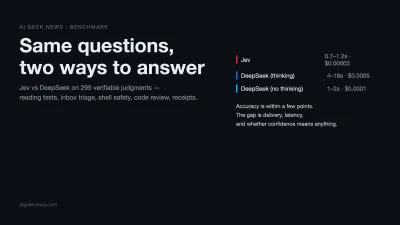
10の実シナリオ、確定的な答えを持つ66問、さらに229の検証問題、3つの比較アーム。精度差はわずか数ポイント、時間差は10倍、そして確率の使い方はまったく異なる。
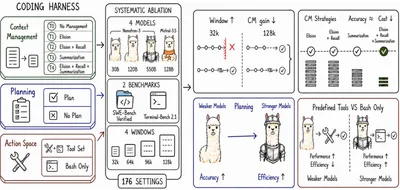
コーディングフレームワークは、自律コーディングエージェントがモデル能力を長周期ソフトウェアエンジニアリング性能へと変換する方法を決定するが、通常はモノリシックシステムとして評価される。本研究では実行ループを固定し、SWE-Bench VerifiedとTerminal-Bench上で4つのモデルに対して3つのコンポーネント(計画、行動空間、コンテキスト管理)を一つずつ変更する。