Jevはテキストを生成せず、確率だけを出力する:「一つの判断」をAPIにした、私たちが実測したそれが解決すべき問題
TypeSafe AI の Jev はモデル出力を文字列から確率付きの型付き判断に置き換え、その確率は「校准」済みだと主張している。この前提を裏付ける証拠は誰も示していない。そこで確定した答えのある 229 件の主張を使い、通常の LLM の信頼度が自動化に使えるかどうかを測った。
日本語
コピー
2026年9月15日、TypeSafe AIはJevを発表した。テキストを生成せず、確率付きの型付き判断だけを返すモデルだ。売りは「より賢い」ことではなく、「ソフトウェアからそのまま使える」こと——そして確率がキャリブレーションされていることにある。この記事では、その位置づけ、論争、エンジニアリングとしての形をはっきりさせ、そのうえで誰も検証していない前提を実測する。
大規模モデルの判断はすでに十分正確だ。それなのに自動化は起きていない。TypeSafe AIの創業者Diogo Almeidaは、この問いをそのまま自分の創業テーマにした。OpenAIでは、言語モデルに指示追従を学ばせるあの手法(ChatGPTの背後にある研究の一部)に関わった。離れたあと2年をかけ、一見小さなことに取り組んだ——モデルの出力を「文字列」から「判断」に変える。
Jevはまさにそれだ。state(テキストでも構造化データでもよい)と、いくつかの型付きの問いを渡すと、テキスト生成は行わず、型付きの答えと確率分布を直接返す。3つのプリミティブが、3つの問いの形に対応する。
| プリミティブ | 何を問うか | 返すもの |
|---|---|---|
Choice | これらの選択肢のどれか? | choice、probabilities(選択肢上の分布)、confidence |
Score | どの等級に落ちるか? | score(小数可、等級上の期待値)、legend、probabilities、confidence |
Noul | この文は真か? | noul(0〜1の確率、独立したconfidenceはない) |
公式ドキュメントの例はこうなっている(quickstart)。
response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment or subscription issues", "technical": "Bugs or integration problems"},
        ),
        "frustration": Score(instructions="How frustrated the customer appears", criteria=[...]),
        "is_urgent": Noul(instructions="The message conveys urgency or time-sensitivity"),
    },
)

response.answers["department"].choice   # "billing"
response.answers["frustration"].score   # 1.035
response.answers["is_urgent"].noul # 0.9993つの語はいずれも吟味に値する。Choiceの選択肢は自分で与える(最大255個)。モデルはその中からしか選ばず、宣言していないカテゴリを勝手に作らない。Scoreが返すのは等級番号ではなく期待値なので、1.035のような小数が普通の出力になる。Noulは確率を1つだけ返し、それ自体がシグナルだ。
1回の呼び出しに複数の問いを詰め込める。ドキュメントいわく、各問いは「同じstateに対して独立に並列評価」され、「問いを足しても応答時間はほとんど変わらない。増えるのはその問いのトークン分だけ」——この一文は、この記事の後半で単独で検証する。
結局何を売っているのか
TypeSafe自身の対照表はかなりはっきりしている。LLMはRLHF/RLVRで訓練され、「人間が好む回答」と「検証可能な報酬」を最適化する。System Oneは彼らがRLCD(Reinforcement Learning for Calibrated Decisions)と呼ぶ手法で訓練され、「キャリブレーションの意味で正直な確率」を最適化する。使う側から見るとこうなる。
| 既存のLLM | Jev(公式の説明) | |
|---|---|---|
| 出力 | 文字列。正しいことも、間違うことも、拒否することも、幻覚を吐くこともある | 型付きの値。宣言した選択肢しかありえない |
| 判断に使うための追加作業 | パース+検証+たまに起きるフォーマット崩壊への対処 | 不要(「型エラー」を学ぶこと自体が数学的に不可能だと公式は言う) |
| サンプリング | 自己回帰、トークン1つずつ | 並列、1回のフォワードで全回答 |
| レイテンシ | エンドツーエンドで3〜329秒(彼らが引くデータ) | 70〜500ミリ秒 |
| 価格 | 入力$0.20–10 / MTok,输出约 5 倍输入 | 输入 $0.042 / MTok、出力は課金なし |
| 信頼度 | 問い詰めれば答えるが、過信しやすく一貫しない | 各回答に付属。キャリブレーション済みと主張:信頼度が高ければより正確なはず |
トップページには2つの数字が掲げられている。193.6倍高速、444.6倍安価(彼ら自身の4つのworkflowでの評価に基づく。比較対象はGPT-6 AstraとFable 5.1の平均)。トップページのデモは別の数値を使っている。Jev 0.114秒 / 0.013880。
名前にはいずれも出典がある。System One / System TwoはKahnemanの『ファスト&スロー』から(速く直感的 vs 遅く推論的)。JevはWilliam Stanley Jevonsから——蒸気機関の効率が上がると石炭消費は減るどころか増えた、いわゆるジェヴォンズのパラドックスだ。TypeSafeの意味するところはこうだ。知能が1桁安くなれば、新しい使い方がさらに何桁も生まれる。
論争:3者が「新しいか」を争い、「前提が成り立つか」は誰も検証していない
Jevは発表当日、Hacker Newsでかなり徹底的に分解された(ディスカッション)。ある人の一言。「これは要するにzero-shot分類器だ」——TypeSafeの創業者は「exactly right!」と返した。会社自身がこの技術的な説明を認めたことで、議論は「これは何か」から「どこが新しいのか」へと移った。
| 何に似ているという指摘 | 誰が | 要点 |
|---|---|---|
| encoder分類器(BERT / DeBERTa) | 複数 | そもそもテキストを生成せず、幻覚もなく、推論が速い |
| GLiNER2 / GLiClass | 複数 | encoder路線。1回のフォワードで複数タスクを出す |
| 制約付きデコーディング+logits読み取り | 複数 | LLMをschemaに押し込み、logitsから確率を読む |
| テキスト拡散モデル | 複数 | 「並列生成」は拡散型デコーディングの特徴 |
| Conformal prediction | 1人 | 「conformal predictionを製品化しただけに感じる」 |
| DSPyの型付きシグネチャ | 1人 | モデルの上に型付き予測の抽象をかぶせるのは成熟した套路 |
対立面を最も完整に書いているのは Sean Goedecke の「Jev means structured output is interesting again」だ。彼はインターフェースはクールだと認めつつ、高速な構造化出力は今でも手に入ると主張する。回答を "choice": " として事前に埋め、モデルには制約付きのトークンを1つだけ生成させ、logprobs から確率を読む——自分の Qwen2.5-1.5B-Instruct で試したところ2〜3倍の高速化が得られ、「Jev には本質的な技術的堀はないかもしれない」と結論づけている。
同じ記事には、この記事の出発点になる一文もある。
Jev は自身が生成する確率が「校正されている」と主張しているが、それらが通常の logit 確率にすぎないことを示唆するものは何も見ていない。…もしそうなら、発表でもっと詳しく書いてほしかった。
要するに、校正曲線を出した者は誰もいない(TypeSafe 自身も含めて)。 「幻覚を起こさない」という主張については彼らは誠実で、ブログには「我々の数値は経験的なものではなく、schema の一致は数学的に保証されている」と書かれている。ただしそれが保証するのは「宣言していない選択肢を返さない」ことだけで、正しく選ぶことは保証しない。Goedecke はこれを「意味論的な詭弁」と呼ぶが、より正確にはこうだろう——「でたらめを言わない」ことと「間違えない」ことを切り離したのであり、前者は型システムの功績、後者は証明されていない。
Hacker News には誰も答えていない質問が2つあり、これが最も価値のある2つでもある。
- RLCD は訓練目標の何を変えたのか? 利点はアーキテクチャの変更と切り分けられるのか? 企業側は「アーキテクチャは当面非公開、いずれ論文を書く」と言うだけだ。
- 「校正」は何と比べての話か? 「フロンティア LLM と同じくらい校正されている、ただ安いだけ」なら、ハードルはかなり低いかもしれない。「フロンティア LLM よりずっとよく校正されている」なら、曲線が必要だ。
我々は Jev の early access を手に入れられない(waitlist があるだけで、公開された重みもまだない)。だから彼らの数値を検証することはできない。だが前提は検証できる:普通の LLM が構造化された判断について出す確率は、自動化された意思決定に使えるのか? 使えないなら、欠けているのは訓練目標なのか、それともプロンプトの書き方なのか。
ここからは実測パートだ。まずエンジニアリング上の形をはっきりさせておく。「使う価値があるか」という問いの半分は、どう使うつもりかで決まるからだ。
エンジニアリング上の形:置き換えようとしているのはチャットモデルではない
公式ドキュメントには4つのモードが示されていて、設計に取り込む価値がある(patterns)。
| モード | やること |
|---|---|
| Speculative Fan-Out | 1回の呼び出しで、使う可能性のある問いをすべて尋ねる(一部の入力でしか必要にならない問いも含む)。どの答えを使うかはコードが決める。限界コストは「使わないかもしれない問いを1つ尋ねるのはほぼ無料」と言えるほど低い |
| Confidence-Gated Routing | confidence を2本目の意思決定軸にする。高信頼なら自動実行、中信頼なら人に確認させ、低信頼なら実行しない |
| Composite Scoring | 「このチケットはどれだけ緊急か」を深刻度・感情・対応可能性の3つの Score に分解し、重みはプロンプトではなくコードに書く |
| Intent Routing | ユーザーの意図を分類し、対応する handler にルーティングする |
この使い方には暗黙の規律があり、ドキュメント自身も強調している。1つの問いでは、数秒で判断できることを1つだけ尋ねる。たとえば「このスタートアップのピッチは良いか」を判断するなら、市場規模・技術的実現性・差別化の3つの独立した問いに分解し、コード側で重み付けする。理由は精度だけではない。重みがコードにあれば、優先度を変えるのは係数を1つ変えるだけで、プロンプトを書き直さなくて済む。
Jev を既存のやり方と並べて比べる(左3列は pearpages の整理、右1列は我々の補足)。
| やり方 | ラベルデータ | レイテンシ | 判断1回のコスト | 確率の質 |
|---|---|---|---|---|
| 分類器の微調整(BERT 系) | 必要、数千件から | ミリ秒 | ほぼゼロ | ネイティブだが、校正は自分でやる必要がある |
| 制約付きデコード + logprobs を読む | 不要 | 数百ミリ秒〜秒 | プロンプト量程度 | logits の生値、粗い |
| LLM + JSON schema(モデルに信頼度を自己申告させる) | 不要 | 秒〜分 | 入力 + 出力 | 自己申告、信頼できない |
| Jev(公式の主張) | 不要 | 70〜500ミリ秒 | 入力のみ、$0.042/MTok | ネイティブ、未検証 |
制限もはっきりしている。依存チェーンは組めない——同じリクエスト内の問いは互いに独立で、後の問いで前の答えを条件にすることはできない。つなげたいならリクエストをもう1回送る。リクエストの予算は約 32k token。画像と音声の入力には対応していない。Choice は最大255個の選択肢。重みも論文もなく、コンテキスト/レート制限/リージョン/データ保持ポリシーはいずれも非公開だ。
これは公式ドキュメントと、私が読んだ第三者による分析の結論だ。ここからは、我々自身が実際に走らせて得た数字を示す。
実測:「信頼度」をしきい値として使うと何が起きるか
我々の問いは単純だ。公式が推奨する confidence-gated routing で自動化するとして、そのしきい値の軸は信用できるのか。
やり方はこうだ(完全なスクリプトと生の出力はリポジトリの content/system-one-models-jev-2026-09/verify/ にあり、コマンド1つで再実行できる)。
- 問題:229問。各問には確定した答えがある。state は本サイトの既存記事から切り出した本文の一節(700〜2200字。これらの記事は2026年9月に書かれたもので、モデルが暗記しているはずがない)。claim は state 内の原文そのまま(真)か、原文に対する単点改変(数値は有効数字1桁だけ変える、量級の単位、実体の置換、方向の反転)のいずれか。さらに最難関の一档として跨文陳述がある。別の記事にある具体的な量級を含む文を持ってきて、この state がそれを支持するかと問う。規則上、答えは「支持しない」だ。
- 確率の取り方8通り。同一モデル、同一の問題群:
| 条件 | 確率の出どころ |
|---|---|
| 自由テキスト · 判定が先 | モデルの自己申告(支持 1.00) |
| 自由テキスト · 確率が先 | モデルの自己申告、語順を反転(1.00 支持) |
JSON モード · probability フィールド | モデルの自己申告 |
| 自由テキスト · 意味を固定 | P= <支持的概率> VERDICT= <支持|不支持> |
| JSON モード · 意味を固定 | フィールド名は p_supported、プロンプトで「claim が支持される確率」と明記 |
| 先頭 token logprobs | Yes/No のみ回答させ、最初の token の確率を読む |
| 単一 token をプリフィル + logprobs | 回答を Verdict:、max_tokens=1 にプリフィルし、その1 token の確率を読む(Goedecke が述べた方法。beta エンドポイント経由) |
| 同じ問題を5回問う | temperature=0.7 を5回走らせ、Yes の割合を取る |
結果1:正解率はほとんど分化しない
| 確率の取り方 | 採点可能 | 解析失敗 | 正解率 | 誤り数 |
|---|---|---|---|---|
| 自由テキスト · 判定が先 | 228/229 | 1 | 99.6% | 1 |
| 自由テキスト · 確率が先 | 227/229 | 2 | 99.6% | 1 |
JSON · probability フィールド | 227/229 | 2 | 100.0% | 0 |
| 自由テキスト · 意味を固定 | 226/229 | 3 | 100.0% | 0 |
| JSON · 意味を固定 | 227/229 | 2 | 99.6% | 1 |
| 先頭 token logprobs | 228/229 | 1 | 100.0% | 0 |
| 単一 token をプリフィル | 229/229 | 0 | 99.1% | 2 |
| 5回サンプリング | 229/229 | 0 | 99.1% | 2 |
8档を合わせても誤りは7個しかなく、しかも4点に集中している。15 秒内 → 16 秒内(3回)、Claude 或 ChatGPT → OpenAI 或 ChatGPT(2回)、半夜 11 点 → 12 点、SDK 54 → SDK 55。つまり、この問題群では「問い方を変える」ことでモデルがより正確になることも、より不正確になることもない。これは我々が当初見たかった「LLM は平気ででたらめを言う」という話とは別物だ。
結果2:本当に分化するのは「この確率が使えるかどうか」
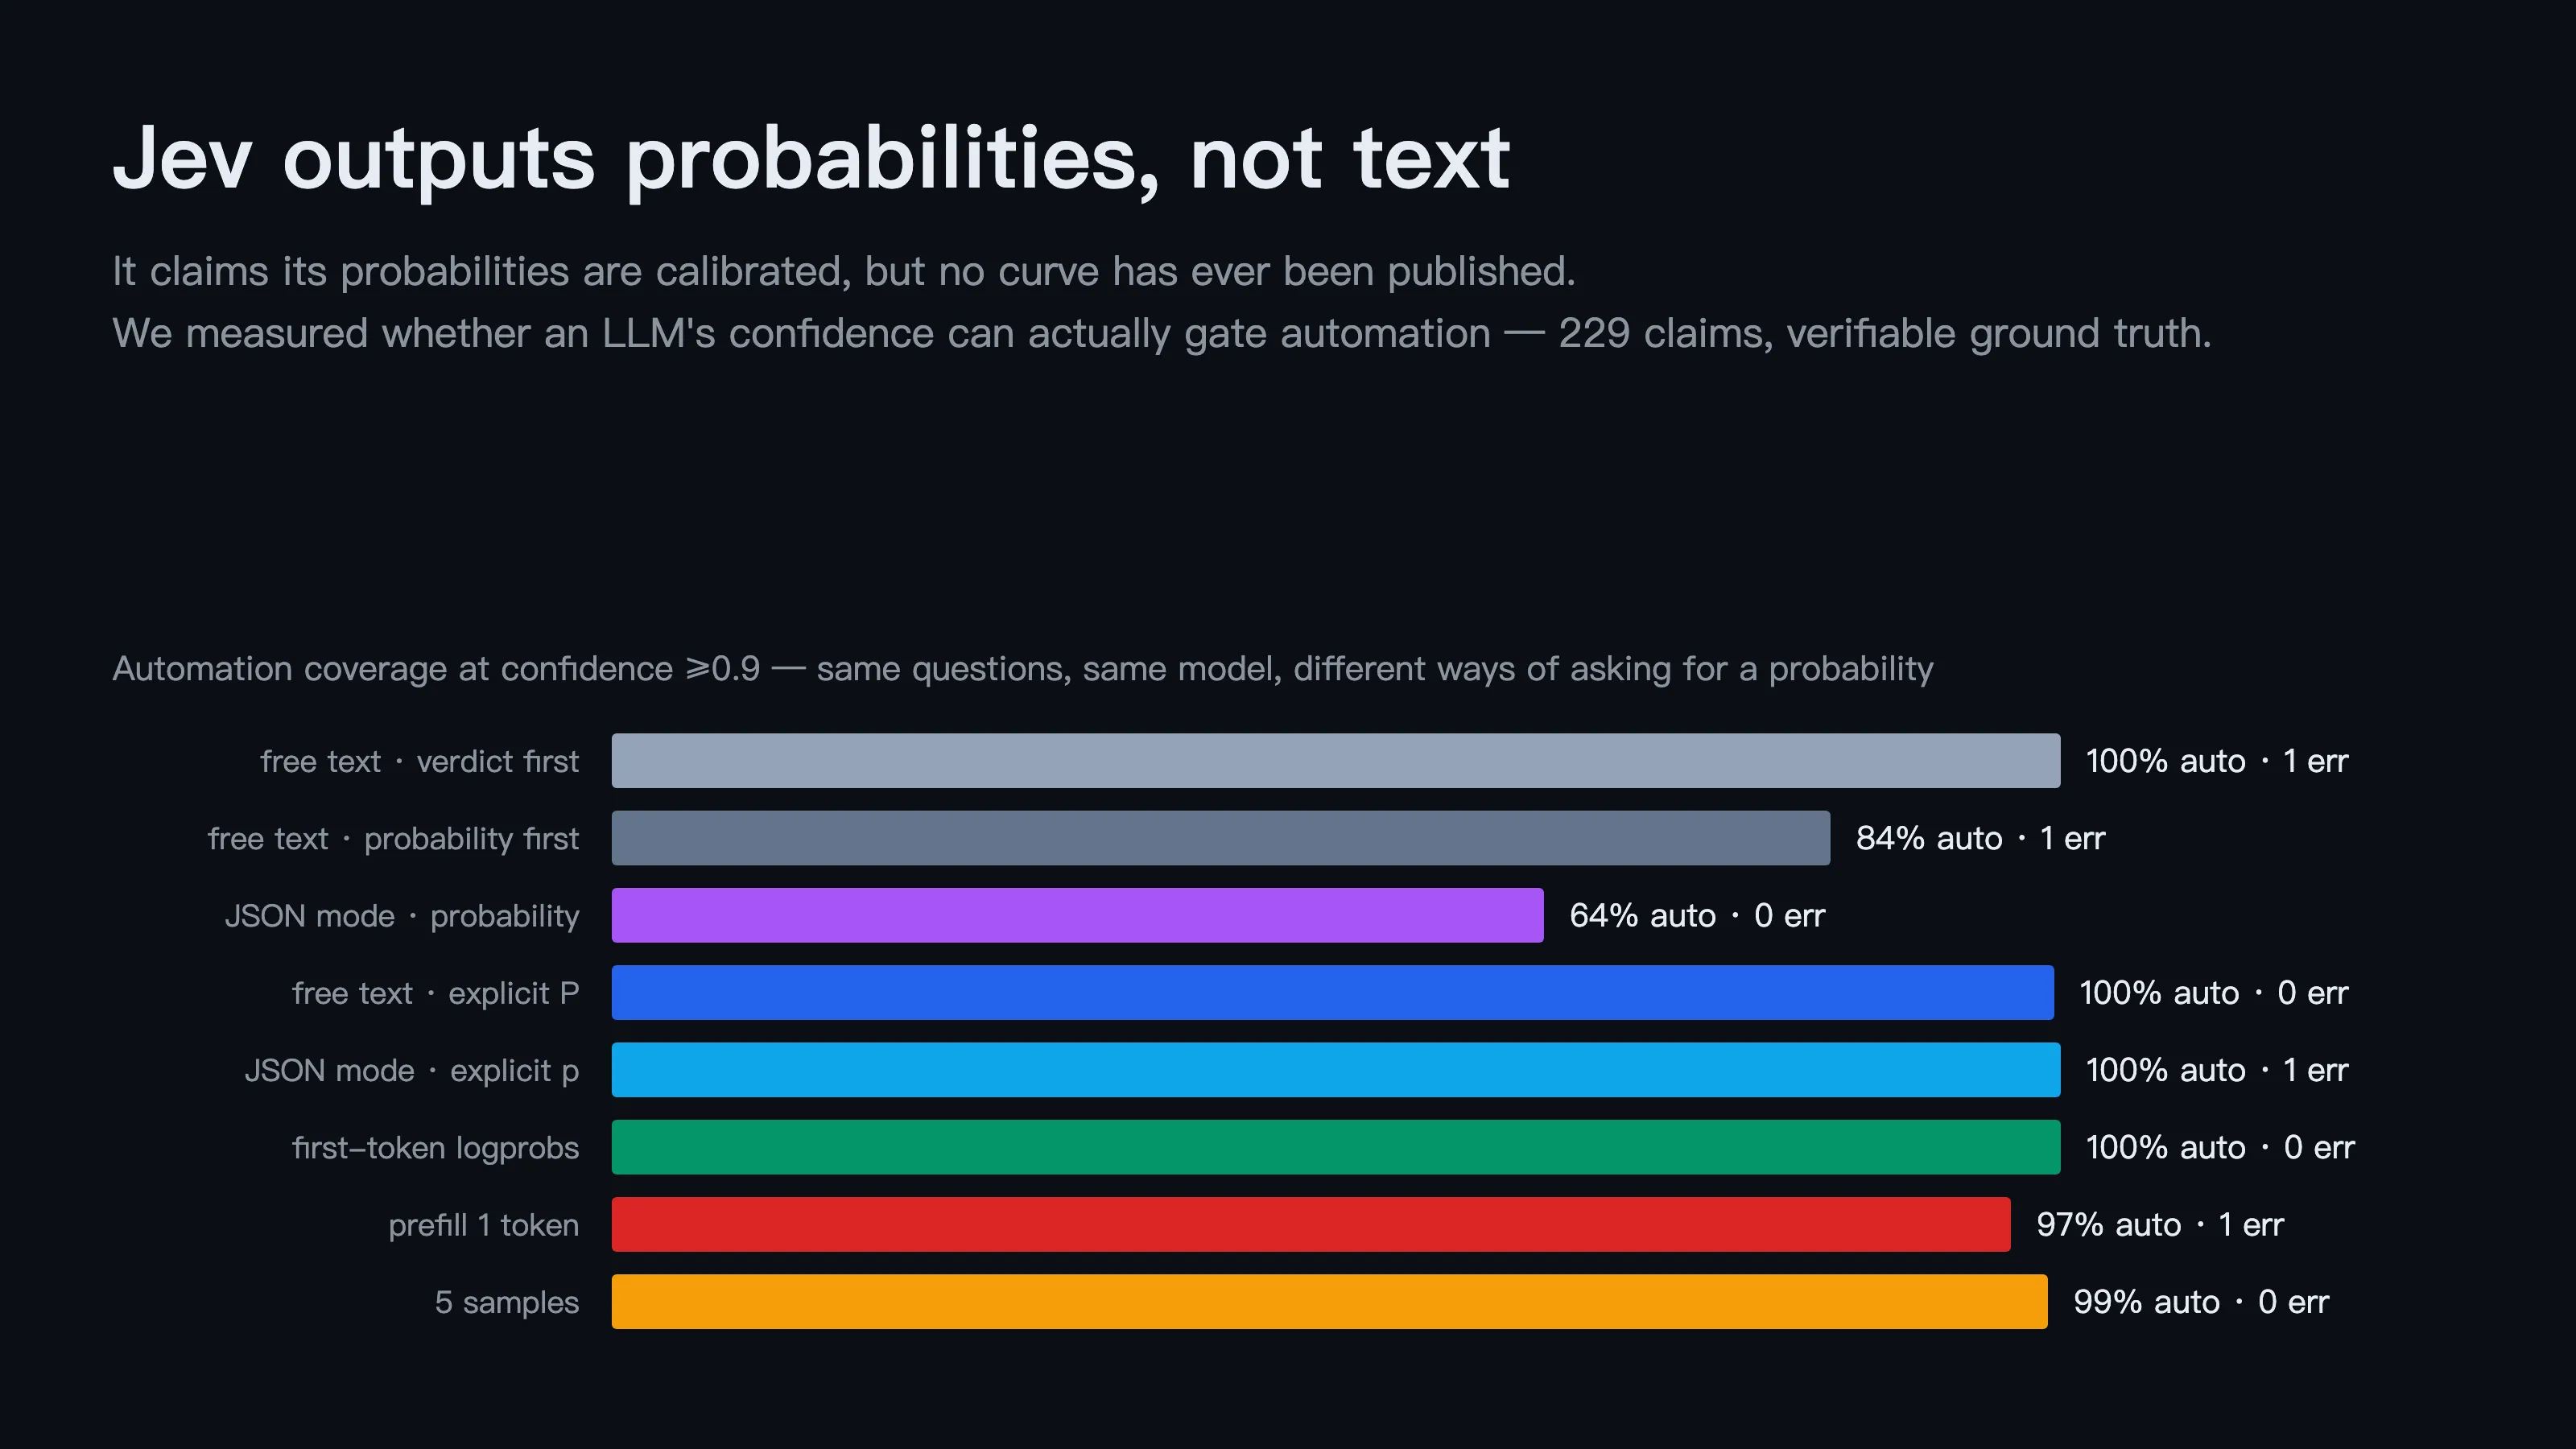
同じ問題群、同じモデルで、確率の取り方だけを変える。信頼度 ≥0.9 のときの自動化カバレッジは64%から100%まで振れる:
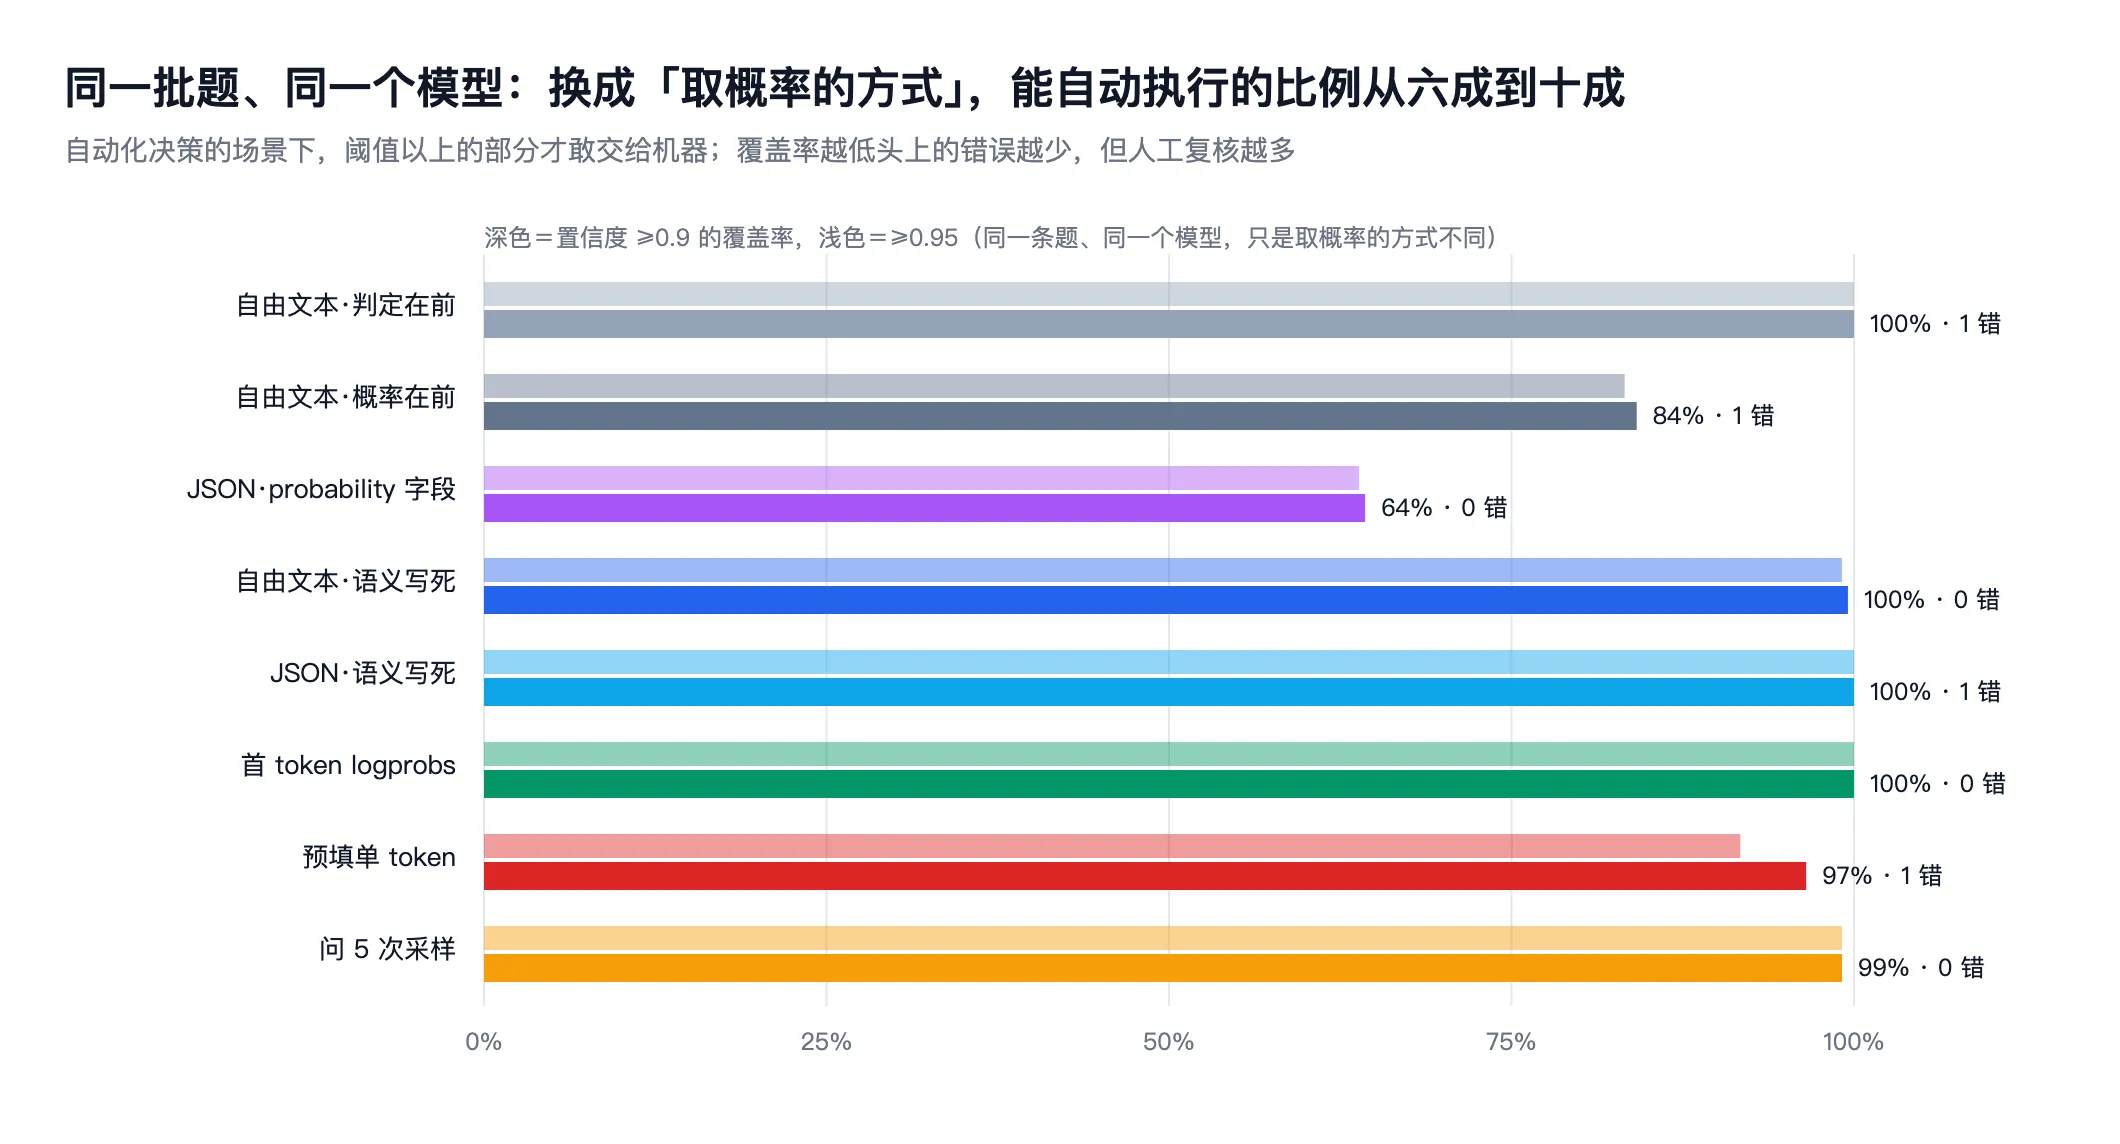
この列の差がどれほど意味を持つか。たとえば「確信度 ≥0.9」を自動実行のしきい値にしたとしよう。JSON モードで自己申告させると、本来まったく正しい判断のうち三分の一を人手による確認に回すことになる。一方、logprobs を読む方法ならほぼすべてが自動で通過し、誤りは 0 件だ。払っているのはモデルの代金ではなく、「確率の取り方」の代金である。
結果三:モデルが自己申告するあの数字は、何を指しているのか?
これがデータ全体でいちばん面白いマスだ。直感に反するのはここである。同じモデル、同じ問題群でも、「確率」を判定の前に書くか後に書くかだけで、同じ数字の意味が変わる。
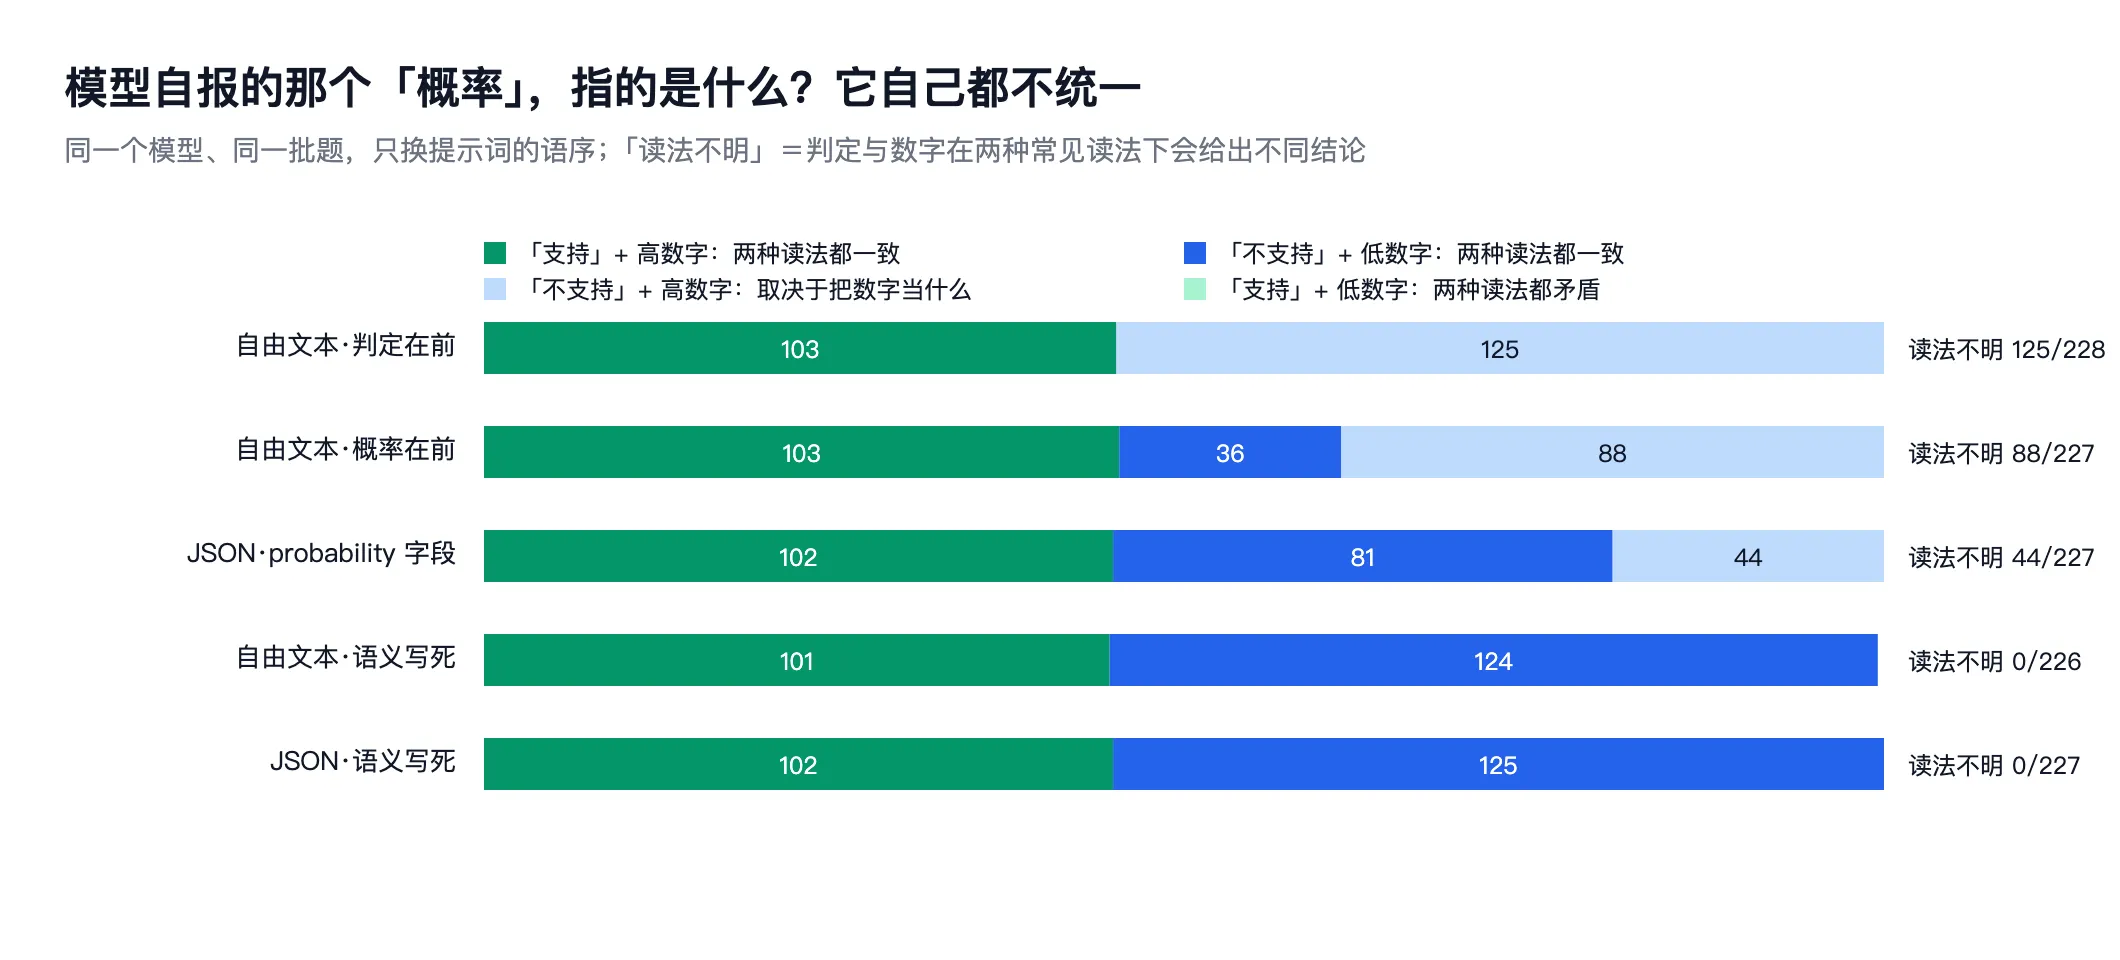
- 判定が先(
支持 1.00)の場合、125 件の否定回答はすべて 0.9 以上の数字を伴っていた——このときモデルは、明らかにこの数字を「自分がその判定にどれだけ自信があるか」として扱っている。 - 確率が先(
0.99 支持)の場合、同じ問題群でも 88 件はそのままだったが、36 件は0.00 不支持に変わった——同じプロンプトの下で、モデル自身が「この数字は何か」を統一できていない。 - JSON モードはさらに混沌としている。44 件が「不支持 + 高スコア」、81 件が「不支持 + 低スコア」で、同じ問題群の中で 2 通りの読み方が半々になっている。
- 意味をプロンプトに書き込む(
P=/p_supported、かつ「これは claim が支持される確率であり、あなたの判定への自信ではない」と明記する)と、読み方不明は 0 件に落ちた。
ECE(期待校准誤差)を自分で計算しても、同じことが見えてくる。JSON モードが自己申告する ECE は 0.359、自由テキスト(判定が先)は 0.002、logprobs を読む方式は 0.000。この 0.359 は「モデルの過信」ではなく意味の混乱であり、不一致はすべてあの 81+44 件から来ている。
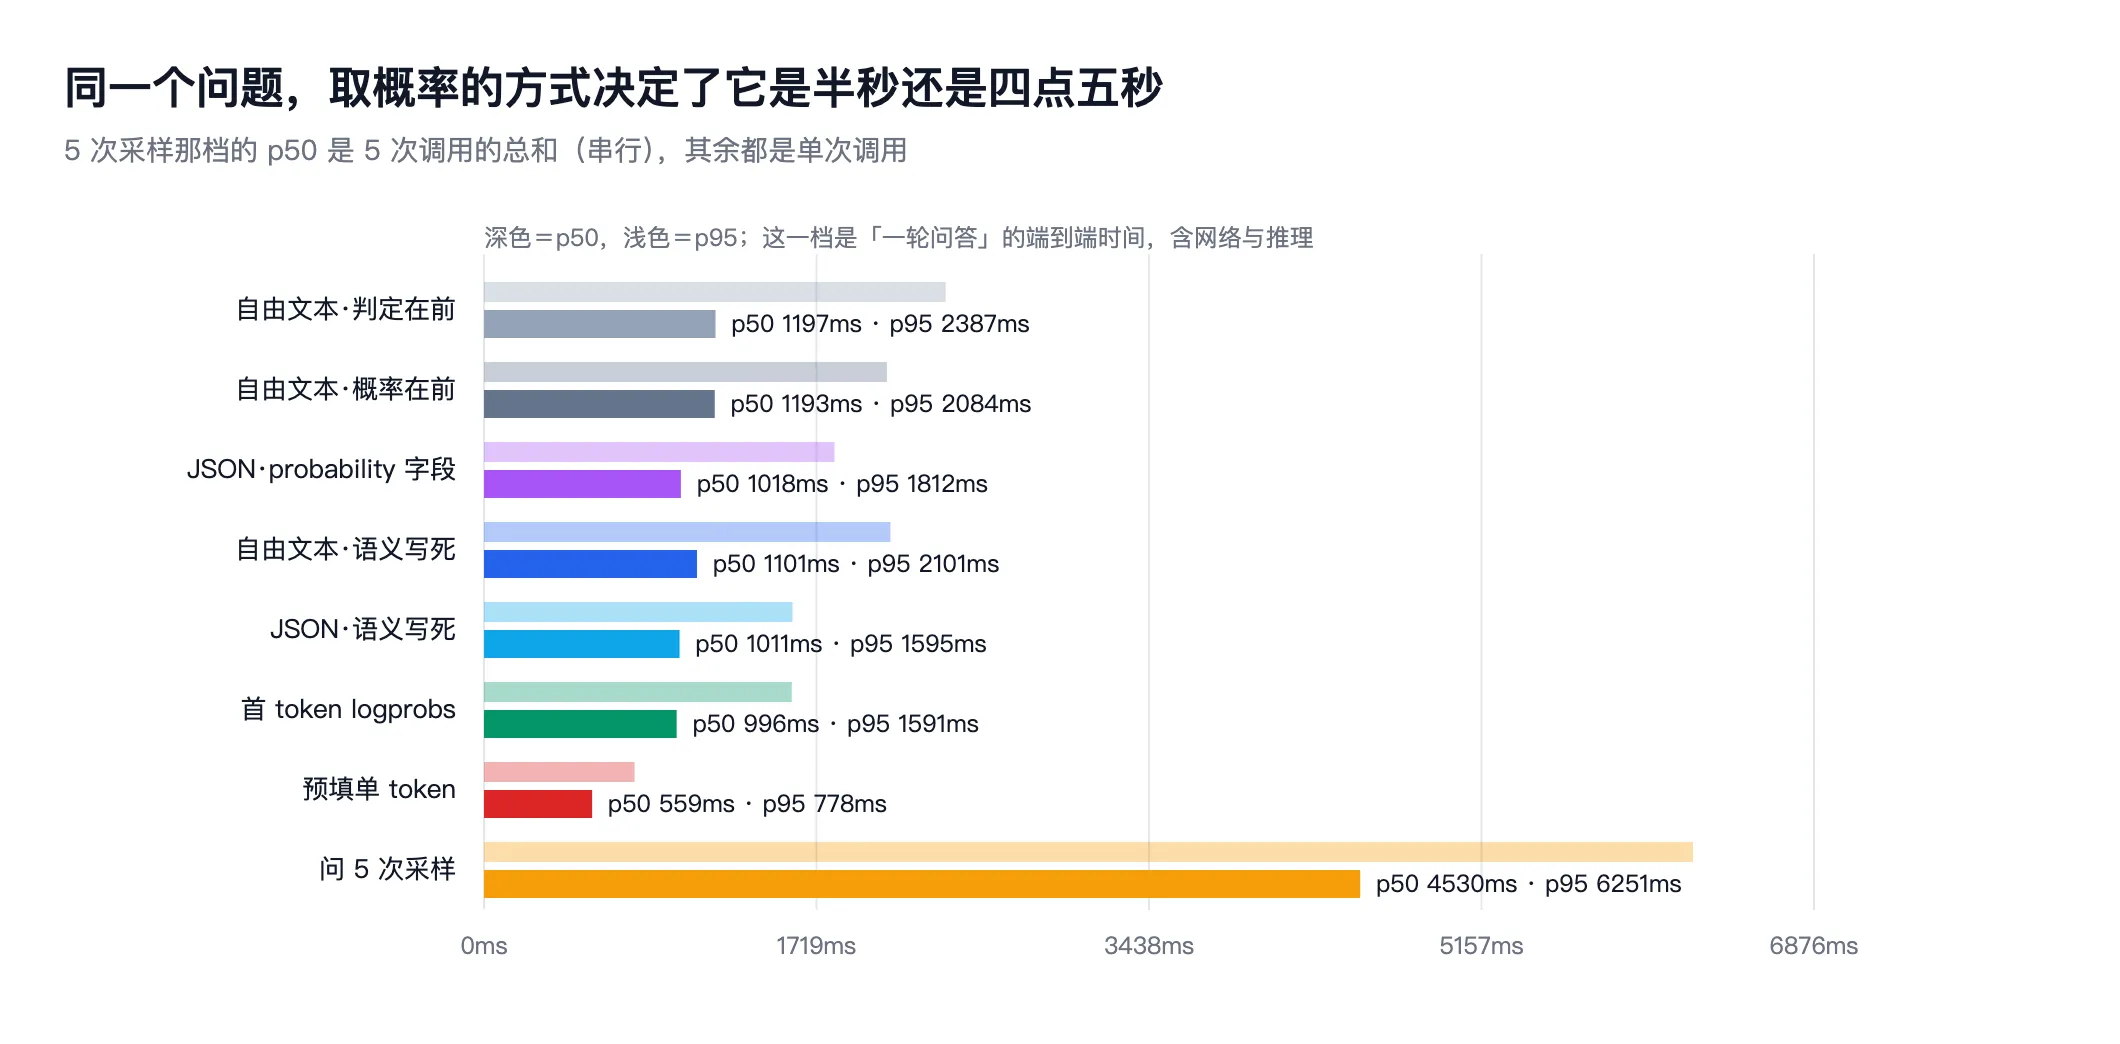
結果 4:最速の方法は Goedecke のあの手
回答を Verdict: に事前充填し、モデルには 1 トークンだけ生成させて、logprobs を読む:
| 確率の取り方 | レイテンシ p50 / p95 | 0.9 以上のカバレッジ | 0.9 以上での誤り |
|---|---|---|---|
| 単一トークンを事前充填 | 559 / 778 ms | 96.5% | 1 |
| 先頭トークンの logprobs(モデルに一巡考えさせる) | 996 / 1591 ms | 100% | 0 |
| 自由テキスト · 判定が先 | 1197 / 2387 ms | 100% | 1 |
| JSON モード | 1018 / 1812 ms | 64% | 0 |
| 5 回サンプリングして問う | 4530 / 6251 ms | 99.1% | 0 |
事前充填の方式は、同じモデルの自由テキストより2.1 倍速く、5 回サンプリングより8.1 倍速く、精度は 99.1%。Jev が主張する 70〜500ms と同じ桁であり(こちらは p50 で 559ms、しかも公衆網と推論モデルを挟んでいる)、しかも今日から使える——waitlist は不要だ。
タダというわけでもない。2 件の誤りはどちらも微妙な数字の書き換えにあり、一方は自ら低信頼(0.657、閾値で弾かれる)を報告し、もう一方は 0.905 を報告している(これは通ってしまう)。これがこのデータ群で「校准」が唯一顔を出す姿だ:最速の方法は、細部で静かに間違える。
結果5:「質問を増やしても応答時間はほとんど変わらない」は通常の LLM では成り立たない
公式ドキュメントには、複数の質問は1回の呼び出しで並列に評価され、「質問を増やしても応答時間はほとんど変わらず、増えた分のトークンしか消費しない」と記載されている。同じ state で質問数を1から20まで増やし、通常の LLM で試した:
| 1回の呼び出しに含まれる質問数 | レイテンシ中央値 | 出力トークン中央値 | 打ち切りの有無 |
|---|---|---|---|
| 1 | 1036 ms | 92 | なし |
| 4 | 1846 ms | 369 | なし |
| 10 | 4463 ms | 1200 | 3回中2回打ち切り |
| 20 | 4823 ms | 1200 | 3回中3回打ち切り |
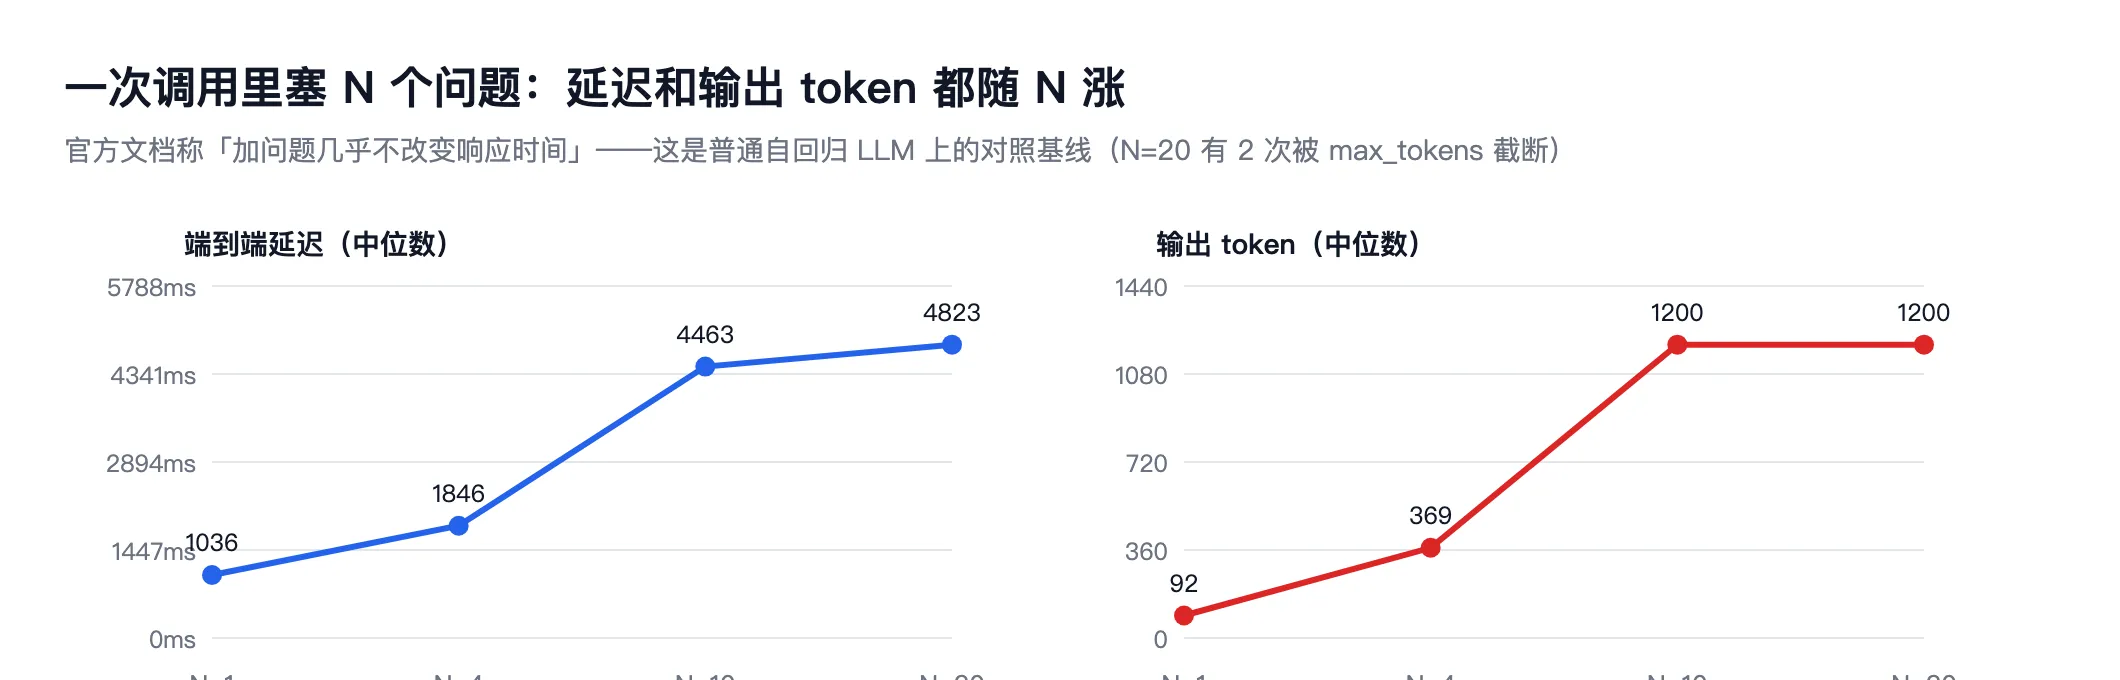
レイテンシは 4.6 倍、出力トークンは 13 倍、しかも N=10 から max_tokens で打ち切られる——通常の LLM では「20 問聞いてもほぼ無料」にはならない。ここがまさに System One 系モデルの構造的な強みだ。テキストを生成しなければ、「出力トークンが質問数に比例して増える」という問題自体が存在しない。
我々の判断
System One が売りにしているのは 2 つ——インターフェースの形と、学習目標だ。 我々が検証できるのは前者だけで、実測はこの形が確かに役立つことを示している。
- 「1 回のフォワードパス、単一トークン、確率を取る」という道は通じており、しかも今日にでも使える。 プリフィル + logprobs は我々の実測で 559ms、精度 99.1% だった。Jev の価値は「実現できるかどうか」ではなく、それを 1 つのモデル + 1 つの API に仕立てたこと(255 択の Choice、Score の期待値、Noul の単一確率)、さらに「型エラーを心配しなくていい」というエンジニアリング上の保証を添えたことにある。
- 自動化が成立するかどうかを決めるのは、モデルがどれだけ賢いかではなく、その確率がどこから来るかだ。 同じ問題群で、logprobs を読む方式は 100% 自動実行できるが、モデルに JSON 内で自信度を自己申告させると 64% にとどまる。しかも自己申告の数値は意味づけすら統一されていない。したがって公式の Confidence-Gated Routing パターンは、「モデルに JSON で confidence を報告させる」形で実装してはいけない——意味を schema に書き込んで検証するか、logprobs を直接読むか、複数回サンプリングするかだ。
- 「キャリブレーション」については、このデータ群では差を検出できなかった。どの方式でも確率は 0.00/1.00 に飽和し、信頼性図は 1 点に退化する。唯一顔を出したのは「最速の設定が、微妙な数字の書き換えに対して高信頼で誤る」という現象だ。これは Jev のキャリブレーションが無意味だという証明ではない。その価値は学習が実際に確率分布を変えたときに初めて存在するということであり、それには曲線が要る——TypeSafe は今もって公開しておらず、我々もテストできる Jev を持っていない。
- どんな場面でこの種のモデルを使う価値があるか:高頻度・低リスク・形が固定された判断(分類、ルーティング、スコアリング、検証)で、しかも閾値化が本当に必要——不確実なものを人間に回すか、高信頼のときに LLM の推論コストを省くか。使う価値がない場面:多段推論や長い思考の連鎖が要るもの(Jev は test-time compute を明確に放棄しており、この種のモデルの知能の上限はおそらく非推論モデル止まりだ)、テキスト生成が要るもの、そして領域をまたぐ汎化が未検証のもの。
エンジニア向けの実行可能な結論を 3 つ。
- 確率を閾値の軸に使いたいなら、まず意味を検証せよ。モデルに確率を自己申告させるのは最も手軽で最も信頼できない道だ。安価な確実性が欲しいなら、フィールドの定義を先に書き固め、数十件を抜き取り検査して定義どおりに答えているか確かめよ。
- 「機械が使える判断」を早く手に入れたいなら、まずプリフィル単一トークンをやれ。waitlist を待つ必要はない。2 倍程度の高速化は我々の環境で計測済みだ。代償は、微妙な違いの誤りが警報を鳴らさないこと——だから低リスクの高頻度意思決定に向き、レビュー系のタスクには向かない。
- 複数質問の 1 回呼び出しを無料と見なすな。通常の LLM では線形コストであり、しかも出力上限にぶつかる。「20 問聞いてもほぼ無料」が本当に必要なら、まさにモデルの種類を変えるべき場所だ。
境界:測れなかったこと
- Jev そのものは測っていない。 waitlist があるだけで、key も公開重みもない。記事中の Jev の数字(70–500ms、7/時間)はすべて公式の主張で、我々は再現していない。The Register が報じた $40M の調達、2 年間のステルスも二次情報だ。
- 単一モデル、単一コーパス、問題は自作。 DeepSeek の推論モデル 1 つ、当サイトの中国語記事、我々が自分で作った問題。したがってこれらの数字が示すのはキャリブレーションの形であり、リーダーボード上の順位ではない。
- コーパス間のドリフトテストはやっていない:これが最もやるべき次の一歩だ——チケットでよくキャリブレーションされたモデルも、あなたのコーパス、あなたの領域に移せばまったくキャリブレーションされていないかもしれない(pearpages のまとめもこの点に触れ、誰も測っていないと述べている)。スクリプトとデータセットをリポジトリに残したのはこのためだ:
verify/でcontent/のコーパスを差し替え、コマンド 1 つで再実行できる。 ScoreとChoiceは個別には測っていない。 本記事の問題はすべて二値判断(Noul の形)だ。多クラスおよび高基数(Jev は 255 択まで対応)のキャリブレーションは別物で、分けて測る必要がある。