Jev 不生成文本,只输出概率:把「一个判断」做成 API,我们实测了它要解决的那个问题
TypeSafe AI 的 Jev 把模型输出从字符串换成带概率的类型化判断,还声称概率是「校准」过的。这个前提没有人给过证据——我们拿 229 条有确定答案的声明,量了普通 LLM 的置信度到底能不能用来做自动化。
中文
复制
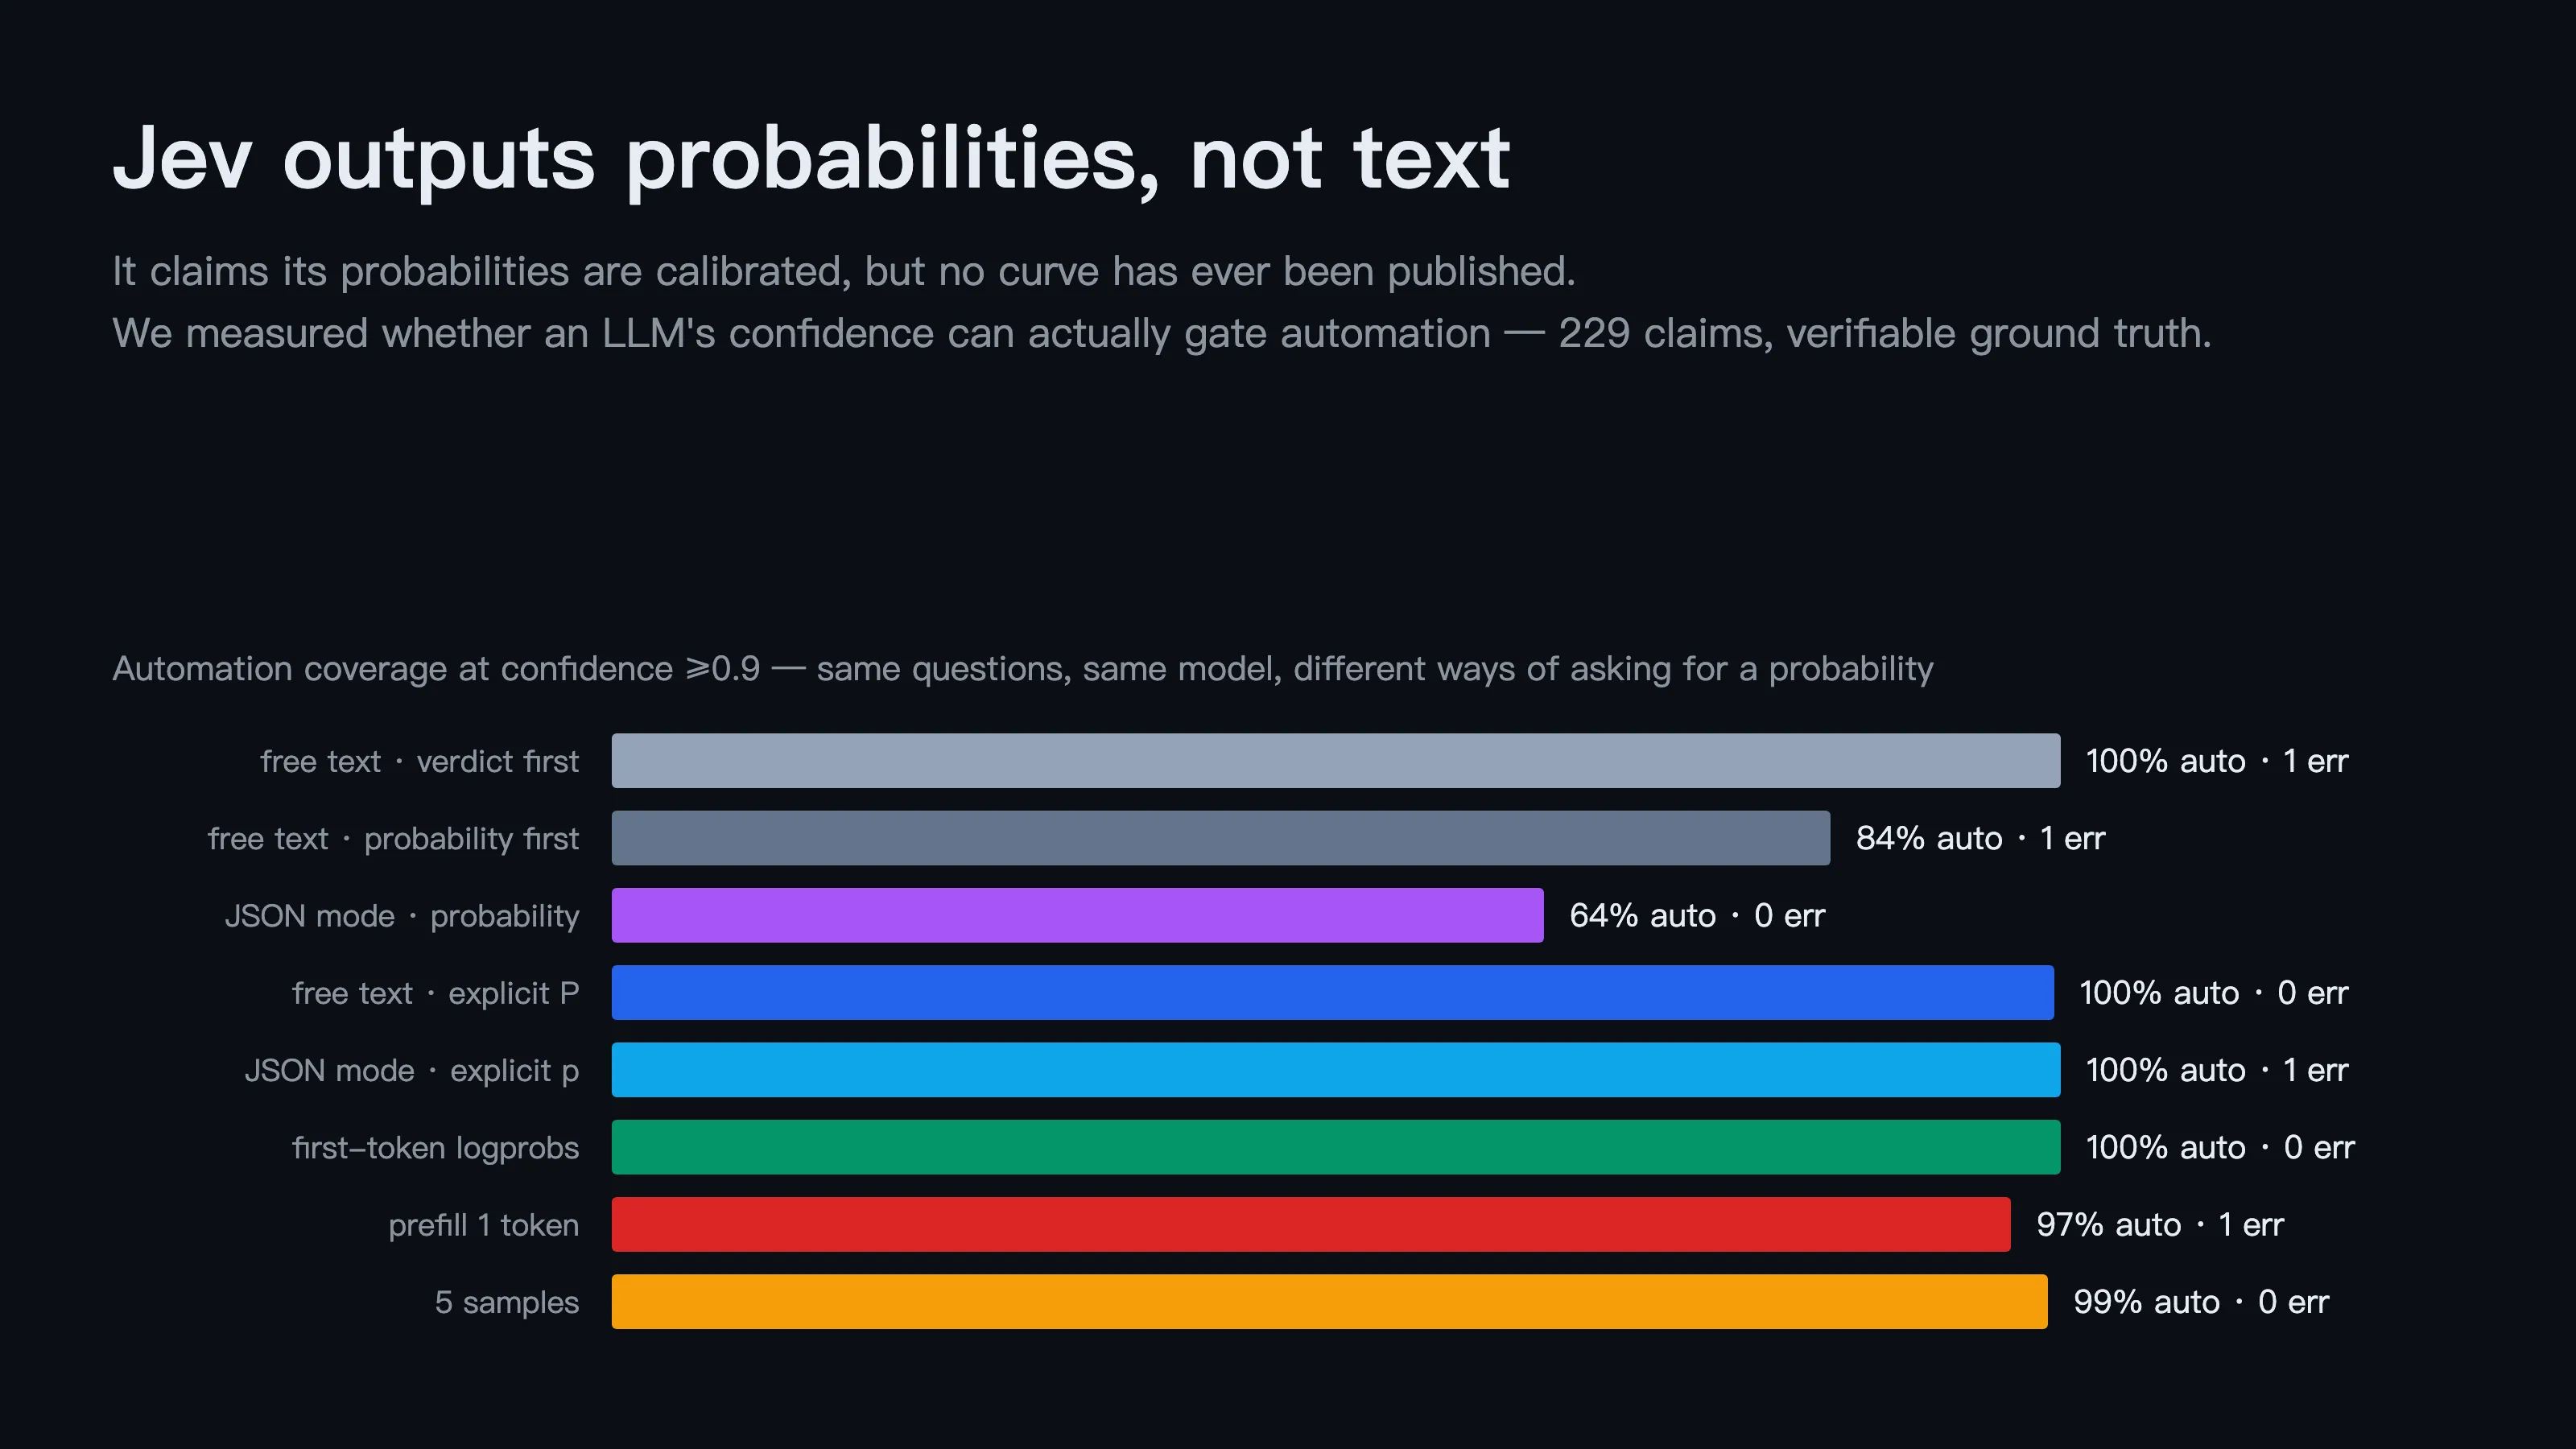
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev:一个不生成文本、只返回带概率的类型化判断的模型。它的卖点不是「更聪明」,而是「软件可以直接用」——以及概率是校准过的。这篇文章里,我们把它的定位、争议和工程形状讲清楚,然后实测那个没人验证过的前提。
大模型做判断已经很准了,可自动化还是没发生。TypeSafe AI 的创始人 Diogo Almeida 把这个问题问成了自己的创业题目:他在 OpenAI 参与过让语言模型学会遵循指令的那套方法(也就是 ChatGPT 背后的那部分研究),离开之后花了两年做一件看起来很小的事——把模型的输出从「字符串」换成「判断」。
Jev 就是这么个东西:你给它一段 state(文本、结构化数据都行)和若干个类型化的问题,它不做文本生成,直接返回类型化的答案和概率分布。三个原语,对应三种问题形状:
| 原语 | 问什么 | 返回 |
|---|---|---|
Choice | 在这些选项里选哪个? | choice、probabilities(选项上的分布)、confidence |
Score | 落在哪个等级? | score(可以是小数,等级上的期望值)、legend、probabilities、confidence |
Noul | 这句话是真的吗? | noul(0–1 的概率,没有单独的 confidence) |
官方文档里的例子长这样(quickstart):
response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={"billing": "Payment or subscription issues", "technical": "Bugs or integration problems"},
        ),
        "frustration": Score(instructions="How frustrated the customer appears", criteria=[...]),
        "is_urgent": Noul(instructions="The message conveys urgency or time-sensitivity"),
    },
)

response.answers["department"].choice   # "billing"
response.answers["frustration"].score   # 1.035
response.answers["is_urgent"].noul # 0.999三个词都值得琢磨。Choice 的选项是你给的(最多 255 个),模型只会在这几个里选,不会造出你没声明的类别;Score 返回的不是等级编号而是期望值,所以 1.035 这种小数是正常输出;Noul 只给一个概率,它自己就是信号。
一次调用可以塞多个问题,文档说每个问题「针对同一个 state 独立并行评估」,「加问题几乎不改变响应时间,只多花那几个问题的 token」——这句是这篇文章后面要单独测的。
它到底在卖什么
TypeSafe 自己的对照表把话说得挺清楚:LLM 用 RLHF/RLVR 训练,优化的是「人类喜欢的回答」和「可验证的奖励」;System One 用他们称为 RLCD(Reinforcement Learning for Calibrated Decisions)的方法训练,优化的是「在校准意义下诚实的概率」。对应到使用上:
| 现有 LLM | Jev(官方说法) | |
|---|---|---|
| 输出 | 字符串:可以是对的、错的、拒绝、或者幻觉 | 类型化取值:只可能是你声明过的选项 |
| 拿来做判断要做的额外工作 | 解析 + 校验 + 处理偶发格式崩溃 | 无(学不到「类型错误」这件事,官方说这是数学上不可能的) |
| 采样方式 | 自回归,一个 token 一个 token | 并行,一次前向出所有答案 |
| 延迟 | 端到端 3–329 秒(他们引的数据) | 70–500 毫秒 |
| 价格 | 输入 $0.20–10 / MTok,输出约 5 倍输入 | 输入 $0.042 / MTok,输出不计费 |
| 置信度 | 被追问时会报,但容易过度自信、不一致 | 每个答案自带,声称校准:置信度高就该更准 |
首页挂着两个数字:193.6 倍更快、444.6 倍更便宜(基于他们自己 4 个 workflow 的评测,参照系是 GPT-6 Astra 与 Fable 5.1 的平均)。首页那段 demo 用的是另一组数:Jev 0.114 秒 / $0.000081,对照的 LLM 8.566 秒 / $0.013880。
名字都有出处:System One / System Two 来自 Kahneman 的《思考,快与慢》(快而直觉 vs 慢而推理);Jev 来自 William Stanley Jevons——蒸汽机效率提高之后煤的消耗不减反增,也就是杰文斯悖论。TypeSafe 的意思是:智能便宜一个数量级,会带来更多数量级的新用法。
争议:三方在争「新不新」,没人验「前提成不成立」
Jev 发布当天在 Hacker News 上被拆得挺彻底(讨论)。有人一句话总结:「这基本就是个 zero-shot 分类器」——TypeSafe 的创始人回了一句 「exactly right!」。公司自己认了这个技术描述,争论于是从「这是什么」转到了「新在哪」:
| 别人说它像什么 | 谁说的 | 要点 |
|---|---|---|
| encoder 分类器(BERT / DeBERTa) | 多人 | 本来就不生成文本、不幻觉、推理更快 |
| GLiNER2 / GLiClass | 多人 | encoder 路线,一次前向出多个任务 |
| 约束解码 + 读 logits | 多人 | 把 LLM 逼进 schema,然后从 logits 里读概率 |
| 文本扩散模型 | 多人 | 「并行生成」是扩散式解码的特征 |
| Conformal prediction | 1 人 | 「感觉像把 conformal prediction 产品化了」 |
| DSPy 的类型化签名 | 1 人 | 在模型上套一层类型化预测抽象是成熟套路 |
对立面写得最完整的是 Sean Goedecke 那篇《Jev means structured output is interesting again》。他承认接口很酷,但认为快速的结构化输出今天就有:把回答预填成 "choice": ",只让模型生成一个受约束的 token,再从 logprobs 里读概率——他用自己的 Qwen2.5-1.5B-Instruct 试了,2–3 倍加速,并且结论是「Jev 可能没有实质技术护城河」。
同一篇文章里还有一句关键的话,正好是这篇文章的切入点:
Jev claims that their generated probabilities are "calibrated", but I haven't seen anything to suggest that these aren't just regular logit probabilities. … If so, I wish they'd written more about that in the announcement.
翻译过来:没人(包括 TypeSafe 自己)发过一条校准曲线。 他们对「不幻觉」的说法是诚实的——博客里写着「我们的数字不是经验性的,schema 匹配是数学上保证的」——但那只保证「不会给你没声明过的选项」,并不保证选对。Goedecke 称之为「语义上的诡辩」,我觉得更准确的描述是:它把「不会胡说」和「不会犯错」分开了,前者是类型系统的功劳,后者它没证明。
Hacker News 上有两个问题一直没人回答,也是最有价值的两个:
- RLCD 到底改了训练目标里的什么? 好处能不能和架构改动分开?公司只说「架构暂时保密,以后写论文」。
- 「校准」是跟谁比? 是「像前沿 LLM 一样校准,只是更便宜」——那可能是个很低的门槛;还是「比前沿 LLM 校准得多」——那需要曲线。
我们拿不到 Jev 的 early access(只有 waitlist,也还没有公开权重)。所以我们没法验证他们的数字。但我们可以验证他们的前提:普通 LLM 在结构化判断上给出的概率,到底能不能拿来做自动化决策?如果不能,缺的是训练目标,还是提示词写法?
后面是实测部分。先把工程形状讲清楚,因为「值不值得用」这个问题,一半取决于你打算怎么用它。
工程形状:它想替换的不是你的聊天模型
官方文档给了四种模式,值得抄进设计里(patterns):
| 模式 | 做什么 |
|---|---|
| Speculative Fan-Out | 一次调用把所有可能要用到的问题都问了(包括只有部分输入才需要的问题),代码决定用哪几个答案。边际成本低到「问一个可能用不上的问题约等于免费」 |
| Confidence-Gated Routing | 把 confidence 当第二根决策轴:高置信自动执行、中置信让人复核、低置信不执行 |
| Composite Scoring | 把「这个工单多紧急」拆成严重性、情绪、可操作性三个 Score,权重写在代码里,而不是写进提示词 |
| Intent Routing | 分类用户意图,路由到对应 handler |
这套用法有个隐含的纪律,文档自己也强调了:每个问题只问一件能在几秒内判断的事。要判断「这个创业路演好不好」,就拆成市场规模、技术可行性、差异化三个独立问题,然后在代码里加权。理由不只是准确率——权重写在代码里,改变优先级就是改一个系数,不用重写提示词。
把 Jev 放进已有做法里对照(左三列来自 pearpages 的整理,右一列是我们的补充):
| 做法 | 需要标注数据 | 延迟 | 每次判断的成本 | 概率质量 |
|---|---|---|---|---|
| 微调分类器(BERT 类) | 要,几千条起 | 毫秒级 | 接近零 | 原生,但校准要你自己做 |
| 约束解码 + 读 logprobs | 不要 | 数百毫秒到秒级 | 提示词量级 | logits 原始值,粗糙 |
| LLM + JSON schema(让模型自报置信度) | 不要 | 秒级到分钟级 | 输入 + 输出 | 自报,不可靠 |
| Jev(官方声称) | 不要 | 70–500 毫秒 | 只有输入,$0.042/MTok | 原生,未验证 |
限制也很清楚:没有依赖链——同一个请求里的问题互相独立,后一个问题不能用前一个的答案当条件,要串联就再发一次请求;请求预算约 32k token;不支持图像和音频输入;Choice 最多 255 个选项;没有权重、没有论文、上下文/限流/区域/数据保留政策都不公开。
这些是官方文档和我读到的第三方分析的结论。接下来是我们自己跑出来的数。
实测:把「置信度」拿来当阈值,会发生什么
我们的问题很简单:如果你要按官方推荐的 confidence-gated routing 来做自动化,那根阈值轴能不能信?
做法是这样(完整脚本和原始输出都在仓库的 content/system-one-models-jev-2026-09/verify/ 里,可一条命令重跑):
- 题:229 条,每条都有确定答案。state 是本站已有文章里切出来的一段正文(700–2200 字,这些文章 2026 年 9 月才写,模型不可能背过);claim 要么是 state 里的原句(真),要么是对原句做单点篡改(数字只动一位有效数字、量级单位、实体替换、方向反转)。另外有一档最难:跨文陈述——拿另一篇文章里带具体量级的句子,问这个 state 支持吗,按规则答案是「不支持」。
- 八种取概率的方式,同一个模型、同一批题:
| 条件 | 概率从哪来 |
|---|---|
| 自由文本 · 判定在前 | 模型自报(支持 1.00) |
| 自由文本 · 概率在前 | 模型自报,语序反转(1.00 支持) |
JSON 模式 · probability 字段 | 模型自报 |
| 自由文本 · 语义写死 | P= <支持的概率> VERDICT= <支持|不支持> |
| JSON 模式 · 语义写死 | 字段叫 p_supported,提示词里写明它是「claim 被支持的概率」 |
| 首 token logprobs | 只答 Yes/No,读第一个 token 的概率 |
| 预填单 token + logprobs | 把回答预填成 Verdict:、max_tokens=1,读那一个 token 的概率(Goedecke 说的做法,走 beta 端点) |
| 同题问 5 次 | temperature=0.7 跑 5 次,取 Yes 的比例 |
结果一:准确率几乎不分化
| 取概率的方式 | 可评分 | 解析失败 | 准确率 | 错误数 |
|---|---|---|---|---|
| 自由文本 · 判定在前 | 228/229 | 1 | 99.6% | 1 |
| 自由文本 · 概率在前 | 227/229 | 2 | 99.6% | 1 |
JSON · probability 字段 | 227/229 | 2 | 100.0% | 0 |
| 自由文本 · 语义写死 | 226/229 | 3 | 100.0% | 0 |
| JSON · 语义写死 | 227/229 | 2 | 99.6% | 1 |
| 首 token logprobs | 228/229 | 1 | 100.0% | 0 |
| 预填单 token | 229/229 | 0 | 99.1% | 2 |
| 问 5 次采样 | 229/229 | 0 | 99.1% | 2 |
八档加起来只有 7 个错误,而且集中在四个点上:15 秒内 → 16 秒内(三次)、Claude 或 ChatGPT → OpenAI 或 ChatGPT(两次)、半夜 11 点 → 12 点、SDK 54 → SDK 55。换句话说,在这批题上「换个方式问」不会让模型更准,也不会让它更不准——这跟我们原本想看到的「LLM 爱胡说」不是一回事。
结果二:真正分化的是「这份概率能不能用」
同样一批题、同一个模型,只换取概率的方式,置信度 ≥0.9 时的自动化覆盖率从 64% 到 100%:
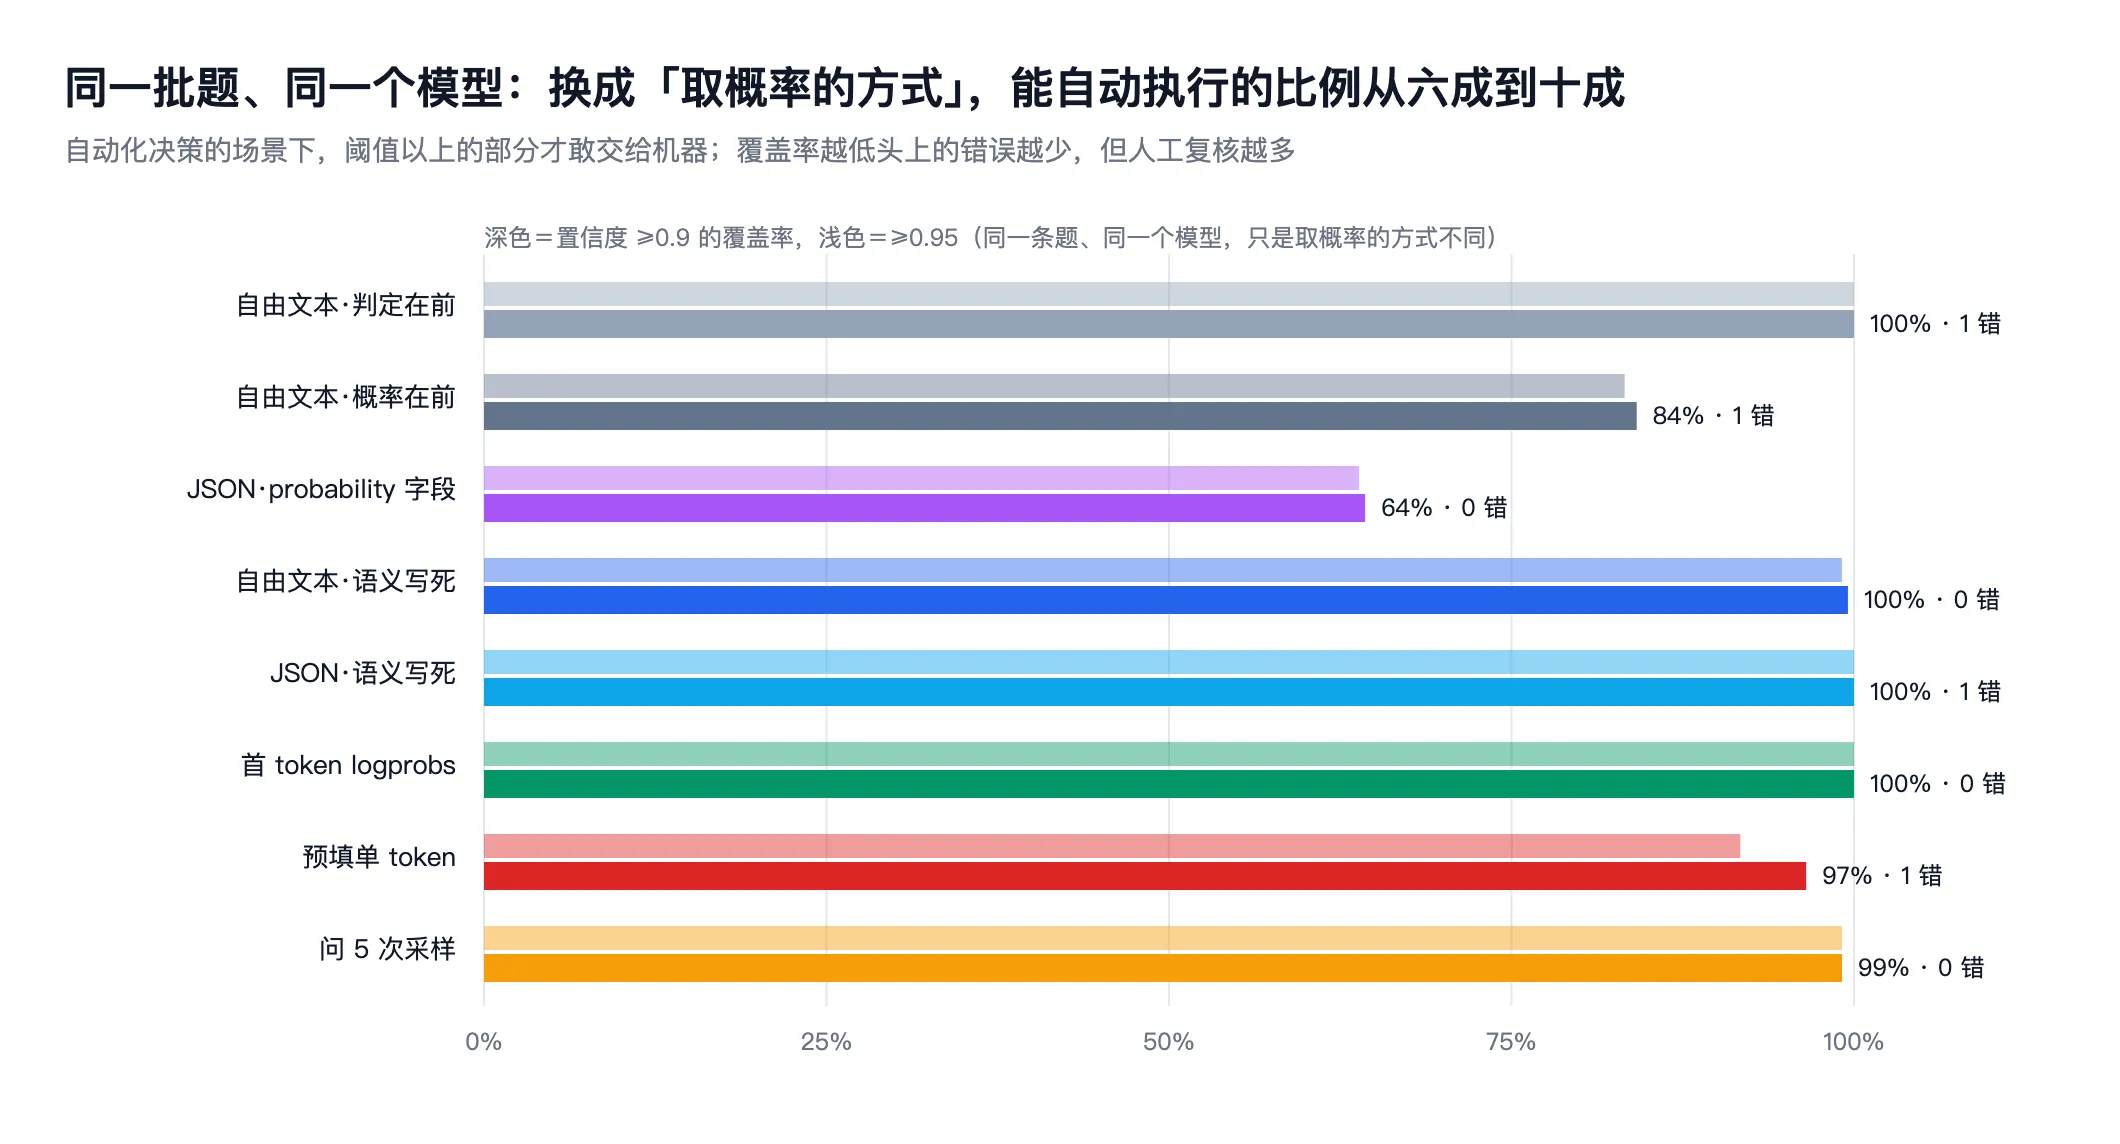
这一列的差别有多大意义:假设你要把「置信度 ≥0.9」当成自动执行的门槛,用 JSON 模式自报的话,你会在本来完全正确的判断上把三分之一送去做人工复核;而读 logprobs 的做法几乎全部能自动过掉,错误 0 个。你付的不是模型的钱,是「取概率的方式」的钱。
结果三:模型自报的那个数字,指什么?
这是整批数据里最有意思的一格。反常识的地方在于:同一个模型、同一批题,只把「概率」写在判定前面还是后面,同一个数字的意思就变了。
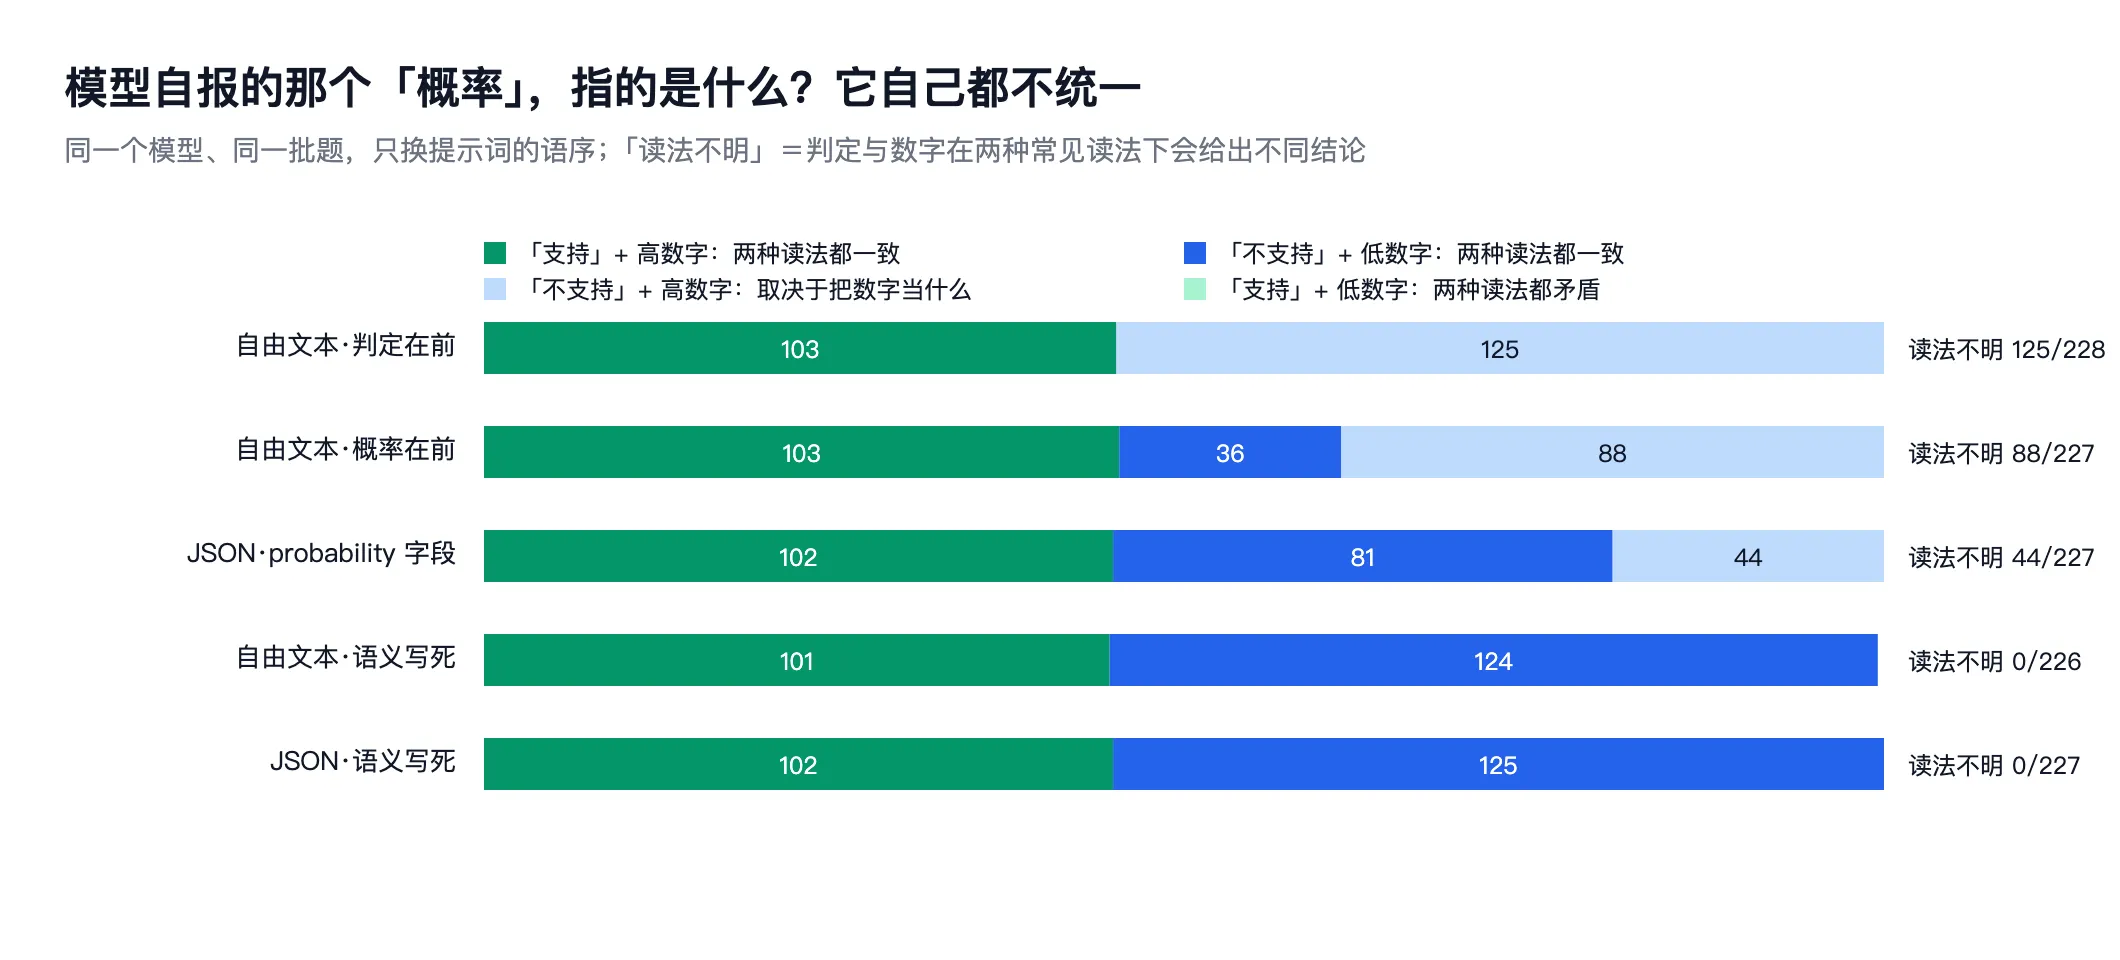
- 判定在前(
支持 1.00)时,125 个否定回答全部配了 ≥0.9 的数字——这时模型显然把这个数字当成「我对这个判定的把握」。 - 概率在前(
0.99 支持)时,同一批题里 88 条仍然这样,36 条却变成了0.00 不支持——同一个提示词下,模型自己对「这个数字是什么」都不统一。 - JSON 模式更乱:44 条是「不支持 + 高分」、81 条是「不支持 + 低分」,同一批题里两种读法各占一半。
- 把语义写进提示词(
P=/p_supported,并明确写「这是 claim 被支持的概率,不是你对判定的把握」)之后,读法不明降到 0 条。
自己算一下 ECE(期望校准误差)也能看出同一件事:JSON 模式自报的 ECE 是 0.359,自由文本(判定在前)0.002,读 logprobs 0.000。这个 0.359 不是「模型过度自信」,而是语义混乱——所有分歧都来自那 81+44 条。
结果四:最快的做法是 Goedecke 那招
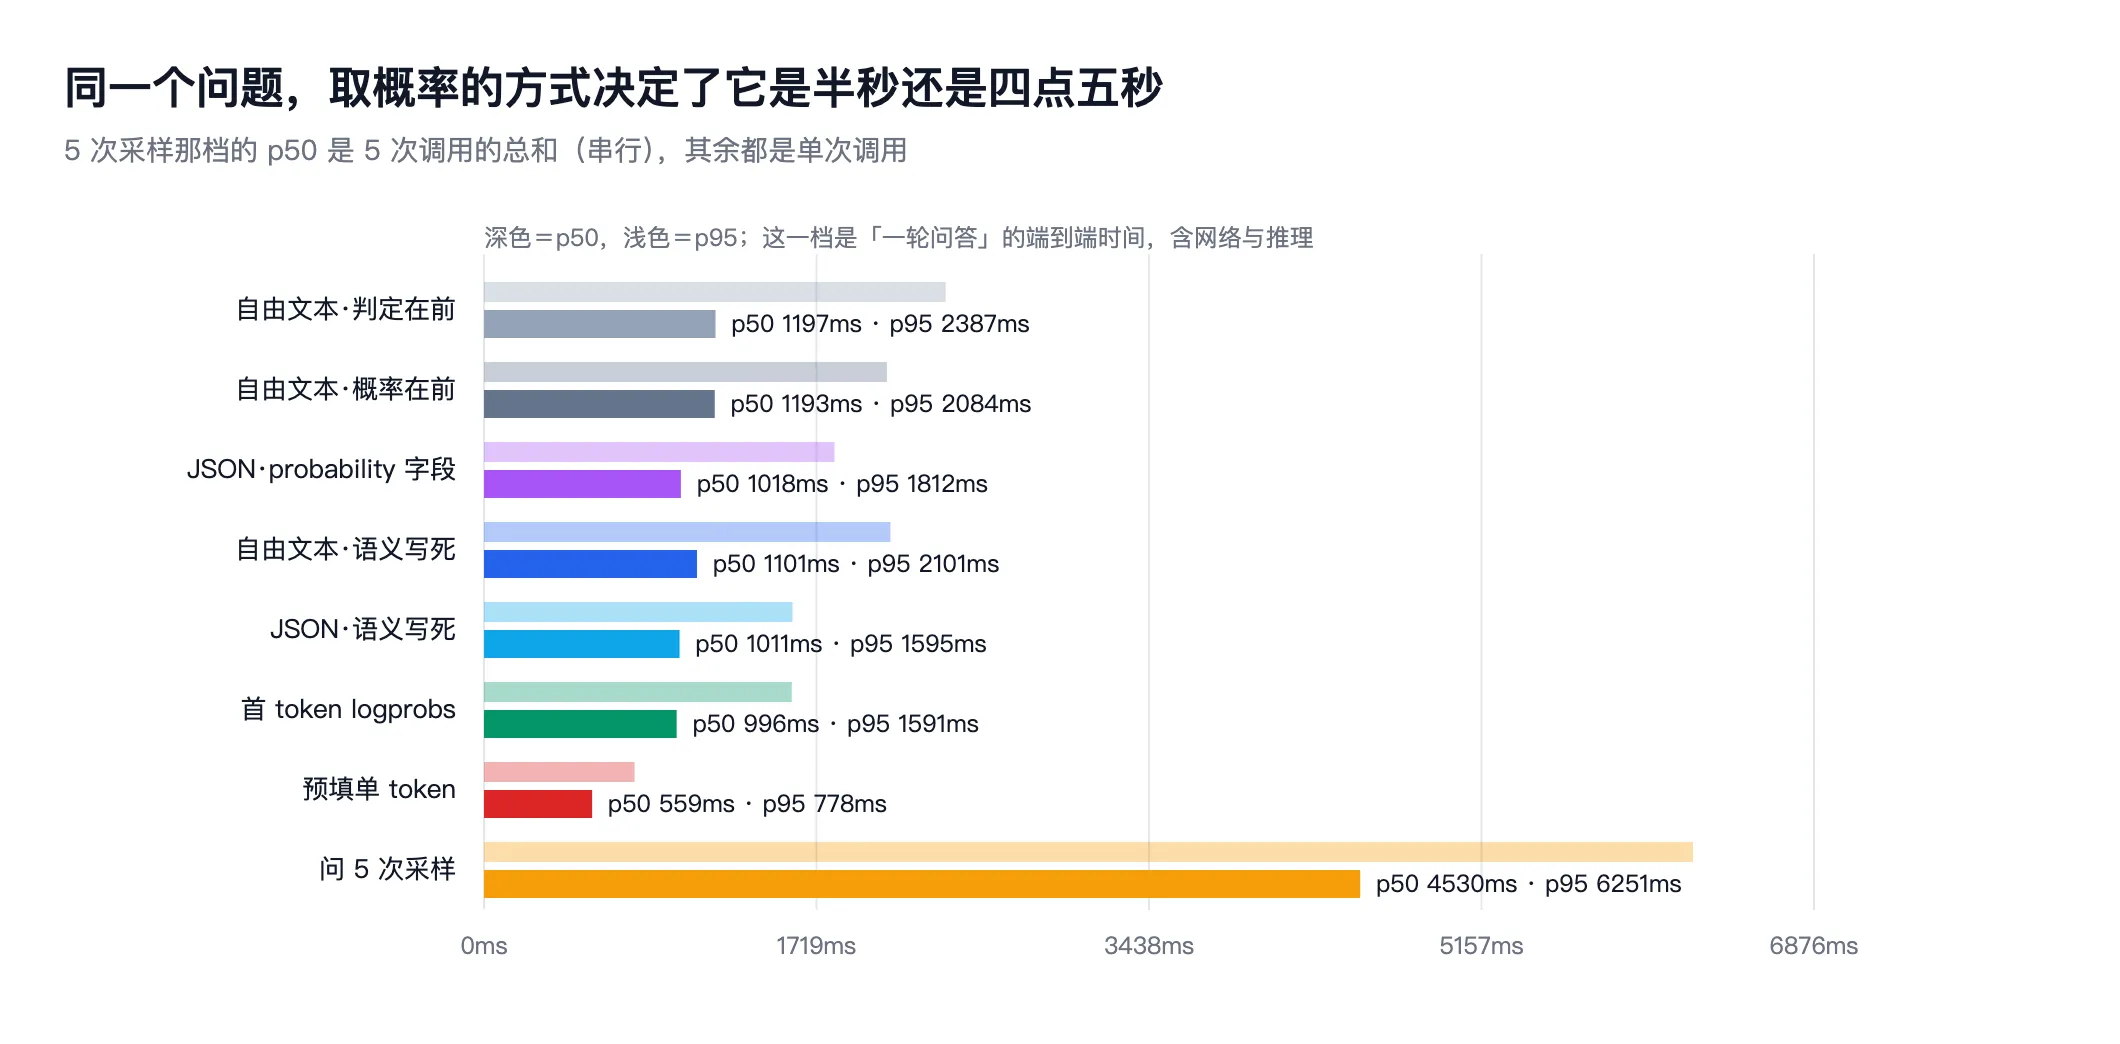
把回答预填成 Verdict:、只让模型生成一个 token,然后读 logprobs:
| 取概率的方式 | 延迟 p50 / p95 | ≥0.9 覆盖率 | ≥0.9 内的错误 |
|---|---|---|---|
| 预填单 token | 559 / 778 ms | 96.5% | 1 |
| 首 token logprobs(要模型先想一轮) | 996 / 1591 ms | 100% | 0 |
| 自由文本 · 判定在前 | 1197 / 2387 ms | 100% | 1 |
| JSON 模式 | 1018 / 1812 ms | 64% | 0 |
| 问 5 次采样 | 4530 / 6251 ms | 99.1% | 0 |
预填那档比同模型的自由文本快 2.1 倍,比 5 次采样快 8.1 倍,准确率 99.1%。它和 Jev 声称的 70–500ms 是同一个量级(我们是 559ms 的 p50,还隔着公网和一个推理模型),而它是今天就能用的——不需要 waitlist。
它也不是白拿的:两个错误都在细微的数字改写上,其中一个自己报出了低置信(0.657,会被阈值拦下),另一个报的是 0.905(会被放过去)。这就是「校准」在这批数据里唯一露头的样子:最快的做法在细节上错得不响。
结果五:「加问题几乎不改变响应时间」在普通 LLM 上不成立
官方文档说多个问题在一次调用里并行评估、「加问题几乎不改变响应时间,只多花那几个问题的 token」。我们在同一个 state 上把问题数从 1 加到 20,测了一遍普通 LLM:
| 一次调用里的问题数 | 延迟中位数 | 输出 token 中位数 | 有没有被截断 |
|---|---|---|---|
| 1 | 1036 ms | 92 | 否 |
| 4 | 1846 ms | 369 | 否 |
| 10 | 4463 ms | 1200 | 2/3 次被截断 |
| 20 | 4823 ms | 1200 | 3/3 次被截断 |
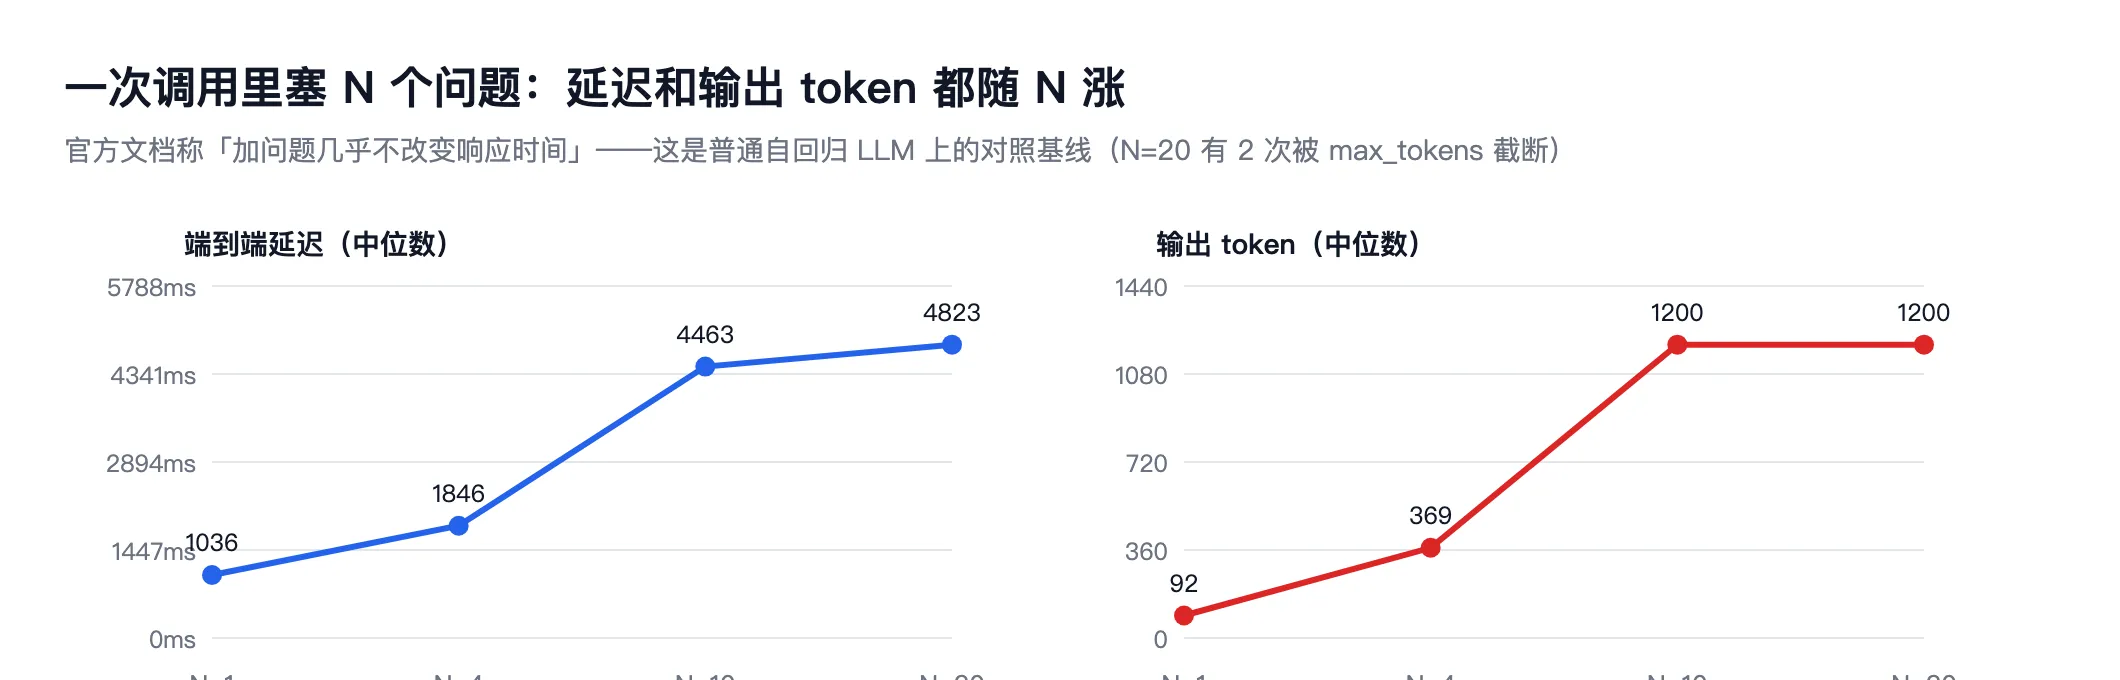
延迟 4.6 倍、输出 token 13 倍,而且从 N=10 起就被 max_tokens 截断——普通 LLM 做不到「问 20 个问题约等于免费」。这恰好是 System One 那类模型的结构性卖点:不生成文本,就没有「输出 token 随问题数线性增长」这件事。
我们的判断
System One 卖的是两样东西:一个接口形状,和一个训练目标。 我们只能验前者,而实测说明这个形状确实有用:
- 「一次前向、单 token、拿概率」这条路是通的,而且今天就能走。 预填 + logprobs 在我们的实测里是 559ms、99.1% 准确率。Jev 的价值不在「能不能做到」,而在把它做成一个模型 + 一套 API(255 个选项的 Choice、Score 的期望值、Noul 的单一概率),再加上「不用担心类型错误」这条工程保证。
- 决定自动化能不能落地的,不是模型多聪明,而是那份概率的来源。 同一批题:读 logprobs 有 100% 可以自动执行,让模型在 JSON 里自报置信度只有 64%。而且自报的数字语义都不统一。所以官方的 Confidence-Gated Routing 模式,不要用「让模型在 JSON 里报一个 confidence」来实现——要么把语义写进 schema 并验证,要么直接读 logprobs / 多次采样。
- 「校准」这件事,在这批数据里我们测不出差异:所有方式的概率都饱和在 0.00/1.00,可靠性图退化成一个点。唯一露头的是「最快那档在细微数字改写上高置信地错」。这不是证明 Jev 的校准没用,而是说明它的价值只有在其训练真的改变了概率分布时才存在,而那需要一条曲线——TypeSafe 至今没发,我们也没有 Jev 可测。
- 什么场景值得上这类模型:高频、低风险、形状固定的判断(分类、路由、打分、校验),且你确实需要阈值化——要么把不确定的交给人工,要么在高置信时省掉 LLM 的推理开销。什么场景不值得:需要多跳推理或长链思考的(Jev 明确放弃了 test-time compute,这类模型的智能上限大概就卡在非推理模型这一档)、需要生成文本的、以及跨领域泛化没验证过的。
给工程师的三条可执行结论:
- 想拿概率当阈值轴,先验证语义。让模型自报概率是最方便也最不可靠的一条路;要便宜的确定性就预先写死字段定义,再抽查几十条看它有没有真的按定义回答。
- 想快点拿到「机器可用的判断」,先做预填单 token。不用等任何 waitlist,2 倍左右的加速在我们这里测出来了,代价是细微差别上的错误不会报警——所以它适合低风险的高频决策,不适合复核类任务。
- 多问题一次调用别当成免费的。在普通 LLM 上它是线性成本,而且会撞输出上限;如果你真的需要「问 20 个问题约等于免费」,那正是需要换一类模型的地方。
边界:我们没测到什么
- 没有测到 Jev 本身。 只有 waitlist,没有 key,也没有公开权重。文章里所有 Jev 的数字(70–500ms、$0.042/MTok、193.6x/444.6x、Doom demo 的 $7/小时)都是官方说法,未经我们复现;The Register 报道的 $40M 融资、两年 stealth 也属于二手。
- 单一模型、单一语料、题目自制。 一个 DeepSeek 的推理模型、本站的中文文章、我们自己构造的题。所以这些数字说明的是校准的形状,不是排行榜上的名次。
- 没做跨语料漂移测试:这是最该做的下一步——一个在工单上校准良好的模型,换到你的语料、你的领域上可能完全不校准(pearpages 的整理里也提到这一点,并说没人测过)。我们把脚本和数据集都留在仓库里,就是为了这个:
verify/里换掉content/语料,一条命令重跑。 Score和Choice我们没有单独测。 本文的题都是二值判断(Noul 形状)。多分类和高基数(Jev 支持到 255 个选项)的校准是另一件事,需要分开测。