AI コーディング
もっと見る AI コーディング
ホームエージェント向けテスト・検証技術の水準は実際どうなのか?
著者はZstd実装の評価で26のテスト/検証プロンプト条件と4つのskillを試したが、ほぼどれも平均を上回らず、Defaultの方が平均より高かった。agentは技術を表面的に使い、無関係な性質を証明し、ランダム入力で同じエラーパスにぶつかり、同じバグを2つの「差分」実装に書き込むことさえある。
マーケティングオペレーション・アズ・コード:GitHubで計画からフォローアップまでのキャンペーンを自動化
GitHub のマーケティングチームは Issue forms、Labels、Actions を使ってイベント準備を自動化し、これまで手作業で2〜3日かかっていた作業が1つの Issue で自動構築、毎日の申し込み確認、締めくくりまでできるようになった。
Weaveツールを5つ試してみよう——あなた自身のものもぜひ共有してください
WeaveツールがFigma Communityに公開可能に、記事が試す価値のある5つを厳選:ムードボードをリアルな部屋のレンダリングに変えるものから、建築コンセプトスケッチや次のネイルのプレビューまで。
AI規範と価値観、第3部(全3部):私たちが信じるもの
Honeycomb の AI 規範と価値観シリーズの最終回は、彼らが何を守ることを選んだのかを語る。著者はこの立場を倫理宣言ではなく仕事上の約束と呼び、Dr. Cat Hicks との今後の対話にも触れている。
AIエージェントで複雑なレガシーコードをモダナイズ
Mistralが欧州のエネルギー事業者による40,000行のFortran 77からC++への移行を支援:まず数値一致性検証台を構築し、100以上のagentでドキュメントを補完し、最終的に「人間が操作するコーディング—テスト—レビューagentワークフロー」という中間路線に落ち着かせ、完全自律ではなかった。
AIは劣悪なエンジニアリングをさらに高くつくものにしている
AIは劣悪なエンジニアを加速させ、Faros AIのデータはPRレビュー時間が441.5%増加したことを示し、JetBrainsは手戻り量が14倍の差があることを記録している。
AIはエンジニアの仕事を奪ったのではなく、やったふりをするのを簡単にしただけだ
著者は、問題は人々がAIを使うことではなく、「動くものを手に入れた」ことがいつの間にか「なぜ動くのかを理解している」と見なされていることだと言う。彼は読書会アプリを作り直した経験と、2台目のモニターにしか現れない通知バグについて語り、その線引きをレビュー、デバッグ、そして自分が何を作ったのかを本当に知るという段階に置いている。
現代のソフトウェアエンジニアにおける緩やかで静かな認知退行
AIへの依存で最も深刻な結果はコードの劣化ではなく認知の退化だと著者は考える。プロンプト、受け入れ、繰り返しの間にレビューの工程が欠け、偽りの信頼が次々と連鎖していく。著者は毎日プログラミング問題を一問解き、録画して解説する対抗法と、自らの手でデバッグして得た確かな手応えについて綴っている。
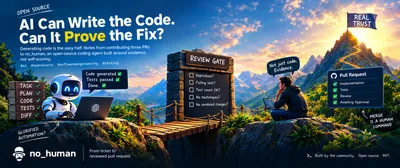
AIはコードを書けるが、修正が有効だと証明できるのか?
AI が生成した変更を人間が信頼するにはどんな証拠が必要か。著者は no_human に出した3つの PR を通じ、改ざん防止ガード、再現ゲート、敵対的レビューがそれぞれどの種類の失敗を防ぐかを明らかにした。
頭を切るのは通用しない:肉のプロキシに従業員としての未来はない
Dan Luu は 2025 年初から、LLM を使うときに頭を切る人々を見てきた。結論は明快だ。LLM が「頭を切っても」平均的なソフトを作れるほど強くなったら、会社は LLM をループで走らせてその人を解雇すればいい。
Bend 2 と vibe-coding の罠:調べる前に言語とコンパイラを作り切ってしまう
Bend 2 のデモは「法則」の宣言に 58 行、証明に 442 行。著者は同じプログラムを形式検証の SPARK で作り直し、不変条件を示すだけで GNATprove が 12 項目すべてを検証したと指摘する。
GitHub CopilotランタイムをRustに移行し、Copilotを使用する
エージェントが登場する前は、この規模の書き換えは手が出なかった。Copilotエージェントランタイムを80万行の本番Rustコードに移植するのに実際にかかったコストを以下に示す。
制御と複雑性:システム設計における緊張
分析的な分解に基づきシステムの制御を維持することを目的とする広範なアプローチと、分析に抵抗する複雑系の視点、およびシステム設計への影響という2つの広範な方法を統合する。
彼らがあなたに描く肖像:AI SREは代替品とされ、コーディングアシスタントはパートナーとされる
AI SREとコーディングアシスタントのマーケティングフレームは分化:前者はSREを置き換えるものとして位置づけられ、後者はエンジニアの増強ツールとして包装されている。
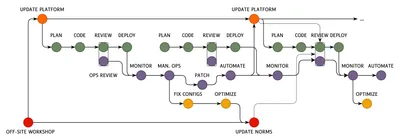
ソフトウェアの高速化と同期ずれ:「コードを書くのが速くなった」のに速くならないのはなぜか
ソフトウェアの高速化はむしろ認知のボトルネックを移動させただけかもしれず、コードレビューがAI開発プロセスを遅らせる元凶と誤解されているが、問題はただ場所を移したにすぎないのかもしれない。
OpenAIが自社LLMでJalapeñoチップを設計:100人未満、9か月でRTLからテープアウト
人工知能は設計時間を大幅に短縮した。それはさらに速くなるだけだ
コーディングエージェントのハーネスを分解して検証:コンテキスト管理の価値の大半は「ウィンドウを溢れさせないこと」
176組のペア実験、4モデル、2ベンチマーク:計画は弱いモデルには精度の足場、強いモデルにはコスト削減ツール。切り詰められたコンテキストを復元可能にすることはほとんど使われていない。事前定義ツールはbashが弱いモデルにのみ明確な利益をもたらし(+15.0%)、bashが強いモデルにはbashをより安く提供するだけ。
ZCodeがGitの全履歴を無言でアップロードする怪しい挙動を暴く
ZCodeはログイン状態でワークスペース全体と完全なGit履歴を無言でパッケージ化してクラウドオブジェクトストレージへアップロードし、復号用秘密鍵はサーバー側にのみ保存される。本記事ではローカルフォレンジックとクライアントコードのリバースエンジニアリングにより完全なアップロード経路と暗号化機構を復元し、ファイルシステムの不変ロックによってこの行為を完全に阻止する方案を示す。
Claude CodeがAGENTS.mdを読み始める:コーディングエージェントの設定ファイル論争が収束へ
Claude Code 2.1.277 はプロジェクトに CLAUDE.md がない場合、AGENTS.md を読むようになった。Codex、Amp、Jules、Cursor などが共同で提唱し、現在は Linux Foundation がホストするこのオープンなフォーマットを、これまで独自路線を歩んできた Claude Code が初めて受け入れた。
Fable 5 対 GPT-5.6 Sol:2,000 ドルと 20 億トークンを費やして、Expo アプリをうまく書けるのはどっちだ
3つのAIモデルがそれぞれ一度に3つのExpoアプリを作成し、20億以上のトークンを消費して2,000ドルを費やし、Fable 5がコードとUIの品質で勝利した。