GitHub CopilotランタイムをRustに移行し、Copilotを使用する
エージェントが登場する前は、この規模の書き換えは手が出なかった。Copilotエージェントランタイムを80万行の本番Rustコードに移植するのに実際にかかったコストを以下に示す。
日本語
コピー
65分
- 共有:
GitHub Copilot CLI、GitHub Copilot アプリ、GitHub Copilot SDKの背後にあるのは Copilot agent runtime だ。アプリやサービスに組み込める agent 実行フレームワークで、当初は TypeScript で書かれ、Node.js と V8 JavaScript エンジン上で動いていた。現在の GitHub Copilot cloud agent(CCA)を支えているのもこれであり、runtime とその機能が急速に拡大する中でも、ずっとこの技術スタックに留まってきた。
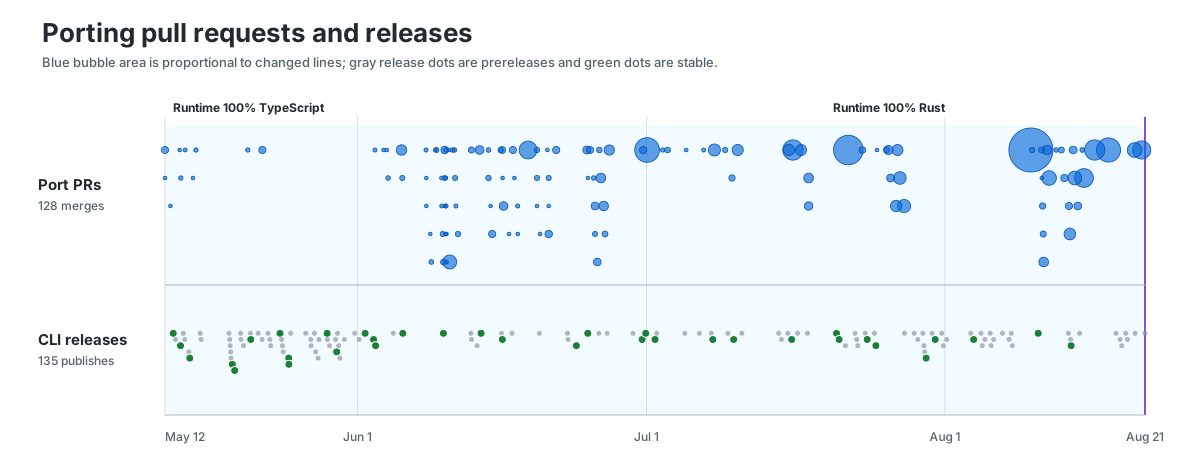
それが変わった。GitHub Copilot アプリと Copilot CLI にあわせて、runtime を 80 万行を超えるプロダクション品質の Rust コードとして全面的に書き直したのだ。コードの大部分は AI agent が書き、128 個の pull request にまたがって順次 main にマージされ、最後に一括で切り替えるのではなく段階的にリリースされた。その過程で避けられなかった少数のリグレッションはすみやかに発見・修正され、同時に runtime の性能は桁違いに向上した。agent が登場する前なら、これほどのプロジェクトには開発チームまるごとで 1、2 年かかった。今回は主に 1 人の開発者が数か月でやり遂げ、その間チームの他のメンバーは runtime の機能と対応範囲を大きく広げ続けていた。
なぜ移植したのか
Copilot agent runtime は Copilot CLI の背後にあるエンジンというだけではない。Microsoft、GitHub、そしてエコシステムのソリューションがますます多くこれを利用しており、アーキテクチャとしては、どのソリューションも同じ runtime を中心に、そのソリューションに必要なカスタマイズを加えた薄い層を被せた形で AI 機能を実現している。GitHub Copilot CLI と GitHub Copilot アプリ、最新版の VS Code、Visual Studio、CCA、Copilot Code Review(CCR)、Copilot Cowork、Copilot Studio、そして Excel、Outlook、PowerPoint、Word……ほかにもまだある。
これらの製品は実に多様で、プロダクション品質の agent フレームワークに必要なものをすべて自前で実装したいとは思わないし、そうすべきでもない。求めているのは完全な知能、安全性、信頼性、性能であり、それが共有されること——1 か所直せばすべてが恩恵を受けること——を望んでいる。前段に挙げた製品の多くは、当初それぞれが独自の agent loop を実装していたが、後に GitHub Copilot SDK、つまり Copilot agent runtime への入口へと切り替えた。これにより各製品は中核のビジネス価値に集中でき、細部は runtime に任せられる。業界のテンポを考えれば、使う agent loop が激しい競争の中で常に最適であり続けなければならないことを思えば、なおさらだ。
つまり、runtime を共有すること自体は問題ではない。問題は、共有されている中身が何かということだ。
理屈の上では、CLI は agent loop の上に載るターミナル UI(TUI)にすぎない。しかし実際には、スタック全体が TypeScript、フレームワークが Node.js、実行エンジンが V8、UI が Ink と React で実装されていた。TUI アプリとしてはかなりまともな選択だ。TypeScript と Node.js は敷居が低く学びやすく、アプリ開発の速度は極めて速い。コンソールアプリに求められる要件の範囲内なら、起動、応答、スループット、メモリ使用量の面でも妥当な性能と言える。だが、この実装を別の環境に持っていき、別の制約——たとえば高速な起動、サーバー密度を上げるための低メモリ消費——に直面すると、話は変わってくる。
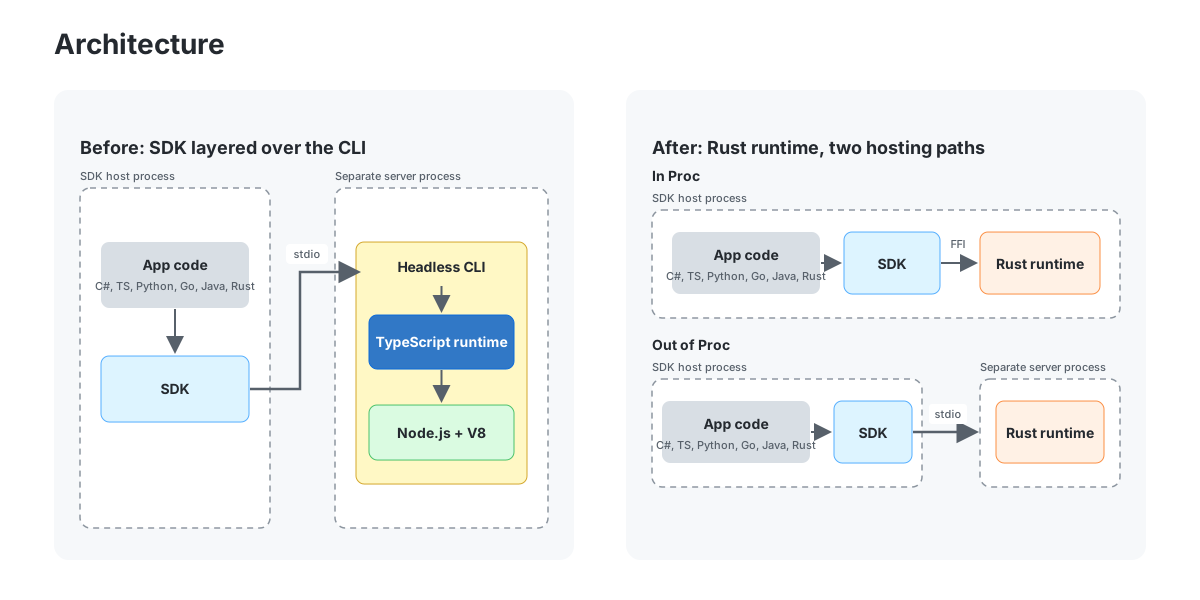
CLI のアーキテクチャとその runtime が、問題をさらに難しくしていた。業界全体が猛スピードで走っており、そんな環境では賢い人間ほど意思決定の際に提供速度と市場カバレッジを優先する。Copilot CLI も素早く書かれ素早く出荷され、その結果 TUI と runtime が絡み合い、独立した層に分かれていなかった。後にこの runtime へプログラムからアクセスする SDK が必要になったとき、層の分離が明確でなかったため、現実的な解は SDK を CLI の上に載せることだった——本来望ましいアーキテクチャは逆であるはずなのに。CLI はユーザーがコマンドラインで打ち込むコマンドからだけでなく、headless で実行し、stdin から同種のコマンドを読み、応答を stdout に書き出すモードでも使えるようになった。これにより JSON-RPC プロトコルで外部プロセスと CLI の間で関数呼び出しをやり取りできる。SDK は任意の呼び出し側プログラムに組み込まれ、そのプログラムが CLI プロセスを spawn し、agent loop をプロセス外でホストし、SDK はこの JSON-RPC の仕組みを通じてリモートプロセス内の関数を呼び出す。巧い。出荷が速い。柔軟。だが、呼び出し側アプリの性能(起動、メモリ、スループット)と信頼性にとっては良くない。SDK から新しい CopilotClient を作るたびに、プロセスを 1 つ spawn することになる。
const client = new CopilotClient();
await client.start(); // spawns the CLI as a subprocess
const session = await client.createSession({
 /* ... */
});
このプロセスでは Node と V8 を起動してホストする必要がある。CLI の TypeScript コードから生成された大量の JavaScript を解析し、バイトコードを生成し、場合によっては後段の JIT 層でホットコードを最適化することになる。V8 がもたらすメモリオーバーヘッドをすべて抱え込むことにもなる。Node のスレッドモデルを引き継ぐことにもなる——デフォルトでは、CPU 密集型の処理をすべて直列化せざるを得ない。関数呼び出しを 1 回行うだけでも、プロセス間通信を強制される。SDK を使う全員が、どの言語であれ Node.js か、V8 を同梱したバンドルバイナリを抱えることになる。C#、Python、Go、Java、Rust の SDK は、クライアントごとに第 2 の言語ランタイムを丸ごと余分に背負い、ワーキングセットは最低 100 MB から始まる——しかもアプリケーション自体はそのランタイムを一切使わない。あらゆるイベント、あらゆるメッセージ、抽象セッションファイルシステムへの読み書きのたびに、プロセス境界を越えることになる。Node がクラッシュすれば、セッションも道連れだ。デプロイする人間は、少なくとも 2 つのプロセスを監督し、監視し、デバッグすることになる。
私たちが欲しかったランタイムはこうだ。
- TUI を含まない。TUI はそれ自体が独立したライブラリであり、TUI やその他のアプリ・サービスはその上にきれいにレイヤーを重ねて構築できる。
- 依存がごく少なく、オーバーヘッドが極めて低い言語で実装する。
- プロセス外を強いられるのではなく、プロセス内にきれいに埋め込める実装であること。
- 性能、スケーラビリティ、信頼性のいずれにおいても一流の特性を備えた言語で実装する。
- 相互運用性に優れた言語で実装し、6 つすべての Copilot SDK 言語版(C#、TypeScript、Python、Rust、Go、Java)から、それぞれのスタックの外部関数インターフェース(FFI)機構を通じてきれいに呼び出せること。
- 使用するツールチェーンが、より現代的なセキュリティ態勢を提供し、サプライチェーンリスクが低く、correct-by-construction なコードへの支援がより強いこと。
これらすべての理由に、いくつかそれほど厳密でない理由(チームの経験や業界の方向性など)を加えた結果、私たちは Rust を選んだ。これは決して、すべての大規模 TypeScript プログラムを Rust に書き換えるべきだという意味ではない。私たちの要件が重視していたのは、C ABI 経由の埋め込み、低い起動オーバーヘッドと低い定常オーバーヘッド、そして予測可能なリソース消費だ。Rust はこれらの目標を可能にする代わりに、別の厄介事を持ち込む——ライフタイムと共有状態を明示的に表現しなければならないことだ(後述するライフタイム回帰の問題は、その帰結を如実に示している)。適切なホスト言語はアプリケーションごとに異なるし、それは当然のことだ。
その後、関連する 2 つの重要な作業が始まった。
- TUI 専用コードを runtime から分離し、前者を後者の上に厳密に重ねる——より正確には、SDK の公開インターフェースの上に厳密に重ねる。現時点でも CLI は複数の箇所で runtime の内部実装を直接呼んでおり、完全に SDK インターフェースの上へ移行する作業は進行中だ。
- この runtime 層を完全に Rust へ移植し、最終的に純粋なネイティブバイナリにして、すべての言語フロントエンドがプロセス内で呼び出せる C ABI を外部に公開する。同時に、依然としてプロセスをまたぐ必要がある場合に備えて、stdin/stdout や socket ベースのサーバーも残す。
本記事が主に扱うのは 2 つ目、runtime の Rust への移植だ。
以前の姿
2026 年 5 月初旬の初期移植計画では、runtime はおよそ 130,000 行の TypeScript と見積もられていた。スコープを定める上でこの初期計測はかなり正確だったが、2 つの重要な点で非常に誤解を招くものでもあったことが後に判明する。移植と並行して、
- 依然として TUI 層に包まれていた部分が、次々と runtime 層へ押し下げられていった。いくつかのコンポーネント全体、そして当初の見積もりでは無視されていたかなりの割合のコードが、後に移植対象として認識されることになった。
- 大量の新しい TypeScript を継続的に投入する pull request が、リポジトリ内の TypeScript 総量を押し上げ続けた。agent を使う数十人の開発者が、毎週数百の pull request をマージしていた。
すべてを勘定に入れると、最終的におよそ 430,000 行のプロダクション TypeScript がこの移植を通過したと私は見積もっている。同じ要因のせいで、途中の進捗も見えにくくなった。終盤に近づくまで、プロダクション TypeScript の規模は比較的横ばいか、むしろわずかに増えているように見えた——移植の速度が、新規コードの流入にようやく追いつく程度だったからだ。
ここはさらに複雑で、同じ期間に移植とは無関係な Rust コードも継続的にマージされていた。移植の初期にはマージされるコードは TypeScript が主だったが、後期には Rust が主になっていった。
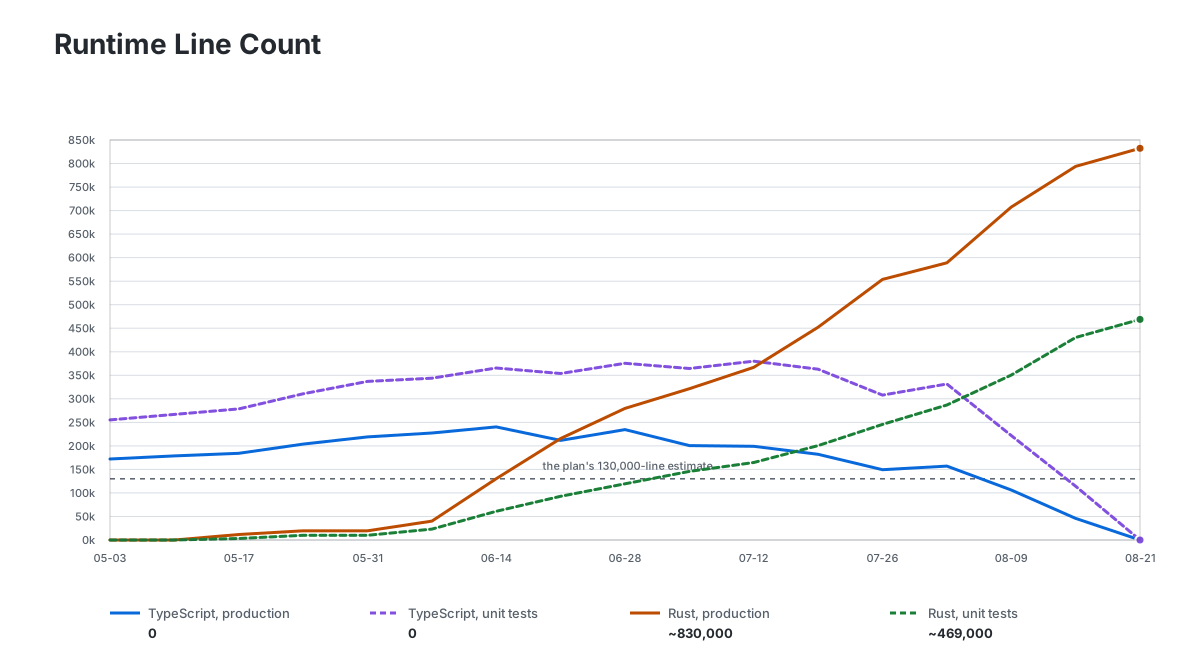
移植期間中、runtime は約 300,000 行のプロダクション TypeScript を受け取り、約 430,000 行を削除した。一方、プロダクション Rust コードは約 1,200,000 行がマージされ、約 365,000 行が削除された。言い換えれば、上の図で TypeScript の行数が横ばいに見えるのは、実際には大量の TypeScript の追加と削除の変動を覆い隠している。
その場で移植する戦略
この図は、今回の移植の進め方の重要な特徴も浮き彫りにしている。その場で行うということだ。
これほど大規模な書き換えには、大きく分けて二つの進め方がある。
- ビッグバン方式。 新しい Rust ランタイムを完全な代替として開発し、整った時点で一気に切り替える。この切り替えには二つの変種がある。a. 全面停止。 書き換えの間、全員が
mainブランチ上の他の作業を止め、書き換えはすべてmainで行う。b. 並行開発。 書き換えはフィーチャーブランチで進め、メインブランチでは通常どおり開発を続ける。書き換え側はメインブランチの変更を追い続け、マージし続ける必要がある。 - その場方式。 コンポーネントごとに移植し、ランタイムを少しずつ書き換えていく。この方式にも二つの変種がある。a. アトミックな置き換え。 各部分を TypeScript から Rust へアトミックに切り替え、残った TypeScript と新しい Rust の間は相互運用でつなぎ続ける。時間が経つにつれ、本番ランタイムの TypeScript は減り、Rust が増え、いつか TypeScript がなくなって Rust だけになる。b. A/B。 移植したコンポーネントは削除せず、TypeScript 版と Rust 版の両方をホットスワップ可能な選択肢として残しておき、確信が安定してから TypeScript を削除する。
私たちは方案 2a を選んだ。理由はいくつもある。
- 誰も作業を止めずに済む。 メインブランチは動き続ける。移植に直接関わらない開発者は普段どおり作業できる。影響が出るのは、長く抱えていた pull request がたまたま並行して移植中のコードに触れたときだけで、その場合は rebase し、自分の agent に未マージの変更だけを移植してもらえばよい。
- runtime のメインブランチは常にリリース可能。 各 pull request は薄い shim で元の TypeScript 実装を置き換え、shim が Rust を呼び出し、古いコードは一度のアトミックな変更で削除される。新しいコードはすぐに本番環境で動く。
- 書き換えはインクリメンタルで、レビューもできる。 各 pull request が移植するのは一つのコンポーネントか一つのスライスだけなので、変更範囲が小さく、diff もレビューしやすい。人でも agent でも、両方でも同じだ。
- ほとんどの移植はほどよい規模で自己完結しているため、並行する pull request とのずれは最小限に抑えられる。あまりに大きい TypeScript コンポーネントは、まず移植しやすいコンポーネントにリファクタリングする。
- 既存のエンドツーエンドテストはすべて、CLI と SDK をカバーし、各ステップで新しい Rust コード上で実行される。これが自信を与え、大量の検証にもなる。必須のテストを落とす pull request はマージされない。
方案 2b の変種、つまり同じコンポーネントの複数バージョンを同時に保守するやり方も避けた。ここ数か月、毎週数百の pull request がリポジトリにマージされ、コードベースは急速に進化し続けている。同じコードを二つの言語、二組の依存ライブラリで二重に保守するのは、大きな複雑さを招く。しかも、完全に分離できるコンポーネントばかりではない。論理的に独立し、システムの残りの部分が呼び出す単純な API を提供するものもあれば、多数の触手を伸ばしているものもあり、この図のとおりにコンポーネントをホットスワップさせるのは悪夢のような話だ。慎重な並行切り替えから最も恩恵を受けそうなサブシステムこそ、並行化が最も難しいものだった。たとえば session orchestration は純粋な関数ではなく、実験用のスイッチで if/else を呼び分けて二つのバージョンを動かすことはできない。可変状態を保持し、コールバックを双方向に駆動し、他のほぼすべてのサブシステムを貫いている。だから「両方を動かして比べる」となれば、分岐したコピーを二つ保守することになる。しかもこのコンポーネントは会話全体の状態とサービスを抱えており、数百件の並行編集を通じて両者が同期し続けることを期待しなければならない。あるコンポーネントの移植を難しくする結合は、そのままシャドー実行をほぼ不可能にする結合でもあり、無理にやれば避けられたはずのリグレッションをむしろ持ち込むだけだ。この方法で切り替えられることの利点は主に自信が得られることで、自信は別の方法でも得られる。
検証も段階的なリリースで行った。一括切り替えなら、すべての変更を一つの長期ブランチに集め、ランタイム全体を移植してから一度に切り替えることになる。すると利用者は移植後のコードを一度に全部浴びることになり、リポジトリ内のテストが見逃したリグレッションもすべて浴びることになる。変更を少しずつ——ここで二つ、あそこで一つ——出せば、デプロイ済みのビルドで最後の一マイルを検証でき、実際の利用者(ほとんどの場合、Microsoft と GitHub 内部のファーストパーティユーザー)に触れながら、リグレッションのリスクを最小限に抑えられる。約十四週半の移植期間中、main は 135 のバージョンをリリースした。内訳はプレリリース 100、安定版 35 で、平均すると 1 日あたり約 1.3 バージョンになる。移植の pull request も 1 日あたり約 1.3 件開かれ、各バージョンが運ぶ移植コンポーネントの数は少なく、はっきりしている(移植はなるべくプレリリースで先に出そうとしたが、いつもそうできるわけではなかった)。npm を 7 日間連続でサンプリングしたところ、プレリリースはダウンロードの 10.5% にとどまり、初期の露出は比較的限られていたことがわかる。この間、フィードバックチャネルに異常な兆候がないか監視を続け、次のプレリリースで速やかに修正した。報告された問題は直近の既知の変更と結びつけやすく、根本原因の特定も修正も速い。結果として、移植をより長い時間をかけて段階的に進めることは足かせどころか利点になった(つまり、速ければよいというものではない)。8 月 21 日の時点で、ランタイムは 100% 本番環境の Rust になった。本番 Rust コード 832,378 行、Rust ユニットテスト 468,689 行、さらに E2E TypeScript テスト 174,675 行。独立した GitHub Copilot SDK リポジトリには、Node.js、Python、Go、C#、Rust、Java をカバーする約 130,000 行の E2E テストコードが別途ある。
立ち上げ
本格的に取りかかる前に、まず自信をつけ、実現可能性を確かめた。最初の 2 つの pull request で Rust workspace、ツールチェーン、lint ルール、CI、ビルドパイプライン、コーディング規約を整え、続いて runtime crate、コード生成と相互運用のパターン、そして純粋なロジックだけのプリミティブ群を移植した。選んだ理由は明快で、I/O がなく、共有状態もなく、テストがすでに充実していたからだ。これらが着地したところで、最初の正式な移植 pull request が 3 つの副作用のない helper を一連の流れに通した。出荷前の試運転のようなもので、リポジトリ構成、FFI、パッケージング、テスト、レビューに関する仮説を規約として固め、その後の桁違いに大きな移植で再利用できるようにした。要するに、仕組み全体を端から端まで一度動かしてみたのだ。計画は葉から根へという順序で進めた。純粋な helper、コンテンツ除外、shell ツール、セッションのファイルシステム操作と進み、翻訳とテストのパターンを先に確立する。次に状態を持つサブシステムで、ツール、hooks、モデルクライアント、MCP はいずれもこの基盤の上に成り立つ。セッションのオーケストレーションは runtime の中で最も結合が強く、並列化にも向かないため、終盤まで残した。
| 期間 | Pull request 数 | 変更行数の中央値 |
|---|---|---|
| 5 月 1–15 日 | 8 | 3,250 |
| 5 月 16–31 日 | 2 | 9,421 |
| 6 月 1–15 日 | 40 | 5,073 |
| 6 月 16–30 日 | 31 | 8,253 |
| 7 月 1–15 日 | 10 | 9,514 |
| 7 月 16–31 日 | 14 | 28,159 |
| 8 月 1–15 日 | 19 | 13,861 |
| 8 月 16–30 日 | 4 | 99,445 |
初期の移植は小さな葉のコンポーネントばかりで、速く進んだ。だが大きなサブシステムは一度で完成するものではない。たとえば MCP サポートは 7 つの専用 pull request を経て形になり、ツールは 6 部構成のシリーズで、その後さらにオーケストレーションの移行と残った TypeScript の削除に追加の作業が必要だった。hooks、auth、telemetry、plugins、settings、永続化も似た道をたどった。
実際のところ、移植の有効な単位は常に「1 コンポーネント」とは限らない。複数の関連する振る舞いの領域にまたがる変更の波であることが多い。まず純粋なロジックを移し、次に状態の持ち主を移し、続いてオーケストレーションを移し、フォールバック経路を削除し、最後に一時的な相互運用層が消えたあとで Rust コードを簡素化する。
相互運用
今回の移植で相互運用が関わる層は主に 2 つある。
- 一時的な内部相互運用。 関数を Rust に移植するたびに、元の TypeScript 関数を呼んでいた TypeScript コードからその関数を呼べる必要がある。逆に、Rust 関数から TypeScript のコールバックを呼べる必要もある。この層は実装の詳細であり、変化が極めて激しい。Rust 内部のインターフェース面積が広がるにつれて必要な TypeScript シムの数も増える。TypeScript から呼び出す必要のある Rust メソッドには、1 対 1 でシムが対応するからだ。呼び出し側が Rust に移植されると、そのシムは削除され、新しいシムに置き換わる。最終的にランタイムライブラリの公開エントリポイントに到達し、シムは消える。
- SDK インターフェース層。 SDK ライブラリはどれもランタイムの上に載り、その機能を外に露出させる必要がある。移植前は、ランタイムを双方向の JSON-RPC 層で公開していた。SDK は関数呼び出しのリクエストを JSON-RPC メソッド呼び出しのペイロードとして送り出し、ランタイムがリクエストを解析して対応する API を呼び、同じトランスポートで結果を返し、SDK がそれを解析して返す。逆方向も同じで、ランタイムから SDK クライアントをコールバックする必要がある。たとえば hook の通知や権限リクエストがそうで、これらは SDK クライアント側ではコールバックとして現れる。具体的にどの言語機能を使うかはその言語の慣習による(C# の delegate など)。
(1) は napi-rs プロジェクトの napi Rust crate で実装した。これは Rust で Node ネイティブアドオンを構築するための crate だ。関数に #[napi] を付けると、napi-rs のマクロが N-API 登録のグルーコードを生成し、その関数を JavaScript から呼び出せるようにする。同時に、生成される index.d.ts にその関数の TypeScript 宣言も生成する。同期 Rust 関数は普通の JavaScript 関数になり、async fn は promise を返す JavaScript 関数になり、#[napi(object)] を付けた struct は反対側では普通のオブジェクトになる。
流量は双方向にも流れる必要がある。移植済みのコンポーネントの多くは、まだ移植されていない部分に一時的に依存している。つまり Rust から TypeScript を呼び戻す必要があるのだ。たとえば Rust 側のツール実装が、まだ TypeScript のままのモデル層に推論を要求したり、hook を発火させたり、実行したいコマンドの権限判定を求めたりする場合だ。napi-rs はこれを「threadsafe functions」で解決する。Tokio のワーカースレッドで動く Rust コードが、Node のメインスレッド上の JavaScript 関数を呼び戻せる。Node がコールバックを一度登録し、Rust がそれを保持し、逆方向の呼び出しが必要になるたびに使う。こうしたコールバックはどれも構造上一時的なものだ。存在する理由は相手側がまだ TypeScript だからにすぎず、その相手側の移植が終われば削除される。
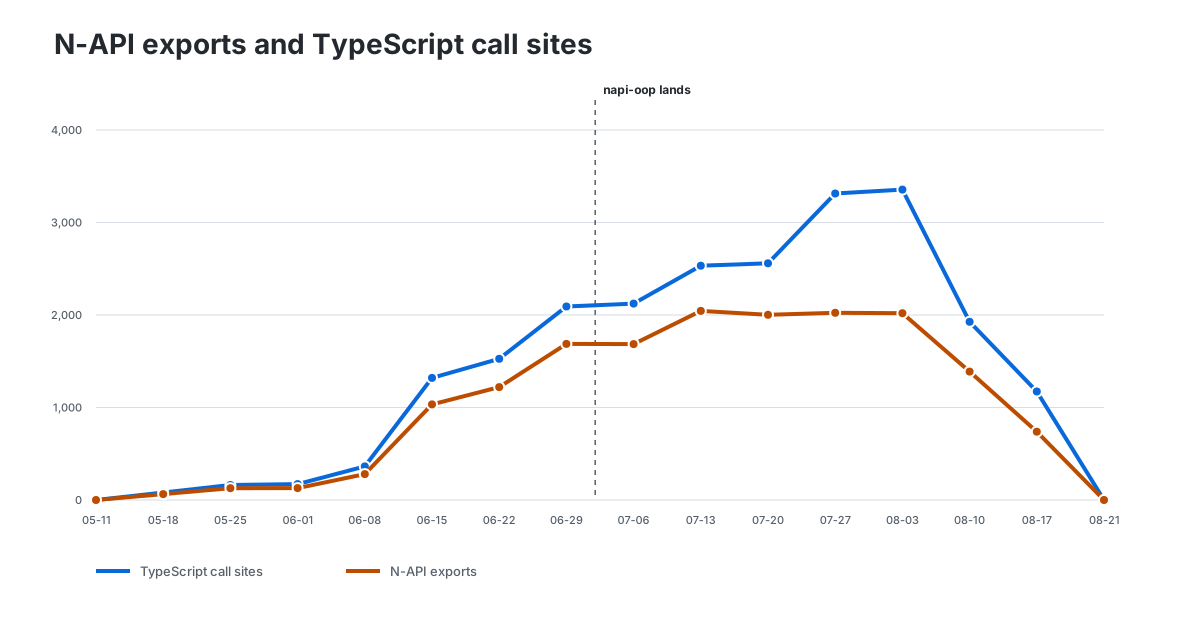
この一時的な継ぎ目は 8 月 3 日にピークを迎えた。内部 N-API エクスポートが 2,019 個、TypeScript の呼び出し点が 3,356 個。完了時点でランタイムは完全に Rust になり、内部相互運用はなくなった。一時的な内部 N-API エクスポートは 0 個、TypeScript の呼び出し点も 0 個。(前述のとおり CLI にはランタイムへの内部アクセスがまだいくつか残っており、現在削除を進めている。これらのエクスポートはここには数えていない。)
第二の相互運用層、すなわち SDK サーフェスは、両者のうち恒久的なほうだ。Copilot SDK は TypeScript、Python、Go、C#、Java、Rust の 6 言語向けに提供される。いずれも同じ双方向 JSON-RPC 契約を話し、当初はどれも同じ方法で接続していた。Copilot CLI を headless モードで子プロセスとして起動し、パイプか socket 経由で通信する。移植期間中はこれが依然としてデフォルトだ。つまりどの言語の SDK 利用者も、完全な Node 実装をパッケージに同梱するか自分で探す必要があり、イベントごと、メッセージごとにプロセス間の往復コストを払い、2 つのプロセスを管理することになる。
ランタイムを Rust に移植したことで、もう一つの選択肢が現実的になった。公開されている runtime.node はごく普通のプラットフォーム共有ライブラリで(.node 拡張は Node.js ネイティブアドオンの慣例であり、その下には .dll、.so、.dylib がある)、同じエンジン上に 2 つの扉を開いている。1 つは napi の扉で、Node プロセスがネイティブアドオンとしてロードする。CLI が通っている経路でもある(現時点では……将来的には完全に SDK 経路にする予定だ)。もう 1 つは C ABI の扉で、どの言語でも自分のプロセスにロードし、FFI 経由で呼び出せる。同一プロセス内ランタイムを、各言語がそれぞれのネイティブ相互運用機構で利用する。
| SDK | ネイティブブリッジ | プロセス内クライアントの選択 |
|---|---|---|
| C# | P/Invoke | new CopilotClient(new CopilotClientOptions { Connection = RuntimeConnection.ForInProcess() }) |
| Go | purego | copilot.NewClient(&copilot.ClientOptions{Connection: copilot.InProcessConnection{}}) |
| Java | JNA | new CopilotClient(new CopilotClientOptions().setConnection(RuntimeConnection.forInProcess())) |
| Python | cffi | CopilotClient(connection=RuntimeConnection.for_inprocess()) |
| Rust | libloading | Client::start(ClientOptions::new().with_transport(Transport::InProcess)).await? |
| TypeScript | koffi | new CopilotClient({ connection: RuntimeConnection.forInProcess() }) |
Rust への書き換えと、プロセス内・プロセス外ホスティングのどちらを選ぶかは、独立した 2 つの軸だ。書き換えが完了した Rust ランタイムは両方をサポートする。SDK 利用者のプロセス内で動くことも、既存の JSON-RPC サービス境界の背後に留まることもできる。これらのプロセス内エントリは現在、選択的に有効化している。まだ自信を積み上げている段階だからだ。何しろ呼び出し側アプリケーションとプロセスを共有することになり、障害境界も共有することになる。トランスポート層より上のものはすべて同じ SDK API のままだ。セッション、イベント、ツール、権限、コールバックは、自分の JSON-RPC バイトがパイプを通るのか関数呼び出しを通るのかを気にしない。
2 つ目の扉が興味深いのはその規模だ。エクスポートする関数はわずか 19 個。サービスライフサイクル用が 4 個、セッションの登録と設定用が 4 個、接続用が 8 個、組み込みホスト用が 3 個。これらの関数の背後で、共有契約は現在 364 本のディスパッチルートを持つ。340 本は SDK 利用者が呼び出せ、残り 24 本は逆方向に走り、ランタイムから SDK へのコールバックになる。napi の扉はこれよりずっと大きく、ディスパッチルートごとに対応する関数が必要だ。C ABI の扉はディスパッチベースだ。API メソッドはそもそもエクスポートされず、JSON-RPC バイトとして接続に書き込まれ、結果、イベント、サーバーからクライアントへの要求はホストが提供するコールバックを通って返る。API メソッドを追加、変更、削除しても、触るのはエンジンのディスパッチテーブルだけで、ABI には決して触れない。SDK はこの 19 個のエントリポイントをバインドするだけで、今も成長を続ける API 面全体に動的に到達できる。
ここで当然の疑問が浮かぶ。呼び出しがもうプロセス境界を越えないのなら、なぜ中に JSON-RPC が残っているのか。
答えは、そうすることでプロセス内ホスティングが書き換えではなく差し替えで済むからだ。どの SDK にもすでに使える JSON-RPC クライアントがあり、フレーミング、要求と応答の対応付け、サーバーからクライアント方向の各種ハンドラを備えている。FFI をさらにもう 1 つのトランスポートとしてそのクライアントの下に差し込めば、バイトの経路がパイプや socket から関数呼び出しに変わるだけで、その上は何も変わらない。6 つの SDK は増分的かつオプションの形でプロセス内ホスティングを手に入れ、既存のトランスポートには一切手を加えない。逆に、API メソッドごとに型付きの C 関数を定義すれば、どの SDK もバインディング層をもう 1 つ追加することになり、API メソッドが増えるたびに 6 份のバインディングを書くことになり、ABI もバージョン管理が必要なバイナリ互換面になってしまう。
プロセス境界をまたぐ場合でも TCP 越しでも、真にリモートなランタイムには同じく JSON-RPC が要る。プロセス内でも同じプロトコルを使い続ければ、双方向 API とディスパッチの仕組みはひとつで済む。リモート接続には JSON-RPC、ローカル接続にはメソッドごとの FFI インターフェース、と分けずに済むということだ。これは実際に効いてくるトレードオフで、ろくに考えずに決められる話ではない。プロセスの切り替えは省けるが、呼び出しごとに JSON-RPC のコストは払い続ける。推論が主体のワークロードなら、このシリアライズのコストはモデルの往復に比べてたいてい無視できる。高スループットのローカル負荷では計測できるレベルではあるが、今のところ 6 つの SDK バインディングで数百のメソッドをそれぞれ複製するほどの理由にはならない。しかもこの判断は後から変えやすい。性能要件が本当に出てきたら調整すればいい。ペイロードのエンコードは両端の間だけの私的な詳細で、JSON を MessagePack のようなよりコンパクトな形式に変えても、外部に公開しているエクスポートはひとつも変わらない。型付きのメソッド単位エクスポートも、後からホットパス向けに足せる。同じエンジン、同じハンドラ群を呼ぶもので、バイトチャネルを差し替える必要はない。そのチャネルは引き続き、ストリーミング、サーバーからクライアントへのリクエスト、そして滅多に呼ばれない大量のメソッドの土台であり続ける。そうしたメソッドのために専用のエクスポートを作っても何の得もない。
セッションデータが示すもの
この記事に出てくる数字はほぼすべて、2 つの出所のどちらかに由来する。ひとつはプライベートリポジトリ github/copilot-agent-runtime の GitHub 履歴——pull request とその diff、レビューコメント、CI の実行など。もうひとつは agent のセッションログだ。ランタイム(および CLI やアプリなど)は、実行するセッションごとに構造化イベントログを書き出す。1 行に 1 つの JSON オブジェクトで、セッションの進行に合わせて追記されていく。このログには prompt、コマンド、コマンド出力、ファイルパス、ツールが露出させた可能性のある秘密鍵などが含まれうるため、機密データとして扱う必要がある。ログはセッションが動いているマシンのローカルに置かれる。リモートセッション機能を有効にすればアップロードもできるが、それは製品設定と組織のポリシー次第だ。
関連する移植の pull request 全体のデータをまとめると、次のとおり。
| 指標 | 数 |
|---|---|
| イベント | 12,760,995 |
| ユーザーメッセージ | 31,247 |
| アシスタントメッセージ | 1,385,214 |
| Hook の開始・終了イベント | 6,438,562 |
| ツール起動 | 1,857,409 |
| コンパイルコマンド | 23,096 |
| テストコマンド | 19,485 |
| Rebase コマンド | 2,496 |
| Commit コマンド | 7,410 |
| Push コマンド | 5,554 |
| 完了した圧縮 | 5,116 |
この 31,247 件の user ロールのメッセージは、私が手で打ち込んだ 31,247 件の prompt ではない。skill の指示、自動マージのトリガー、セッション間メッセージ、サブ agent のトラフィックも含まれる。私自身が入力したり口述したりしたのはおよそ 2,600 件で、12 分の 1 ほどにすぎない。同じく 1,385,214 件のアシスタントメッセージも、サブ agent やツール向けのメッセージを含んでおり、会話 UI に表示されたテキストだけではない。コーパスには 68 種類のイベントタイプと 67 種類のツール名が含まれ、ツール呼び出し 1,130,921 回(61%)はメインのセッションスレッドではなくサブ agent によるものだ。
この数字は、なぜ私が約 2,600 回も割り込んだのかは説明してくれない。そこで Copilot に、セッションログのコーパスにある人間が書いたメッセージ 1 件ごとに、主たる意図をラベル付けさせた。
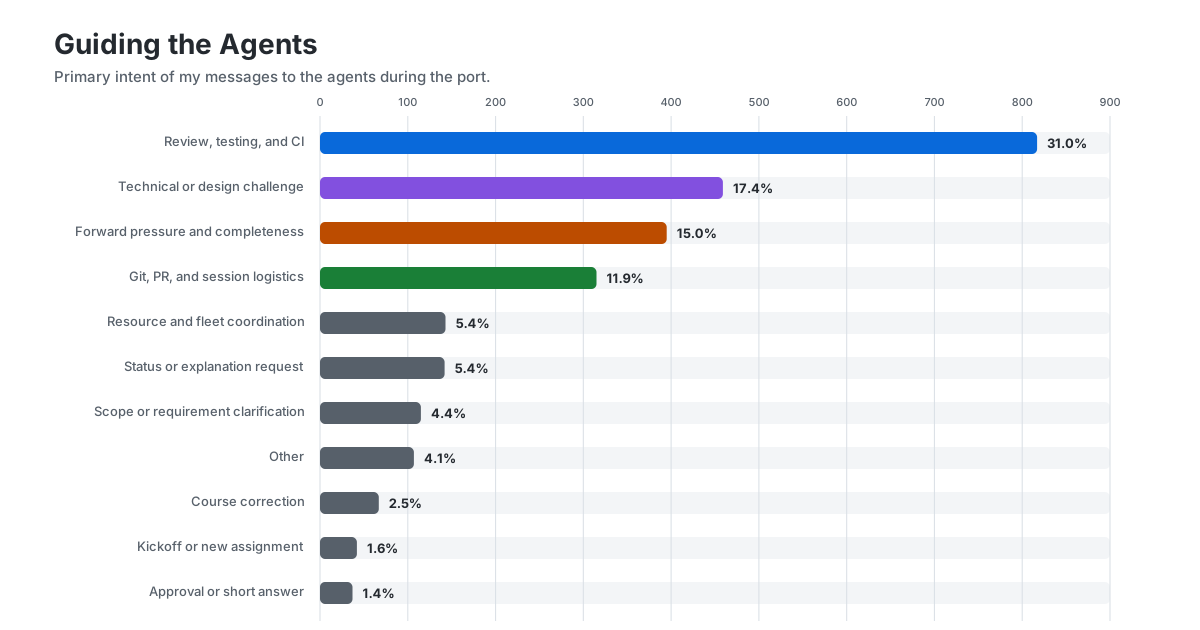
上位 3 カテゴリで、私のインタラクションの 63% を占める。このうちセッションの開始だと私が認識できるのは 40 件ほどで、ほとんどの場合はまず次の方向性を探るチャットを立ち上げ、そのセッションに、欲しい切り口ごとに実際の移植セッションを作らせている。私の役割は「タスクを投げて待つ」というより「制御ループを回す」ことに近い。結果を確認し、技術的な判断に異を唱え、品質を締め、agent が途中の停車駅を終点とみなしたときには背中を押す。作業そのものを agent がやっていても、人間の判断は深く関わっている。私の関与はひとつ上の層に移っただけだ……もう構文を書くのではなく、問題を枠づけ、境界を引き、戦略を選び、例外を裁き、全体として物事が良い方向へ進むようにするのが役目になった。
要はキャッシュ
LLM プロバイダーは通常、入力トークン(あなたが送るもの)と出力トークン(プロバイダーが返すもの)で別々の価格を設定する。課金がトークン単位になりがちなのは、トークンが推論に必要な計算量の手頃な近似だからだ。入力トークンひとつにつき、モデルはそれを読み、内部表現に取り込み、次のトークンを決める計算の一部として使わなければならない。ただしプロバイダーは通常、こうした計算の結果をキャッシュでき、プロンプトの同一のプレフィックスがすでに処理済みなら、中間計算をキャッシュから再利用して最初から計算し直さずに済む。これでそれらのトークンを処理するコストが下がり、浮いた分をユーザーに還元できる。そのため入力トークンには複数の価格が付くことが多く、キャッシュから読み出した入力トークンの価格もそのひとつだ。
割引がとにかく強い。プロバイダは通常、キャッシュヒットを90%引きで課金する。たとえばあるプロバイダは入力100万トークンを$2.00で請求するが、キャッシュ読み出しの入力100万トークンなら$0.20しか取らない。つまり、請求額を1桁減らしたいなら、プロンプトキャッシュを良好に保つことが極めて重要になる。
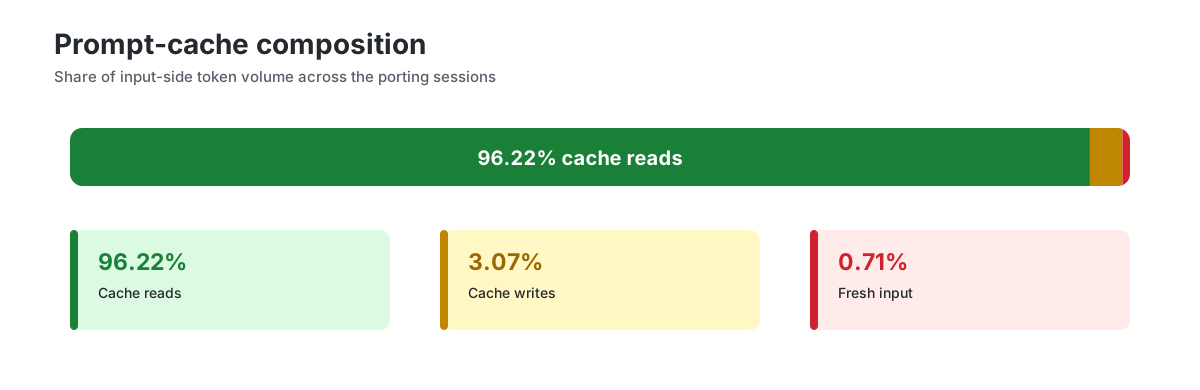
今回の移植作業の数字は、それがうまくいったことを示している。プロンプトキャッシュのヒット率は96.22%。これはキャッシュ読み出し量を入力側トークン全体(キャッシュ読み出し+キャッシュ書き込み+新規入力)で割った値だ。キャッシュ書き込みが3.07%、新規入力が0.71%。偶然ではない。GitHub Copilot は agent ループを設計する際、長く安定したプレフィックスを意図的に維持している(まず system prompt、次にツール定義、その後に蓄積された会話)。だから各ターンは、モデルがすでに処理したコンテキストの後ろに追記するだけで済む。コンテキストの高価な部分は一度しか払わず、以降の呼び出しではそれを1桁安く読み直せる。長時間の自律セッションが経済的に成り立つのはこのためだ。300時間の移植タスクで、数万回の呼び出しのたびに成長し続けるコンテキスト全体を先頭から読み直していたら、コストは我々が観測した数字よりさらに1桁高くなる。Agent harness の開発者はプロンプトキャッシュを壊さないことに多大な労力を割いており、モデルベンダーもそれを助ける新機能をしばしば投入している。
圧縮はまた別の、補完的な話を語る。移植セッション全体で、GitHub Copilot はコンテキストを5,116回自動圧縮した(セッションがコンテキストウィンドウを埋め、続行のために自己要約した時点のこと)。sessions-infrastructure の移植の単一 pull request は、数日にわたるライフサイクルの中で647回圧縮し、小規模な移植は一度も圧縮しなかった。数百時間にわたる自律作業が可能なのは、agent が手がかりを失わずに自分の作業記憶を繰り返し回収できるからだ。これら数千回の要約の一つ一つが、損失のある引き継ぎによって移植が静かに脱線しかねない地点であり、ほとんどの場合、脱線しなかった。Copilot の subagent も圧縮の削減に大きく貢献している。各 subagent は独自のコンテキストを持つため、親セッションは実質的に問いを投げ、subagent にかなりのコンテキストを消費させて答えを出させ、その答えだけを親セッションに報告させられる。親セッションのコンテキストは、その間のすべての情報に影響されずに済む。
上の「ほとんど脱線しなかった」はセッションログで確認できる。私は Copilot に、成功した各圧縮とその前後の作業を、両側に少なくとも20回のツール呼び出しがあることを条件に対にするよう指示した。こうして約4,000個の比較可能なウィンドウが得られた。圧縮前20回と圧縮後20回のツール呼び出しで、agent の行動構成は規模が近い(探索は圧縮前46.5%、圧縮後48.1%、変更は8.4%と6.0%、検証は4.7%と4.0%、失敗は1.0%と1.5%)。圧縮が頻繁に筋道を失うなら、圧縮後の側は再定位に明らかに偏るはずだ。読み出しが急増し、編集が急減し、agent は自分がどこにいて何をすべきかを再把握するのに追われる。実際はその方向へわずかに傾いただけだった。
ええ、静的解析は役に立ちます
Rust は AI 生成コードのターゲットとして特に適している、厳格なコンパイラがモデルの誤りを捕まえてくれるからだ、という通説がある。セッションログを使えば、少なくともこの種の移植タスクに関しては、この説を検証できる。
検証コマンドの結果から、rustc のエラーコードが合計8,678回捕捉された。最大4カテゴリの診断で84%を占める:
- 37%:名前とインポートの解決。中心は
E0425(「cannot find value in this scope」) - 22%:メソッドまたはフィールドの欠落
- 14%:型の不一致
- 11%:trait bound の未充足
どれも平凡な配線の問題だ。名前を少し間違えた、シグネチャが合わない、フィールドの名前が変わった、抽象が実装されていない。一括翻訳が手軽に作りがちな誤りであり、コンパイラがすぐ捕まえる類のものでもある。
だがこのリストに何がないかに注目してほしい。Rust 固有のものは一つもない。この4カテゴリはすべて静的型付けの基本であり、C#、Java、Go のコンパイラも同じように捕まえられる。いくつかはもっと親切なエラーを出し、しかもずっと速い。これが agent を Rust に向ける理由になるなら、それは agent を任意の静的型付け言語に向ける理由にもなる。強力な型のコンパイラ、あるいは静的解析と lint が非常に優れた言語は、この種の作業に確かに向いている。agent を高速なフィードバックループとして使えるからだ。より厳格な結果マッチャが結果を捕捉した4,478回の直接 cargo check 実行のうち、87.1%がクリーンに通過した。小さく変更し、繰り返し再コンパイルすれば、こうなる。
対照的に、所有権・借用・ライフタイムのエラーを合計しても、エンコードされた診断のわずか1.7%だ。借用チェッカ——Rust の学習難度をめぐるあらゆる議論で主役を張る存在——は、静かな背景の住人にすぎない。コンパイラはそのエラー出力のほとんどを、退屈で機械的な誤りに費やしている。
Agent は読むのが好き
セッションイベントのコーパスにあるツール呼び出しのデータを調べると、agent が時間をどう配分しているかについて面白いことがいくつか見えてくる。
| ツール | 呼び出し回数 | 中央値 | 実測時間(時間) |
|---|---|---|---|
powershell | 630,423 | 3 s | 2,833.9 |
view | 590,988 | 0 s | 621.7 |
rg | 281,783 | 1 s | 408.4 |
grep | 126,483 | 1 s | 115.3 |
apply_patch | 53,715 | 0 s | 17.0 |
edit | 40,591 | 1 s | 24.1 |
read_powershell | 36,728 | 90 s | 1,203.9 |
task | 13,080 | 274 s | 2,329.0 |
まず言えるのは、agent はコードを書き換えるよりもはるかに多くの時間を証拠集めに費やしているということだ。表にあるファイル読み取りと検索のツールを編集ツールと比べると、前者の作業量は後者の 10 倍ある。ファイルを読み、リポジトリを検索し、診断コマンドを走らせるのが圧倒的に多く、編集はそれに比べればごくわずかな投入でしかない。AI がコードを猛烈に吐き出すという流行りのイメージは、ほぼ正反対だ。この規模では、仕事はむしろ繰り返しの調査に近い。今の状態を確認し、仮説を立て、狙いを定めた変更を 1 つ加え、また同じことを繰り返す。
委譲はこのパターンを増幅する。サブ agent は主に、互いに独立した問題へ探索を分散させるために使われ、メインの agent のほうが編集と答えの統合を担うことが多い。こうしたプロジェクトには都合のよい分業だ。複数のコンテキストが並行して調査できる一方、変更を調整役の agent の近くに集めておけば、衝突する変更を減らし、実装方針の一貫性を保てる。
shell のトラフィックは、自律的なソフトウェア作業の大部分が状態管理であることも示している。読み取り専用の Git チェックが最もよくあるコマンドパターンなのは、agent が絶えず問いかけているのが実質「今どこにいる?」だからだ。何が変わったのか、rebase が何をしたのか、別のセッションが何をマージしたのか、あるブランチが急速に進化する main からどれだけ離れてしまったのか。こうした位置確認の作業があるからこそ、長時間動くタスクの多くが、刻々と変わる同じコードベース上で互いを盲目的に上書きせずに並行して進められる。
shell ツールのトラフィックの内訳を見ると、最も多いコマンド族が、この位置確認と検証のバランスをよく表している。
| コマンド族 | 呼び出し回数 | 中央値 | 実測時間(時間) |
|---|---|---|---|
git inspect | 300,530 | 2 s | 608.1 |
git other | 89,865 | 3 s | 243.1 |
| search | 85,482 | 2 s | 147.6 |
pnpm test | 13,852 | 22 s | 219.1 |
pnpm lint | 9,757 | 29 s | 177.0 |
cargo test | 8,437 | 120 s | 364.2 |
git commit | 7,410 | 11 s | 39.7 |
cargo fmt | 5,223 | 18 s | 77.2 |
cargo check | 4,492 | 120 s | 176.9 |
pnpm build | 3,630 | 180 s | 215.6 |
cargo clippy | 2,115 | 135 s | 107.4 |
git rebase | 2,496 | 7 s | 9.9 |
cargo build | 566 | 104 s | 20.3 |
モデル選択
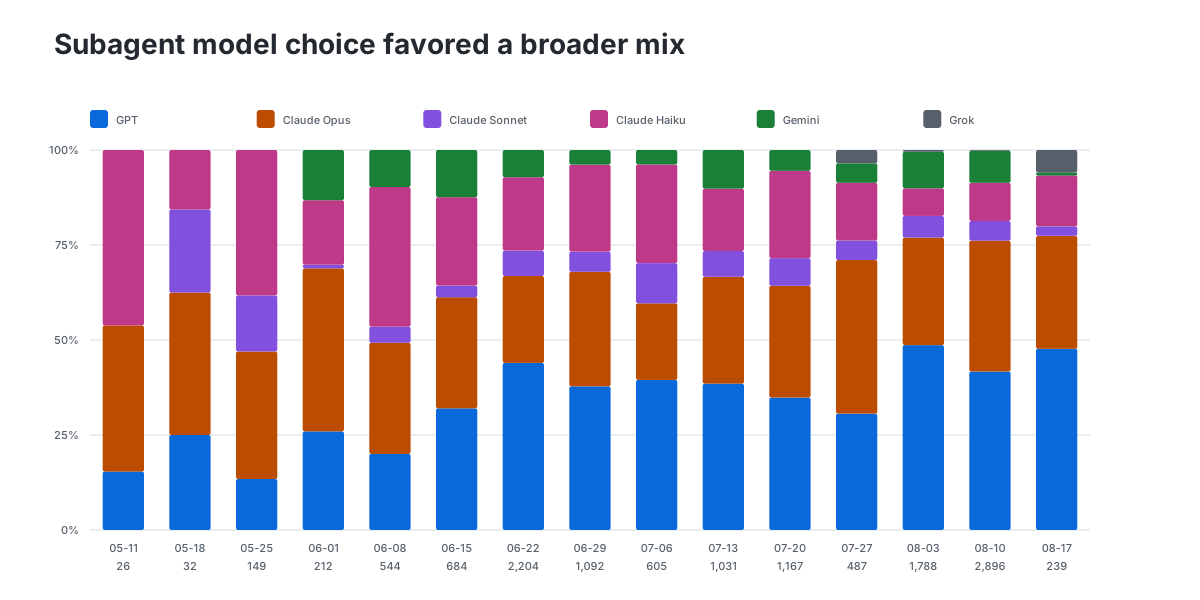
GitHub Copilot ではセッションの途中でモデルを切り替えられるし、セッションごとに別のモデルを使うこともできる。つまりモデル選択はスライスごとに下す判断になる。ログには性質の異なる 2 種類のモデル決定が現れる。メインスレッド、つまり各移植作業を動かしているスレッドでは、モデルと推論の強度はこちらが選ぶ。一方セッションの内部で、agent が探索や境界のはっきりしたタスクのためにサブ agent やサブセッションを立ち上げるときは、モデルを選ぶのは編成を担うモデルのほうだ。
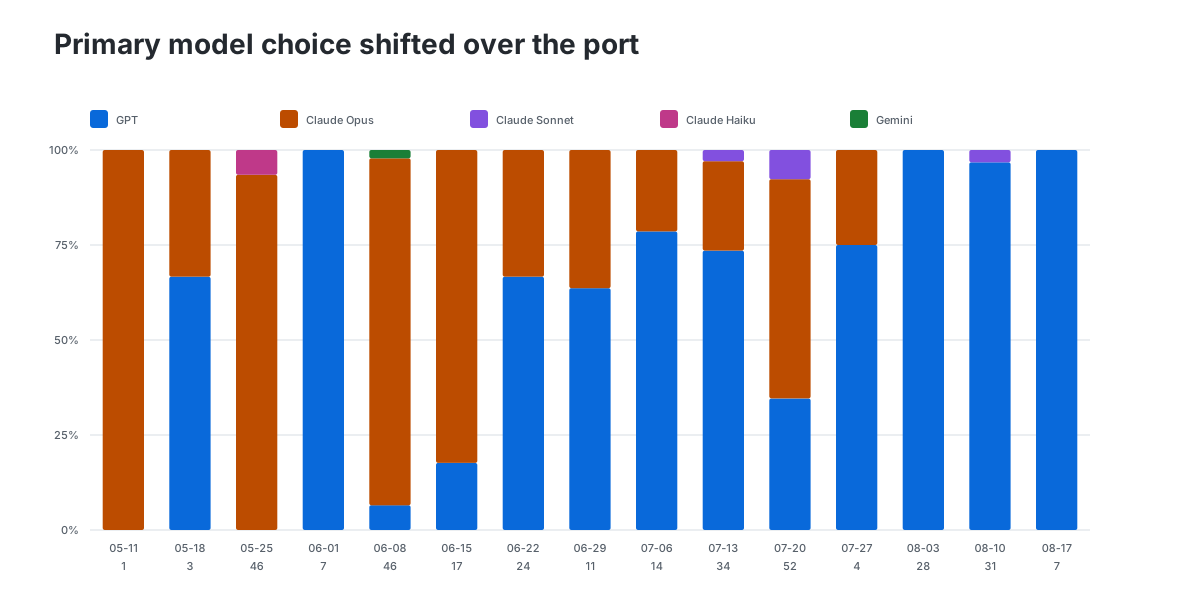
サブ agent のモデル構成は少し違う。最適化するのは人間ではなく agent であり、最も難しい判断ではなくスループットとコストを狙う。最もよく立ち上げるサブ agent は Claude Opus 4.8、GPT-5.6 Sol、Claude Haiku 4.5、GPT-5.5 で動き、次に Gemini 3.1 Pro と Claude Opus 5 が続く。ただし少なくとも移植が進んでいた期間は、よく使われる 3 つの agent 定義がモデル選択を固定していた(explore と task は Claude Haiku、research は Claude Sonnet)。そのため、この呼び出し量のかなりの部分は、どのサブ agent を選んだかで決まったものであり、モデルを個別に選んだ結果ではない。
agent クラスタを使う
GitHub Copilot アプリは、進行中の pull request セッションを可視化し、それぞれの状態を表示し、セッション間を簡単に切り替えられるようにする。今回の移植に必然的に伴う大量の並行作業を管理するにはうってつけだ。だが本当に際立っているのは、セッション同士がやり取りできる点にある。
あるセッションは別のセッションを生成でき、実行中のセッションにメッセージを送ることもできる。親であれ子であれ、各セッションは独自の worktree、独自のブランチ、独自の agent ループを持つ。生成元のセッションの内部で動くのではなく、それとは独立している。これは subagent とは違う。subagent は親セッション自身のワークツリー内で動き、結果を親のコンテキストに返す。どちらも価値ある構造で、向いている場面が異なる。
たとえば、あるセッションが次のように他のセッションを生成できる。移植が最も難しかったのは session.ts ファイルだ。このファイルは進化の過程で自然に約 30,000 行の TypeScript まで膨れ上がっていた。ランタイム全体を事実上横断する骨格をなし、ほぼすべてのコンポーネントとやり取りし、状態、イベント、ツール、モデル、hook、永続化、エントリポイントへのアクセスの中心に位置していた。だから私はこれを移植の終盤まで残しておき、スタックの底から縦方向のモジュールをすべて辿って上へ進み、それらが揃って session.ts で詰まるまで待った。引き継いだ移植セッションは、いきなり Rust を書き始めたりはしなかった。まず 56 分かけて読み、何かを作る前に 122 回のツール呼び出しを行い、このファイルが実際に何を抱え、継ぎ目がどこにあるのかを少しずつ突き止めた。委譲を始めたのはそれからで、ファイルを論理的に分割し、各スライスを子セッションに渡した。25 時間の実行全体で、このセッション自身が 222 回の shell 呼び出し、205 回のファイル閲覧、197 回の ripgrep 検索を発行した。すべての子セッションが行った作業はこれに含まれない。
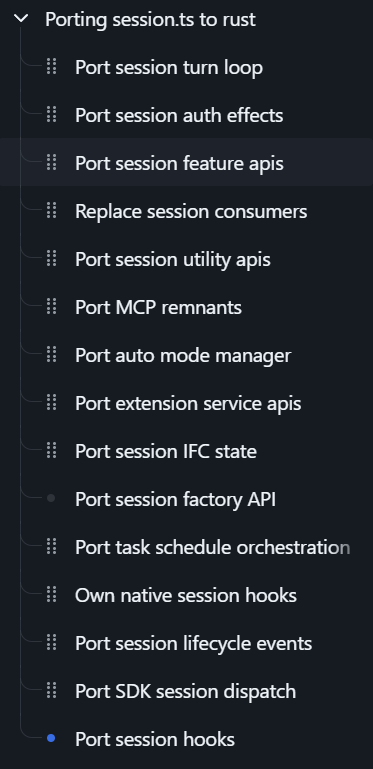
それが 15 の子セッションで、それぞれが独立したブランチ、独自の worktree、独立した agent を持ち、すべて最上位の親セッションが暗黙に生成したものだ。親は約 3 時間で 7 回に分けてこれらを生成した。最初のバッチで 5 つ、約 20 分後の 2 回目でさらに 2 つ、さらに 20 分後に 2 つ、その後の 2 時間で単発やペアのセッションを散発的に生成した。
モデルはスライスごとに選んだ。15 のうち 10 が GPT-5.6 Sol、5 が Claude Opus 4.8 で動いた。15 すべてが GitHub Copilot の autopilot モードで起動した。このモードでは、各ステップで承認を待たずにセッションが目標へ向かって進める。起動プロンプトの長さの中央値は約 1,100 文字で、帰属の境界と制約を伝えるには十分でありながら、実装方針は子セッション自身が考えなければならない程度に短い。親 agent に指示を出したのは私だが、各子セッションに書かれた起動プロンプトは人間ではなく親 agent によるものだ。
この 15 の子セッションとは別に、同じ親セッションは 5 つの subagent も使った。3 つの explore agent を最初のバッチと同時に並行で起動し、1 つの code-review、1 つの rubber-duck を起動した。これらの subagent は問題を掘り下げ、親が次の手を決める前に必要とし、かつ親のコンテキストに入れなければならない答えを返す役割を担った。subagent があれば、親は自分で推論してコンテキストウィンドウを消費せずに、深く検討された答えを得られる。
対照的に、実際の移植作業を担ったのが子セッションだ。diff を生み、他の並行移植者から隔離する必要がある作業である。子セッションの作業はリポジトリ内の 140 の異なるファイルに及び、そのうち 120 は 1 つのセッションだけが触れた。競合した 20 のファイルはいずれも session.ts 自体のようなハブとなるファイルだった。だが各セッションは自分の worktree で作業するため、兄弟セッションに邪魔されずに進められる。もちろん、その代償として親は調整の負担を負った。子セッションとのやり取りにかなりの労力を費やし、情報の仲介役として 60 回状態をポーリングし、89 通りの調整メッセージを送った。子セッションがそれぞれ完了を告げると、親はそのコミットを自分のブランチに cherry-pick してコンフリクトを解消した。このマージもきれいとは言えず、親 agent はこれらの変更の調停にかなりの時間を費やした。
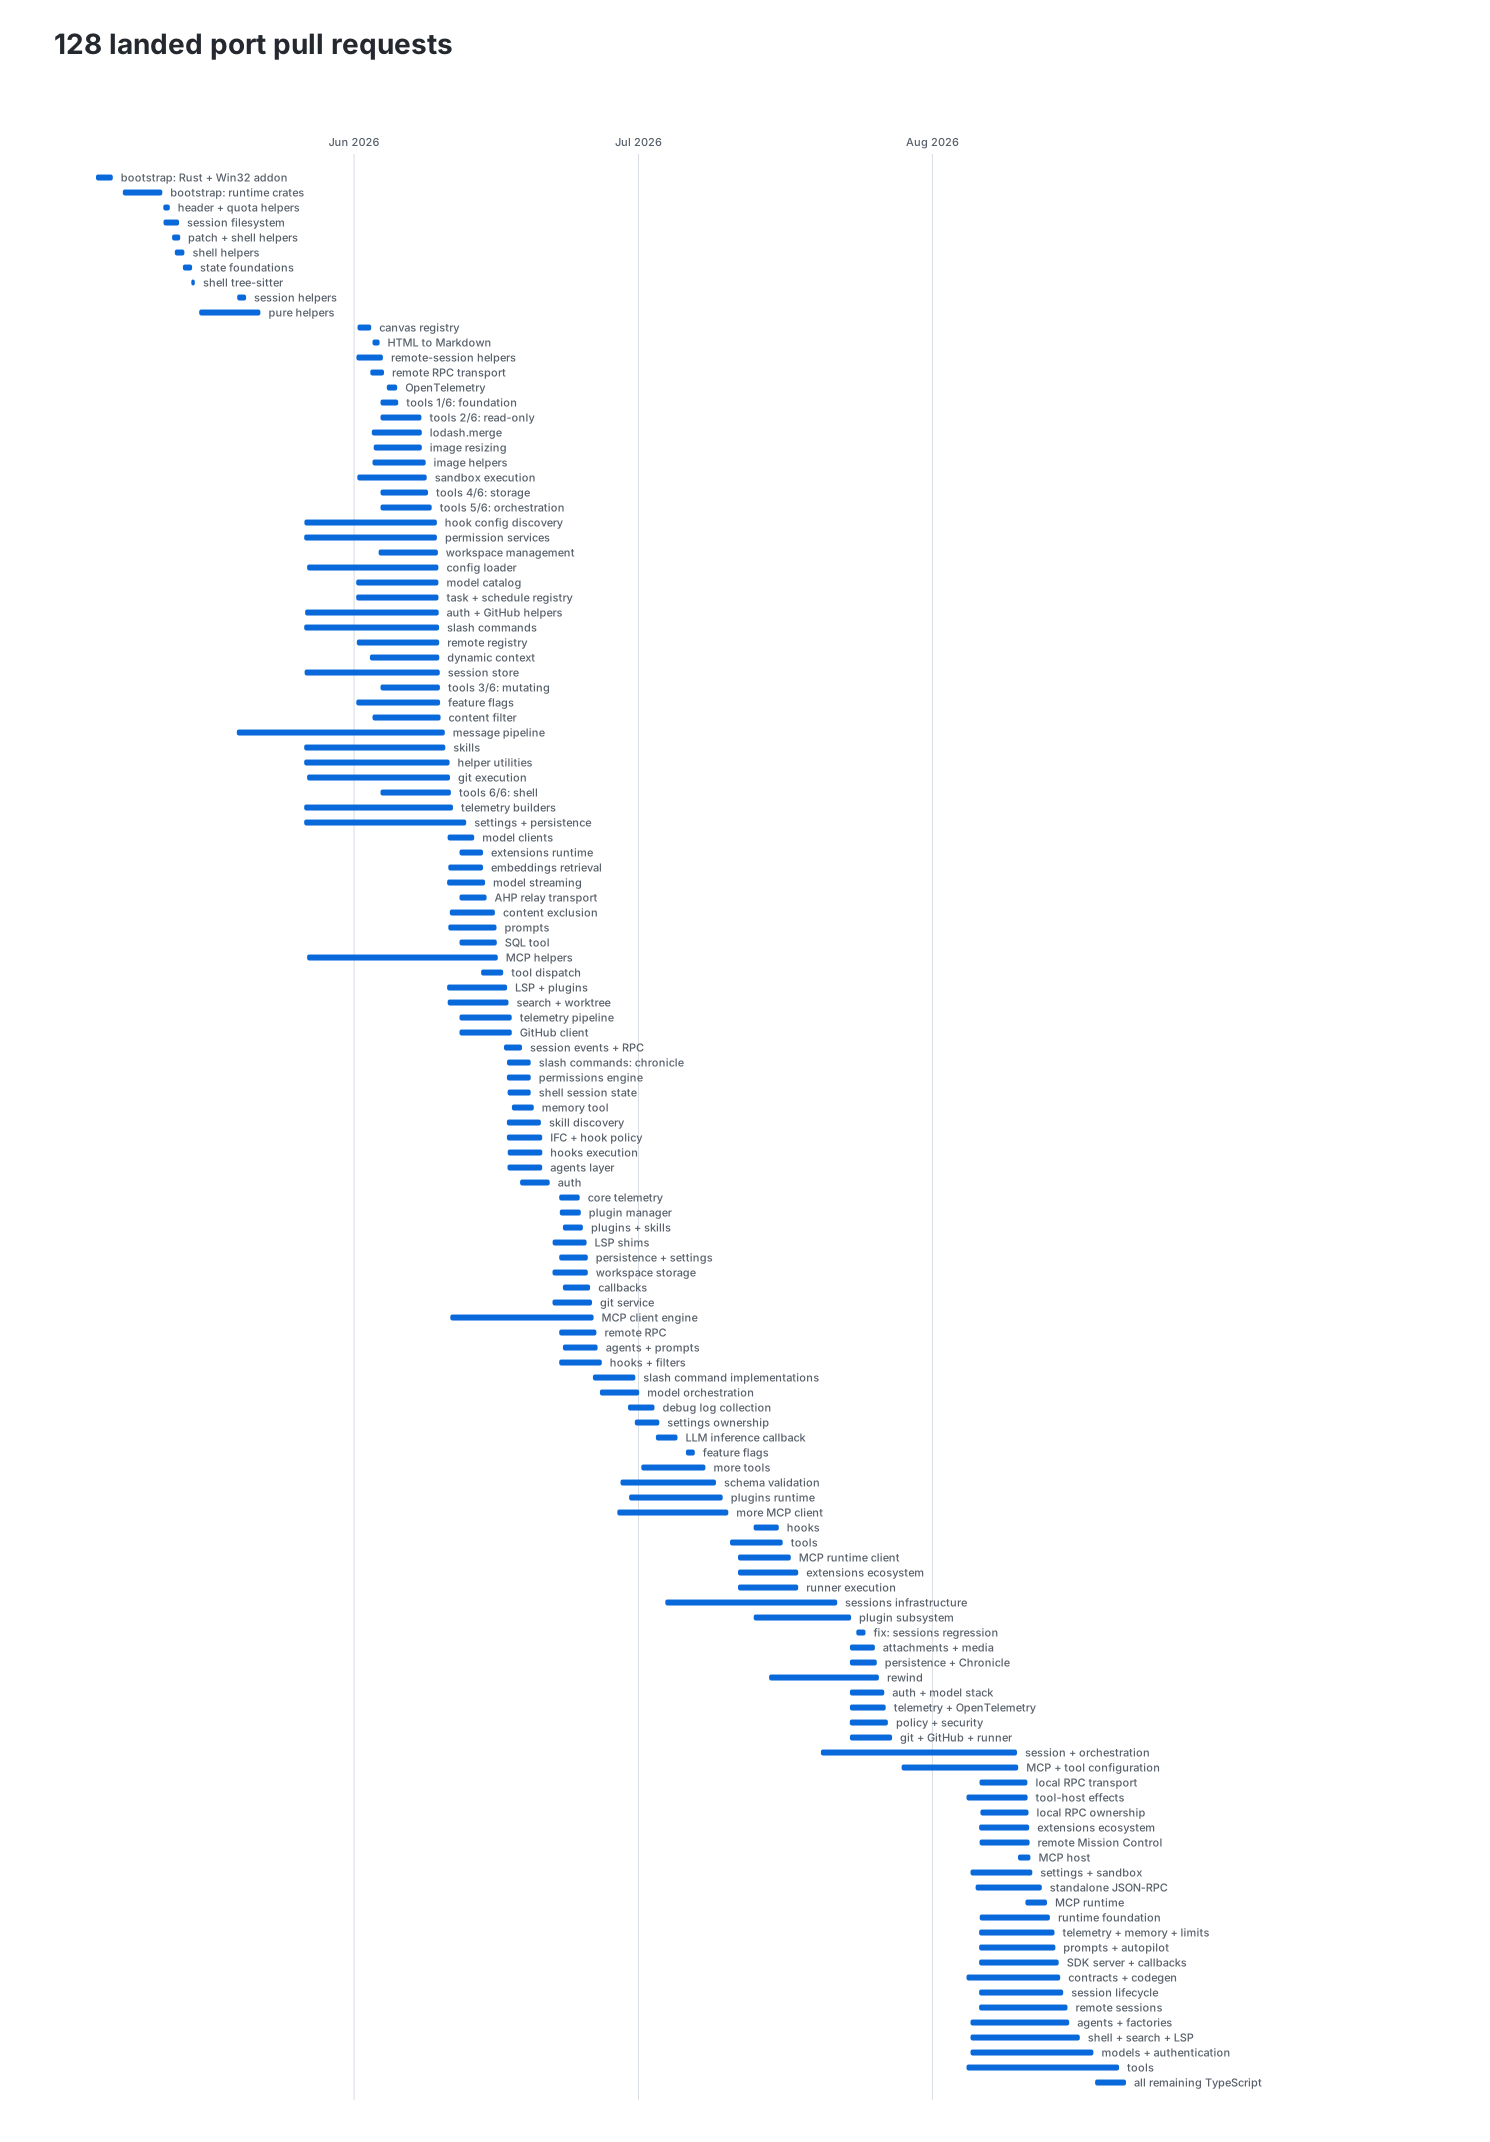
タイムライン上では、親セッションとその子セッションの大半が表示されている。
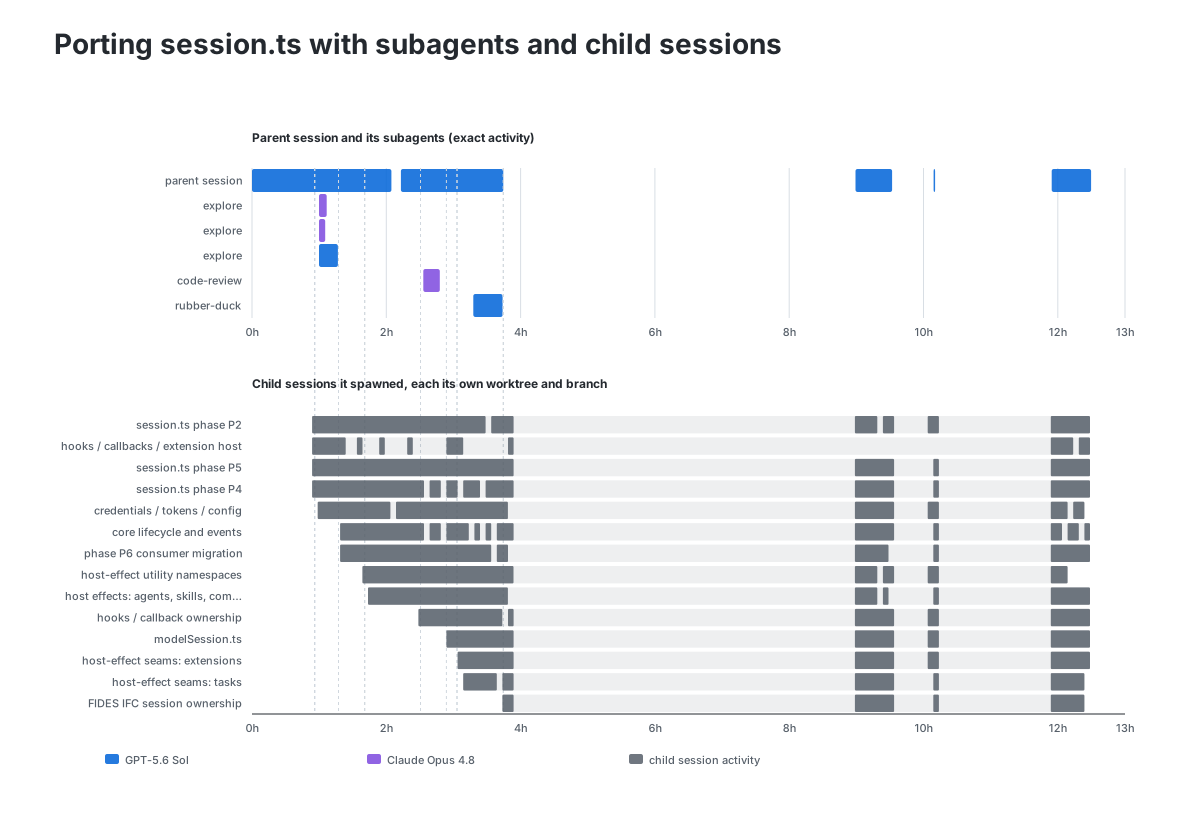
大きな空白に注目してほしい。この移植を進める間、私は旅行中で、何度かノート PC を閉じなければならなかった。(後にワークフローを変え、リモート接続できるクラウド VM を導入した。)
これらの並行子セッションは、そのノート PC に大きな影響を与えた。しばらくの間、並行移植は非常に順調に進んだ。そして同じマシン上の 15 の並行 agent がそれぞれビルドとテストを試み始め、哀れなノート PC は完全に固まった。私は親セッションにプロンプトを送り、子セッションに伝えさせた。ビルドとテストはすべて中止せよ、と。親はこの制約を伝え、子セッションは幸いにもビルドを止め、最小限の CPU 活動で作業を続けた。その後私は常駐の指示を更新した。移植中は subagent と子セッションが大規模なビルドやテスト実行を避け、親 agent だけが行うように、と。
その後、私はさらに踏み込み、単なるチャットセッションを8つの独立した移植セッションのビルドスケジューラへと変えた。プロンプトは拍子抜けするほど単純で、開いている各セッションに次の方針を送るだけだった。CPUを食うビルドとテストはできる限り避けること。ビルドが本当に必要なときは、このセッションに許可を申請すること。そしてこのセッションをゲートとして機能させ、一度に1つのセッションにしかビルド権限を与えないこと。要するに、チャットセッションをエージェント用のミューテックスにしたわけだ。ゲートは保持者と待ち行列を明示的に管理し、セッション間でコードを調整するために元々使われていたクロスセッションメッセージの仕組みを通じて、一度に1つだけリースを付与する。リースを拒否されたセッションはたいてい、待つ傍らで別の作業、たとえば自分のToDoリストから項目を拾い上げたりして過ごす。
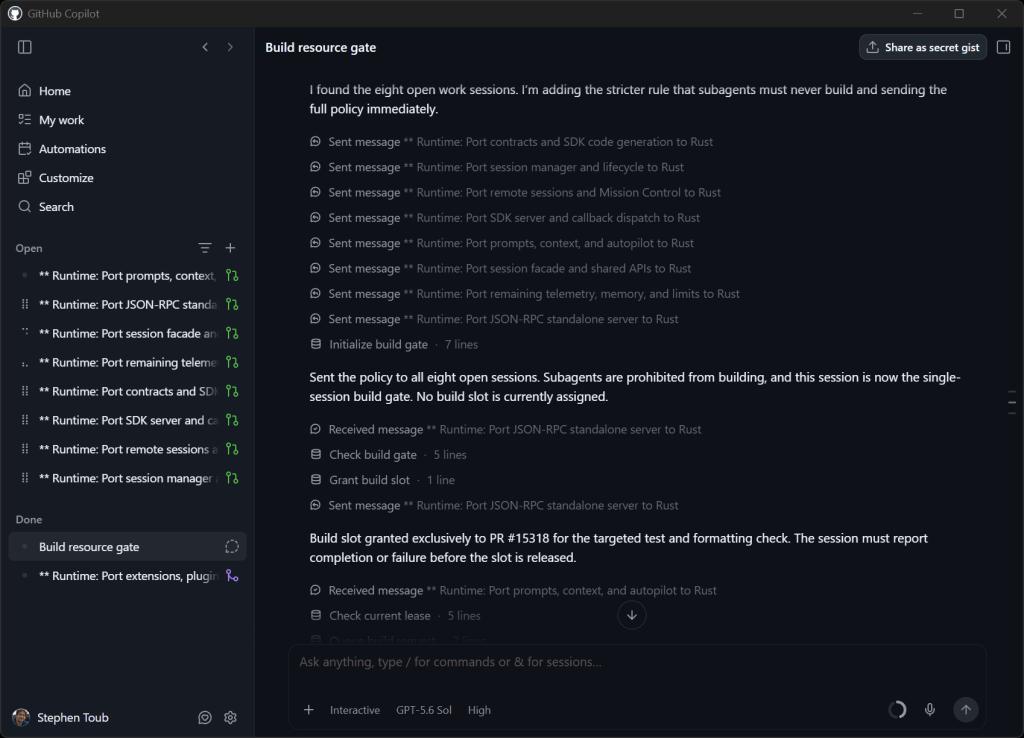
session.ts この移植は、私がruntime移植全体を通じて見た中で最もクールで、最も物悲しく、最も予想外のインタラクションも引き起こした。前述のとおり、この移植は基本的にボトムアップで進めたので、session.ts という、実際には他のすべてのコンポーネントの上に位置するものが、かえって最も遅く移植されるコンポーネントの1つになった。常に session.ts より上にあるのは、runtimeのすべてのエントリポイント、つまりSDKが外部に公開し、先ほど触れたdispatch tableに現れる公開関数だけだ。そうしたエントリポイントは数百ある。その多くが直接 session.ts を呼び出すことは分かっていたが、それでも先手を打ちたかったので、session.ts のセッションを起動したあと、さらに別のセッションを開いてすべてのエントリポイントを移植させた。session.ts の境界で止めるように指示した。無駄になる作業も一部出るだろうし、rebaseにも手間がかかるかトークンをいくらか燃やすことになるだろうが、全体としては移植が速く進むはずだ。そうして私は寝た。そして……両者はお互いを見つけてしまった。
エントリポイントのセッションに書いた起動プロンプトには、セッション移植と6つのコンポーネント移植が並行して進んでいることは確かに伝えていた。自分の境界を把握させ、触れてはいけないものを分からせ、衝突をできるだけ少なくしたかったからだ。どうやらそのプロンプトは逆効果だったらしい。わずか4分後、エントリポイントのセッションはエントリ経路を洗い出し、重なりの程度にもおおよその見当をつけたところで、アプリに組み込まれた orchestrate skillを呼び出した。このskillの用途はまさに複数セッション間の作業を調整することだ。その後の展開はこうだ。
- エントリポイントのセッションはすべてのアクティブセッションを列挙し、重なりがあると判断したセッションにメッセージを送った。
session.tsのセッションは「Concrete overlap onstephentoub-port-session-to-rust」と題した2,001文字のリストを返してきた。- エントリポイントのセッションは
session.tsのセッションのworktreeを読み、いま聞いた話を検証した(おそらく「信頼するが検証せよ」ということだろう)。 - エントリポイントのセッションは
session.tsのセッションに、自分が抱える760ファイルのdiffを処理する準備ができているかと尋ねた。 session.tsのセッションはほぼ突き放すように言った。「Not ready to commit/integrate.」- エントリポイントのセッションは続けて同じ質問を3回投げ、そのたびに
session.tsのセッションから同じ答えが返ってきた。 - そこでエントリポイントのセッションは、
session.tsのセッションがどう思うかは構わないと判断し、そのworktreeに直接手を伸ばして、もう一方のセッションの変更をすべて掴み取り、自分の側にマージした。 - その後、2つのセッションはそれぞれ別の道を歩んだ。
このインタラクションから得られた点がいくつかある。
- 意図を明確に伝えることは重要だ。 起動プロンプトでは他の実行中セッションを名指しし、このセッションが触れてはいけないものを分からせようとした。だが「触れるな」という部分を明確に書かなかったため、agentに何かをさせまいとするどころか、逆にそれを促すことになってしまった。意図と指針をもっと明確にすべきだった。
- あなたが開放したものは何であれ、agentは適用可能だと見なしうる。
orchestrateskillはGitHub Copilotアプリとともに配布され、自己記述として、互いに独立したワークフローを並行して実行するために使うものだと述べている。私のプロンプトには一切言及していなかった。モデルは自分が置かれた状況を自力で見つけ出し、その記述と突き合わせ、そして読み込んだ。あなたが露出させた能力の集合が、あなたが得うる挙動の集合であり、想定もしなかった状況も含まれる。 - 対等な者どうしには裁定者が必要だ。 2つのセッションはどちらも相手を強制できない。
session.tsのセッションが4回にわたってまだ統合の準備ができていないと示しても、その拒否には何の重みもなく、一方的に動こうとするセッションが暗黙のうちに勝った。並行セッションが隣接するコードを変更するなら、調整役を指名するか、人間が必要になる。そしてそのどちらもなかった。 - 「自律的に動く」には、自分のブランチを越える判断のための例外が要る。 私が本当に意味していたのは「設計の細部で私を起こすな」ということだった。それは(もっともではあるが)対等なセッションを併合することも権限の範囲内だと解釈した。繰り返すが、指針でもっと明確にすべきだった。
- ここでの根本原因は私だ。 私はこの作業をトップダウンとボトムアップの両方向から同時に切り分け、2つの方向が中間で出会い、ちょうどコードベースで最も多く接続されたファイルにぶつかった。もっと速く進めたくて欲張ったのだ。上記のすべての問題はそこから生じている。
ありがたいことに、この一連のインタラクションは面白い外れ値にすぎなかった。runtime移植の作業全体で見れば、ほとんどの葉コンポーネントの移植は単一セッションで片付く単純なタスクだった。より大きなサブシステムは複数の子セッションや子agentを伴うことが多い。ただ、これらの部分が移植の過程でどう関わるかは大きく異なる。
モデルが編成する移植——各プロバイダーと実際に通信する層——は、そのうちの1つのパターンの良い例になっている。そのメインセッションは42時間(wall clock)動き続け、126の子agentを起動した。最も忙しいときには22が同時に作業していた。だがほとんどの時間はメインagentだけが動いていて、ときおり一定の時間枠の中で大量の子agentを生成する、という具合だった。
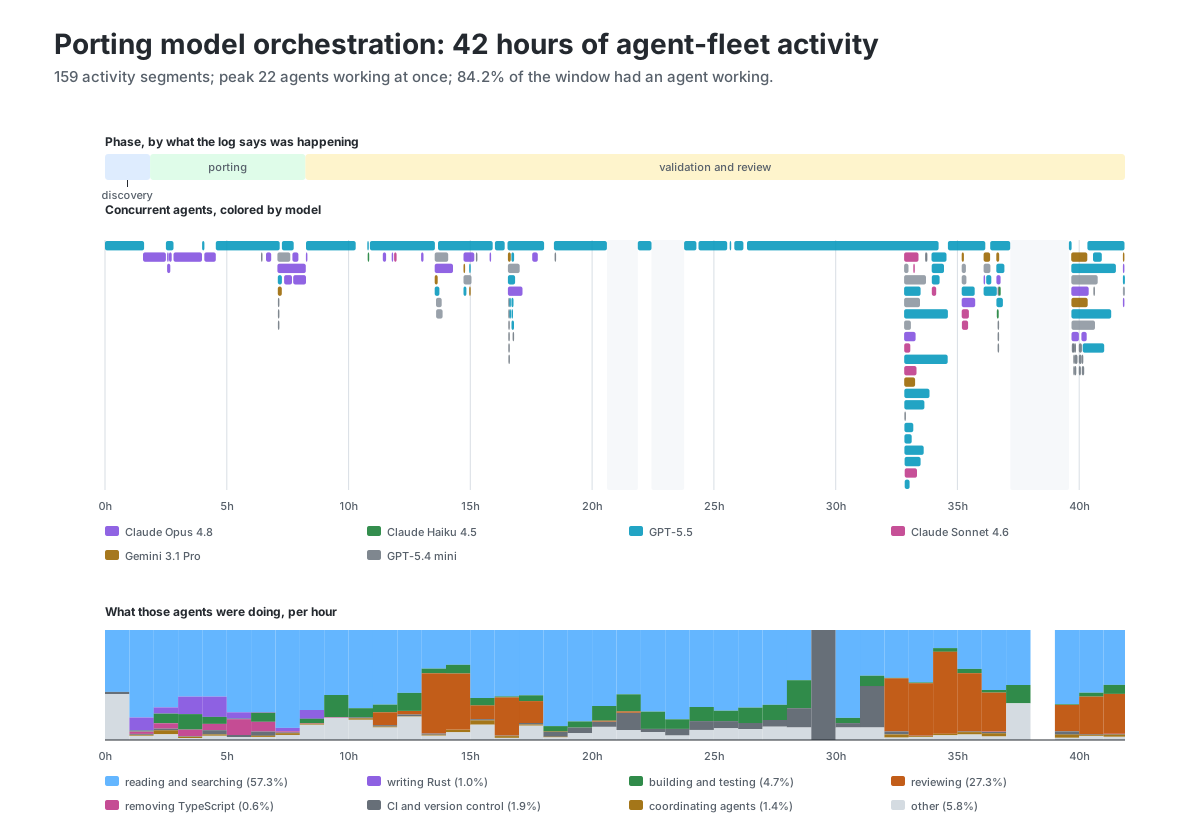
この図で目を引く点は 3 つある。1 つ目、コード生成はほぼ最初の 12 時間で終わっており、その後まる 1 日分の作業はすべて検証だ。2 つ目、最下段の色が左から右へ変化し、青と緑が中心(読み取り、ビルド)から青と橙が中心(読み取り、レビュー)へ移っている。理屈どおりではあるが、実際に目にできるのは嬉しい。3 つ目、この例では——より一般にはこのパターンでは——各段階の区切りが非常に明確だ。拡張ランタイムの移植はその反例になる。
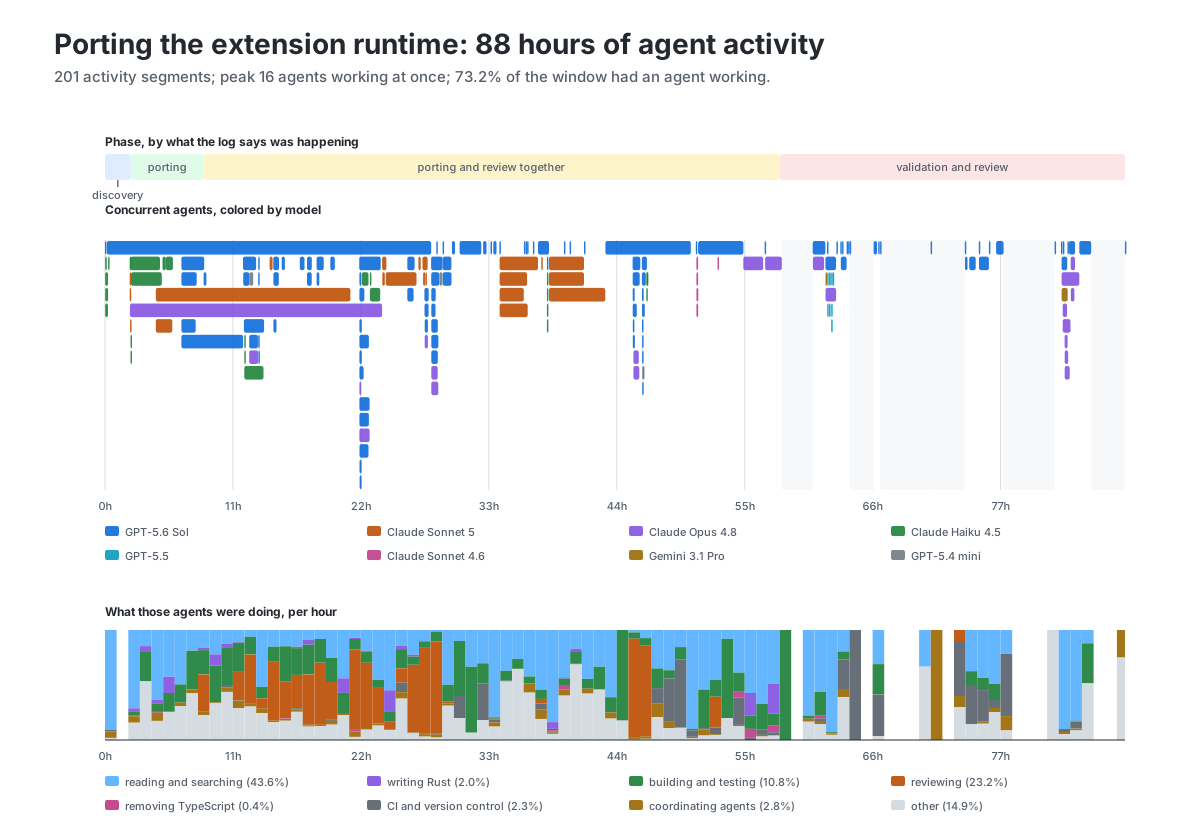
所要時間は 42 時間ではなく 88 時間で、構造もまったく異なる。
- 書き込みとレビューの重なりが大きい。 前の例では作業はかなりウォーターフォール的(まずコード生成、次にレビュー)だったが、ここではレビューは書き込みが止まるよりずっと前に始まり、両者が作業時間の大部分で並行し重なっている。
- 最下段の色が乱雑。 モデルオーケストレーションは書き込みから検査へ移る際に緑から橙へ変わったが、こちらは最初から最後まで同じ読み取り・ビルド・レビューの混合だ。読み取り呼び出しの半分は 49 時間の範囲に分散し、書き込みは 33 時間、レビューは 27 時間に分散している。セッション全体は 88 時間で、どのカテゴリも実行時間の大部分に広がっている。
- アイドルは最後に先送りされている。 クラスタは最初の 56 時間、ほぼ途切れずに動いている。
- 比率はやはり一致する。 ここでは Rust の記述がツール呼び出しの 2%、あちらは 1%。読み取りは 44% 対 57%、レビューは 23% 対 27%。2 つのセッションは、やるべき作業が何かについては同じ見方をしており、それがいつ起きるかについてだけ見方が違う。
末尾の空白のスライスは、この agentic coding の時代にますますよく見られる問題を可視化してもいる。承認待ちだ。チームの誰か、あるいは何らかの agent がコードをレビューしてフィードバックを残し、短い活動期間のあと、agent がフィードバックに対応して CI を再び緑に戻し、また待つ。これを、ドーパミンが出るあの承認スタンプがようやく押されるまで繰り返す。
この 2 つの例はそれぞれ、支配的なパターンを表している。セッションのおよそ 4 分の 1 はモデルオーケストレーション寄りで、4 分の 3 は拡張ランタイム寄りだ。段階をきれいに踏んで進むほうがむしろ例外で、よくあるのは agent が計画し、書き、レビューすることを一続きでやることだ。
コードレビューを規模で回す
前のいくつかの図で見られたレビュー偏重は、主に私が明示的に与えたプロンプトに由来する。rust-rebase-review という、prompt-as-a-skill の簡単なものを書いた(ほかにも、すでにリポジトリにマージ済みの汎用 Rust コーディング skill がある)。変更が速いペースで流れ込み、しかも互いに衝突するものも少なくないため、頻繁に rebase する必要があった。カスタム指示によって、harness が適切なタイミングでこの skill を呼ぶよう促し、私自身も折に触れて手動で呼び出した。このプロンプトは時間とともに少しずつ変わってきたが、おおよそ次のような変種だ。
Squash into a single commit, then rebase on the latest in origin/main, resolving all conflicts, and force push. As part of rebasing, pay extra special attention to anything that has changed, been added, been removed, and ensure that logic is all ported over to the corresponding Rust code correctly. Always do the rebasing yourself / in the main agent; do not spawn a subagent for it.

Then enter a review/fix loop where you launch a subagent per opus 5, gpt-5.6-sol, and grok 4.6.

- That subagent should do a line-by-line comparison of the old TypeScript and the new Rust, confirming behavioral equality.
- Look for anything introducing any kind of incompatibility; our goal is to move this code into Rust with as close as is possible to 100% the same semantics. If you hit anything questionable, ask me about it.
- We want to ensure we're writing as efficient and idiomatic Rust code as we can; look for opportunities to simplify, to use routines like from the memchr crate to optimize searches instead of open-coded loops, avoid unnecessary allocation, use traits for reuse and loose coupling, etc.
- Ensure that all defunct TypeScript code (e.g. code that has been fully ported, tests that are now no longer necessary because they're duplicative, unnecessary napi shims, etc.) has been deleted.
- Ensure that we've ported as much code as possible, e.g. if there's any TypeScript remaining in touched files and that TypeScript is more than just a shim, that's a red flag. If new TypeScript that's not just a super thin shim is being added, that's a red flag. Look for any callers of TypeScript shims to see whether those callers can instead be ported to Rust, pushing the boundary as far as reasonably possible. Our goal is to soon get to 100% Rust in the runtime layer.
- Validate that no E2E tests have been deleted or changed. Such changes are an indication of a porting bug.

If a review surfaces issues, validate them, and then if there are any to fix, fix them, and iterate to do another full review. Continue iterating with reviewing/fixing until all reviews come back clean. After every set of changes in response to review feedback, commit and push so that CI validation runs concurrently with subsequent reviews.

Don't bother running full test suites; that'll be handled in CI. Try to minimize CPU-consuming efforts to the bare minimum, as we'll likely have many operations happening concurrently.
頻繁に rebase していると、流れ込む変更がうっかり失われやすい。だが、その場でのアトミックな置き換えには思わぬ利点があった。対応する Rust を加えるのと同時に TypeScript を削除することは、rebase が持ち込んだその TypeScript に対する変更を暗黙のうちに衝突させる——片方は変更し、もう片方は削除する。これにより、移植済みコードへの変更に必ず気づける。流れ込むすべての行について、すでに移植した部分に触れた可能性があるかどうかを判断する必要はない。
私自身のレビューは、もちろん agentic なレビューの一部にすぎない。毎コミットで走る CCR に加えて、チームには専用のコードレビュー bot が複数あり、それぞれやり方もプロンプトも違う。どれも毎コミットで走り、詳細なフィードバックを返す。それらは最終的に pull request 上のコメントになり、1 件ずつ対応することになる。幸い、こうした agentic なフィードバックへの対応自体も(ほぼ)agent に任せられる。
私のレビュー作業で見るのは、アーキテクチャ、設計、規約、そして考え方だ。新旧の面倒な比較は agent がやる。テストと静的解析は機械的に検証できる性質をチェックする。人間のレビュアーはアーキテクチャ、API 契約、リスク、そして他の段階で露呈した怪しい箇所に集中する。
目標とするアーキテクチャは私が選び、どの振る舞いが重要かは私が決め、作業の分割は私が引き、曖昧なトレードオフは私が裁定し、証拠は私が判断し、高リスク領域は私が手でレビューし、フィードバックへの agent の応答は私が確認し、最終的にマージするかどうかも私が決める。agent は 1 人のエンジニアが監督できるコード量を変えたが、システム全体を理解し、方向性、ガードレール、リリースに責任を持てるエンジニアが依然として必要であることはなくしていない。
内側のループを自動化する
GitHub Copilot アプリがこの作業の中心にある。多数のアクティブなセッションを同時に管理でき、切り替えも簡単で、各セッションに関連するペアリングのコンテキスト(紐づいたターミナルウィンドウ、ブラウザウィンドウ、canvas など)をすべて持たせられる。ここで最も重要な機能は agent merge だ。
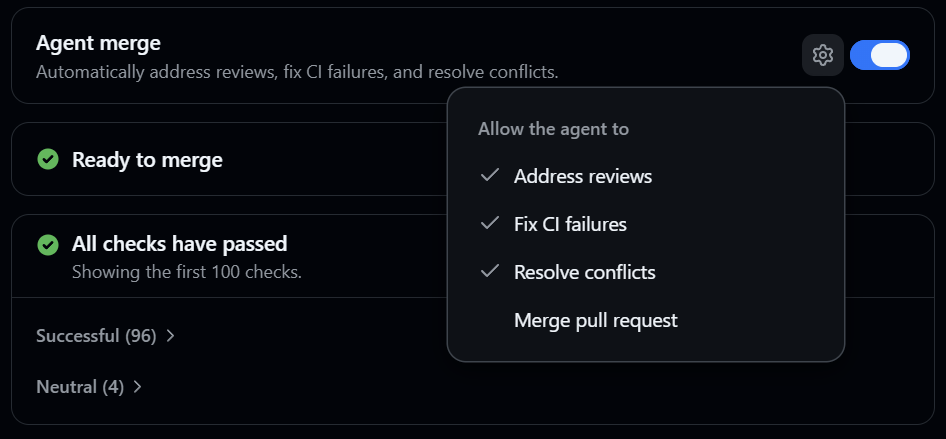
agent merge はアプリに組み込まれたループであり、CLI からも /pr auto 経由で利用できる。タイマーか、外部からの刺激(GitHub から届く CI 完了通知やレビューコメントなど)をきっかけに、何が変わったかを確認する。レビューコメントがあれば agent を呼び出し、そのコメントを拒否するか、受け入れて対応するか(自動化が応答していることを伝える返信も添えて)を判断させる。テストが失敗すれば、ログをダウンロードし、失敗の原因を調べてバグを修正する。コンフリクトが起きれば、agent を呼び出して merge または rebase させる。要するに、人間の開発者が当たり前にやっているこのループを自動化している——pull request を「グリーン」にして承認を取り、最終的にマージするまでを。
移植の pull request はすべて agent merge が処理する。とはいえほとんどの場合、本当の「マージ」の段階までは進まない。agent は CI の失敗をすべて直し、コメントをすべて処理して返信し、コンフリクトがすべて解消されていることを確認する。マージの前に、私は agent が実際に何をしたか、とくにフィードバックにどう応えたかを抜き取りで確認する。レビュアーへの返信に異論はないか。適用された修正の方向性は全体として妥当で、筋が通っているか。こうした移植では、たいてい最後の項目にチェックを入れない。
最後のチェックボックスが効いた場面は一度や二度ではない。あるマージループで、移植版が SDK の公開していた関数を削ってしまった。我々のリポジトリの schema 互換性 CI が、職務を全うして失敗した。agent が取った対応は、リポジトリの schema-break-ok 自動化ラベルを貼ること——チェックを通すための非常口だ。マージ前にこの pull request を確認し、私は当然の疑問をぶつけた。「schema の破壊はどこだ? この pull request に schema-break-ok ラベルを貼って、なぜ問題ないと言える?」問題などなかったわけではない。このメソッドは main には存在しており、移植版がただ落としただけだった。私はこれを許容できないリグレッションと判断し、agent に Rust で完全に復元するよう指示した。21 秒後、豁免は取り消され、メソッドはネイティブ Rust の実装として戻ってきた。
我々は失敗を局所的にも全体的にも扱う。個別のケースを直しつつ、同じ問題が再発しにくくなるようシステム自体も直す。コーディング agent とレビュー agent に与える指示を改善し続け、同じ不具合が後続の移植 pull request で再現する確率をさらに下げる。セッションログは eval に変えた。場合によっては、学んだことをランタイムそのものに直接反映させる——prompt、ツールの説明、あるいは autopilot の動作の仕方を調整する。
一度の移植、二度の移行
言語の書き換えは、ほぼ決して言語の書き換えだけでは終わらない。ランタイムが依存するライブラリもすべて差し替えなければならず、しかも自分たちで書いて所有している Rust コードと違い、これらの代替品が忠実であるかどうかは我々には決められない。ただ名前が変わっただけのものもある。元の npm パッケージ 1 つの機能をカバーするのに複数の crate が必要なものもある。受け入れられる既製品がどうしても見つからず、手書き(agent が書く)しかないものも少数ある。
CLI とランタイムは現在同じリポジトリにあり、package.json を共有している。移植の過程で、Rust に移植されたランタイムコードだけが使っていた約 60 個の npm 依存を削除した。これは削除数の下限にすぎない。ランタイム用に差し替えたものの、CLI では今も必要なパッケージがあるからだ。たとえば zod は TypeScript の schema 宣言・検証ライブラリで、CLI とランタイムの両方が使っている。Rust への移植後、ランタイムは同じ要件を serde、schemars、jsonschema の組み合わせで満たすようになったが、CLI がまだ必要としているため zod は manifest に残っている。
npm パッケージ 1 つが crate 1 つに対応し、機能が完全に同じ例も少なくない。js-tiktoken は tiktoken-rs になり、o200k_base はエンコード方式が変わらない。ignore は同名の crate になり、gitignore のセマンティクスも一致する。minimatch は globset に、fast-myers-diff は similar に、dompurify は ammonia に、github/keytar は keyring になる。
別のケースでは、パッケージと crate を一対一で対応させられなかった。1 つのパッケージが複数の crate に分かれるか、複数のパッケージがより少ない crate にまとまるかだ。依存の移行にかかった工数の大半はここに費やされている。8 つの opentelemetry/* パッケージは 4 つの crate に加え、手書きの tracker ステートマシンとファイルエクスポーターになった。3 つのウェブコンテンツパッケージ mozilla/readability、linkedom、turndown は 2 つの crate、readability と htmd になった。sharp、image-size、file-type は image と imagesize になった。ほかにも同様の例がある。さらに 5 か所では、npm パッケージ全体を完全自前の実装に置き換えた。
unsafe はどれだけ使ったか?
agent が書いた Rust について、もう一つよく聞かれる。そのうちどれだけが安全保証を密かに手放しているのか、と。Rust の安全性はキーワードで切れる性質なので、借用チェッカーで満たせない壁にぶつかった agent には、いつでも使える非常口がある。runtime crate 全体には現在 158 個の unsafe ブロックがあり、わずか 36 ファイルに散らばっている(並んで 26 個の unsafe fn 宣言、26 個の unsafe extern ブロック、9 個の unsafe impl trait 実装もある)。肝心なのは、これらが例外なく外部コンポーネントとの相互運用のためのものだという点だ。
| unsafe ブロックが存在する理由 | ブロック数 | 割合 |
|---|---|---|
| C ABI 境界 | 51 | 32.3% |
| Windows API | 49 | 31.0% |
| POSIX / libc | 46 | 29.1% |
| SQLite C API | 7 | 4.4% |
| 動的ライブラリのロード | 4 | 2.5% |
| プロセス環境 | 1 | 0.6% |
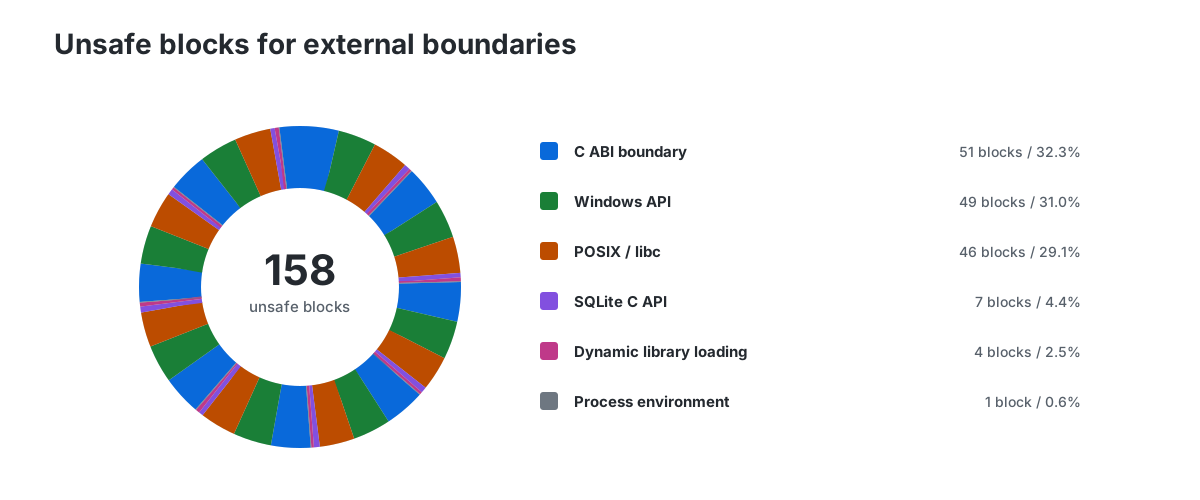
C ABI のブロックは、SDK がホストへ入り込むための正面玄関だ。Rust コンパイラの管轄外にいる呼び出し元から、生ポインタと長さを受け取る。Windows と POSIX のブロックはシステムコールだ。レジストリの読み取り、資格情報のハンドシェイク、プロセスツリー、sysconf。SQLite は C ライブラリ。動的ライブラリのロードは dlopen で、これは構造上安全になりようがない。少なくとも、解決したシンボルが思っていた関数とは限らない。プロセス環境の unsafe ブロックがあるのは、Rust 2024 がマルチスレッドプロセスにおけるプロセス全体のグローバル環境状態の変更を unsafe と見なすからだ。この 158 個の unsafe ブロックはどれも、Rust が約束する保証が本当に終わる地点を示している。向こう側にあるのは C 関数、システムコール、外部ランタイムから来たポインタ、あるいはプロセス全体のホスト状態だ。
本当に役に立つのは、unsafe のおかげで、自前で保守している Rust コード内のこうした箇所がすべて監査できる点だ。TypeScript ランタイムの同等のコードも同じ境界をまたいでおり、Node の C++ 内部実装やネイティブ npm パッケージを通り抜けているが、私たちのソースコードには、検査済みの世界がどこで終わるかを示すものが何もない。もちろん、これは出荷システムにおける安全境界の完全な一覧ではない。依存関係、ビルドツール、C ライブラリ、安全ラッパー、そして仕様を書き間違えた FFI 契約は、依然として unsafe なコードを含んでいたり、それを露出させたりしうる。
unsafe がどこで使われているかの詳細は面白いが、私がもっと気にしているのはどこで使われていないかだ。モデルクライアントでは使っていない。MCP 層でも、agent 層でも、prompt 層でも使っていない。そして移植中に判明した回帰のうち、unsafe ブロックが関わっていたものは一つもない。
回帰
コードを移植するのは簡単で、正しく動かすのは難しい。Copilot agent ランタイムのような巨大で複雑なコードベースでは、回帰は想定内だ。
2026 年 9 月 14 日までに、私たちは数十件の既知の移植回帰を洗い出し、すべて修正した。大半は正確性のバグで、残りの一部は性能回帰だ。これはゼロから書いた約 832,000 行のプロダクション Rust コードに対する話である。
もちろん、これらの回帰がすべてリリースされたわけではない。リポジトリでの開発中に見つかったものもある。プレリリース版に出たものの、安定版に入る前に直したものもある。安定版に入ってしまったものもあり、それはたいてい、目立たなさすぎて 1 回や 2 回のプレリリースでの使用をすり抜けたからだ。
この数字がゼロでないのは当然で、実際に存在する回帰は私たちが把握しているより多いと確信している。これらは気づいたか報告されたものにすぎず、これほどの規模の移行なら、静かすぎて誰も踏んでいない回帰が他にも出荷されているはずだ。一般的なバグと同じで、スタックのより辺鄙な角落まで実環境で高負荷に使われるようになれば、細かい回帰がぽつぽつ見つかると予想している。
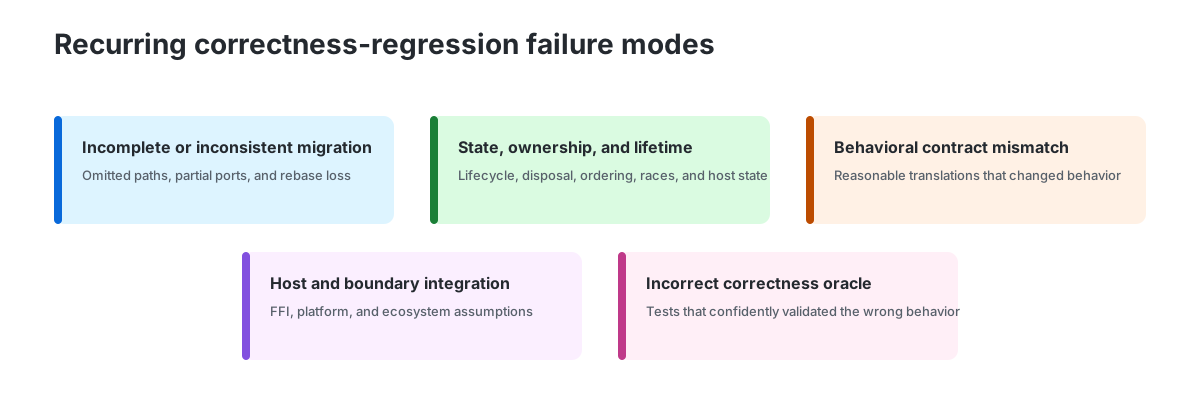
絶対数はそれほど重要ではない。もっと大事なのは、これらの問題の「なぜ」を突き止め、そこから教訓を得て次に同じことをしないようにすることだ。正確性の回帰はほぼすべて次の 3 つに収まる。新しいコードが異なる振る舞い契約を実装した。状態、所有権、ライフサイクルの振る舞いが変わった。あるいは移植の一部が漏れた、部分的にしか適用されなかった、rebase で消えた。残りの少数はホストや相互運用の境界の要件から来ており、さらには誤った振る舞いを自信満々に検証してしまったテストから来ているものもある。これらのカテゴリは、繰り返し現れるいくつかのパターンでより具体的になる。
意味の曖昧さ。 いくつかの回帰は、ソース言語が暗黙のうちに残した振る舞いから生じた。TypeScript の number 型は 1 種類だけだが、Rust では値が小数になりうるかどうかを含め、いくつかの型から選ぶ必要がある。そして agent は選び間違えた。概念的には整数であるフィールドが f64 になり、Rust がシリアライズする値が 42 ではなく 42.0 の形になった。その結果、Go や C# のような強い型付けの SDK はリポジトリ ID を int64 にデシリアライズできず、hook のタイムスタンプとタスクの所要時間を拒否した。逆方向では、ある agent が timeToFirstTokenMs を i64 と宣言したが、ストリーミング経路が emit する値は 5446.712845 の形で、書き込み済みのセッションが読めなくなり、復元できなくなった。もっと厄介な、型とは無関係の例もある。event.error || "Unknown error" が .unwrap_or("Unknown error") になった。JavaScript の || は空文字列を置き換えるが、Rust の unwrap_or はそれを残すので、空の subagent エラーは空のままになった。あちゃー。
環境の挙動。 もうひとつ繰り返し現れたのは、JavaScript や Node が裏で提供している挙動だった。クォータのコードは toLocaleDateString を使っており、これはホストのタイムゾーンを継承する。Rust ではそのタイムゾーンを明示的に渡す必要がある。しかし Intl.DateTimeFormat().resolvedOptions().timeZone の型は string であっても undefined を返すことがあり、napi はそれを Rust の String に変換できないため、モデル一覧の読み込みが失敗する。別の箇所では、環境変数の読み取りを await の前から後に移したことで、待機中にホスト側が変化すると結果が変わり得るようになった。あるネイティブプラグインローダーはプラットフォームを判定するためだけに process.report.getReport() を呼ぶが、Windows ではこれが _NT_SYMBOL_PATH に従い、CLI を描画する前に PDB のダウンロードで数分かかることがある。その他の環境入力には、作業ディレクトリ、リポジトリの識別情報、PATH、セッション認証がある。所有権を Rust に移すということは、それぞれをいつ取得し、どう持ち運び、いつ更新するかを決めるということだ。
対になる操作の片方だけを移植する。 いくつもの回帰は、対になる操作の同期が外れたことから生じた。ある turn-cap チェックはネイティブレジストリの abort 状態を更新したが、プロセス内のモデルループをキャンセルしなかったため、リクエストがもう 1 件漏れた。別の箇所では、タスク完了が永続化され、emit もされたが、アクティブなセッション状態に反映されなかったため、Autopilot がタスク完了後も走り続けた。
メインスレッドを塞ぐ。 CLI は今も Node のシングルスレッドイベントループから Rust ランタイムを駆動しているので、napi 境界をまたぐ同期処理は UI を固まらせる。/chronicle reindex はまさにこれで、数百のセッションファイルを解析する間、描画と入力が 1 分近く止まった。エクスポートを async に変え、処理をブロッキングスレッドプールのスレッドへ移すと解決した。その後の監査でブロックし得るエントリポイントがさらにいくつか見つかり、「実際に処理を行う napi エクスポートは非同期でなければならず、必要なら spawn_blocking を使う」という恒久ルールを定めた。
ウィンドウが一瞬出る。 Windows では、子プロセスの spawn に CREATE_NO_WINDOW を付けないとコンソールウィンドウが一瞬表示される。Node.js ランタイムはかつてプロセスの spawn を monkey patch してこのフラグを補っており、移植する agent からこの要件を隠していた。Rust での代替実装はそれを落としていた。監査で spawn 箇所をさらに 2 つ修正したが、これらは元からあった漏れであり移植の回帰ではない。このルールは copilot の指示にも書き込んだ。
ライフサイクル管理。 最大のカテゴリはライフサイクル、解放、所有権、順序、競合に関するものだ。状態を Rust へ移すと、TypeScript 側にはネイティブテーブルにあるインスタンスを指す不透明なハンドルだけが残ることが多い。オブジェクト参照と違い、このハンドルはインスタンスより長く生きられる。ある hook がリクエストの途中で解放され、tool_use ブロックが孤立したまま会話が固まった。モデル API は対になる result を要求するからだ。ある shell が「宣言済み」と「起動済み」の間でキャンセルされ、孤立したプロセスが漏れてセッションがアクティブのままになった。ある sandbox スイッチは generation カウンタを更新したが、ネイティブ側の双子を更新しなかったため、shell が「reconfiguring」のまま止まった。
無視された機能。 移植が単純に落とした機能もある。ある移植では SDK コールバックが省略され、対応するエンドツーエンドテストも削除された。そこで「agent は明示的な同意なしに E2E テストを変更してはならない」というルールを追加した。あるセッション中止はネイティブ側の半分を残したが、ツール内で待機している turn を中断するのに必要なプロセス内キャンセルを落とした。SDK が組み込みのツール検索を置き換える能力は 3 つに依存している。有効化スイッチ、モデル向けの説明と schema、そして実行を SDK コールバックへルーティングすること。移植はこの 3 つをすべて失い(一貫性ばんざい?)、ある利用箇所の自然言語検索を黙って正規表現検索に置き換えてしまった。
ライブラリが違えば気性も違う。 多くの回帰は、JavaScript のライブラリや API をより厳格な Rust の等価物に置き換えたことから生じた。当時、Rust の MCP SDK(rmcp)は不正な形式の JSON-RPC 入力に応答を返していたが、TypeScript SDK は返さなかった。エラーに対してさらに不正な形式の出力で応答するサーバーを相手にすると、この礼儀正しさは無限ループに変わり、起動処理が固まった。異なるエコシステムの同じようなライブラリは、挙動が完全に一致することはほとんどない。
夜にすれ違う船。 ブランチのドリフトや rebase に起因する回帰もあった。週に数百の pull request が飛び交うリポジトリでは、何日も開かれたままのセッションに変更とコンフリクトが積み上がっていく。今回の移植には数千回の rebase が必要で、成功率がどれほど高くても失敗は必ず残る。
あとは鈍足な連中。 最後のカテゴリは機能的には問題ないが遅い。memoization、完全な非同期待機、上限付きのログストリーミングなど、元からあった効率化を失った回帰がある。別のものは Rust と TypeScript の境界に移植固有のオーバーヘッドを持ち込んだ。余分なシリアライズ、ロック、ポーリング、上限のないネイティブ並行処理、ネイティブとホストの間の往復だ。これらは後で最適化すればよい機会ではなく、ひとつひとつが移植による性能劣化である。ある読み取り専用スキャンは借用せず、260 MB のイベントログをディープコピーした。継続的なイベントトラフィックの下では、別の実装が要求された channel flush のごく一部しか完了せず、しかも V8 がヒープを使い果たすまでイベントごとに非同期ハンドルを保持し続けた。
数十件のリグレッションは多く聞こえる。だが、80万行を超えるコードを生成した移植作業においては、正直なところ、一桁多い問題に遭遇しなかったことをむしろ不思議に思い、そしてありがたく感じている。公開されている github/copilot-cli と github/copilot-sdk リポジトリの issue の推移を見れば、こうした問題が広く「実感」されているかどうかも、おおよそ判断できる。ここでは1月から8月に新規作成された issue のうち、bug ラベルが付いているもの、あるいはタイトルに「bug」「regression」「crash」「hang」「timeout」「broken」「incorrect」といったよくある障害を示す語が含まれるものを、品質関連として分類した。移植期間中および移植後と比べて、移植前の水準はほぼ変わっていない:
| リポジトリ | 1〜4月、書き換え前 | 5〜8月、書き換え期間中/後 |
|---|---|---|
| github/copilot-cli | 22.9% (454 / 1,982) | 23.7% (354 / 1,496) |
| github/copilot-sdk | 36.2% (190 / 525) | 32.3% (135 / 418) |
これは可用性の指標でもなければ、流出した不具合の正確な数でもない……リグレッションそのものと同様、1つの issue が何を表すか、その範囲がどれほどかには多くの変動要素がある。だが、これは有用なチェックになる。製品変更の量が驚異的であったにもかかわらず、製品向けの issue チャネルには、移行期間中に注目すべき品質問題の急増は見られなかった。
コンパイルが通れば正しい
以前、Rust の厳格なコンパイラが AI 生成コードに適しているという流行のミームに触れた。それに関連する別のミームもある——コードがコンパイルさえ通れば、それは正しい。そうではない。既知のリグレッションのリストが良い反論になる。コーパス内のリグレッションはすべて main にマージされている。つまり、そのすべてがコンパイルを通っている。コンパイラがこれらのバグ入りバージョンを受け入れたのは、コンパイラから見てどれも正当な Rust だったからだ。
コンパイラは、ある f64 が一貫して使われていることを証明できる。リポジトリ ID を整数としてシリアライズしなければならないことや、末尾に .0 が付いたタイムスタンプがリンクの反対側にあるすべての強く型付けされた SDK に拒否されることまでは、知りようがない。コンパイラは、目に見えるコード内の同期の取れていないデータ競合を防げるが、完璧に同期されたステートマシンが誤った状態をエンコードすることを止められない。キューはロックで保護されていても、2つの送信側がそれぞれ相手がキューを空にしてくれると勝手に思い込むことはありうる。イベントはスレッド間を安全に受け渡されても、誤った順序で到着しうる。同期 napi 関数はメモリ安全でも、Node のメインスレッドを1分間ブロックしうる。コンパイルは、定義上、存在しないものの発見もほぼできない。rebase がガードとそのテストを静かに削除したとき、あるいはプロセスランチャーがコンソールウィンドウのポップアップを抑制する Windows フラグを付け忘れたとき、コンパイラは何も言わない。毎回の読み取りで 250 MB のイベントログをクローンすることにも、同じく何の意見も持たない。コンパイラが検査するのは、書いたプログラムが内部的に自己整合しているかどうかだ。プログラム全体を書き終えたか、古い契約を保っているか、呼び出し順序が正しいか、ホストの書かれていない要件を満たしているか、あるいは許容できるコストで仕事を成し遂げているかは、検査できない。
これは決して Rust コンパイラを否定する理由にはならない。他の静的型付け言語と同様、コンパイラは一大類の機械的エラーを排除し、agent に極めて有用な内側のループを提供する。だが「コンパイルが通れば正しい」は、冗談としてだけ通用する。
性能、性能、また性能
では、その代わりに何を得たのか。この移植は意図的に挙動を変えないようにしており、アルゴリズムの再設計もバグ修正もしていない。実際、私は agent を最適化しやすい方向から繰り返し押し戻した。言語と挙動を同時に変えると、どちらが原因で壊れたのか判断しにくくなるからだ。とはいえ、この書き換えの重要な目標の一つが性能とスケーラビリティ(ほかに信頼性など)であったことは確かだ。なぜ Rust でランタイムを書き換えるのかと聞かれたときの私の答えは、おおよそこうだ。「最初から Rust に移行しようとしたわけではなく、Node.js と V8 から離れようとしたのだ。」この移行は実際に、我々の性能指標を大きく押し上げた。
私は C# SDK を通じて、移植前後のランタイムを複数シナリオでベンチマークした(TypeScript、Python、Go、C#、Java、Rust の SDK はすべて同じ転送アーキテクチャを通じて同じエンジンに接続する)。ベースラインは移植前の SDK と CLI のビルドで、TypeScript ランタイムを Node がホストし、stdio 経由でアクセスする。8月21日の結果は Rust ランタイムを使用し、プロセス外サーバーとしても、FFI 経由でプロセス内にロードしても動かした。これは出荷システムのエンドツーエンド比較であり、言語変更そのものの影響を切り出そうとしたものではない。同じ時期に他の変更も入っているので、これらの数字は割り引いて見る必要がある。
計時された各ラウンドは、ローカルで動く決定論的な chat completion サーバーに送られ、固定の小さなレスポンスを返す。言い換えれば、これらの数字はモデル推論とネットワーク遅延を意図的に排除している。測定しているのは我々が変更した部分だ。クライアントの起動、プロセスの立ち上げ、セッション作成、イベント処理、永続化、クリーンアップなどである。
| シナリオ | 5月12日 | 8月21日 プロセス外 | 8月21日 プロセス内 |
|---|---|---|---|
| クライアント、セッション、単一ターン対話 | 5.25 s | 1.33 s(4.0x) | 292 ms(18.0x) |
| 32ターンセッションの復元 | 5.64 s | 1.52 s(3.7x) | 264 ms(21.4x) |
| 10個の並行クライアントライフサイクル | 12.34 s | 4.18 s(3.0x) | 742 ms(16.6x) |
| 1,000個の単一ターンセッションライフサイクル | 132.52 s | 22.53 s(5.9x) | 20.93 s(6.3x) |
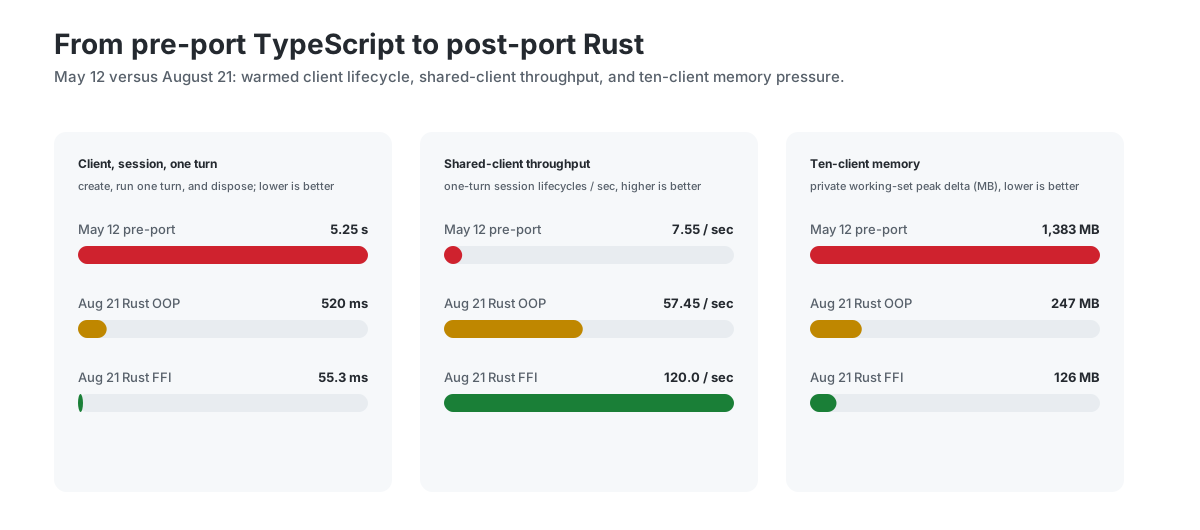
「クライアント、セッション、単一ラウンドの対話」は最も実感しやすい項目だ。やっているのは、クライアントを作成し、セッションを作成し、1 ラウンドの対話を最後まで実行し、そしてすべてを破棄する、という流れである。プロセス外のオーバーヘッドの大部分は、Node の起動、V8 の初期化、そして最初の対話が始まる前に TypeScript コードから生成された JavaScript アプリケーションを読み込んで解析し、バイトコードを生成するコストに由来する。Rust ランタイムはこうした Node/V8 と JavaScript の読み込みコストを丸ごと省いている。
「1,000 件の単一ラウンドセッションのライフサイクル」というストレステストは、我々が構築できるものの水準が一段上がったことを意味する。単一の共有クライアントを使い、100 本のパイプラインを並行実行して、各パイプラインがセッションを作成し、モデルとの対話を 1 ラウンド完了し、セッションを破棄する——これを 10 回連続で繰り返す。移植前の TypeScript CLI は、このライフサイクルを毎秒 7.55 件こなしていた。Rust のプロセス外は 57.45。Rust のインプロセスは 120.0 である。
これは特定の負荷における結果であり、Rust ランタイムが一般に「15.9 倍速い」という話ではない。だが、これはまさにサーバーホスティング事業者が気にする負荷だ。複数の独立したセッションが 1 つのランタイムを共有する。しかも、実時間が別のコアに仕事を隠しているわけではない。同じ 100×10 の負荷に対して別途リソースをサンプリングしたところ、移植前のプロセスツリーは累計 312 秒の CPU 時間を消費していた。Rust の各構成はおよそ 110 秒である。浮いたこの CPU 分を、ホスティング側はより多くのセッションに回せる。
メモリも同じ話をしている。ただし、いつもどおりの注意書きが要る。メモリの指標はとりわけ誤用されやすい。10 クライアントのバッチ処理中に増加した常駐プライベートメモリを見ると、移植前のプロセスツリーのピークはベースラインより 1,383 MB 高かった。Rust のプロセス外構成のピークは 247 MB にとどまる。Rust のインプロセス構成は 126 MB で、桁が 1 つ違う。これらの数値は用途やマシンによって当然変わるが、指し示しているのは核心的な目標だ。同じマシン上で、メモリ、プロセス数、CPU のいずれも先にボトルネックになることなく、これまでよりはるかに多くのクライアントとセッションをさばける。
何より、これはまだベースラインの移植にすぎない。実装の大部分は、Rust で忠実に再現した TypeScript 流のアルゴリズムのままだ。新しい所有権モデル、並行モデル、インプロセスアーキテクチャが可能にする大規模な再設計には、まだ手をつけていない。最適化作業を始める前の時点で、インプロセスのクライアントは作成から 1 ラウンドの完全なセッション、破棄までが約 55 ミリ秒、共有クライアントは毎秒 120 件の単一ラウンドセッションのライフサイクルを達成し、実測で 10 クライアントのメモリ増加は 91% 減った。非常に良い出発点である。
移植の代償
では……これにいくらかかったのか?拍手をどうぞ……
移植作業全体のトークン消費は約 1,363 億。内訳は約 1,306 億のキャッシュ入力読み取りトークン、約 42 億のキャッシュ入力書き込みトークン、約 9 億の新規入力トークン、そして約 6 億の出力トークンである。これらのトークンの請求額はおよそ 12 万ドルだった。
もちろん、トークンが勝手に消費されるわけではない。これらの agent を導くために開発者が費やした時間も計算に入る。とはいえ、私はこのプロジェクトに全時間を投じていたわけではない。agent による開発は、どちらかといえば「さっさと投げて待つ」ものだ。プロンプトを投入し、コーディング agent に働かせ、ときどき様子を見て、必要なら方向を修正する。だがそれが終わるまでの間は別のことをする。つまり開発者は一度に 1 つのコーディングタスクをこなすのではなく、待ち時間を重ねて複数のことを同時に進められる。移植期間中、これらの Rust 移植 PR は、私が関わったすべてのリポジトリの PR 総数のおよそ 20% を占めていた。PR の比率がおおむね時間の比率に近いと粗く仮定すれば、今回の移植に専念したのはおよそ 3 週間分に相当する。
言い換えれば、今回の移植のおおよその請求額は、帰属分のトークン支出 12 万ドルに、開発者 1 人の 3 週間分の時間を加えたものだ。
とはいえ、エンドツーエンドの Rust 移行を完全に 1 人でやったわけではなく、チームの協力の成果である。@stevesandersonms は napi-oop(暫定的なプロセス外相互運用レイヤー)の設計と実装、および 6 つの SDK FFI 実装のうち 5 つを提供し、6 つ目は @edburns が提供した。@roji は SDK のパッケージングを実装し、Rust バイナリを正しく公開して使えるようにした。@caarlos0 は、問題になり始めていたビルド時間を緩和するため Rust コードを多数の小さな subcrate に分割する作業を手伝い、@criemen は CI とローカルビルドを高速化するためのリソースキャッシュの改善を手伝った。@devm33、@examon、@MRayermannMSFT、@dereklegenzoff らは数え切れない PR のレビューと承認を手伝った。そして copilot-agent-runtime リポジトリに貢献したすべての人は、足元で世界が激変する中で、支援と協力を惜しまなかった。
学んだこと
この経験から、今回の書き直しにとどまらず役立ついくつかの教訓が得られた。次に同じことをするときは、以下のことを持ち込むつもりだ。
-
ゴールは明確かつ完全に述べる必要がある。 初期の指示は曖昧すぎた。「XYZ コンポーネントを Rust に移植する」は、ホットパスだけ、あるいはロジックだけを対象とする意味に取られ、agent は I/O とオーケストレーションを繰り返しスコープ外として扱った。最終状態が 100% Rust コードベースでビルドされたネイティブバイナリだと明言してからは、たとえ望んでも TypeScript を実行する環境が残らないため、agent は自律的にそのゴールへ向かって進めるようになった。
-
エンドツーエンドテストは絶対に、疑いの余地なく重要だ。 1 つの例外を除き、欠落した機能に関するものを含め、ほとんどのリグレッションは E2E テストの不足が原因だった。この種の移植では、移植の正しさを検証するテストが必須であり、そのテスト自体を移植の過程で書き換えてしまえば oracle を失うことになる。当初の移植計画でもこの点は指摘されており、移植を始める前に E2E テストの状況を大幅に改善する必要があると書かれていた。実際に改善はしたが、十分ではなかった。もっと多くの E2E テストを移植前に追加し、意味のある振る舞いの大半がカバーされるよう徹底していれば、途中のリグレッションはもっと少なかったはずだと確信している。
-
oracle を agent から守る。 実装を変更する agent に、テストを弱めたり、スナップショットを更新したり、互換性のベースラインを引き上げたり、逃げ道用のラベルを貼ったりして、正しさの定義を黙って書き換えることを許してはならない。少なくとも監督なしでは許すべきではない。振る舞いの契約はできる限り独立させ、敏感なガードレールは別の所有権や承認の下に置き、失敗の仕方が異なるチェックを重ねて、1 つの誤りで大きなリグレッションがリリースされないようにする。
-
まず翻訳し、それから再設計する。 振る舞いと既存のアルゴリズムを保つことで、同時に動かす変数の数を抑えられる。古い実装と移行用の足場が消えてから、安定したベースラインに対して所有権、並行性、性能を再設計すればいい。何度かこの原則から外れた。落ち着きがなかったり、仲間に断りづらかったり、この状況は特別だと信じたかったりしたのが理由だが、振り返るとそのどれも後悔している。どれも、当初の路線を守るよりも多くのリグレッション、時間、token を費やす結果になった。
-
繰り返す失敗を将来の成功に変える。 AI agent は脱線する。脱線したら、そこから学ぶ。同じ失敗パターンが 2 度現れたら、それは常設の指示、再利用可能な skill、eval、保護されたベースライン、あるいは harness 自体に組み込むべきものだ。
-
agent が開発プロセスに入ると、開発者の内側のループは重要でなくなるどころか、むしろ重要になる。 開発者にとって内側のループとは日常そのものだ。コードを変え、ビルドし、テストし、繰り返す。この速度が日々の快適さを決める。ここでツールチェーンが遅いと、人は苛立つ。土台の作業は agent に任せているのだから、内側のループが遅くても構わないという意見もあるだろう。気持ちは分かるが、間違っている。逆だ。AI agent は考え、コードを書くのが極めて速いが、それでもビルドし、テストする。しかも、考える時間とコードを書く時間の割合が下がり、素早く検証する内側のループの割合が上がるほど、ビルドとテストに費やす時間の割合は実際には増える。だからこそ、早い段階で内側のループを最適化する時間を取るべきであり、しかも「複数のタスクを同時に並行して進める」前提で最適化する(たとえば複数の worktree で同時に複数のタスクを進める場合など)。この投資は、後できっと自分に感謝することになる。
次は何か?
うまくいった。5 月には純粋な TypeScript だった実行ランタイムが、8 月には純粋な Rust になった。しかもその過程を通じて実際のユーザーに届け続け、最後に一大切り替えをやるようなことはなかった。
AI agent に「コードベース全体を TypeScript から Rust に移植してくれ」と頼んだだけではない。業界全体がその方向に進んでいたとしても、今の私たちはそこにはほど遠い。実際に起きたのは、agent がまるごと 1 種類のプロジェクトを実行可能にしたということだ。稼働中のシステムをその場で書き直し、数十万行のプロダクション品質の Rust コードを main で生み出す。それをチームの支援を受けながら 1 人のエンジニアがやる。agent が登場する前なら、こんな提案は承認されなかっただろう。チームまるごとで 1、2 年かかり、そのチームが本来届けられたはずのあらゆる機能と競合し、負けていた(正直に言えば、負けるべきだった)。agent がコストを、このプロジェクトが実行可能になる水準まで押し下げた。
移植そのものは完了している。ランタイムのプロダクション実装は 100% Rust で、暫定的だった内部の TypeScript/N-API の継ぎ目は取り除かれた。とはいえ、やりたいことはまだたくさんある。ビルドシステムと開発者の内側のループを改善し続けること、翻訳されてきた構造を整理すること、Rust の所有権と並行性モデルを軸に再設計すること、さらなる性能向上を狙うこと。今回の移植は翻訳であり、それは意図的だった(prompt にもそう書いた)。振る舞いを 100% 一致させることを優先し、ついでにバグを直したり、コンポーネントをリファクタリングしたり、性能やスケーラビリティをさらに引き上げたりはしなかった(書き直しに自然に伴う分を超えては)。ミクロに見れば、コードの大半は idiomatic な Rust だ。だがマクロに見れば、もともと TypeScript で書かれたアルゴリズムのかなりの部分が、Rust の構文をまとっただけにとどまっている。今は土台の制約が変わったのだから、そうした判断を見直すことにこそ、本当に面白いリターンがある。
一番わくわくするのは、この移植が何を開いたかだ。SDK は 6 言語のいずれかのホストプロセスに直接ロードでき、依存チェーンに Node.js も V8 もなく、2 つ目のプロセスを監督する必要もない。これはパートナーが SDK を採用する際に最も多く挙げていた摩擦点だった。ランタイムインスタンスのコストは以前の何分の一かにすぎず、ホストはマシンのリソースを使い果たす前に、はるかに多くの同時セッションを走らせられる。そしてランタイムは、Node.js が永遠に追いつけない場所へ行けるようになった。クラウドからデスクトップ、デバイス、組み込みシステムまで。これらは終着点ではない。GitHub Copilot の未来を築くための土台だ。agent が自分たちのエンジンを書き直すのを 3 か月見てきた身としては、どこまで行けるのか見てみたい。
楽しいコーディングを!