Expo Modules 2.0 の新しい JNI レイヤー
Kolibri は Expo Modules 2.0 が Android で使う JNI ライブラリだ。安全ラッパーを任意にし、C++ ポインタをそのまま Kotlin に渡し、JS データは共有バイナリバッファ経由で流す。
もっと見る パフォーマンス
ホームKolibri は Expo Modules 2.0 が Android で使う JNI ライブラリだ。安全ラッパーを任意にし、C++ ポインタをそのまま Kotlin に渡し、JS データは共有バイナリバッファ経由で流す。
Software Mansion が、スタック選定の背景にある 5 つの問いと 3 つのアプローチを解説し、Gobi が React Native からネイティブの iOS / Android へ画面ごとに移行した理由を説明する。
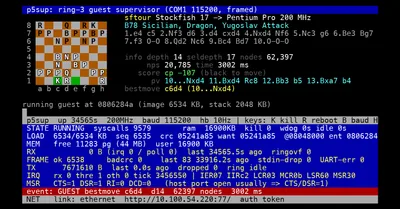
IBM は数百万ドルをかけてディープブルーを作り、1996 年に Kasparov を破った。30 年後、200 MHz の Pentium Pro で現代の Stockfish を動かすと、棋力は約 3300 Elo になり、ほぼ確実に勝てる。
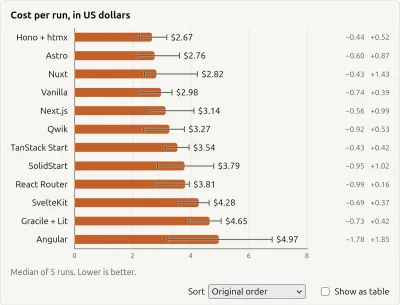
同じポケモンアプリを 12 のフレームワークでエージェントに 5 回ずつ書かせたところ、Hono+htmx が最も安く、Angular が最も高くついた。コード量は 7 割の差、Lighthouse のスコアはほぼ同じ。
Flamerix AI は自身の OpenTelemetry で、agent_summary が Claude Code の支出全体の 16.4% を占め、メインの会話より多いことを見つけた。30 秒ごとにエージェントの会話記録を丸ごと Opus に送り、3〜5 語の進捗を書かせる仕組みだ。80 行の Bun preload で止め、バージョンごとの検証結果も公開している。
Anthony Green が Common Lisp で書いた OpenLDK は、Java バイトコードを Lisp に変換して SBCL にコンパイルさせる。Java クラスは CLOS クラスになり、7 つの JVM 言語を 1 つの式に埋め込め、初期化済みの Spring Boot は 84 ミリ秒で起動する。
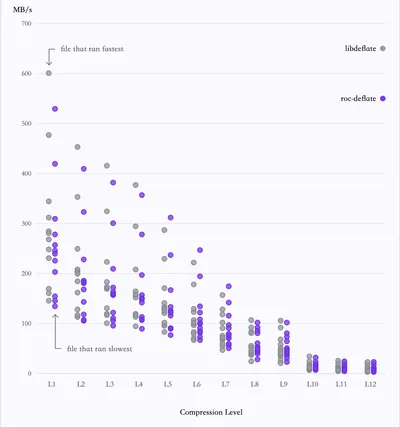
Roc で書いた DEFLATE パッケージが、Silesia コーパスの 144 項目で手作業チューニング済みの C に中央値で M1 MacBook Pro は 2.6%、Ryzen 3900X は 8.9% まで迫った。
遅いプログラムを Rust や C で書き直しても、たいてい速くはならない。Sean Goedecke は、ほとんどの高速化はプログラムのやることを設計し直すことから来るのであって、言語の速さから来るのではないと論じる。
Rust はガベージコレクションを不要にするために生まれた言語だが、Clayton Ramsey はそれでも循環参照を回収する並行ガベージコレクタを書いた。Drop、ビジター trait、収集タグで実装し、見つけられる限りの Rust コレクタとベンチマークで比べている。
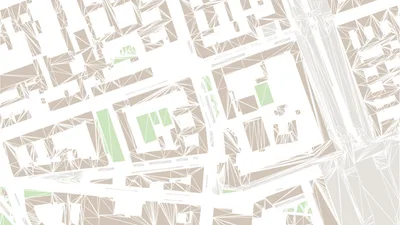
earstrip は耳切り法でエンジンの制約付き Delaunay 三角分割を置き換え、ワルシャワ周辺の 374 万ポリゴンの処理を 2.93 秒から 489 ミリ秒に縮めた。着想ごとに 1 コミットずつ作り直し、各節の末尾にその変更で何ミリ秒減ったかを示している。
Mark Bartlett は esp32-ai の TinyStories モデルを再現し、律速は PSRAM の帯域で CPU は余っていたと特定した。出力を変えない 5 つの変更で 1 トークンあたり 94.7 ms を 43.3 ms に短縮した。
tsrs は 4 つの実プロジェクトで TypeScript 7.0 より 3.8〜8.1 倍速く、ピークメモリは 2 割ほど。フォークせず、TypeScript チームの判断に追従しながら Vinext と同じエージェント運用で上流と同期する。
短いビット演算の式を総当たりで探索し、浮動小数点数の最下位セットビットを分岐なしで取り出す書き方と、部分式の再利用で1演算減らす書き換えを見つけた。
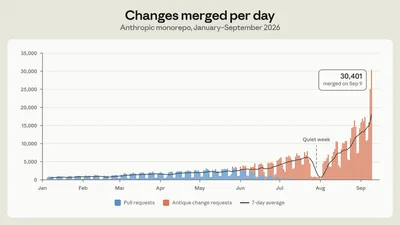
Anthropic の 1 日あたりのマージ回数が 10 倍以上に増えたため、チームは 5 か月で git ベースの構成を自社開発のバージョン管理システム Scion に置き換え、どの操作がどれだけ速くなったかを数字で示した。
C 言語の小さな arena アロケータを解説する。解決するライフサイクル問題から、動く実装の構造体、アラインメント、realloc の経路まで。
Postgres 19 は TOAST 圧縮を pglz から LZ4 に切り替える。LZ4 はより高速だが、常に小さくなるわけではなく、使用すると一部の読み取りが遅くなる。
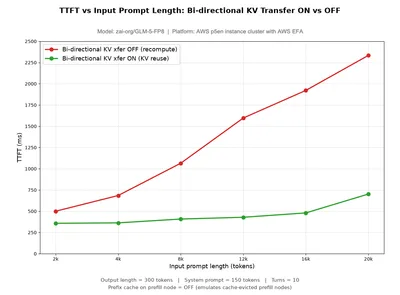
双方向 KV 転送により、vLLM の prefill ノードは後続の会話ターンで decode ノードが以前に計算した KV を再利用でき、冗長な prefill 再計算を削減して、長いマルチターンプロンプトで TTFT を最大 3.3 倍下げる。
読み取り中心のワークロードではRwLockはロックフリーのアトミック操作に敗れた。記事は2つのバージョンを構築し、ベンチマークを行い、そのコストがロック自体よりも同期がどこでどれだけ頻繁に発生するかにある理由を説明する。
小さなレジスタアロケータを、ライブインターバルと衝突から固定レジスタとスピルまで段階的に解説する。この設計はスループットよりも明快さを重視しており、ライブラリとしてではなくレシピとして読むことを意図している。
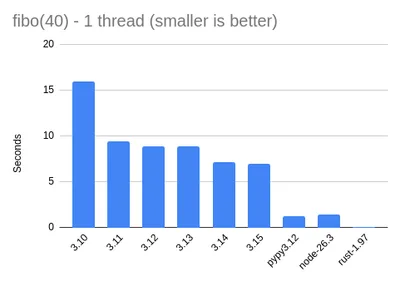
Miguel GrinbergがPython 3.15上でさまざまなワークロードとハードウェアに対してベンチマークスイートを再実行し、インタプリタがどこで速くなり、どこで速くならなかったかを報告。グラフはシングルスレッドとマルチスレッドのテストを並べて示している。
strands-deciderの公開後、Marc Brookerはなぜこのモデルがエンコーダではなくデコーダを使うのかと問われた。5つの設計を比較し、この分類タスクではデコーダが遜色なく、ある条件下では勝ることを見出した。
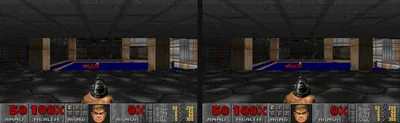
CedarDB の SQL クエリで Doom のゲームロジックとレンダラーを実装し、デスマッチも実現した。記事では全体アーキテクチャ、ゲームループ、SQL における BSP 走査、そしてデータベースの実行モデルがどの点で非常にうまく適合するかを解説する。
Futhark は通常、配列プログラムを GPU カーネルにコンパイルするが、一部のワークロードは多くの CPU コアで回した方が速い。本記事はスパースなヤコビ行列の計算を例に、ターゲットが GPU ではなく CPU になったときコンパイラのどこを変える必要があるかを追う。
Go 1.27で可搬性のあるsimdパッケージが登場し、simd.Uint8sなどの型でAVX512、NEON、wasmのベクトル差異を隠蔽する。