2026年におけるRustでのSIMDの現状
恐れ知らずのSIMDメンテナーが書いた年次SIMDライブラリ調査。std::simd、wide、pulp、maceratorを比較し、x86命令セット互換の難題を詳解。
もっと見る パフォーマンス
ホーム恐れ知らずのSIMDメンテナーが書いた年次SIMDライブラリ調査。std::simd、wide、pulp、maceratorを比較し、x86命令セット互換の難題を詳解。
x86-64 と aarch64 のどちらを選ぶかは、Postgres がファイルをどう読むかで決まる。記事は両者の違いと、新しいアプリでどちらを選ぶべきかを整理する。
bfcacheMetricsIntegration は 3 つの bfcache 指標を Sentry に送る。記事は計測の仕組みと、どの数字を見れば戻る・進むのキャッシュが効いていると分かるかを説明する。
agentic な LLM に Rust コードを反復最適化させると、既存の最先端ライブラリより 2〜20 倍速くなった。PyO3 でその利得を Python 側に還元する。
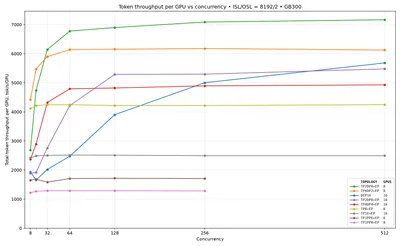
GB300 NVL72 上で Qwen3.8-2.4T を PD 分離でサービングした結果。高スループット側では GPU あたり毎秒 5,000 トークン、低遅延側ではユーザーあたり 180 トークンに達し、両端が同じパレート前沿に乗る。
Postgres の全文検索をインデックス構造から解説。GIN インデックスが語を行にどう対応させるか、`LIKE '%x'` がインデックスを使えない理由、trigram インデックスの曖昧一致のコストまで。
vLLM が PyNvVideoCodec ハードウェアデコードを統合し、動画記述のスループットは 8 GPU ノードでも線形にスケールします。
Redis 8.10 がリリース、コンパクトハッシュでメモリ使用量を最大50%削減、ロードスループットが倍増、さらに増分バックアップ復元、より完全な JSONPath クエリ、Streams と Time Series のいくつかの新コマンドを提供。
コーディングエージェントがモバイルアプリの構築コストを二度下げ、ShopifyはReact NativeからSwiftとKotlinに戻った。著者は核心的な前提を変えたもの、そしてこの移行の代償と収穫を説明する。
Spark の Real-Time Mode が連続計算を担い、Redis がミリ秒単位の読み取りを担う。この役割分担により、パーソナライズ推薦と不正スコアリングをリクエストパス内に収めている。記事には実行可能なサンプルリポジトリも付属。
Google Research の Retrieve-for-Train は、軽量な拡散モデルを強化学習で一度だけ訓練し、 推論時の思考予算を迂回して一貫した fan-out 検索結果を 1 回の順伝播で生成する。
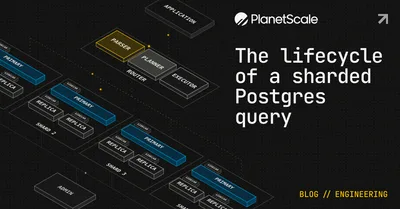
Postgresが千台のサーバーにシャーディングされた後、1つのSELECTが認証、wire protocol、分散クエリプランナーをどう通過するか、NekiルーターはGoでSCRAM-SHA-256を再実装しSimpleとExtendedの両プロトコルをサポート。
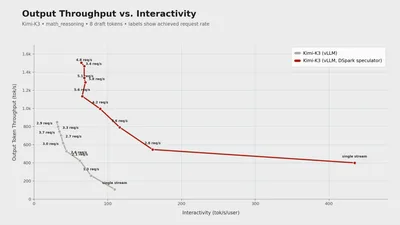
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。
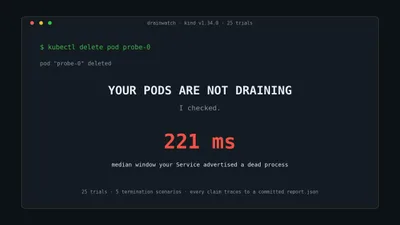
drainwatch が25回の実測でKubernetesのグレースフルシャットダウンを分解、即座に終了するPodは45ミリ秒以内にRSTでTCPを切断されるが、Serviceは死んだプロセスを221ミリ秒間外部に通知し続ける。
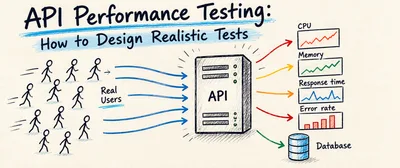
性能テストは、インターフェースにやたらと大量のリクエストを送ることではない。著者はまず、負荷、ストレス、耐久、スパイク、キャパシティ、スケーラビリティの6種類のテストがそれぞれ何に答えるのかを説明し、次に現実に即したシナリオをどう設計するかに重点を置いて、ユーザーパスから業務量をもとにRPSを逆算するアルゴリズム、外部サービスをモックするかどうか、環境とデータベースをどう構成すべきかに至るまで解説している。
PlanetScaleがPostgres全文検索拡張TINをリリース、48ビットのctidをそのままpostingのネイティブ形式として使用し、85 GB・1億5000万文書のベンチマークでスループットがParadeDB、pg_textsearch、組み込みGINより少なくとも8倍高く、インデックス作成は8分10秒。
同じ 8 コア・3D V-Cache の Ryzen 7 が 2 年で Geekbench 6 のシングルコア +47%、全コア +58%。最大クロックの伸びは 15% にすぎない。トランジスタ +50%、ディスパッチ幅 6→8、リオーダーバッファ 256→448、SIMD は 256→512 ビットへ。
Reanimated 4 安定版がリリース、CSS 互換の宣言的アニメーション API を追加し、一部の worklet シーンを置き換え可能。
Discord がアプリを React Native の新アーキテクチャへ移行し、Fabric、Reanimated、Screens などの課題を解決した方法をご紹介します。
エージェントが登場する前は、この規模の書き換えは手が出なかった。Copilotエージェントランタイムを80万行の本番Rustコードに移植するのに実際にかかったコストを以下に示す。
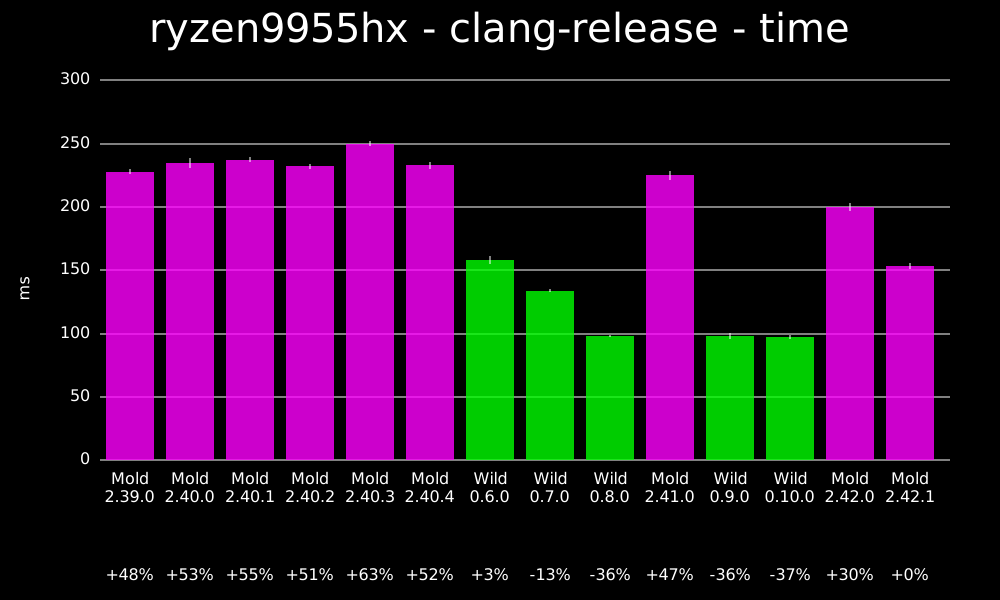
Moldが最近リンカベンチマークを更新し、初めてWildを対象に含めた。このベンチマークではWildはMoldよりかなり遅く、8月4日の前回リリース時にWildが最新で公表したベンチマーク結果とは逆である。
Go 1.27 で 80 バイト以下の割り当てがより高速なメモリ割り当てに。こうした割り当ては最大 20~30% 高速になり、割り当ての多いプログラムは最大 1% 高速に。Go ランタイムは特定サイズの割り当てに特化した関数を導入することで、これらの割り当ての性能を向上させた。
Cloudflare のグローバルネットワークは巨大だが、限界がないわけではない。リソース使用量を削る小さな手立てを探す中で、大きく削れる場面に巡り合うこともある。この記事は、Pingora ベースのあるサービスのメモリ使用量をどう下げたか、そしてなぜそれが簡単ではないのかを扱う。
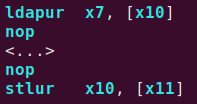
ARM の弱い順序付けメモリモデル上で x86-TSO をエミュレートするのは、エミュレータに長くある落とし穴だ。全ストア順序付けを自前で補って初めて正しくなるが、代償は大量のメモリバリアで、性能と正確性の両立が難しい。記事は問題の根源と、手法ごとのトレードオフを整理する。