推論のボトルネックを回避:Retrieve-for-Train で複雑な AI 検索を高速化
Google Research の Retrieve-for-Train は、軽量な拡散モデルを強化学習で一度だけ訓練し、 推論時の思考予算を迂回して一貫した fan-out 検索結果を 1 回の順伝播で生成する。
日本語
コピー
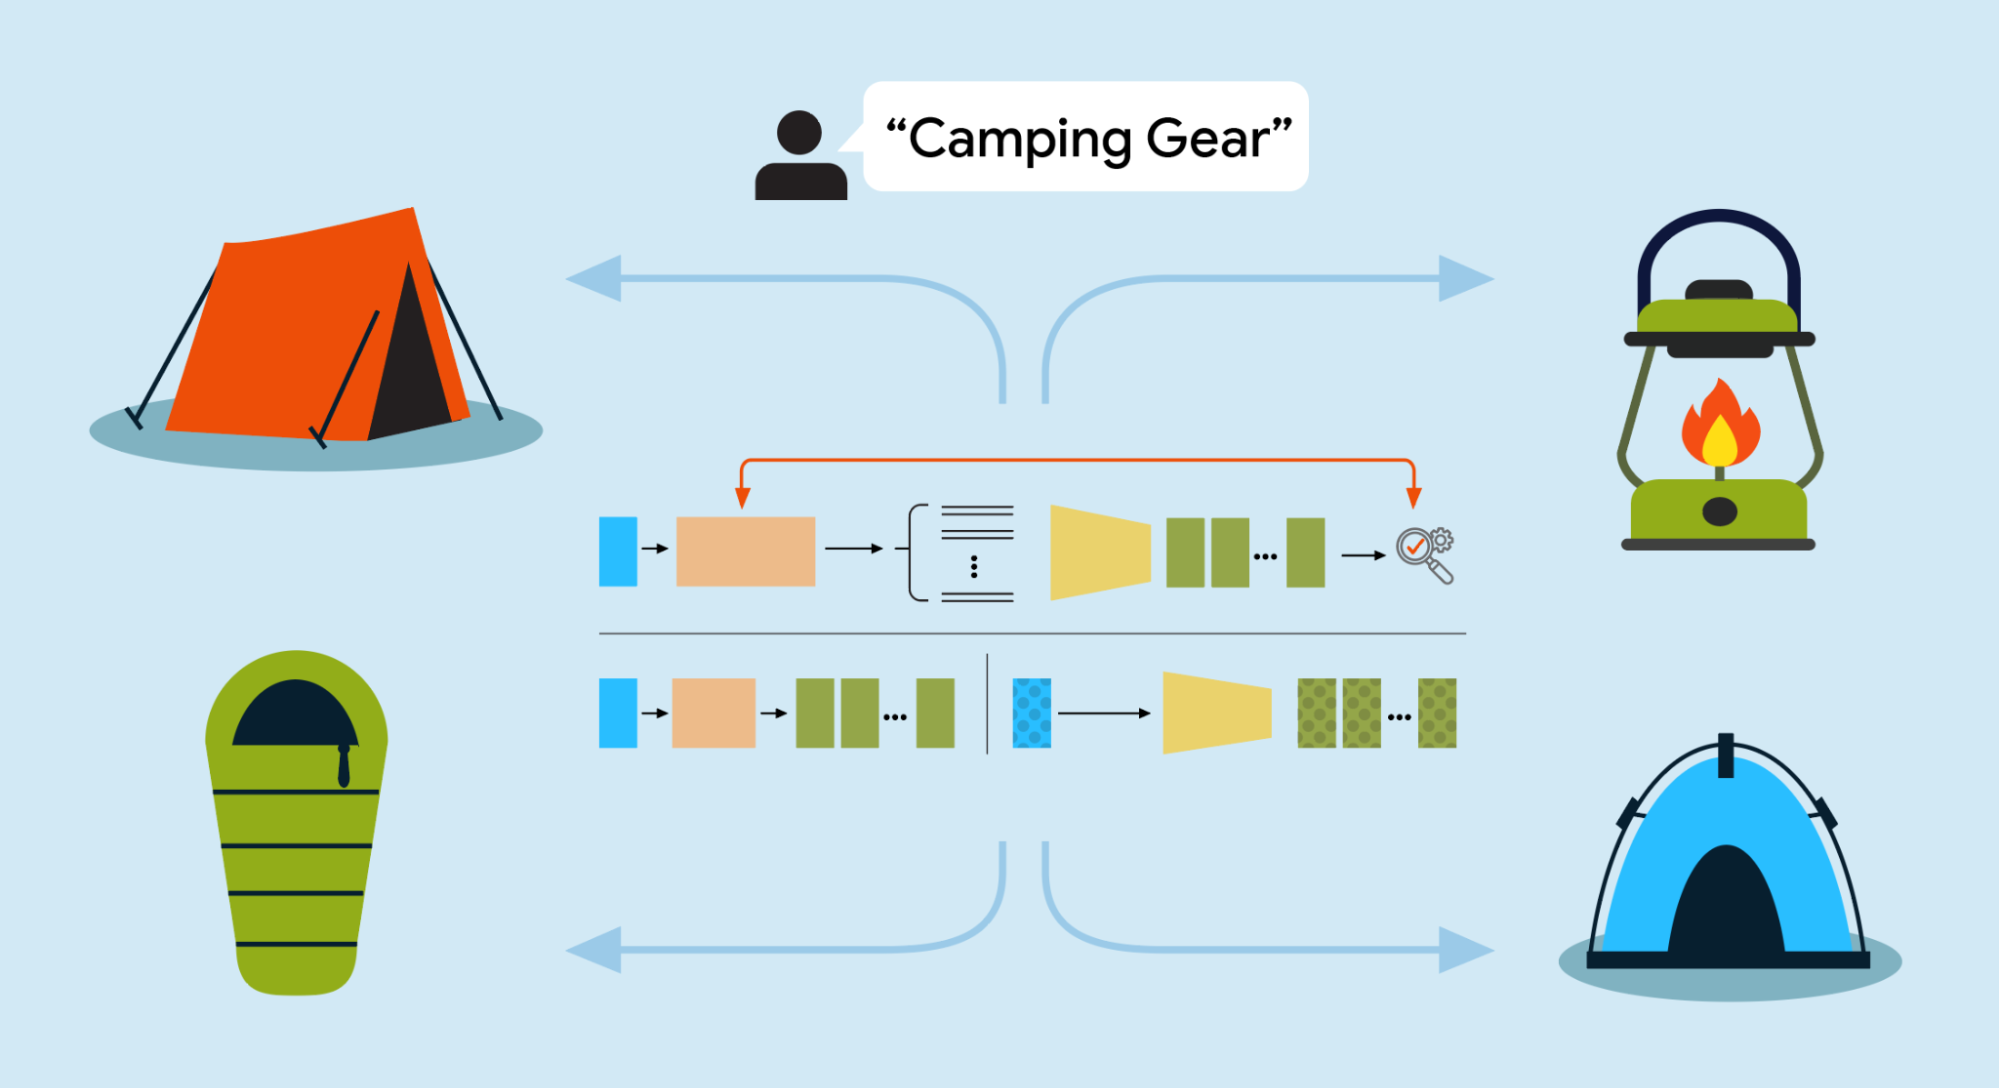
Retrieve-for-Train フレームワークは、コストの高い推論時の推論に頼る代わりに、強化学習で軽量な拡散モデルを一度訓練する。こうして重い自己回帰的な「思考予算」を迂回し、一貫性のある専門家レベルの AI 検索結果を直接生成する。
クイックリンク
今日の検索やレコメンドのアプリケーションには、単一の最良の一致ではなく、互いに調和した結果の集合を返すことがますます期待されている。たとえばユーザーが「キャンプ用品」と検索するとき、求めているのは似たり寄ったりの4人用テント10張ではなく、テント、寝袋、ポータブルストーブ、ヘッドランプなどの必須装備を網羅した、補い合う調和の取れたリストだ。そのためにシステムは query fan-out 技術を使い、広いプロンプトをいくつかの関連するサブクエリに分解して、ユーザーが関心を持ちうる方向をカバーする。しかし、LLM がデータベースを意識した query decomposition を動的に行うには、膨大な思考予算を消費する。設計上、zero-shot LLM は汎用の自己回帰テキスト予測器にすぎず、対象コーパス固有の幾何学的多様体上をナビゲートするよう最適化されているわけではない。そのため、多様性、カバレッジ、相補性、調和性といった集合レベルの高次の属性を最適化しつつ、固定されたデータベースに grounding された結果の集合を返すには、テスト時の追加計算が必要になる。ICML 2026 の論文「Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion」で、私たちはこの分解のボトルネックを報酬からデータへのコンパイルフレームワークによって解決した。Retrieve-for-Train フレームワークは、推論時にモデルへ大量の思考予算を強いるのではなく、オフライン強化学習(RL)で報酬に整合した fan-out を発見し、それを教師信号へコンパイルする。この最適化された探索行動を軽量な拡散検索器に蒸留することで、推論時には単一のフォワードパスで query fan-out を効率よく完了でき、テスト時の思考トークンのオーバーヘッドなしに、数学的に定式化された集合レベルの属性を実現できる。
なぜ汎用 AI は検索の専門家ではないのか
複雑な検索語の集合をブレインストーミングするタスクでは、推論段階で既成の標準的な LLM をそのまま呼び出せば済むとつい考えたくなる。しかし、データベースを意識したクエリ分解を汎用モデルに任せると、2つの重大な問題が生じる。
-
言い換えの崩壊: データベースを意識した最適化がなければ、ゼロショット LLM はしばしば言い換えの崩壊を起こす。あるテーマの下で補い合うさまざまな側面を探索しようとはせず、冗長でほぼ同義のクエリを生成しがちだ。たとえば「ボヘミアン・フェスティバル風」という広いプロンプトに対して、プロンプトを丁寧に設計していない標準的な LLM は「ボヘミアン・フェスティバル・ファッション」「ボヘミアン・フェスティバル・ウェア」といった手抜きの出力をしかねない。こうした意味上の堂々巡りは同質な結果の山を生むだけで、ファッションの専門家なら見分けられる独特で価値のある意味の方向——フリンジジャケット、かぎ針編みのドレス、スエードブーツなど——を完全に取り逃す。
-
自己回帰のレイテンシーボトルネック: 標準的な LLM は本質的に逐次的な自己回帰生成に縛られている。複雑なクエリを補い合う側面へと分解するには、現代のモデルは通常かなりの思考予算を必要とし、実際の検索語を出力する前に、拡張の方向を計画するための中間的な思考の連鎖(CoT)推論トークン(AI モデルが複雑な問題に答える前に生成する中間ステップ、つまり内部処理の単位)を数百個生成する。この熟考は対話型 AI なら許容できるが、集合型の検索(たとえば先のフリンジジャケットやかぎ針編みのドレスなど、補い合う結果の集合を検索する場合)にとっては深刻な構造的ボトルネックになる。多数のサブクエリを同時にブレインストーミングしなければならないとき、コンテキストを処理し続けながら大量の推論トークンを生成する重畳的なオーバーヘッドは、スケールしない。高度な serving 最適化があっても、このトークン単位のアーキテクチャはレイテンシーの下限を作り出し、本番環境の検索ボックスが求めるサブ秒の応答時間と根本的に衝突する。
Retrieve-for-Train フレームワーク
Retrieve-for-Train は、AI の訓練を、ユーザーが画面の前に座って待ち、その場で試験を受けなければならない場面ではなく、オフラインの演習として扱う。クエリを受け取るたびに検索の法則をゆっくり手探りし、大量の計算予算を燃やすのではなく、まずオフライン RL 訓練を一度走らせる。この訓練は厳格な報酬の仕組みによって、「結果は多様で、しかも本当に中身がある」といった抽象的な目標を、一歩一歩まで正確に記した操作マニュアルへと変える。マニュアルができあがれば、AI は実際の検索でそれをそのまま実行でき、レイテンシーは生じない。パイプライン全体は3つのステップに分かれる。
- Fan-out 言語モデルの訓練: RL で fan-out 言語モデルを訓練し、属性に整合したサブクエリを出力させる。集合レベルの属性検証報酬が採点する。この報酬は個々の結果を個別に採点するのではなく、結果の集合全体を評価する。
- 教師データの合成: 凍結した fan-out 言語モデルが(クエリ → 目標集合)のペアを完全にオフラインで合成し、教師あり学習に使う。人手によるアノテーションは一切不要。
- 拡散検索器の訓練: コンパクトな 53.9M パラメータの拡散モデルが、クエリ埋め込みを1回の非自己回帰フォワードパスで目標埋め込みの集合全体へ直接マッピングすることを学び、テキストベースの CoT 推論トークンを仕組みとして迂回する。
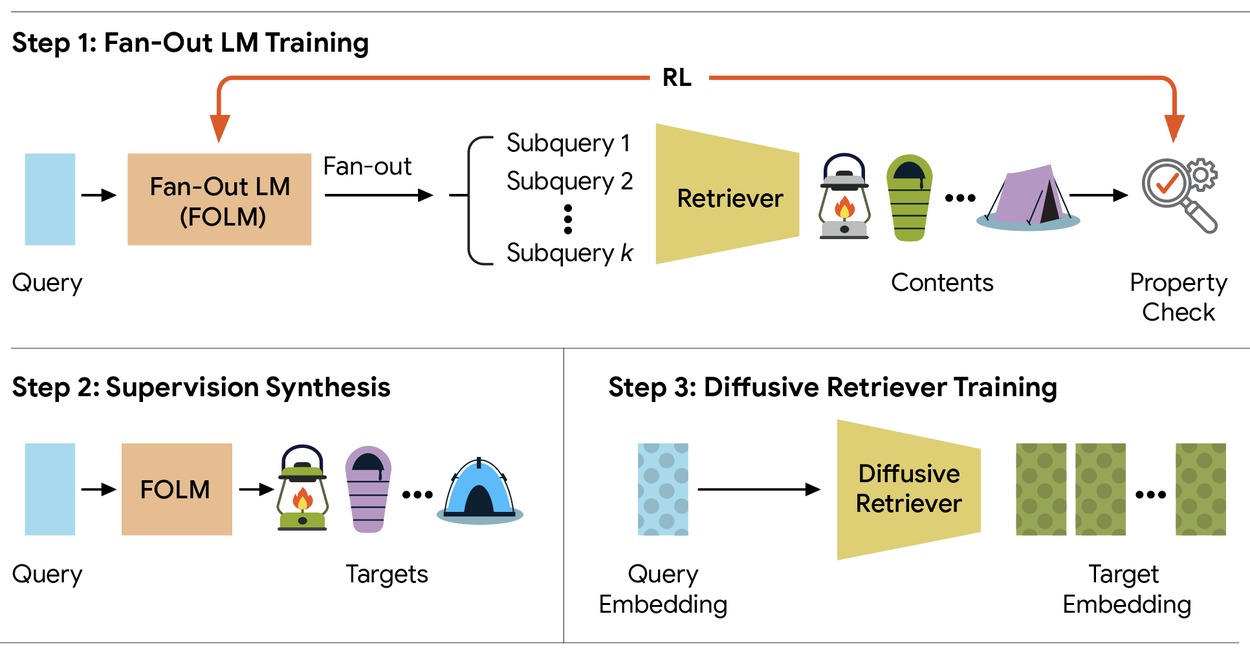
Retrieve-for-Train フレームワークの全体像。 ステップ1: RL で fan-out 言語モデル(FOLM)を訓練し、属性に沿ったサブクエリを生成する。 ステップ2: 訓練済み FOLM で教師データを合成する。 ステップ3: 拡散ベースの fan-out 検索器を訓練し、クエリ埋め込みから直接コンテンツ埋め込みをサンプリングする。
集合志向の設計:複合報酬の力
Retrieve-for-Train が成立するかどうかは、「よい」検索行動をどう定義するかにかかっている。従来の教師あり訓練は learning to rank による逐点関連度評価で、検索結果を1件ずつ採点する。しかし、真に優れた検索リストの性質は集合レベルにあり、個々の項目には分解できない。1件だけでは多様性も相補性も測りようがなく、検索結果全体をまとめて評価して初めて、これらの性質は数学的に存在するものになる。
Retrieve-for-Train は、こうした fan-out の性質を強制するのに曖昧な自然言語の指示に頼らず、厳密な数学的複合報酬を1つ用意し、強化学習で 4B のオープンソース言語モデル(Gemma3-4B と Qwen3-4B)をファインチューニングする。オープンエンドな要約検索タスクにおけるこの複合報酬は、互いに牽制し合う3本の柱の重み付きバランスだ。
- 根拠性(Groundedness): データベース多様体からの距離にペナルティを与え、生成された各サブクエリがデータベース内に実在する検索可能な項目に対応することを保証する。
- 多様性(Diversity): Vendi Score でサブクエリ集合全体を測り、モデルに広い意味的広がりを探索させる。
- 整合性(Alignment): 候補サブクエリを元の広いプロンプトに固定し、意味的ドリフトを防ぐ。
互いの逆方向アンカーと soft-GRPO 訓練
訓練では group relative policy optimization(GRPO)と soft proximal policy optimization(PPO)を組み合わせ、fan-out 言語モデルをこうした幾何学的な現実に最適化させる。
この3つの報酬はどれも欠かせない。互いに逆方向のアンカーとして働くからだ。根拠性だけを最適化すると、モデルは報酬の抜け穴を突き、退化した無意味な文字列を生成する——数学的にたまたまデータベース上の座標に写るというだけで。では整合性を足して無意味な出力を正せば、今度は方策が直接カンニングし、ユーザープロンプトを言い換えるだけに退化する。
逆方向アンカーとして Vendi Score を導入したことで、Retrieve-for-Train はこれらの近道を実質的に塞いだ。高い報酬に到達するには、方策は埋め込み空間の均衡した領域へ入らざるを得ず、そこでは元の意図の正当で厳密に根拠づけられ、かつ意味的に互いに異なる変種を見つけなければならない。
実験
Retrieve-for-Train フレームワークを評価するため、凍結したデータセット固有のマルチモーダル埋め込みバックボーンと、クエリ拡張に最適化したオープンソース言語モデルを組み合わせた。この方式を、集合値をとる検索の2つの異なる設定で評価している。
- オープンエンドな抽象的検索: 唯一の正解が存在せず、品質は多様性、クエリとの整合性、データベースへの根拠づけといった集合レベルの性質だけで測られる。
- 弱教師あり組合せ検索: クエリに弱い参照集合が付くが、それはクエリ意図の実現例の1つにすぎない。
マルチモーダル埋め込みバックボーンについては、2つの領域で実験した。テキストから画像への実験には、ユーザーがコーディネートした服で構成される大規模ファッションデータセット(CLIP ベースの検索器で評価)。テキストから音楽への評価には、専門家が作成した音楽プレイリストからなるプロプライエタリな産業データセット(MuLan で評価)。言語モデルについては、クエリのファンアウトを 4B のオープンソースモデル、具体的には Gemma3-4B と Qwen3-4B が担い、主検索プロンプト1件につきちょうど10件のサブクエリを生成する。これらの fan-out モデルの RL 訓練は Soft-GRPO で行い、これはグループ相対方策最適化にソフト PPO 正則化を加えたものだ。
結果
検索品質と精度
2つの検索タスクで、Retrieve-for-Train は従来の単一クエリ検索、ゼロショット拡張、そして入念に最適化された Best-of-N ベースラインさえも上回った。定性的に見ると、ゼロショット LLM ベースラインはほぼ同義の言い換え(たとえば "bohemian festival style" と "bohemian festival fashion")を生成しがちで、結果が冗長になる。Retrieve-for-Train が生成するサブクエリは高度に多様で互いに区別され(たとえば "boots" や "lace" に分岐する)、同時にデータベース多様体の内側に厳密に根拠づけられている。
推論速度が桁違いに向上
RLでチューニングした言語モデルをそのままデプロイすれば、検索品質は確かに優れている。だが、自己回帰アーキテクチャ固有のレイテンシ制約を引き継ぎ、思考計算の予算も大きく必要とする。そこで、学習した振る舞いを53.9MパラメータのRetrieve-for-Train拡散モデルに蒸留し、レイテンシのボトルネックを解消した。拡散モデルは連続埋め込み空間で目標方向を一括並列生成するため自己回帰が不要で、自己回帰方式より12〜20倍速い。規模が大きくなると、自己回帰のfan-outレイテンシは大コンテキストのバッチで線形に膨張し50秒近くに達するが、Retrieve-for-Train-Diffusionは常にサブ秒から数秒に収まり、ごくわずかな計算コストで本番投入可能な専門家レベルの検索を提供する。
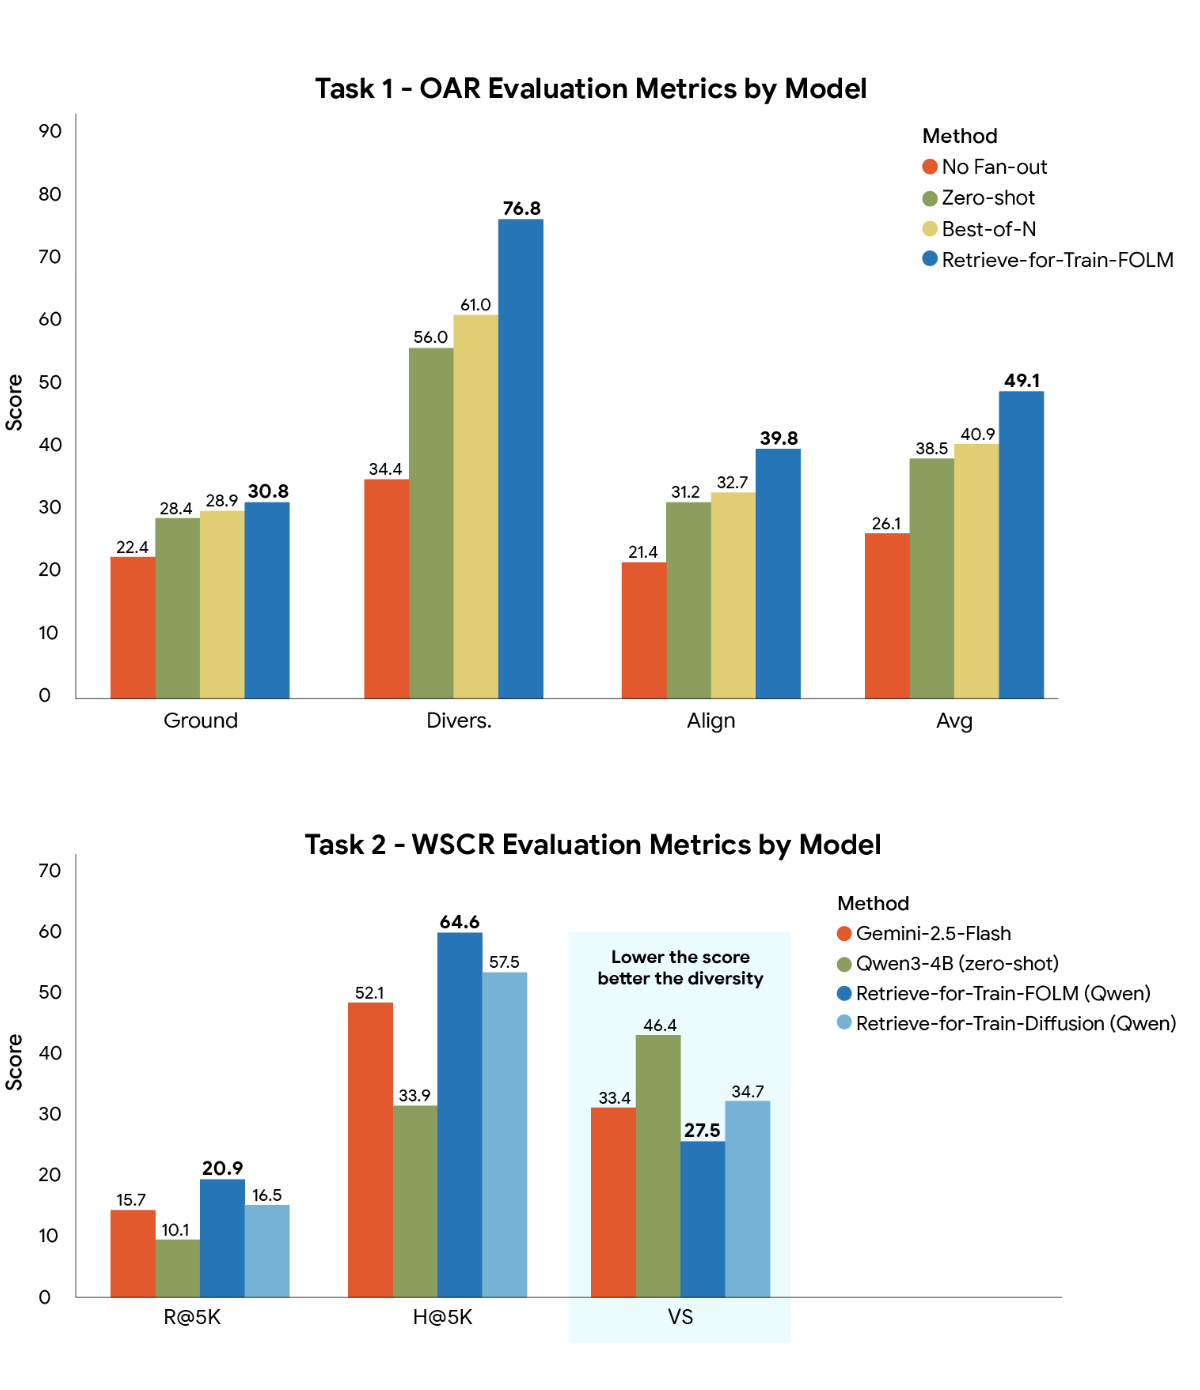
オープンエンド要約検索(OAR)と弱教師あり構成検索(WSCR)の2タスクで、Retrieve-for-Trainフレームワーク(FOLMとDiffusion)は標準検索およびゼロショットベースラインを一貫して上回り、多様性・アラインメント・再現率のいずれも大幅に改善した。
チート防止アンカー(アブレーション実験で判明したこと)
報酬最適化の過程で、検索用fan-out言語モデルの訓練に関する根本的な事実が一つ見つかった。多様性項を入れないと、モデルは即座に無意味な文字列(例:"line ending line ending")を生成する方向へ退化し、データベースのベクトル座標の隙を数学的に突くようになる。幾何学的多様性指標(Vendi Score)の導入は、重要な逆方向のアンカーとして働き、モデルを埋め込み空間の安定した領域へと追い込む。そこでは、検索の専門家のように振る舞って初めて報酬を最大化できる。
結論
RLをオンライン推論エンジンではなく、一度きりの「目標変換器」として使うと極めて高い効率が引き出せることを示した。報酬駆動の振る舞い探索にかかる重い計算を、最終的にデプロイするモデルから切り離すことで、私たちのフレームワークはオンラインLLMデプロイに典型的な推論レイテンシと計算オーバーヘッドを回避している。こうした複雑な集合レベルの振る舞いを軽量なdiffusion priorに蒸留することで、本番グレードの検索システムが多様性やアラインメントといったより高次の属性を効果的に最適化できるようになる。最終的にRetrieve-for-Trainは、専門領域やマルチモーダル領域における集合検索のために、高いスケーラビリティとデータ効率を備えたパイプラインを確立する。そうした領域では、人手で注釈を付け属性を揃えた訓練ペアが乏しいか、入手コストが高い。詳細は論文を参照。