绕过推理瓶颈:用 Retrieve-for-Train 加速复杂 AI 搜索
Google Research 提出 Retrieve-for-Train,用强化学习训练轻量级扩散模型,绕过推理期思考预算,单次前向即可生成连贯的 fan-out 搜索结果。
中文
复制
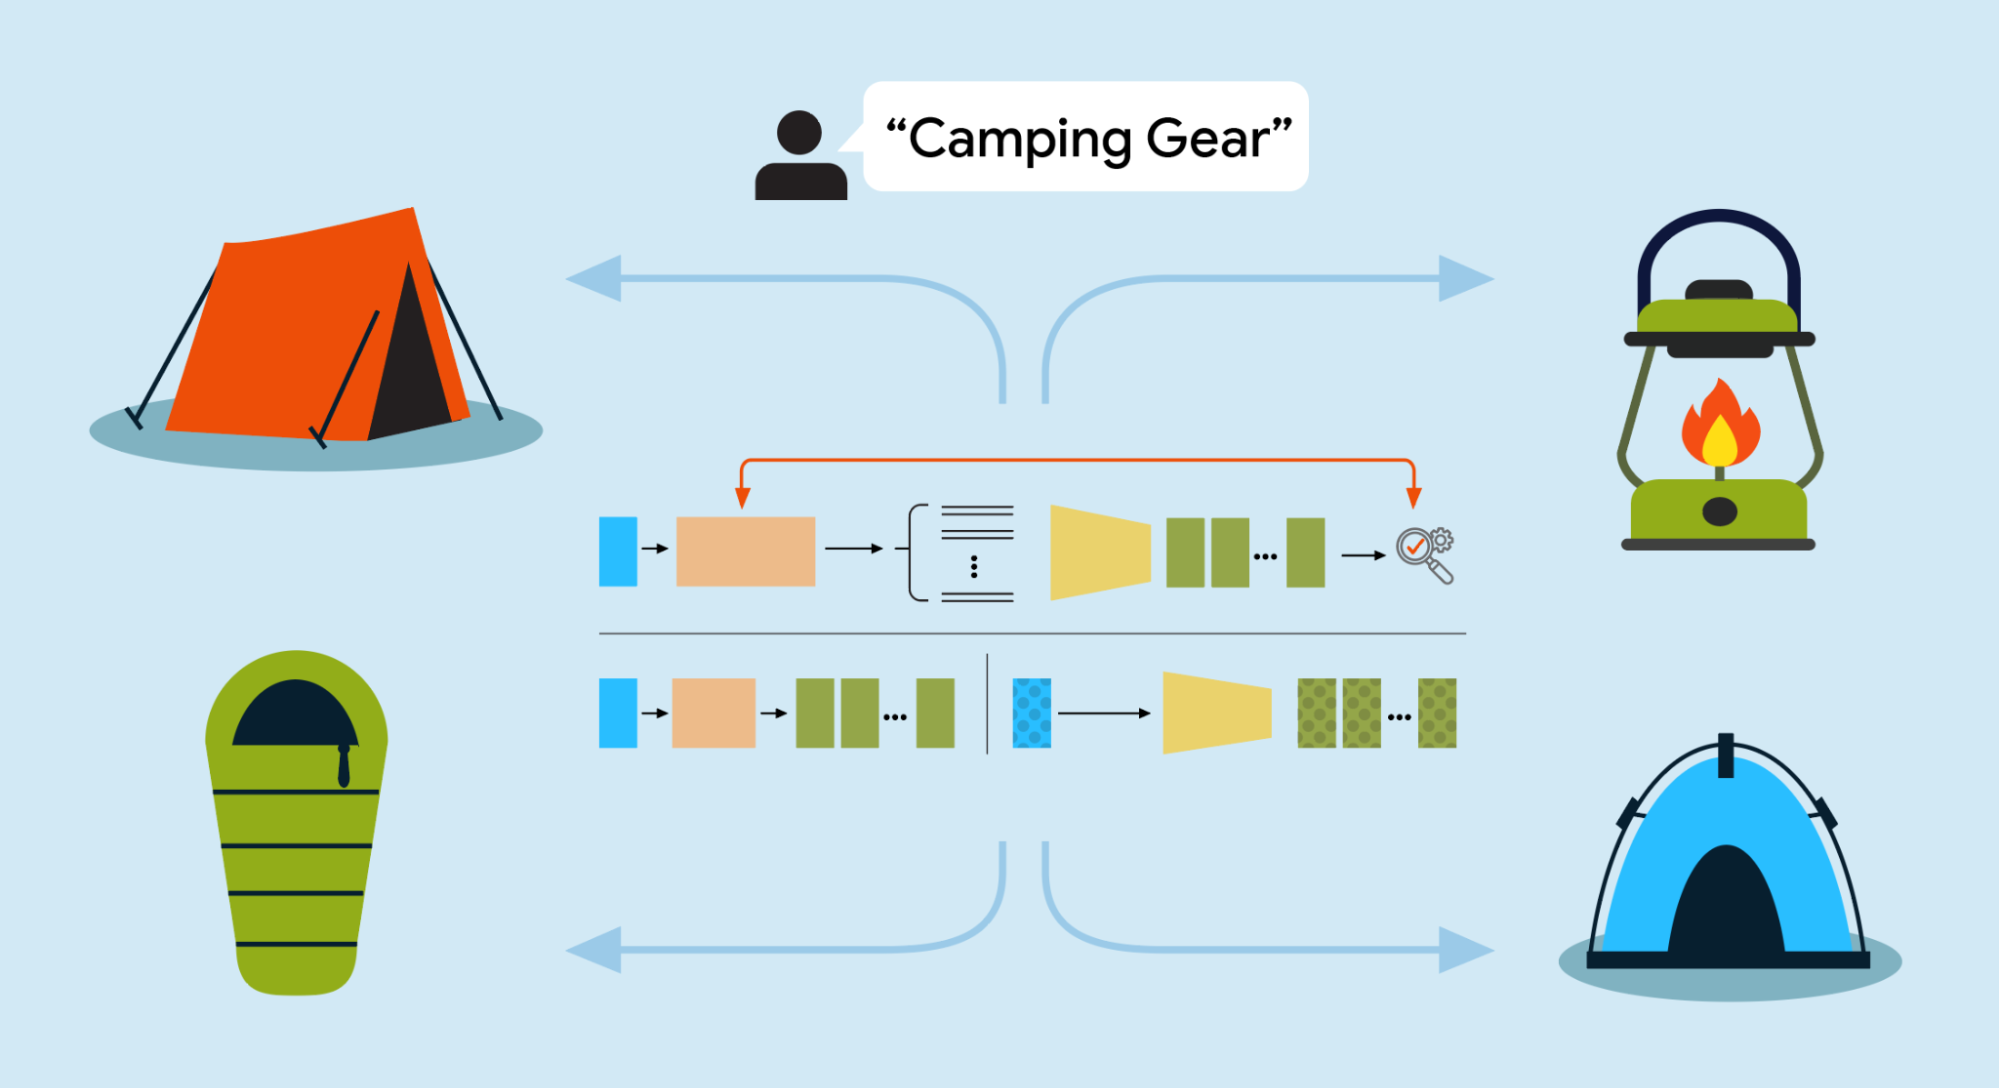
Retrieve-for-Train 框架不依赖昂贵的推理期推理,而是用一次强化学习训练一个轻量级扩散模型。这样便绕开了沉重的自回归“思考预算”,直接生成一组连贯、专家级的 AI 搜索结果。
快速链接
如今的搜索或推荐应用,越来越被期待返回一组彼此协调的结果,而不是单一的最佳匹配。比如用户搜索“露营装备”,他们并不想要十款大同小异的四人帐篷,而是想要一份协调互补的清单,涵盖帐篷、睡袋、便携炉具、头灯等必备装备。为此,系统采用 query fan-out 技术,把一条宽泛的提示拆成若干相关子查询,以覆盖用户可能感兴趣的方向。然而,要让 LLM 动态完成感知数据库的 query decomposition,会消耗巨量的思考预算。按设计,zero-shot LLM 只是通用的自回归文本预测器,并未针对在目标语料库特定的几何流形上导航做过优化。因此,它们需要额外的测试期计算,才能返回一组在集合层面优化了高阶属性(如多样性、覆盖度、互补性、协调性)、同时又与固定数据库保持 grounding 的结果。在 ICML 2026 论文“Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion”中,我们通过奖励到数据的编译框架解决了这一分解瓶颈。Retrieve-for-Train 框架不在推理时强迫模型耗费大量思考预算,而是用离线强化学习(RL)发现与奖励对齐的 fan-out,并将其编译为监督信号。把这些优化后的探索行为蒸馏进一个轻量级扩散检索器后,我们就能在推理时以单次前向高效完成 query fan-out,在无需测试期思考 token 开销的情况下,实现数学形式化的集合层面属性。
为什么通用 AI 不是搜索专家
面对为一组复杂搜索词做头脑风暴的任务,人们很容易想到在推理阶段直接调用一个现成的标准 LLM 来搞定。然而,依赖通用模型做数据库感知的查询分解会带来两个关键问题:
-
释义坍缩: 没有数据库感知的优化,零样本 LLM 经常出现释义坍缩。它们不会去探索一个主题下互补的各个侧面,而是倾向于生成冗余、近乎同义的查询。比如给定一个宽泛的提示“波西米亚节日风格”,一个未经精心设计提示词的标准 LLM 可能偷懒地生成“波西米亚节日时尚”和“波西米亚节日服装”。这种语义上的打转只会产出一批同质化的结果,完全错过了时尚专家能识别出的那些独特且有价值的语义方向,比如流苏夹克、钩针连衣裙或麂皮靴。
-
自回归延迟瓶颈: 标准 LLM 从根本上受制于顺序式的自回归生成。要把一个复杂查询成功分解为互补的侧面,现代模型通常需要相当可观的思考预算,在输出真正的搜索词之前生成数百个中间思维链(CoT)推理 token(即 AI 模型在回答复杂问题前生成的中间步骤或内部处理单元)来规划扩展方向。这种深思熟虑对对话式 AI 来说可以接受,但对集合型搜索(例如检索一组互补的结果,比如上面提到的流苏夹克或钩针连衣裙)却构成了严重的结构性瓶颈。当系统必须同时为一大批子查询做头脑风暴时,持续处理上下文与生成大量推理 token 所带来的叠加开销,扩展性很差。即便有先进的 serving 优化,这种逐 token 的架构也制造了一个延迟下限,与生产环境搜索框所要求的亚秒级响应时间从根本上相冲突。
Retrieve-for-Train 框架
Retrieve-for-Train 把 AI 的训练当作一次离线练习,而不是用户守在屏幕前、它必须当场应考。它不让 AI 每次收到查询都慢慢摸索搜索的规律、烧掉一大笔算力预算,而是先跑一次离线 RL 训练。这套训练用一套严格的奖励机制,把「结果要多样、而且真的有货」这类抽象目标,变成一份精确到每一步的操作手册。手册一旦成型,AI 在真实搜索中就能直接照做,没有延迟。整条流水线分三步:
- Fan-out 语言模型训练: 用 RL 训练一个 fan-out 语言模型,让它输出与属性对齐的子查询,由集合级属性校验奖励打分。这个奖励评估的是整组结果,而不是逐个结果单独打分。
- 监督数据合成: 冻结后的 fan-out 语言模型完全离线地合成(查询 → 目标集合)配对,供监督学习使用,不需要任何人工标注。
- 扩散检索器训练: 一个紧凑的 53.9M 参数扩散模型学会在一次非自回归前向中,把查询嵌入直接映射为一整套目标嵌入,从机制上绕开了基于文本的 CoT 推理 token。
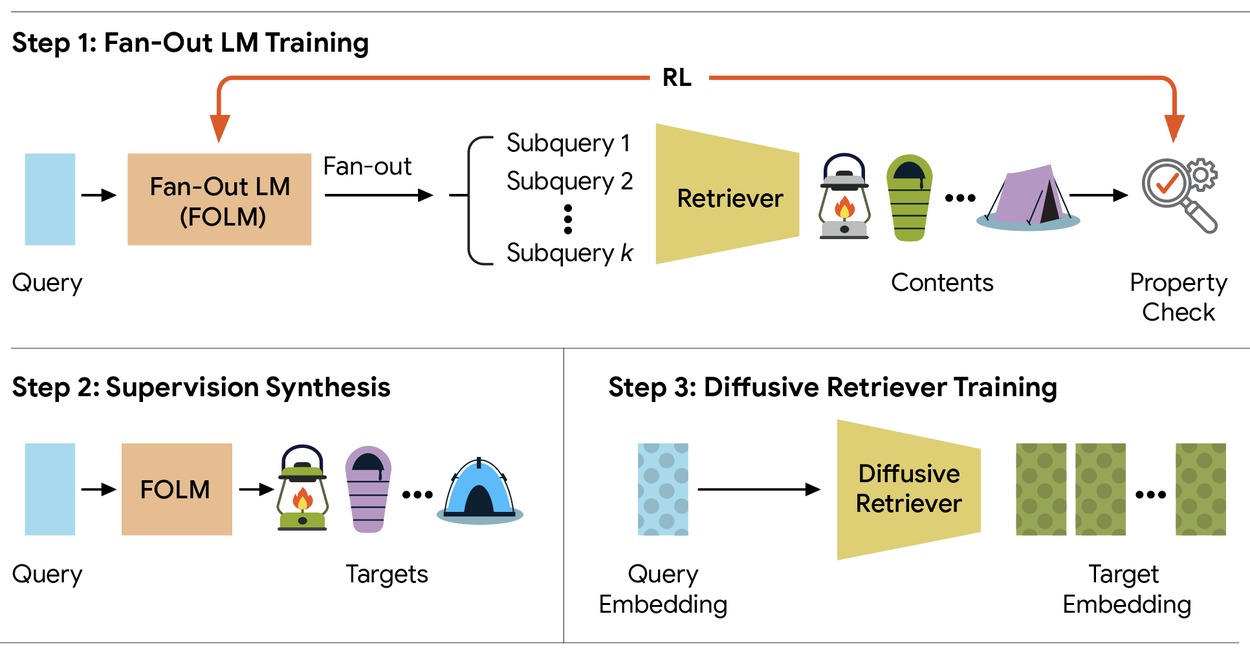
Retrieve-for-Train 框架总览。 第 1 步: 用 RL 训练 fan-out 语言模型(FOLM),产出与属性对齐的子查询。 第 2 步: 用训练好的 FOLM 合成监督数据。 第 3 步: 训练一个基于扩散的 fan-out 检索器,直接从查询嵌入中采样内容嵌入。
面向集合的设计:复合奖励的力量
Retrieve-for-Train 框架能否成立,完全取决于我们如何定义“好的”搜索行为。传统的监督式训练通过 learning to rank 做逐点相关性评估,对每个检索结果单独打分。但一个真正专业的搜索列表,其性质是集合层面的,无法拆解到单个条目上。单个条目的多样性和互补性无从度量;只有在评估整个检索结果集合时,这些性质才在数学上存在。
Retrieve-for-Train 没有依赖含糊的自然语言指令来强制实现这些 fan-out 性质,而是用一个严格的数学复合奖励,通过强化学习微调 4B 开源语言模型(Gemma3-4B 和 Qwen3-4B)。在我们的开放式摘要检索任务中,这个复合奖励是三个相互制衡的支柱的加权平衡:
- 有据可依(Groundedness): 惩罚与数据库流形的距离,确保每个生成的子查询都对应数据库中真实、可检索的条目。
- 多样性(Diversity): 用 Vendi Score 在整个子查询集合上度量,迫使模型探索广泛的语义跨度。
- 对齐(Alignment): 将候选子查询锚定在原始宽泛提示上,防止语义漂移。
互为反向锚点与 soft-GRPO 训练
训练时,我们用 group relative policy optimization(GRPO)配合 soft proximal policy optimization(PPO),让 fan-out 语言模型针对这些几何现实做优化。
这三项奖励缺一不可,因为它们互为反向锚点。如果只针对有据可依做优化,模型会钻奖励的空子,生成退化的、毫无意义的字符串——只要它们恰好能在数学上映射到某个数据库坐标。如果再加上对齐来修正这些无意义输出,策略又会直接作弊,退化成对用户提示的重复改写。
把 Vendi Score 作为反向锚点引入后,Retrieve-for-Train 有效堵死了这些捷径。为了达到高奖励状态,策略被迫进入嵌入空间中一个平衡的区域,在那里它必须找到原始意图的合法、严格有据、同时语义上又彼此不同的变体。
实验
为评估 Retrieve-for-Train 框架,我们将冻结的、针对特定数据集的多模态嵌入骨干网络与面向查询扩展优化的开源语言模型相结合。我们在两种不同的集合值检索设定下评估了这套方案:
- 开放式抽象检索: 不存在唯一标准答案,质量完全由集合层面的属性衡量,包括多样性、与查询的对齐程度,以及是否扎根于数据库。
- 弱监督组合式检索: 查询配有一个弱参考集,而该参考集只是查询意图的一种可能实现。
在多模态嵌入骨干网络方面,我们跨两个领域做了实验:一个用于文本到图像实验的大规模时尚数据集,由用户搭配的服装组成(用基于 CLIP 的检索器评估);以及一个专有的工业数据集,由专家生成的音乐播放列表组成,用于文本到音乐评估(用 MuLan 评估)。在语言模型方面,查询扇出过程由 4B 开源模型驱动,具体是 Gemma3-4B 和 Qwen3-4B,它们每处理一条主搜索提示,就要生成恰好 10 条子查询。这些扇出模型的 RL 训练通过 Soft-GRPO 实现,该方法在组相对策略优化的基础上加入了软 PPO 正则化。
结果
检索质量与准确度
在两个检索任务上,Retrieve-for-Train 都优于传统的单查询搜索、零样本扩展,甚至优于经过大量优化的 Best-of-N 基线。从定性上看,零样本 LLM 基线倾向于生成近乎同义的改写(例如 "bohemian festival style" 与 "bohemian festival fashion"),导致结果冗余。Retrieve-for-Train 生成的子查询高度多样、彼此区分(例如分叉出 "boots" 或 "lace"),同时严格扎根于数据库流形之内。
推理速度提升一个数量级
直接部署经 RL 调优的语言模型,搜索质量确实出色,但它继承了自回归架构固有的延迟限制,还需要很高的思考计算预算。我们把学到的行为蒸馏进 53.9M 参数的 Retrieve-for-Train 扩散模型,成功打破了延迟瓶颈。扩散模型在连续嵌入空间中一次性并行生成全部目标方向,无需自回归,速度比自回归方案快 12 到 20 倍。规模上去之后,自回归的 fan-out 延迟在大上下文批次下线性膨胀到近 50 秒,而 Retrieve-for-Train-Diffusion 始终保持在亚秒到数秒之间,以极小的计算成本提供可直接上线的专家级搜索。
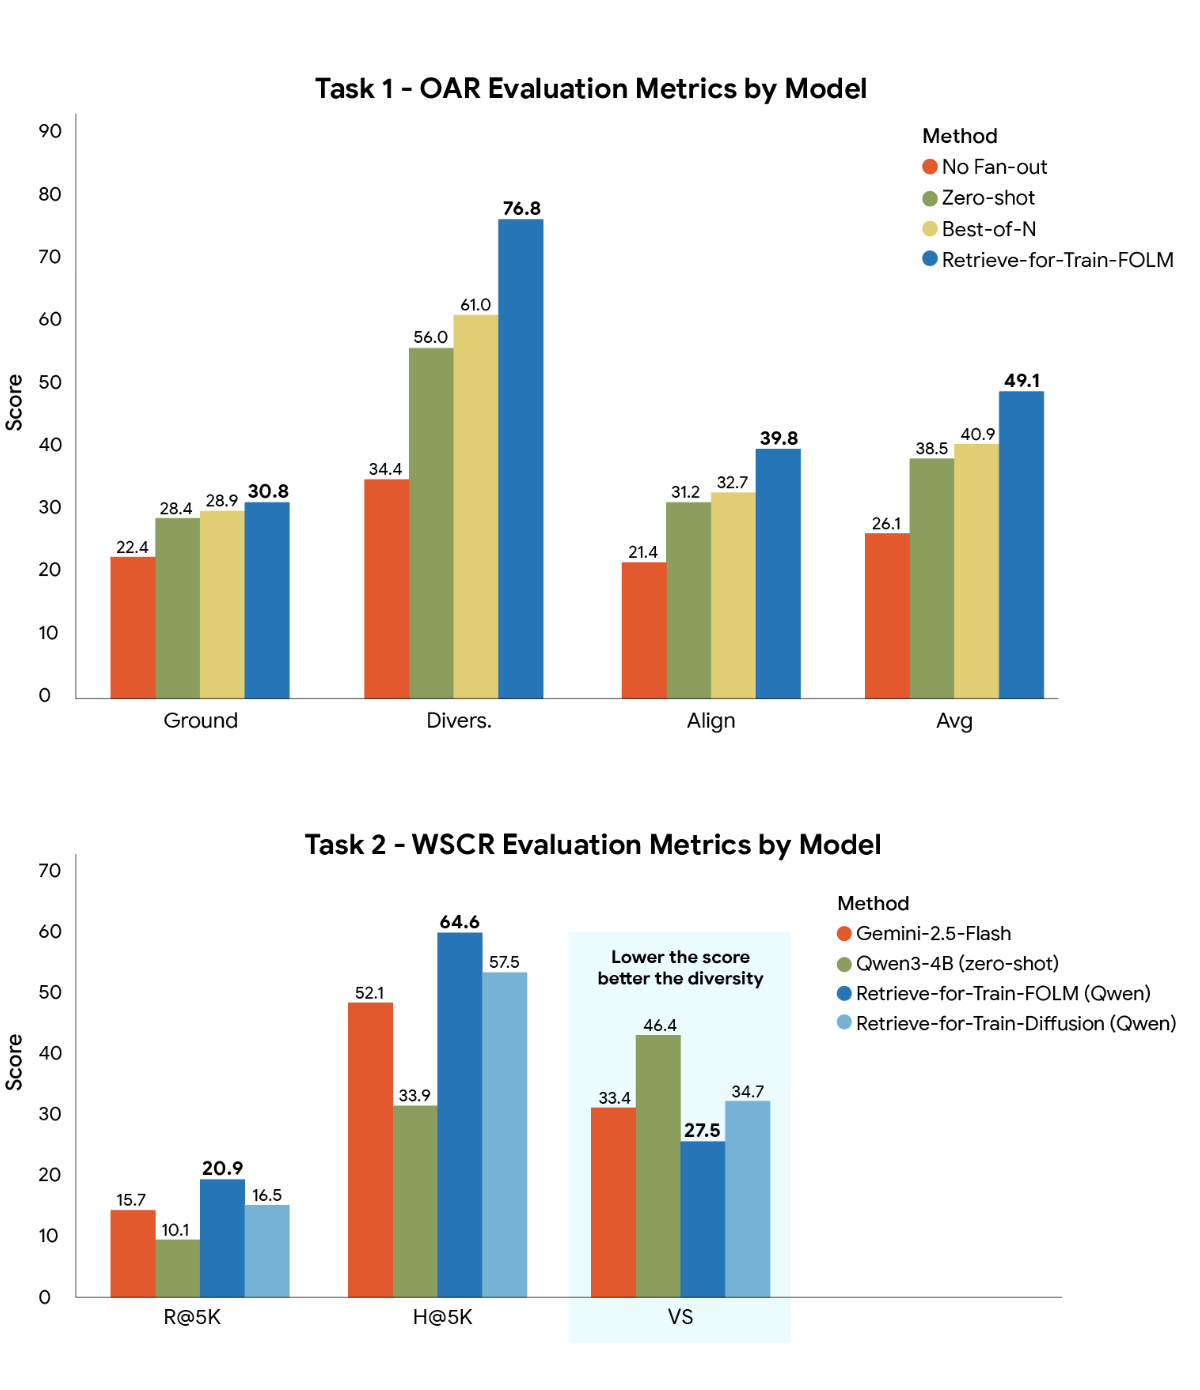
在开放式摘要检索(OAR)和弱监督组合检索(WSCR)两项任务上,Retrieve-for-Train 框架(FOLM 与 Diffusion)的表现始终优于标准搜索和零样本基线,在多样性、对齐度和召回率上都有显著提升。
防作弊锚点(消融实验的发现)
在奖励优化过程中,我们发现了一件关于训练搜索用 fan-out 语言模型的根本性事实。如果不加多样性项,模型会迅速退化成生成无意义的字符串(比如 "line ending line ending"),从数学上钻数据库向量坐标的空子。引入几何多样性指标(Vendi Score)相当于加了一个关键的反向锚点,把模型逼进嵌入空间中一个稳定的区域——在那里,它只有真正像搜索专家那样行事,才能把奖励最大化。
结论
我们证明了,当 RL 被用作一次性的“目标转换器”而非在线推理引擎时,可以发挥出极高的效率。通过将奖励驱动的行为探索中繁重的计算与最终部署的模型解耦,我们的框架成功绕开了在线 LLM 部署典型的推理延迟和计算开销。将这些复杂的集合级行为蒸馏进一个轻量级的 diffusion prior,使生产级检索系统能够有效地针对多样性和对齐等更高阶的属性进行优化。最终,Retrieve-for-Train 为专业领域或多模态领域的集合检索建立了一条高度可扩展、数据高效的流水线——在这些领域中,人工标注且属性对齐的训练对往往稀缺或获取成本高昂。更多细节请参阅论文。