Qwen3.8-2.4T の PD 分離サービング
GB300 NVL72 上で Qwen3.8-2.4T を PD 分離でサービングした結果。高スループット側では GPU あたり毎秒 5,000 トークン、低遅延側ではユーザーあたり 180 トークンに達し、両端が同じパレート前沿に乗る。
日本語
コピー
概要
本記事では、GB300 NVL72 クラスタ上で vLLM を使い、Qwen3.8-2.4T を PD 分離構成でデプロイした最新の性能結果を紹介する。ワークロードは 8K/1K だ。高スループット寄りの構成では、vLLM は GPU あたり 5000 トークン/秒の合計スループットに達する。低レイテンシ寄りの構成では、ユーザーあたり 180 トークンを生成する。どちらも下のパレートフロンティアに示す。本記事では、これらの結果をどうやって得たのかを詳しく説明し、誰でもローカルのデプロイで検証・再現できる正確な srt-slurm 設定を示す。だがそれ以上に重要なのは、こうした設定を決めていく過程の意思決定を書いている点だ。これは性能結果そのものより価値がある。任意のモデルについて PD 分離デプロイの性能を引き出すために使えるからだ。
はじめに
以前、Qwen3.5 の PD 分離デプロイの結果を示し、vLLM が 25K Total TPS/GPU に到達できることを明らかにした。それに続いて、Qwen シリーズからまたフロンティアモデルが登場した。Qwen3.8-2.4T である。本記事は Qwen3.8-2.4T の PD 分離デプロイに移り、パレートフロンティアの全体を示す。
Qwen3.5 の検討では、パレート曲線の左側、つまり Total TPS/GPU の最大化を主に見ていた。今回はさらに進めて、左側(高スループット)と右側(低レイテンシ)の両方をカバーする完全なパレートフロンティアを構築する。言い換えると、スループット重視の構成だけでなく、対話性(ユーザーあたりの Gen TPS)を最大化する最適な PD 構成も見つける。
同じく重要なのは、本記事が最終的な数字だけを語るものではないという点だ。チューニングの過程も順を追って分解する。どの指標を測るか、どこでボトルネックを特定するか、どうやってより良い PD 構成へ反復するか。狙いは、このワークフローを理解しやすく再利用しやすくして、誰もが他のモデルのデプロイ性能をチューニングできるようにすることにある。
スループットの最大化
まず最大化したい指標は、GPU あたりの合計トークンスループットだ。この指標は並行数に依存する。decode エンジンが同時に処理するリクエストが多いほど、スループットは上がる。
並行数を制限するのは KV cache の容量である。アクティブなリクエストはそれぞれ、その一部を占有するからだ。したがって KV cache のサイズは、どのトポロジでも最初に答えるべき問いになる。これは 2 つに分かれる。1 つのリクエストがどれだけ cache を消費するか、そしてモデルの重みをロードし、vLLM サーバーが自身の作業用に領域を確保したあと、GPU 上にどれだけ残るか。本章の残りではこの 2 つを順に見て、GB300 1 枚で Qwen3.8-2.4T が理論上到達できる最大並行数を導出する。
リクエストあたりの KV cache 見積もり
Qwen3.8-2.4T は 92 層ある。69 の GDN 層と 23 の Full-Attn 層で、各層に MoE ブロック(92 × 512 expert)が付く。GDN と Full-Attn は BF16、MoE は NVFP4 だ。重みの内訳は次のとおり。
- 91 GiB —— モデルの非 expert 重み(GDN 重み 60 GiB、Full-Attn 重み 19 GiB)
- 1242 GiB —— モデルの expert 重み
Qwen3.8-2.4T はハイブリッドモデルなので、state は 2 つに分かれ、計算方法が大きく異なる。Full-Attn state はトークンごとに増え、GDN state はリクエスト単位で保持される。
Full-Attn state はトークン単位で保持する。1 トークンあたり各層で 2 KiB 必要になる。
Full-Attn state per token:num_key_value_heads 4 × head_dim 256 × float8_e4m3fn の 1 バイト、K と V で 2 倍して 2048 B = 2 KiB。
GDN state はトークン単位ではなくリクエスト単位で保持する。ここが重要だ。これは 2 つの部分からなる。
- Conv state —— 因果畳み込みの最後の kernel-1 個の入力。チャネルごとに 1 つのフィルタを持ち、チャネルは q、k、v を連結したものだ。
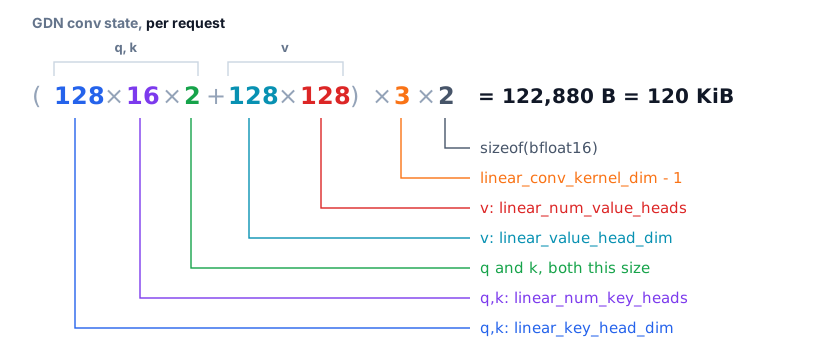
GDN の conv state(リクエストあたり):q と k は linear_key_head_dim 128 × linear_num_key_heads 16 × 2、v は linear_value_head_dim 128 × linear_num_value_heads 128。全体に linear_conv_kernel_dim − 1(つまり 3)を掛け、さらに bfloat16 の 2 バイトを掛けると 122,880 B = 120 KiB になる。
- SSM state ——コンテキスト全体を保持する再帰行列:
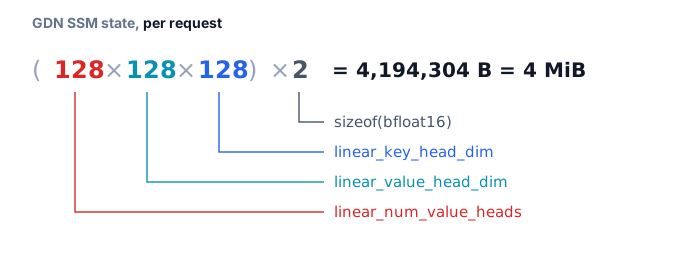
GDN の SSM state(リクエストあたり):linear_num_value_heads 128 × linear_value_head_dim 128 × linear_key_head_dim 128、bfloat16 で 1 要素 2 バイトなので 4,194,304 B = 4 MiB。
合計すると、GDN の state には 4 MiB + 120 KiB = 4216 KiB が必要になる。
vLLM は KV cache をブロック単位で確保し、ブロックは GDN state 1 個、または Full-Attn state 複数個を収められる大きさでなければならない。Qwen3.8-2.4T では GDN state が Full-Attn state の 4216 KiB / 2 KiB = 2108 倍ある。したがってブロックサイズは GDN state で決まり、16 バイト境界に揃えるので、1 ブロックに align(2108, 16) = 132 * 16 = 2112 token が入り、ブロックサイズは 2112 × 2 KiB = 4.125 MiB になる。
分離デプロイで注意すべき点が一つある。prefill と decode はそれぞれ独立にブロックサイズを計算するが、KV cache の転送には両側で一致していることが要る。一致しない場合は --block-size を手動で設定し、両側で GDN state を収められる値にする。代わりに KV cache の空間をいくらか無駄にする。
1 ブロックのサイズが出れば、1 リクエストが占める KV cache の量が分かり、測定で期待できる最大同時実行数も見積もれる。この計算には先に負荷の見積もりが要る。ここでは ISL=8192、OSL=1024 に固定する。いわゆる長 ISL・decode 律速のテストシナリオだ。
1 リクエストは ISL と OSL、それに OpenAI API リクエストが使う chat template 用に確保されるわずかな領域を占める。1 ブロック 2112 token、Full-Attn 23 層、GDN 69 層として、1 リクエストのオーバーヘッドは次のように計算できる。
Full-Attn state は token 数に比例して増えるので、23 層それぞれで 2112 token ごとに 1 ブロック必要になる。GDN state はリクエストごとに固定なので、69 層それぞれでちょうど 1 ブロック必要になる。総量をこの 2 つに分ける。
KV cache が使うのは、モデルのロードとその他すべての予約を差し引いた後に残る GPU メモリだ。だからまず、メモリを確保するものを一つ残らず洗い出す。
KV cache の容量
GB300 は最初に 279 GB を渡してくる。ドライバのオーバーヘッドがまず 2.28 GiB を占め、vLLM の起動時に使えるのは合計 276.62 GiB になる。vLLM サーバーが起動する前の時点で、CUDA context がすでに約 3.13 GiB を占めている。このメモリはこちらではどうにもならず、調整する手段もない。
さらに vLLM は既定で、276.62 GiB を基数としてその 8% を事前に予測できない部分——activation のピークなど——のために予約する。これが gpu_memory_utilization で制御している設定だ。ここまでで残りは約 254 GiB になる。
別に 2.90 GiB が NCCL buffer、アロケータ、その他 PyTorch とは無関係なものに消える。つまり重みをロードする前の時点で 276.62 × 0.92 − 3.13 − 2.90 = 248 GiB ある。
activation のピーク
重みのロードが終わると、vLLM はモデルを eager モードで 1 ステップ実行したときに消費するメモリを測定する。CUDA graphs を使わない場合のことだ。この手順は欠かせない。CUDA graphs 自体にサイズ上限があり、推論時の batch size がそれを超えることがあるからだ。その場合、forward は何としても走らせるしかなく、eager モードに落ちる。こうなると性能が落ちるので、もちろん避けたいが、実行時に絶対に起きないとは保証できない。eager モードの測定には max_num_batched_tokens token を使うので、最悪ケースの activation ピークが測れる。
メモリ消費を見積もる最も簡単な方法は、aggregated モードで対象の decode トポロジを何度かテストすることだ。本記事で扱うトポロジについて、engine ごとの activation ピークは次のとおり。
| 実行 | トポロジ | MTP | max-num-seqs | max-num-batched-tokens | activation ピーク (GiB) |
|---|---|---|---|---|---|
| 1 | TP8 | + | 20 | 96 | 0.57 |
| 2 | TP8 | + | 32 | 144 | 0.58 |
| 3 | TP8 | + | 80 | 336 | 0.56 |
| 4 | TP8 | + | 272 | 1104 | 1.91 |
| 5 | TP4DP4 | + | 80 | 336 | 1.72 |
| 6 | TP4DP4 | + | 272 | 1104 | 2.24 |
| 7 | TP4DP4 | − | 528 | 544 | 1.83 |
| 8 | TP4DP4 | − | 656 | 672 | 2.15 |
CUDA graphs
次に vLLM は CUDA graph をキャプチャする。graph に必要なメモリは固定アドレス上に事前確保しておく必要があり、つまりこの分のメモリは graph をキャプチャする前に見積もっておかなければならない。
現在の vLLM はこうしている。まずサーバー構成で利用可能な graph サイズをすべて列挙する。同時に再生できる graph は 1 つだけであり、graph が大きいほどピークメモリ使用量も増える——少なくとも最大のもの分の領域は確保しておく必要がある。次に問題になるのは残りの graph にどれだけ追加メモリが要るかだが、ここは eager 実行とは事情が異なる。ある graph をキャプチャし終えたあと、それを再生するとまったく同じアドレスが再利用される。2 番目に大きい graph もキャプチャしてみると、最初の graph がすでに占有しているメモリの上に、さらに追加分を占有することがわかる。
ウォームアップ時間を節約するため、vLLM は続いて次のように仮定する。以降の各 graph も同じ大きさの増分をもたらす、と。CUDA graph に必要なメモリは で計算する。ここで は最大 graph のメモリ、 は graph の総数である。graph は静的アドレスを使い、起動時にすべてをキャプチャすることもできないため、この推定値でブロック全体を先に確保しておくしかない。
実際には、この推定値は graph が本当に必要とするメモリを大きく上回ることが多い。自分で確かめたいなら、aggregated モードで compilation-config: '{"cudagraph_mode": "FULL_DECODE_ONLY"}' と max-cudagraph-capture-size を組み合わせ、decode トポロジの試運転をすればよい。
本記事で扱うこれらのトポロジについて、FULL モードでのエンジンあたりのメモリ使用量は次のとおり。
| 実行 | トポロジ | MTP | graph 数 | 予約 (GiB) | 実使用 (GiB) | 未使用 (GiB) | % |
|---|---|---|---|---|---|---|---|
| 1 | TP8 | + | 11 | 0.91 | 0.59 | 0.32 | 54% |
| 2 | TP8 | + | 17 | 1.28 | 0.82 | 0.46 | 56% |
| 3 | TP8 | + | 37 | 1.87 | 1.88 | −0.01 | −1% |
| 4 | TP8 | + | 85 | 7.93 | 6.04 | 1.89 | 31% |
| 5 | TP4DP4 | + | 37 | 8.35 | 6.52 | 1.83 | 28% |
| 6 | TP4DP4 | + | 85 | 7.56 | 9.90 | −2.34 | −24% |
| 7 | TP4DP4 | − | 52 | 8.29 | 7.51 | 0.78 | 10% |
| 8 | TP4DP4 | − | 60 | 8.95 | 8.07 | 0.88 | 11% |
この表は gpu_memory_utilization の予約がなぜ存在するのかも示している。上記のいくつかの実行では、graph が実際に使うメモリが初期見積もりを超えており、その超過分をこの予約が OOM に至らせずに済ませている。
注意すべきは、KV cache に割り当てられるメモリ量は CUDA graph の推定値で決まり、graph 実行時の実使用量では決まらないという点だ。つまり KV cache のサイズはこの見積もりの精度に直接依存する。我々のケースではよく当たっているが、最終的な割合を最適化したいなら、graph サイズは手動で見積もるべきだろう。vLLM の graph 見積もり機構はさらなる調査と改善に値する。Qwen3.8、Kimi-K3、DSV4 のような超兆パラメータのフロンティアモデルが登場するにつれ、この問題はますます切実になっているからだ。
エンジンあたりの最大同時実行数
ここでこれまでの結果をすべてまとめ、vLLM が我々のモデルでエンジンあたり何リクエスト処理できるかを計算する。前述のとおり、GB300 からは 276.62 GiB が得られる。その一部は gpu_memory_utilization が占める。我々のシナリオではデフォルト値の gpu_memory_utilization=0.92 を使う。したがってエンジンあたりの初期利用可能メモリは 276.62 GiB × 0.92 = 254.5 GiB となる。
下表は最後の列を除いてすべて実測値である。これらの数値は vLLM サーバー起動時の報告から取っている。最後の列はそこから導出したもので、KV cache サイズを 1 リクエストあたりに必要な 759 MiB(前述の「単一リクエストの KV cache 見積もり」で算出した値)で割ったものだ。
これは単なる割り算であり、MTP が投機トークン用に確保する追加の KV スロットは意図的に無視している。したがって MTP の行については、実際に到達できる同時実行数ではなく上限と見なすべきである。
| 実行 | トポロジ | MTP | CUDA ctx (GiB) | non-torch (GiB) | 重み (GiB) | ピーク活性 (GiB) | graph 推定 (GiB) | KV cache (GiB) | リクエスト数/エンジン |
|---|---|---|---|---|---|---|---|---|---|
| 1 | TP8 | + | 2.54 | 0.72 | 169.28 | 0.57 | 0.91 | 83.00 | 112.0 |
| 2 | TP8 | + | 2.54 | 0.72 | 169.28 | 0.58 | 1.28 | 82.63 | 111.5 |
| 3 | TP8 | + | 2.54 | 1.19 | 169.28 | 0.56 | 1.87 | 81.60 | 110.1 |
| 4 | TP8 | + | 2.54 | 2.40 | 169.28 | 1.91 | 7.93 | 72.97 | 98.4 |
| 5 | TP4DP4 | + | 3.13 | 1.98 | 108.71 | 1.72 | 8.35 | 133.74 | 180.4 |
| 6 | TP4DP4 | + | 3.13 | 2.22 | 108.71 | 2.24 | 7.56 | 133.77 | 180.5 |
| 7 | TP4DP4 | − | 3.13 | 2.90 | 107.51 | 1.83 | 8.29 | 133.96 | 180.7 |
| 8 | TP4DP4 | − | 3.13 | 3.03 | 107.51 | 2.15 | 8.95 | 132.85 | 179.2 |
この表からいくつかのことが読み取れる。第一に、検証したすべての構成で、重みにも KV cache にも属さないメモリオーバーヘッドは約 20 GiB で、利用可能なメモリ全体のおよそ 7% を占めていた。第二に、モデルの重みに割り当てられる領域はトポロジーによってかなり異なる。GPU あたりの総 token スループットを最大化するには高い並行度が必要であり、その並行度は最終的に KV cache に使えるメモリによって頭打ちになる。メモリをさらに空ける方法は、モデル自体が要求する分を圧縮することだけであり、最高の並行度を狙うなら decode 段階で TP4DP4 トポロジーを選ぶべき理由はここにある。
prefill 性能の測定
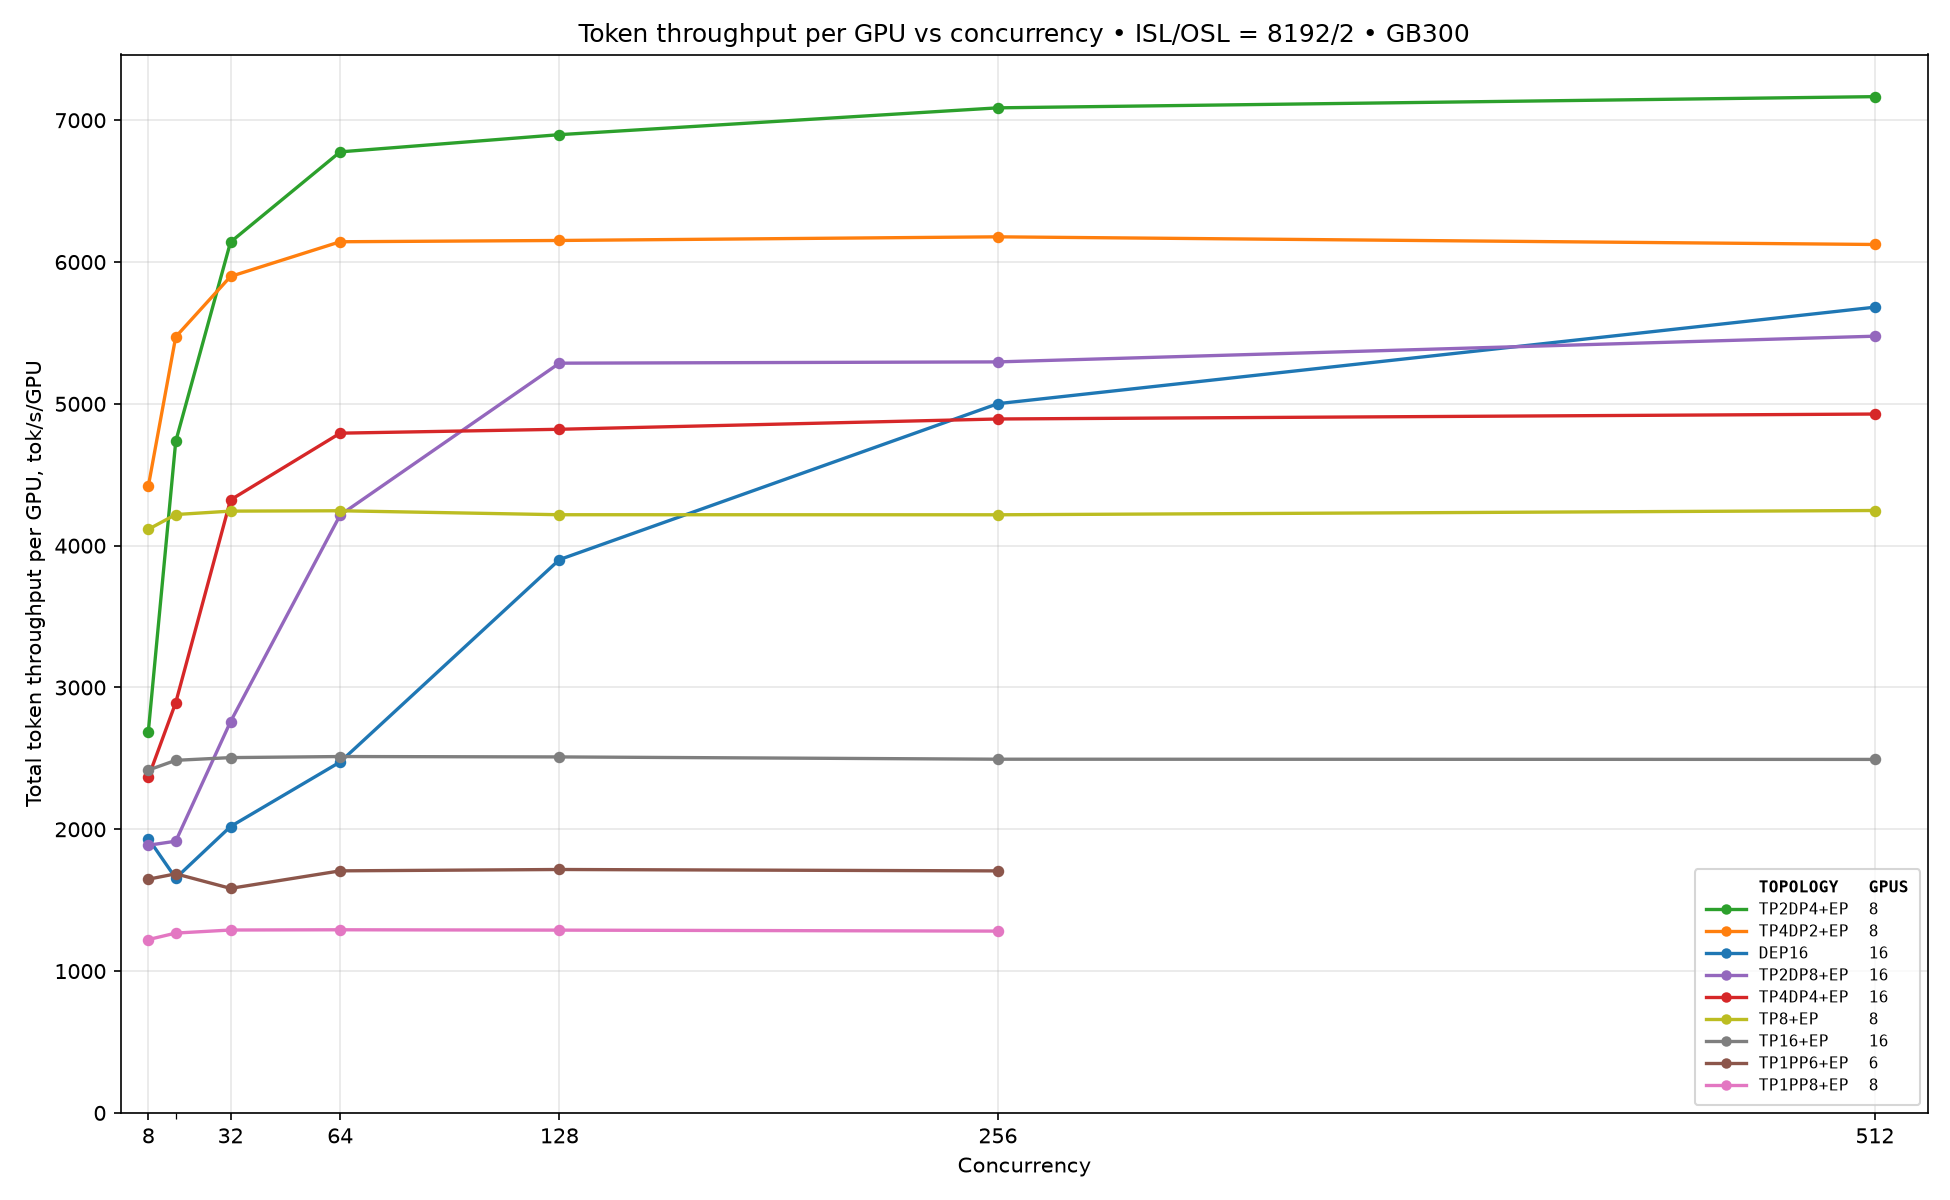
目標に向けた次の大きな一歩は、prefill 性能と decode 性能を分けて測定することだ。具体的には、prefill のみの負荷(ISL/OSL=8192/2)で集約型サービスを動かし、disaggregated serving の prefill endpoint にどのトポロジーが最適かを割り出す。prefill のみと decode のみの負荷を別々に測定すれば、最適なトポロジーを選べるうえ、PD serving の性能評価にかかる作業量も大幅に減る。今回の構成では、prefill に以下のトポロジーを選んだ。
- TP4DP2+EP
- TP2DP4+EP
- TP4DP4+EP
- TP2DP8+EP
- DP16+EP
- TP1PP6+EP
- TP1PP8+EP
- TP8+EP
- TP16+EP
測定結果は以下のとおり。
図 1:GB300 上、ISL/OSL 8192/2 における prefill の GPU あたり総 token スループットと並行数の関係。
並行度が低いときは TP4DP2+EP が最も良い。並行数が上がると TP2DP4+EP が優位に立つ。
decode 性能の測定
decode も同じ手順で扱う。decode のみの負荷(ISL/OSL=1/1000)で集約型サービスを動かす。選んだトポロジーは以下のとおり。
- TP2DP4+EP
- TP4DP8+EP
- TEP8
- TEP16
さらに MTP を speculative token 3 個で有効にしてみた。これで性能が上がるはずだ。
測定結果は以下のとおり。
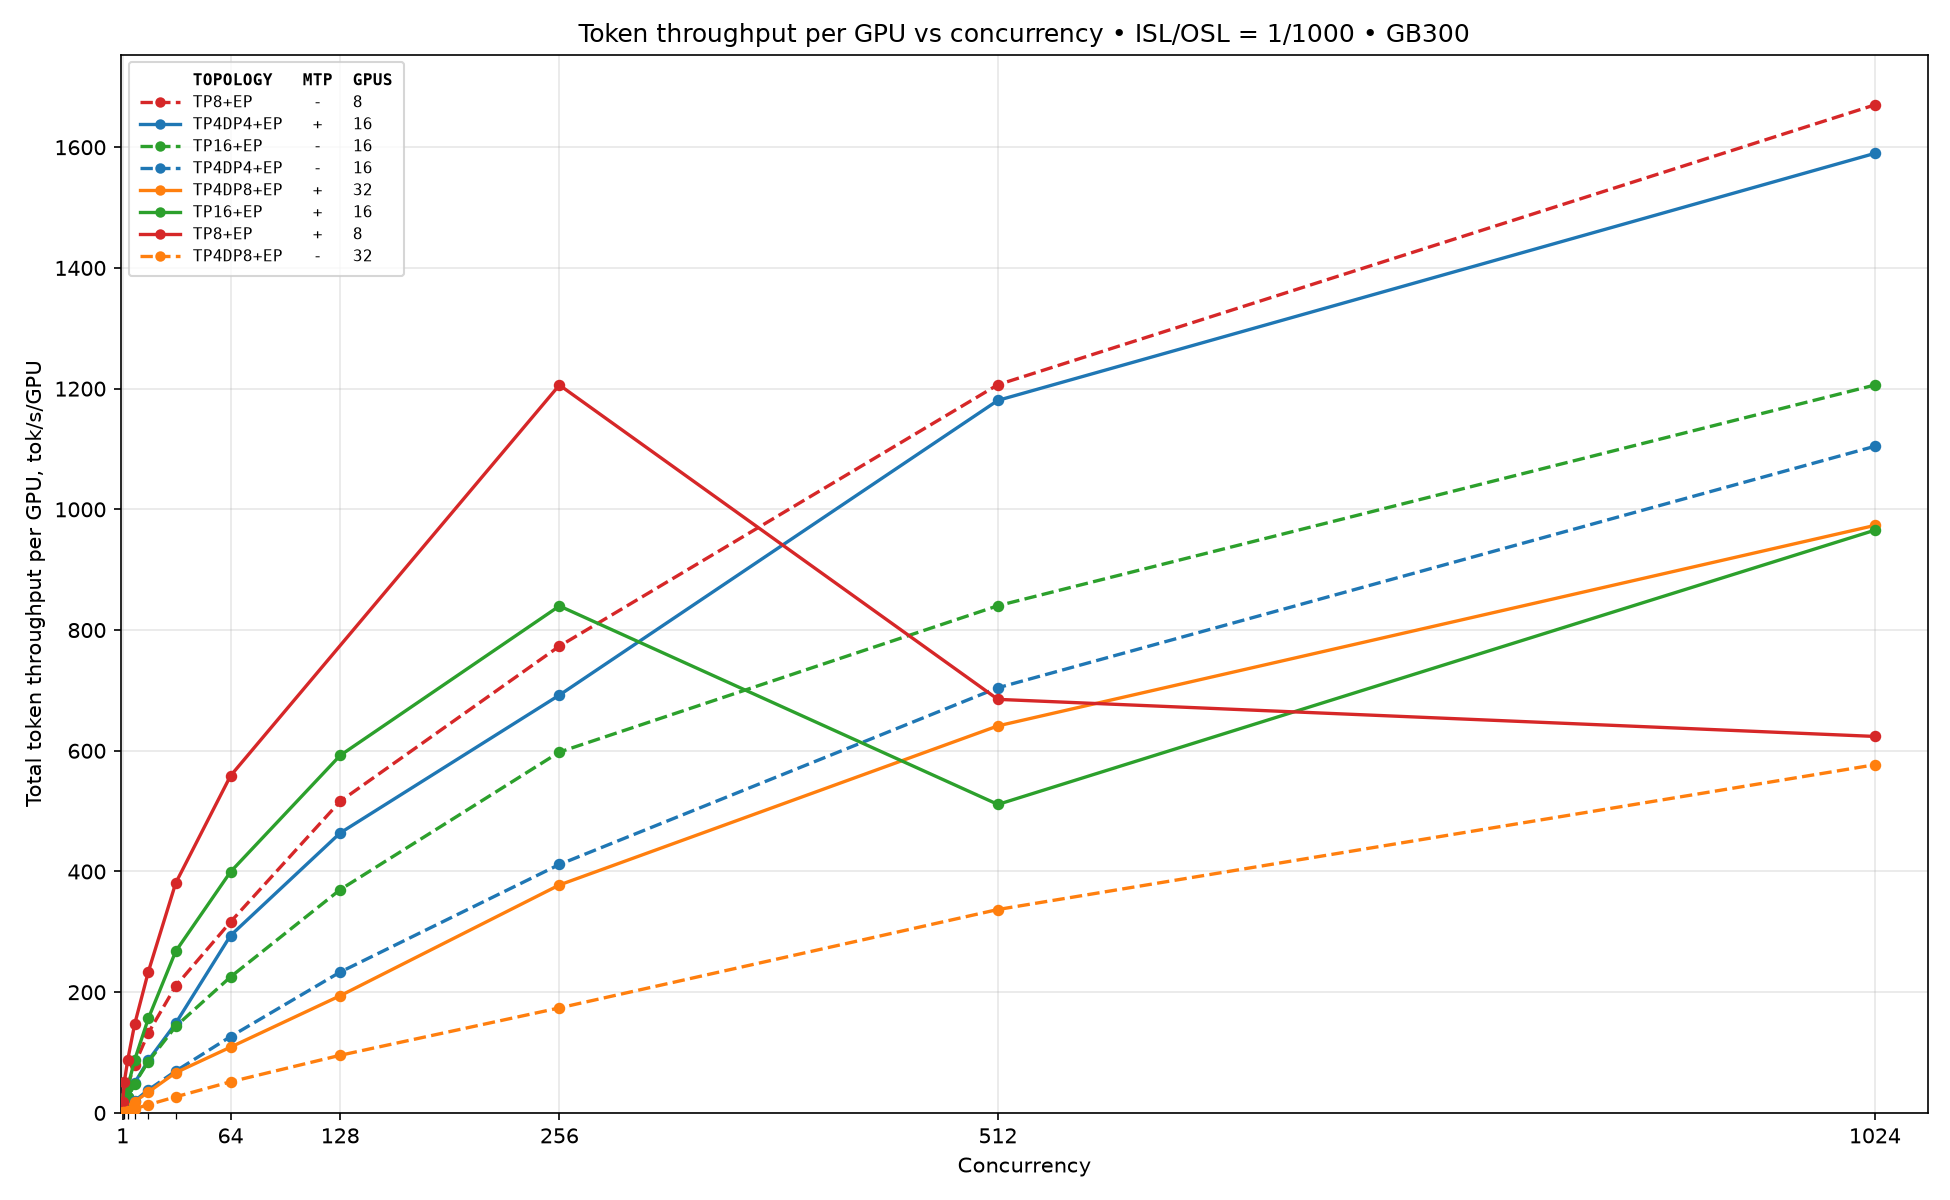
図 2:GB300 上、ISL/OSL 1/1000 における decode の GPU あたり総 token スループットと並行数の関係。
まず、KV cache に十分な空きがあるかぎり、MTP は性能を大きく引き上げる。並行数が低いときの最適なトポロジーは TEP8 + MTP。並行数 512 と 1024 では TEP8 が優勢。並行度が高いときは TP4DP4+EP が他のすべてを上回る。TEP8 より KV cache の領域を多く取れるからだ。
これで分離型のパレート測定に必要なものはすべてそろった。
分離型の性能結果
環境構成
測定は NVLink72 で接続した GB300 クラスタ上で行った。ISL/OSL = 8192/1024、並行数は 1 から 2560 まで。性能は decode トポロジーと decode endpoint 数を固定して測定している。この構成で decode 側は endpoint 1 個に GPU を 8 枚または 16 枚載せる。
- 1×TEP8
- 1×TP4DP4+EP
prefill 側は endpoint 1 から 4 個、それぞれ GPU 8 枚から 32 枚の構成を評価した。
- 1×TEP8
- 1×TP4DP2+EP
- {1,2,3,4}×TP2DP4+EP
結果を再現するには Qwen3.8-2.4T NVFP4 モデル、最新の vLLM vllm/vllm-openai:nightly-a9a17 Docker イメージ(vLLM revision v0.26.1rc1.dev1177+ga9a17e709)、Dynamo 1.2.0.dev20260526、srt-slurm v1.0.98、AIPerf ツールを使う。本記事で使用した recipe はすべて srt-slurm-recipes リポジトリ にある。
精度結果
まず選定したすべての PD 構成で精度を検証した。同じリポジトリに精度 recipe があり、srt-slurm で自分で実行できる。標準的な GSM8K(Grade School Math 8K)ベンチマークを使った。各 PD 構成の最終的な精度はすべて 95%。これで性能測定に進める。
性能結果
各構成のパレート曲線は以下のとおりです。それぞれの曲線は単一のデプロイを並行数方向にスキャンして得たものなので、各点はその曲線上にある構成でしか到達できません。
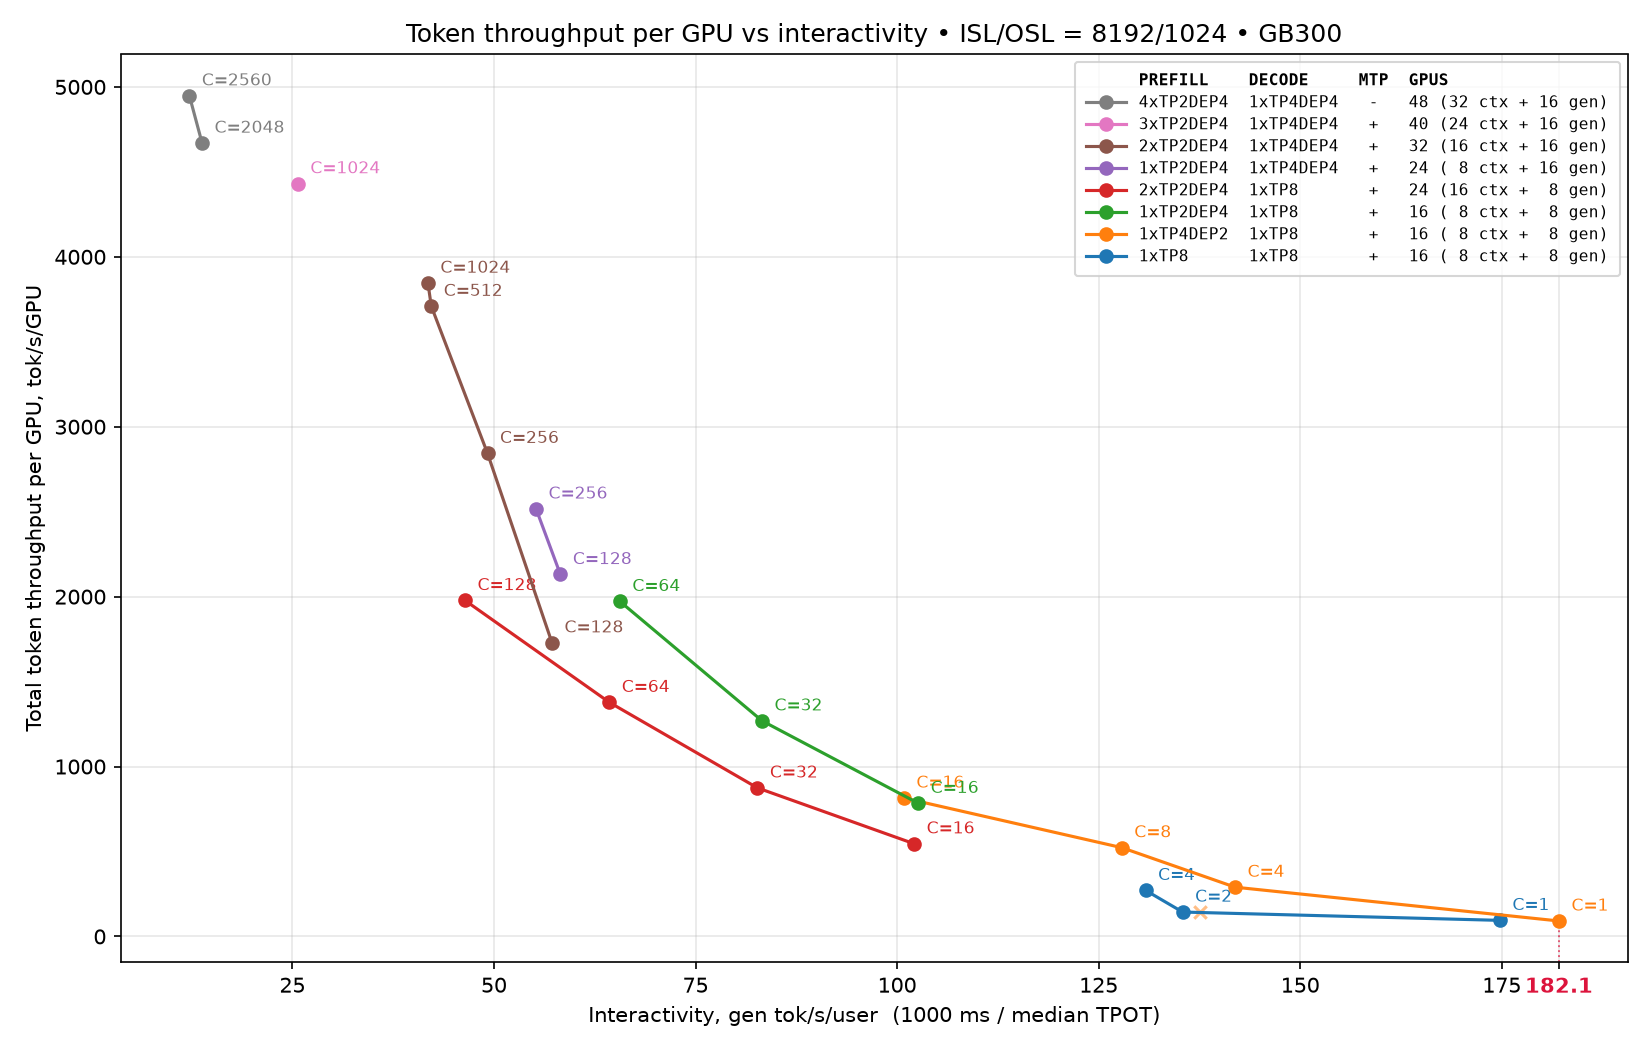
図 3:各分離構成のパレート曲線、ISL/OSL 8192/1024、GB300。
これらをすべて統合すると、最終的なパレートフロンティアが得られます。
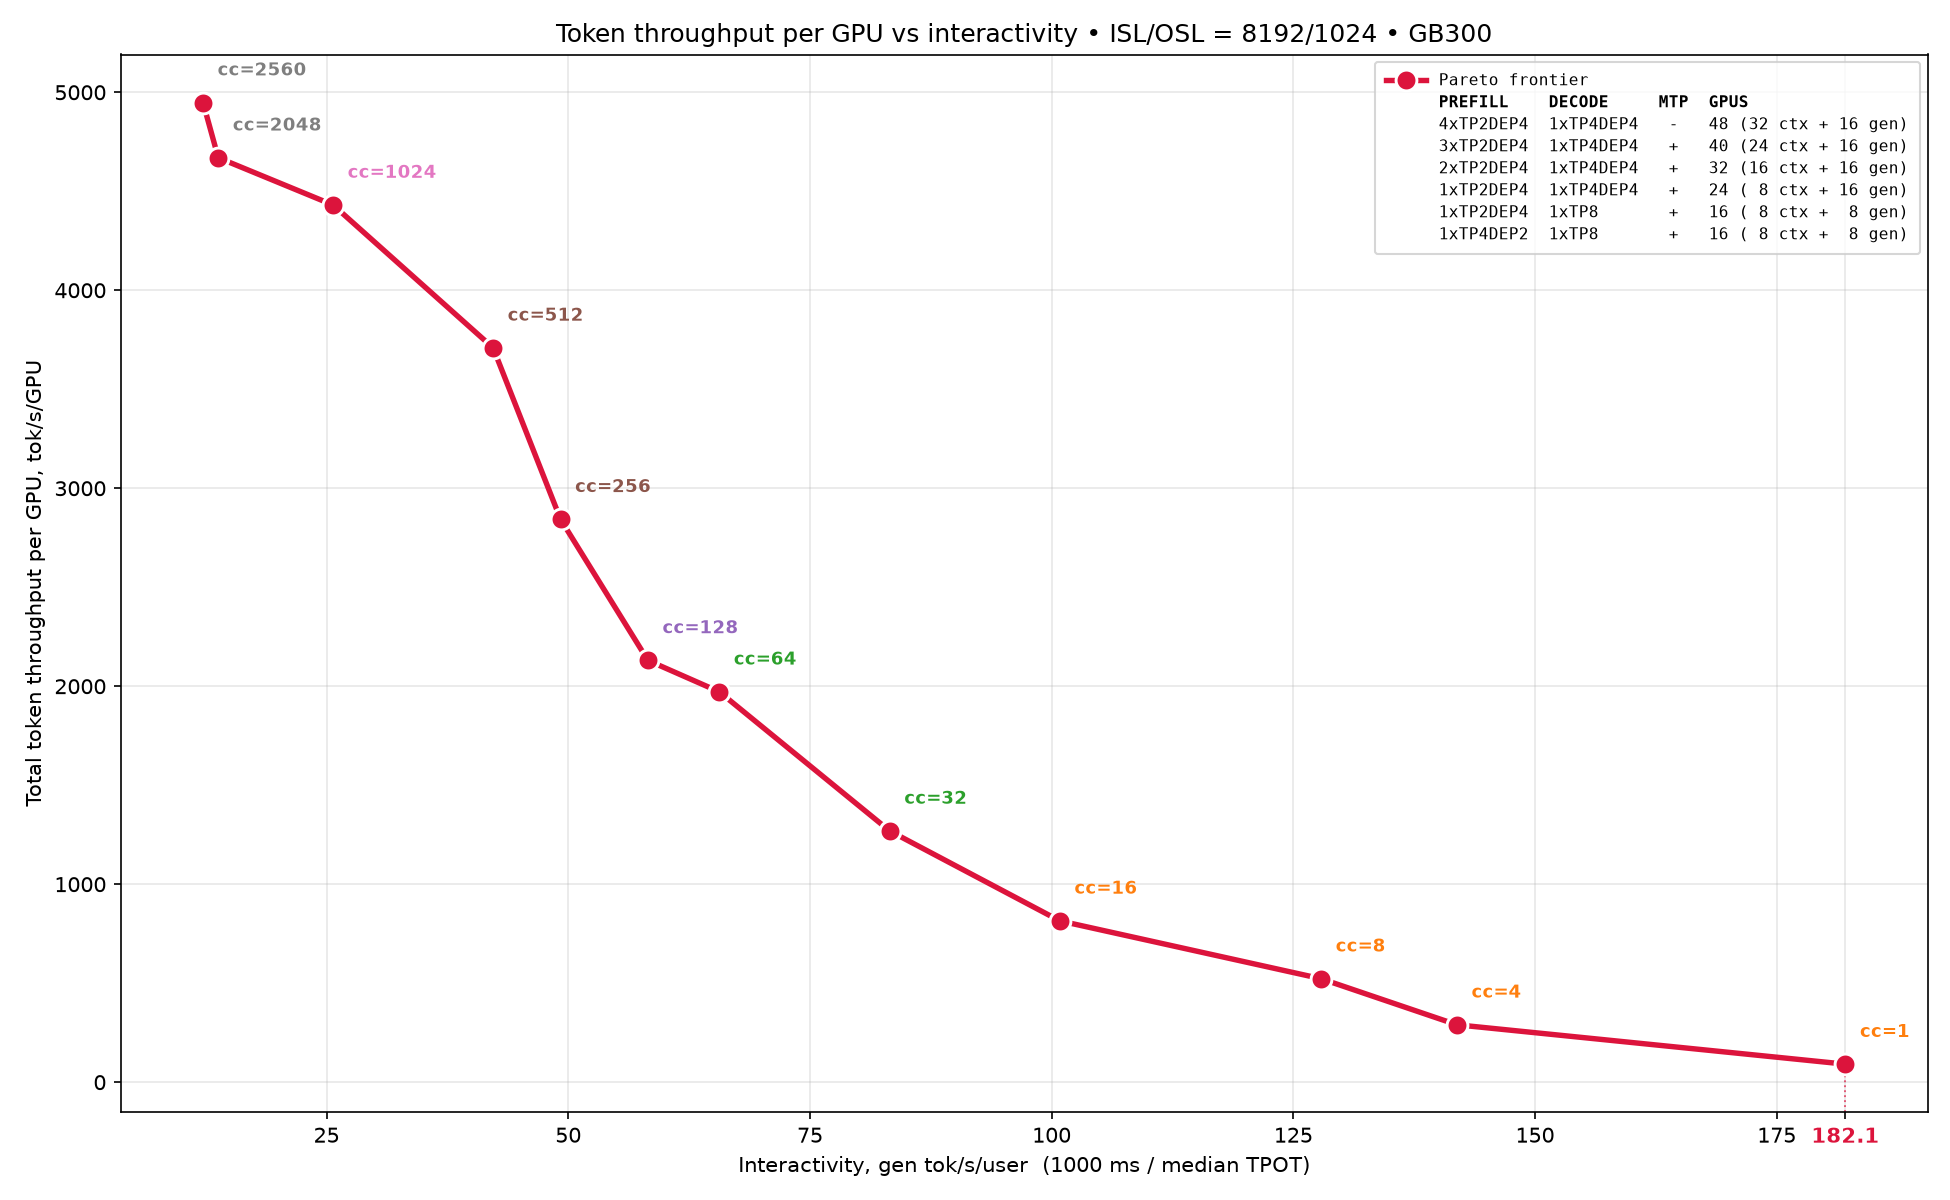
図 4:分離サービングの最終パレートフロンティア、ISL/OSL 8192/1024、GB300。
結論
このブログでは、Qwen シリーズのフロンティアモデルのパレート曲線を構築するといった複雑なタスクを、互いに独立した小さなステップに分解する方法を示しました。その結果、GPU あたり 5K の総トークンスループットと、180 gen tok/s/user の対話性を達成しています。
謝辞
Artem Perevedentsev(NVIDIA)、Vadim Gimpelson(NVIDIA)、Xin Li(NVIDIA)
また、本ブログで触れた最適化の一部に貢献し、レビューに参加してくれた vLLM コミュニティのメンバーに感謝します。