Qwen3.8-2.4T 的 PD 分离部署
在 GB300 NVL72 上跑 Qwen3.8-2.4T 的 PD 分离部署:高吞吐场景每 GPU 达到 5,000 总 token,低延迟场景每用户 180 个生成 token,两端落在同一条帕累托前沿上。
中文
复制
摘要
本文介绍我们在 GB300 NVL72 集群上使用 vLLM 对 Qwen3.8-2.4T 模型进行 PD 分离式部署的最新性能结果,工作负载为 8K/1K。在高吞吐场景下,vLLM 达到每 GPU 5000 总 token 吞吐量;在低延迟场景下,每用户生成 180 个 token——两者均展示在下方的帕累托前沿上。本文将详细说明我们如何取得这些结果,并给出精确的 srt-slurm 配置方案,任何人都可以用它在本地部署中验证和复现。但更重要的是,我们会描述制定这些配置方案时的决策过程。这比性能结果本身更有价值,因为它让你能够为任意模型挖掘 vLLM PD 分离式部署的性能潜力。
引言
此前我们展示了 Qwen3.5 PD 分离式部署的结果,表明 vLLM 可以达到 25K Total TPS/GPU。紧接着,Qwen 系列又发布了一款前沿模型:Qwen3.8-2.4T。本文转向 Qwen3.8-2.4T 的 PD 分离式部署,并给出完整的帕累托前沿。 在之前对 Qwen3.5 的研究中,我们主要关注帕累托曲线左侧,目标是最大化 Total TPS/GPU。这次我们更进一步,构建完整的帕累托前沿,覆盖左侧(高吞吐)和右侧(低延迟)两部分。换句话说,除了面向吞吐的配置,我们还要找出最大化交互性(即每用户 Gen TPS)的最优 PD 配置方案。 同样重要的是,本文不只讲最终数字。我们还会逐步拆解调优过程:如何选择测量指标、如何定位瓶颈、如何迭代出更好的 PD 配置。我们的目标是让这套工作流程易于理解、可复用,帮助任何人为其他模型调优部署性能。
最大化吞吐
我们要最大化的第一个指标是每 GPU 总 token 吞吐量。这个指标取决于并发数:一个 decode 引擎同时处理的请求越多,吞吐量就越高。 限制并发数的是 KV cache 容量,因为每个活跃请求都占用其中一部分。因此,KV cache 大小是任何拓扑都要回答的第一个问题,它分为两部分:单个请求消耗多少 cache,以及加载模型权重、vLLM 服务器为自身工作分配空间之后,GPU 上还剩多少。本章其余部分将逐一分析这两部分,并推导出 Qwen3.8-2.4T 在单块 GB300 上理论上可达的最大并发数。
单请求的 KV cache 估算
Qwen3.8-2.4T 有 92 层:69 个 GDN 层和 23 个 Full-Attn 层,每一层都带一个 MoE 块(92 × 512 个 expert)。GDN 和 Full-Attn 是 BF16,MoE 是 NVFP4。权重分类如下:
- 91 GiB —— 模型的非 expert 权重(GDN 权重 60 GiB,Full-Attn 权重 19 GiB)
- 1242 GiB —— 模型的 expert 权重
Qwen3.8-2.4T 是混合模型,所以它的 state 分两部分,计算方式差别很大:Full-Attn state 随每个 token 增长,GDN state 则按请求存储。 Full-Attn state 按 token 存储。一个 token 每层需要 2 KiB:
Full-Attn state per token:num_key_value_heads 4 × head_dim 256 × float8_e4m3fn 的 1 字节,K 和 V 再乘 2,得 2048 B = 2 KiB。
GDN state 按请求存储,而不是按 token,这一点很重要。它由两部分组成。
- Conv state —— 因果卷积最后 kernel-1 个输入,每个通道一个 filter,通道是 q、k、v 拼接而成:
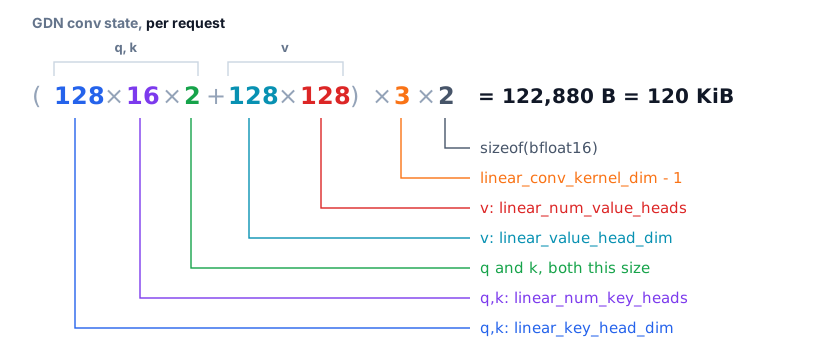
GDN conv state per request:q 和 k 为 linear_key_head_dim 128 × linear_num_key_heads 16 × 2,v 为 linear_value_head_dim 128 × linear_num_value_heads 128;全部乘以 linear_conv_kernel_dim 减 1(即 3),再乘 bfloat16 的 2 字节,得 122,880 B = 120 KiB。
- SSM state —— 保存整个上下文的循环矩阵:
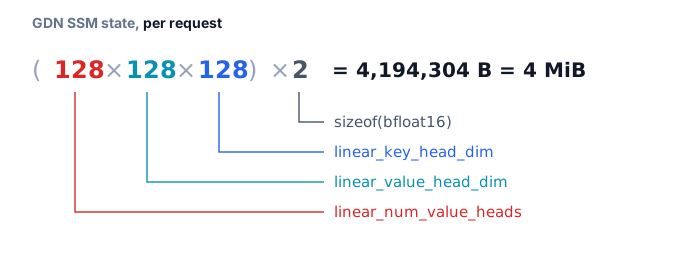
GDN SSM 单请求状态:linear_num_value_heads 128 × linear_value_head_dim 128 × linear_key_head_dim 128,bfloat16 下每元素 2 字节,得到 4,194,304 B = 4 MiB。
合计下来,GDN 状态需要 4 MiB + 120 KiB = 4216 KiB。
vLLM 按块分配 KV cache,块必须大到足以容纳单个 GDN 状态,或若干个 Full-Attn 状态。对 Qwen3.8-2.4T 来说,GDN 状态比 Full-Attn 状态大 4216 KiB / 2 KiB = 2108 倍。于是块大小由 GDN 状态决定,并按 16 字节对齐,因此一个块能放下 align(2108, 16) = 132 * 16 = 2112 个 token,块大小为 2112 × 2 KiB = 4.125 MiB。
分离式部署有一点要注意:prefill 和 decode 各自独立计算块大小,但 KV cache 传输要求两边一致。如果不一致,就手动把 --block-size 设成足以在两侧容纳 GDN 状态的值,代价是浪费一些 KV cache 空间。
算出了单个块的大小,就能知道一个完整请求占用多少 KV cache,进而估算测量中能期望的最大并发数。这个计算需要先做负载估计。我们固定 ISL=8192、OSL=1024,也就是所谓长 ISL、decode 受限的测试场景。
一个请求占用 ISL、OSL,外加一小块为 OpenAI API 请求所用 chat template 预留的空间。每块 2112 个 token、23 层 Full-Attn、69 层 GDN,单请求开销可以这样算:
Full-Attn 状态随 token 数增长,所以 23 层中每层每 2112 个 token 需要一个块。GDN 状态每个请求固定,所以 69 层中每层恰好需要一个块。把总量拆到这两部分:
KV cache 用的是模型加载和所有其他预留之后剩下的 GPU 显存,所以第一步是弄清每一个会分配显存的内存占用方。
KV cache 容量
GB300 一开始给我们 279 GB。驱动开销先占 2.28 GiB,于是 vLLM 启动时总共有 276.62 GiB。在 vLLM 服务器启动之前,CUDA context 已经占掉约 3.13 GiB。这块内存我们完全无法控制,也没有办法调整。
除此之外,vLLM 默认从 276.62 GiB 这个基数里预留 8%,用于无法提前预测的部分——激活内存峰值之类。这就是 gpu_memory_utilization 这个设置控制的东西。到这里只剩约 254 GiB。
另外 2.90 GiB 进了 NCCL buffer、分配器以及其他与 PyTorch 无关的东西。所以在加载权重之前,我们有 276.62 × 0.92 − 3.13 − 2.90 = 248 GiB。
峰值激活内存
权重加载完成后,vLLM 会测量模型在 eager 模式下单步执行所消耗的内存——即不使用 CUDA graphs 的情况。这一步必不可少,因为 CUDA graphs 本身有大小上限,而推理时的 batch size 可能超过这个上限,此时无论如何都得把前向跑完,只能退回 eager 模式。这类情况会导致性能下降,当然应尽量避免,但实践中无法保证运行时永远不会出现。测量 eager 模式时使用 max_num_batched_tokens 个 token,这样测出的是最坏情况下的激活峰值。
估算内存消耗最简单的办法,是用 aggregated 模式对你关心的 decode 拓扑跑几次测试。本文涉及的拓扑,每个 engine 的激活峰值如下:
| 运行 | 拓扑 | MTP | max-num-seqs | max-num-batched-tokens | 激活峰值 (GiB) |
|---|---|---|---|---|---|
| 1 | TP8 | + | 20 | 96 | 0.57 |
| 2 | TP8 | + | 32 | 144 | 0.58 |
| 3 | TP8 | + | 80 | 336 | 0.56 |
| 4 | TP8 | + | 272 | 1104 | 1.91 |
| 5 | TP4DP4 | + | 80 | 336 | 1.72 |
| 6 | TP4DP4 | + | 272 | 1104 | 2.24 |
| 7 | TP4DP4 | − | 528 | 544 | 1.83 |
| 8 | TP4DP4 | − | 656 | 672 | 2.15 |
CUDA graphs
接下来,vLLM 会捕获 CUDA graphs。graph 所需的内存必须预先分配在固定地址上,也就是说,这部分内存在 graph 被捕获之前就得估算出来。
目前 vLLM 的做法是这样的。首先枚举服务器配置下所有可用的 graph 尺寸。同一时刻只能重放一个 graph,而 graph 越大,峰值内存占用越高——所以至少得给最大的那个留出空间。接下来的问题是其余 graph 还需要多少额外内存,而这里的情况和 eager 运行不同:一个 graph 捕获完成后,重放它会复用完全相同的地址。再把第二大的 graph 也捕获进来,你会发现它在第一个 graph 已占用的内存之上还要额外占用一部分。
为了节省预热时间,vLLM 随后做出如下假设:后续每个 graph 都会带来同样大小的增量。CUDA graph 所需内存按 计算,其中 是最大 graph 的内存, 是 graph 总数。由于 graph 使用静态地址,又无法在启动时全部捕获,我们只能先用这个估算值把整块内存提前占下来。
实际中,这个估算值往往大幅超过 graph 真正需要的内存。想自己测一测,可以在 aggregated 模式下用 compilation-config: '{"cudagraph_mode": "FULL_DECODE_ONLY"}' 配合 max-cudagraph-capture-size 对 decode 拓扑做试运行。
本文涉及的这些拓扑,在 FULL 模式下每个 engine 的内存占用如下:
| 运行 | 拓扑 | MTP | graph 数 | 预留 (GiB) | 实际使用 (GiB) | 从未使用 (GiB) | % |
|---|---|---|---|---|---|---|---|
| 1 | TP8 | + | 11 | 0.91 | 0.59 | 0.32 | 54% |
| 2 | TP8 | + | 17 | 1.28 | 0.82 | 0.46 | 56% |
| 3 | TP8 | + | 37 | 1.87 | 1.88 | −0.01 | −1% |
| 4 | TP8 | + | 85 | 7.93 | 6.04 | 1.89 | 31% |
| 5 | TP4DP4 | + | 37 | 8.35 | 6.52 | 1.83 | 28% |
| 6 | TP4DP4 | + | 85 | 7.56 | 9.90 | −2.34 | −24% |
| 7 | TP4DP4 | − | 52 | 8.29 | 7.51 | 0.78 | 10% |
| 8 | TP4DP4 | − | 60 | 8.95 | 8.07 | 0.88 | 11% |
这张表也顺带说明了 gpu_memory_utilization 预留为什么存在。在上面某些运行里,graph 实际使用的内存超过了初始估算,而多出来的这块预留正好避免了这种情况演变成 OOM。
需要注意,留给 KV cache 的内存空间取决于 CUDA graph 的估算值,而不是 graph 运行时实际用了多少,所以 KV cache 的大小直接取决于这个估算有多准。在我们这里它估得不错,但如果你想优化最终的百分比,大概应该手动估算 graph 大小。vLLM 的 graph 估算机制确实值得进一步研究和改进,因为随着 Qwen3.8、Kimi-K3、DSV4 这类超万亿参数前沿模型的出现,这个问题正变得越来越紧迫。
每个引擎的最大并发数
现在把前面所有结果汇总起来,算一算 vLLM 在我们的模型上每个引擎能处理多少请求。前面说过,GB300 给我们 276.62 GiB。其中一部分内存被 gpu_memory_utilization 占用。在我们的场景里用的是默认值 gpu_memory_utilization=0.92。所以每个引擎初始可用内存是 276.62 GiB × 0.92 = 254.5 GiB。
下表中除最后一列外都是实测值:这些数字来自 vLLM 服务器启动时的报告。最后一列由它们推导而来——用 KV cache 大小除以单个请求所需的 759 MiB,即上文“单个请求的 KV cache 估算”中算出的值:
这只是一次普通除法,并且有意忽略了 MTP 为投机 token 预留的额外 KV 槽位,所以对 MTP 那几行,应把它看作上限,而不是实际能达到的并发数。
| 运行 | 拓扑 | MTP | CUDA ctx (GiB) | non-torch (GiB) | 权重 (GiB) | 峰值激活 (GiB) | 图估算 (GiB) | KV cache (GiB) | 请求数/引擎 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | TP8 | + | 2.54 | 0.72 | 169.28 | 0.57 | 0.91 | 83.00 | 112.0 |
| 2 | TP8 | + | 2.54 | 0.72 | 169.28 | 0.58 | 1.28 | 82.63 | 111.5 |
| 3 | TP8 | + | 2.54 | 1.19 | 169.28 | 0.56 | 1.87 | 81.60 | 110.1 |
| 4 | TP8 | + | 2.54 | 2.40 | 169.28 | 1.91 | 7.93 | 72.97 | 98.4 |
| 5 | TP4DP4 | + | 3.13 | 1.98 | 108.71 | 1.72 | 8.35 | 133.74 | 180.4 |
| 6 | TP4DP4 | + | 3.13 | 2.22 | 108.71 | 2.24 | 7.56 | 133.77 | 180.5 |
| 7 | TP4DP4 | − | 3.13 | 2.90 | 107.51 | 1.83 | 8.29 | 133.96 | 180.7 |
| 8 | TP4DP4 | − | 3.13 | 3.03 | 107.51 | 2.15 | 8.95 | 132.85 | 179.2 |
从这张表可以得出几点观察。第一,在我们测过的每一种情况下,既不属于权重也不属于 KV cache 的那部分内存开销都在 ~20 GiB 左右,约占总可用内存的 7%。第二,留给模型权重的空间随拓扑变化相当大。要让每块 GPU 的总 token 吞吐最大化,就需要高并发,而并发最终受限于可用于 KV cache 的内存。想腾出更多内存,唯一的办法是压缩模型本身所需的部分——这正是追求最高并发时解码阶段应选 TP4DP4 拓扑的原因。
测量 prefill 性能
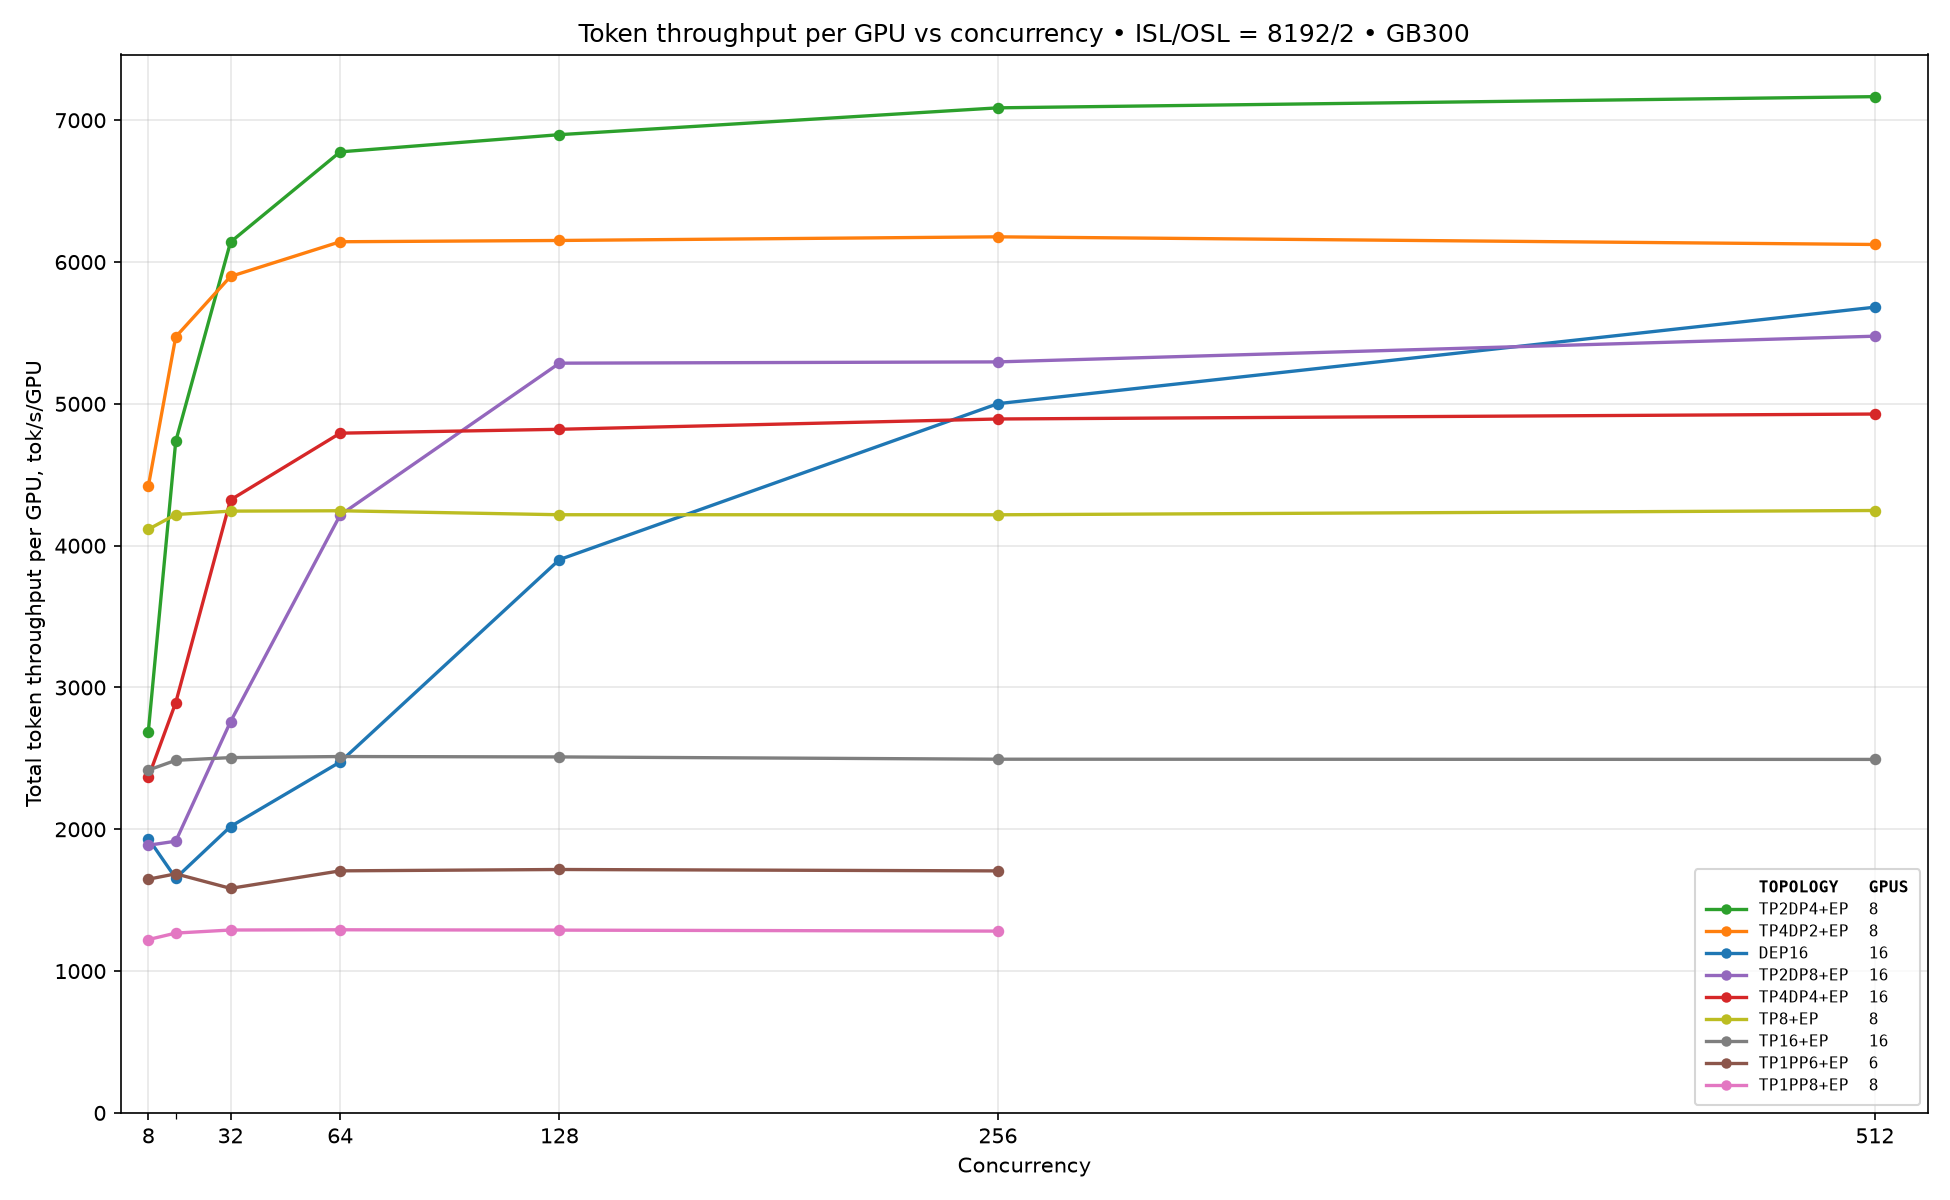
朝着目标迈出的下一个重要步骤,是把 prefill 性能与 decode 性能分开测量。具体做法是在 prefill-only 负载(ISL/OSL=8192/2)下运行聚合式服务,由此找出 disaggregated serving 中 prefill endpoint 应当选用的最佳拓扑。将 prefill-only 和 decode-only 负载分开测量,既能选出最佳拓扑,又能大幅减少评估 PD serving 性能所需的工作量。在我们的场景中,prefill 选用了以下拓扑:
- TP4DP2+EP
- TP2DP4+EP
- TP4DP4+EP
- TP2DP8+EP
- DP16+EP
- TP1PP6+EP
- TP1PP8+EP
- TP8+EP
- TP16+EP
测量结果如下:
图 1:GB300 上 ISL/OSL 8192/2 时,prefill 每 GPU 总 token 吞吐量随并发数的变化。
可以看到,低并发下 TP4DP2+EP 表现最好;并发数升高后,TP2DP4+EP 开始占据优势。
测量 decode 性能
decode 也做同样的处理:以 decode-only 负载(ISL/OSL=1/1000)运行聚合式服务。我们选用了以下拓扑:
- TP2DP4+EP
- TP4DP8+EP
- TEP8
- TEP16
此外,我们还尝试开启 MTP,使用 3 个 speculative token,这应当有助于取得更好的性能。
测量结果如下:
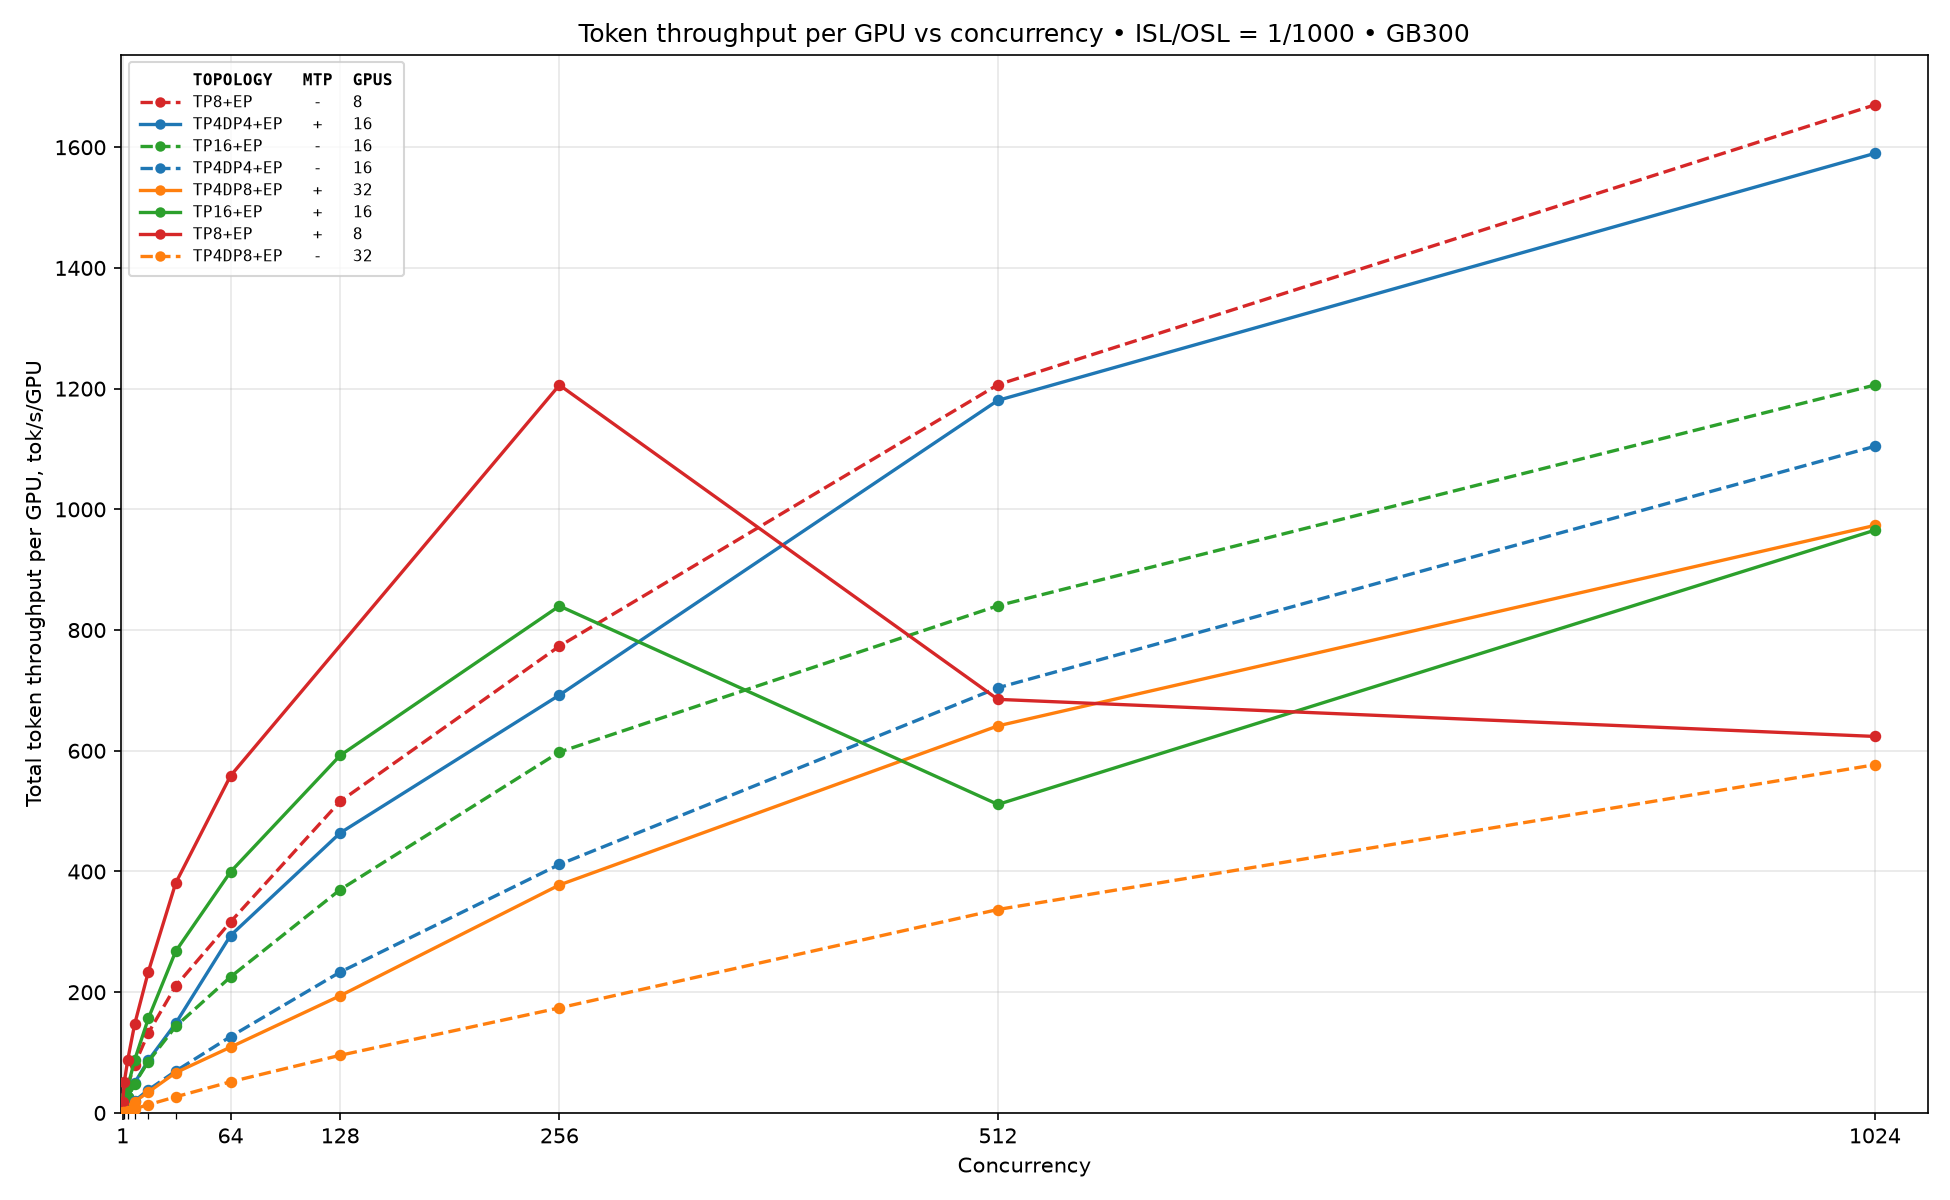
图 2:GB300 上 ISL/OSL 1/1000 时,decode 每 GPU 总 token 吞吐量随并发数的变化。
可以看到,首先,只要 KV cache 还有足够的可用空间,MTP 就能大幅提升性能。并发数较低时,最佳拓扑是 TEP8 加 MTP;并发数为 512 和 1024 时,TEP8 占优;而在高并发下,TP4DP4+EP 胜过其他所有拓扑,因为它相比 TEP8 有更多 KV cache 空间。
现在,进行分离式帕累托测量所需的一切都已就绪。
分离式性能结果
环境配置
测量在通过 NVLink72 互联的 GB300 集群上进行。我们采用 ISL/OSL = 8192/1024,并发数从 1 到 2560。性能在固定的 decode 拓扑和固定的 decode endpoint 数量下测量。在该配置中,decode 侧使用一个 endpoint,配备 8 或 16 块 GPU:
- 1×TEP8
- 1×TP4DP4+EP
在 prefill 侧,我们评估了从 1 到 4 个 endpoint 的配置,每个使用 8 到 32 块 GPU:
- 1×TEP8
- 1×TP4DP2+EP
- {1,2,3,4}×TP2DP4+EP
要复现结果,请使用 Qwen3.8-2.4T NVFP4 模型、最新的 vLLM vllm/vllm-openai:nightly-a9a17 Docker 镜像(vLLM revision v0.26.1rc1.dev1177+ga9a17e709)、Dynamo 1.2.0.dev20260526、srt-slurm v1.0.98 以及 AIPerf 工具。本博文中使用的所有 recipe 均可在 srt-slurm-recipes 仓库 中找到。
精度结果
我们首先对所有选定的 PD 服务配置进行了精度验证。同一仓库中提供了精度 recipe,你可以用 srt-slurm 自行运行。我们使用标准的 GSM8K(Grade School Math 8K)基准。每种 PD 配置的最终精度结果均为 95%。接下来就可以进行性能测量了。
性能结果
各配置的帕累托曲线如下所示。每条曲线都是单个部署在并发数上扫描得到的,因此每个点只有位于其曲线上的配置才能达到。
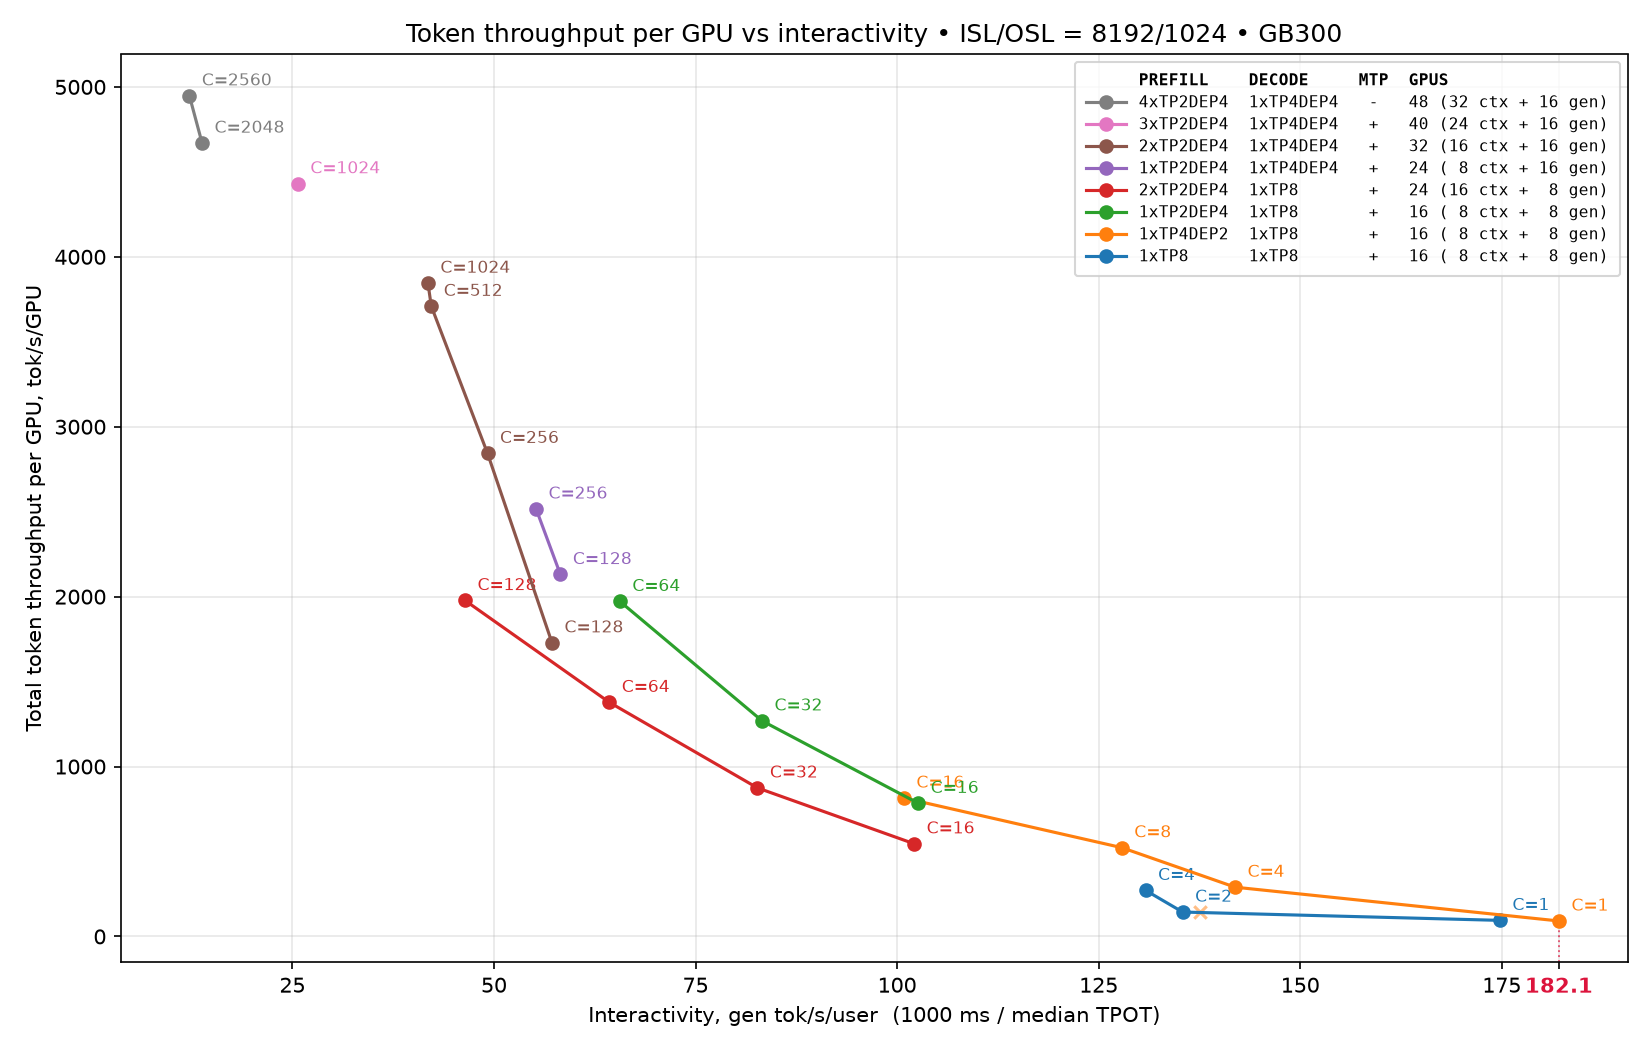
图 3:各分离式配置的帕累托曲线,ISL/OSL 8192/1024,GB300。
将它们全部合并,得到最终的帕累托前沿:
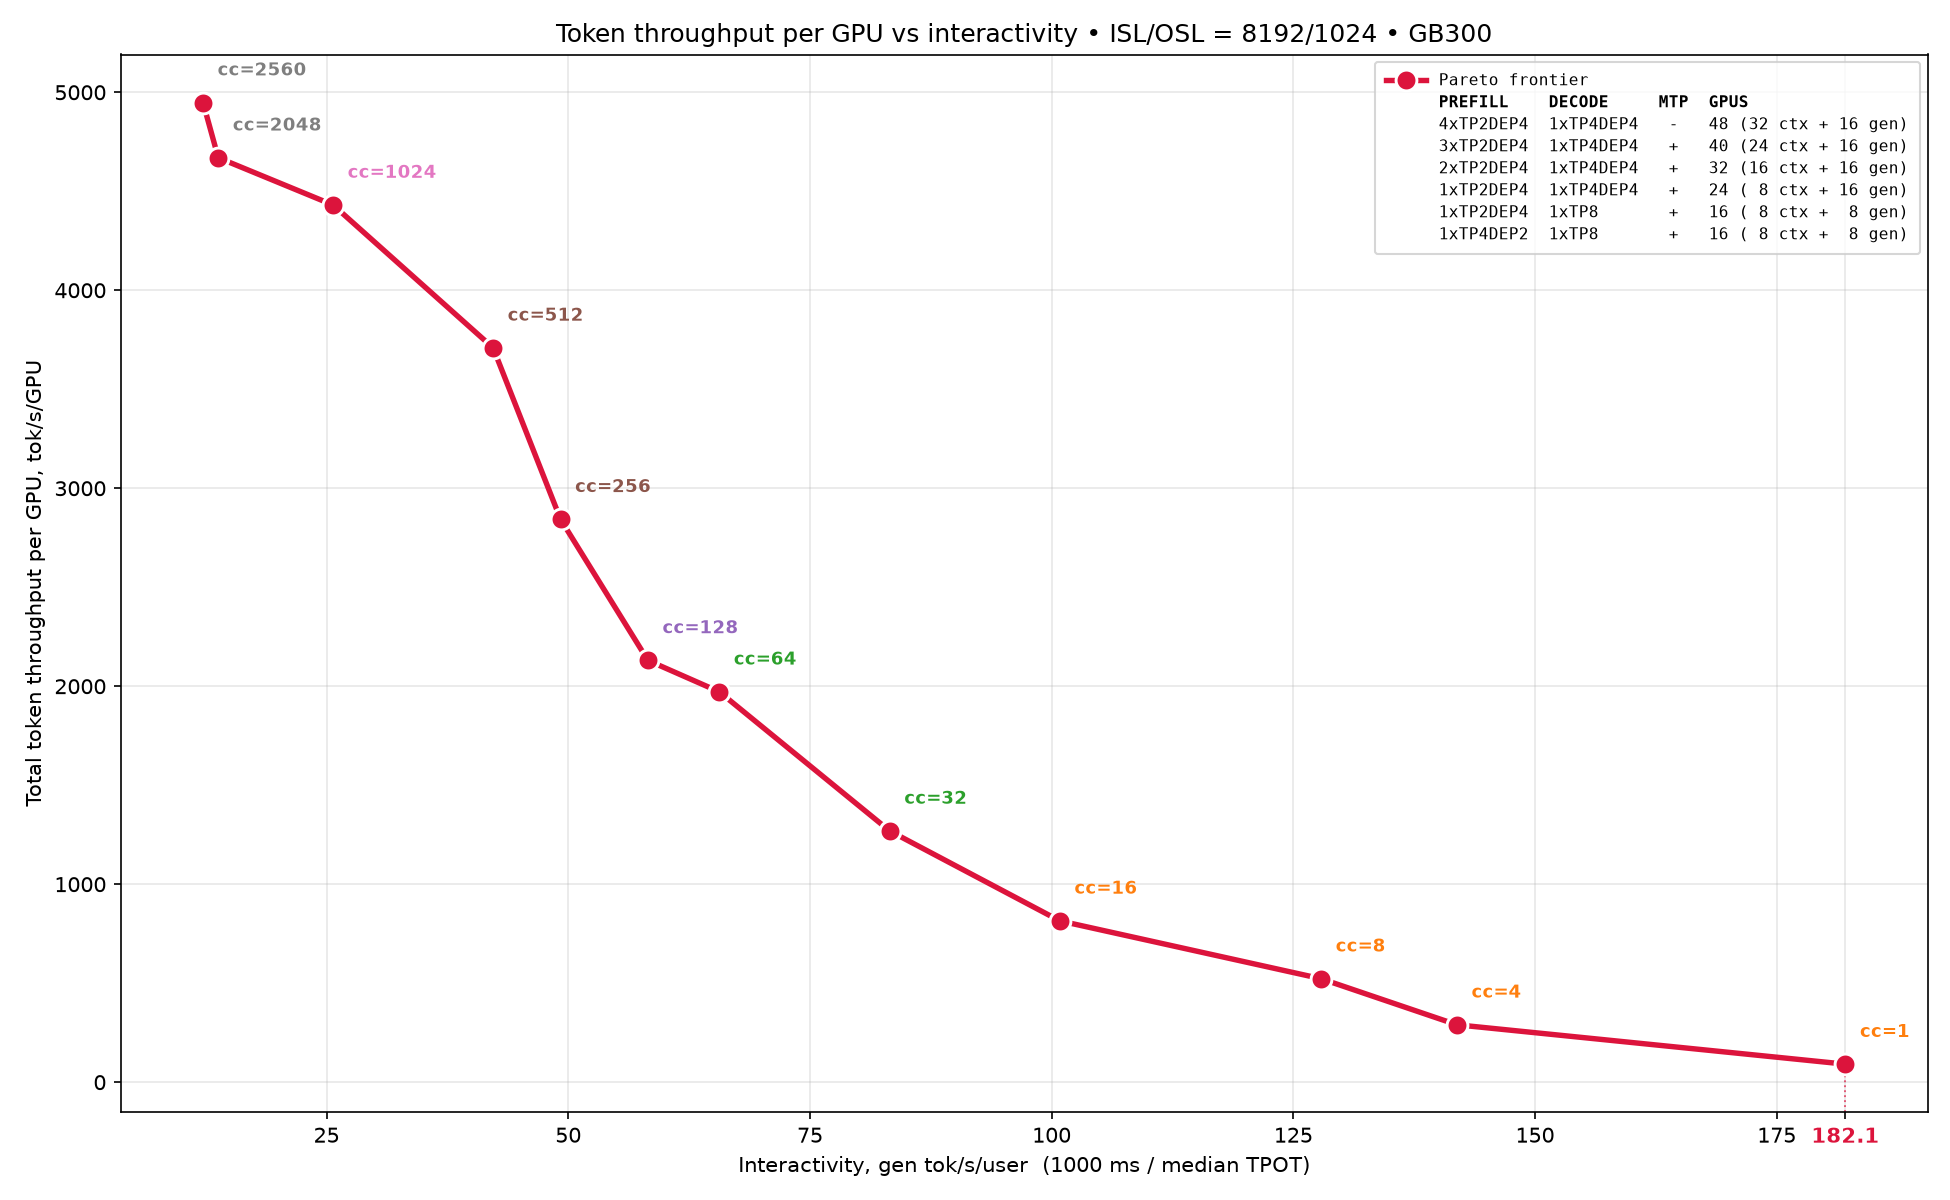
图 4:分离式服务的最终帕累托前沿,ISL/OSL 8192/1024,GB300。
结论
在这篇博客中,我们展示了如何将构建 Qwen 系列前沿模型 pareto 曲线这样复杂的任务,拆解为若干个相互独立的小步骤。最终,我们实现了每 GPU 5K 的总 token 吞吐量,以及 180 gen tok/s/user 的交互性。
致谢
Artem Perevedentsev(NVIDIA)、Vadim Gimpelson(NVIDIA)、Xin Li(NVIDIA)
同时感谢 vLLM 社区的成员,他们为本博客中提到的部分优化工作做出了贡献并参与了评审。