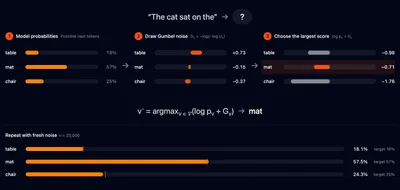
vLLMにおけるウォーターマーク技術
テキスト透かしは出力分布、堅牢性、検出コストの間でトレードオフが必要。vLLMの記事ではレッドグリーンリスト、Gumbelノイズサンプリングなど数種類の手法と、それぞれがどのような条件で破られるかを解説。
テキスト透かしは出力分布、堅牢性、検出コストの間でトレードオフが必要。vLLMの記事ではレッドグリーンリスト、Gumbelノイズサンプリングなど数種類の手法と、それぞれがどのような条件で破られるかを解説。
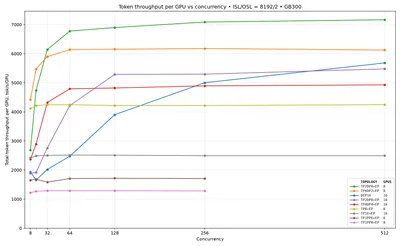
GB300 NVL72 上で Qwen3.8-2.4T を PD 分離でサービングした結果。高スループット側では GPU あたり毎秒 5,000 トークン、低遅延側ではユーザーあたり 180 トークンに達し、両端が同じパレート前沿に乗る。
vLLM が PyNvVideoCodec ハードウェアデコードを統合し、動画記述のスループットは 8 GPU ノードでも線形にスケールします。
Novita AIがChordをオープンソース化、W4A16 MoE CUDAカーネル群。公開されているHummingと比較し、層ごとの実測でH200ではレイテンシ最大1.33倍削減、未チューニングのB300では最大2.15倍削減。
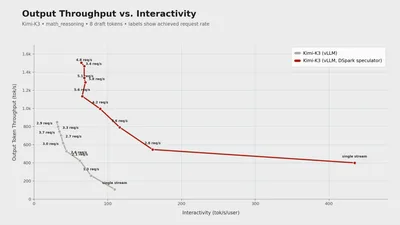
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。