PyNvVideoCodecとvLLMを使用したマルチGPUビデオ字幕生成のスケーリング
vLLM が PyNvVideoCodec ハードウェアデコードを統合し、動画記述のスループットは 8 GPU ノードでも線形にスケールします。
日本語
コピー
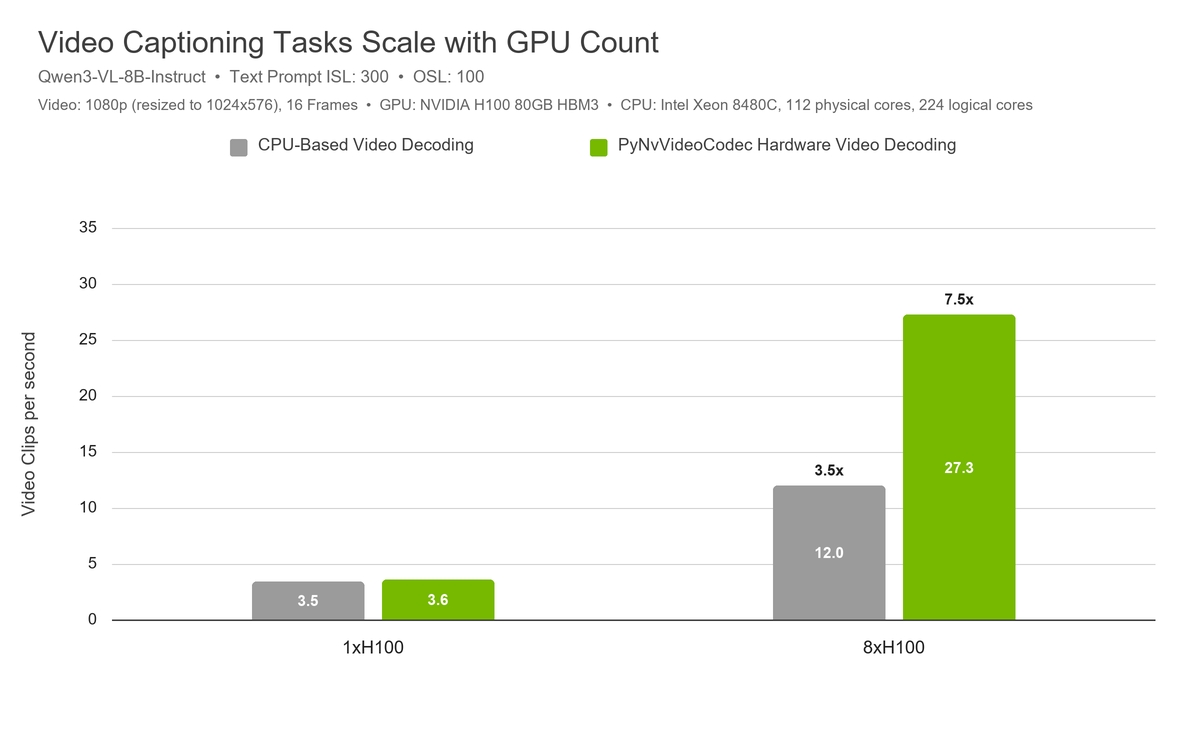
vLLM が NVIDIA GPU 内蔵のハードウェア動画デコードに対応したことをお知らせします。これまで CPU に律速されていた動画キャプションとアノテーションのタスクを、データセンター級のマルチ GPU ノードでスループットをスケールさせながら実行できるようになりました。
動画キャプションは、動画内で何が起きているかを説明する、多くの業界で一般的なタスクです。自動運転(AV)の学習システムでは、危険なシーンを説明・分類したり、検索可能な可読メタデータを生成したりするために使われています。
これまで vLLM でこうしたデータセットを処理するには、CPU ベースの OpenCV+FFMPEG バックエンドでしかデコードできない動画を送る必要がありました。マルチ GPU ノードでこの種の VLM(GPU 1 枚につき vLLM サーバー 1 つ)を動かすと、VLM の推論が始まる前に CPU が動画フレームのデコードで悲鳴を上げます。動画キャプションの出力は比較的短く(100〜200 token)、動画デコードが占める時間の割合はそれだけ大きくなるため、CPU ベースの動画デコードはすぐにボトルネックになります。GPU が 2 枚や 4 枚でも CPU コアを使い切ってしまいます。
NVIDIA のハードウェア動画デコーダ(別名「NVDEC」)の Python インターフェースである PyNvVideoCodec を統合することで、vLLM はこの動画デコードの負荷を CPU からオフロードし、ボトルネックを解消できます。8 枚の GPU までスケールさせても良好なスケーラビリティを維持します。
以下はこのタスクの入力プロンプトと出力の例です(実際のプロンプトはもっと長く、構造も複雑です)。
入力プロンプトの例
この前方ドライブレコーダーの映像を分析してください。走行環境、関連する道路利用者と交通制御施設、自車の動作を簡潔に説明してください。はっきりと見える詳細だけを報告し、推測はしないでください。
出力の例
自車は昼間、複数車線の市街路を良好な視界で走行している。前方の同一車線と隣接車線に複数の車両があり、信号で制御された交差点が 1 か所見える。自車は車線を維持し、車流に近づくと減速し、その後は前車との車間を保って走行を続ける。
vLLM で NVIDIA ハードウェア動画デコードを使う
依存関係のインストール
標準の CUDA 版 vLLM には PyNvVideoCodec が提供する機能がすでに組み込まれています。自分でビルドした vLLM を使う場合は、プロジェクトの PyPi 依存関係に PyNvVideoCodec==2.0.4 が含まれていることを確認してください。
PyNvVideoCodec 動画デコーダを有効にして vLLM を起動する
# First launch CUDA MPS Daemon
nvidia-cuda-mps-control -d

# Launch vLLM with pynvvideocodec video backend
vllm serve Qwen/Qwen3-VL-8B-Instruct \
 --dtype bfloat16 \
 --max-model-len 32768 \
 --max-num-seqs 1024 \
 --max-num-batched-tokens 32768 \
 --api-server-count 4 \
 --renderer-num-workers 4 \
 --async-scheduling \
 --mm-ipc-gpu-memory-gb 2 \
 --media-io-kwargs \ '{"video":{"backend":"pynvvideocodec","min_frames":16,"max_frames":16,"hw_decoders":2}}' \
 --mm-processor-kwargs \
 '{"size":{"shortest_edge":65536,"longest_edge":9437184}}'
マルチプロセスで高並列なワークロード(バッチ VLM 推論など)で性能を引き出すには、CUDA MPS が欠かせません。vllm serve を実行する前に、MPS Daemon が起動していることを確認してください。
--mm-ipc-gpu-memory-gb は動画デコード用に VRAM を確保するために使います。異なる値でスループットを試し、スループットに影響しない最小値を採用するとよいでしょう。PyNvVideoCodec デコーダバックエンド関連のパラメータの詳細は vLLM のドキュメント を参照してください。
マルチ GPU にスケールさせる場合、通常は vLLM サーバーのレプリカごとに 1 コンテナを動かし、各コンテナに GPU を 1 枚だけ見せる構成を推奨します。別の方法として、CUDA_VISIBLE_DEVICES で vLLM レプリカごとに GPU を 1 枚見せることもできます。レプリカ間のリクエスト分散はリバースプロキシで行います。
動画キャプションタスクでのマルチ GPU スケーリング
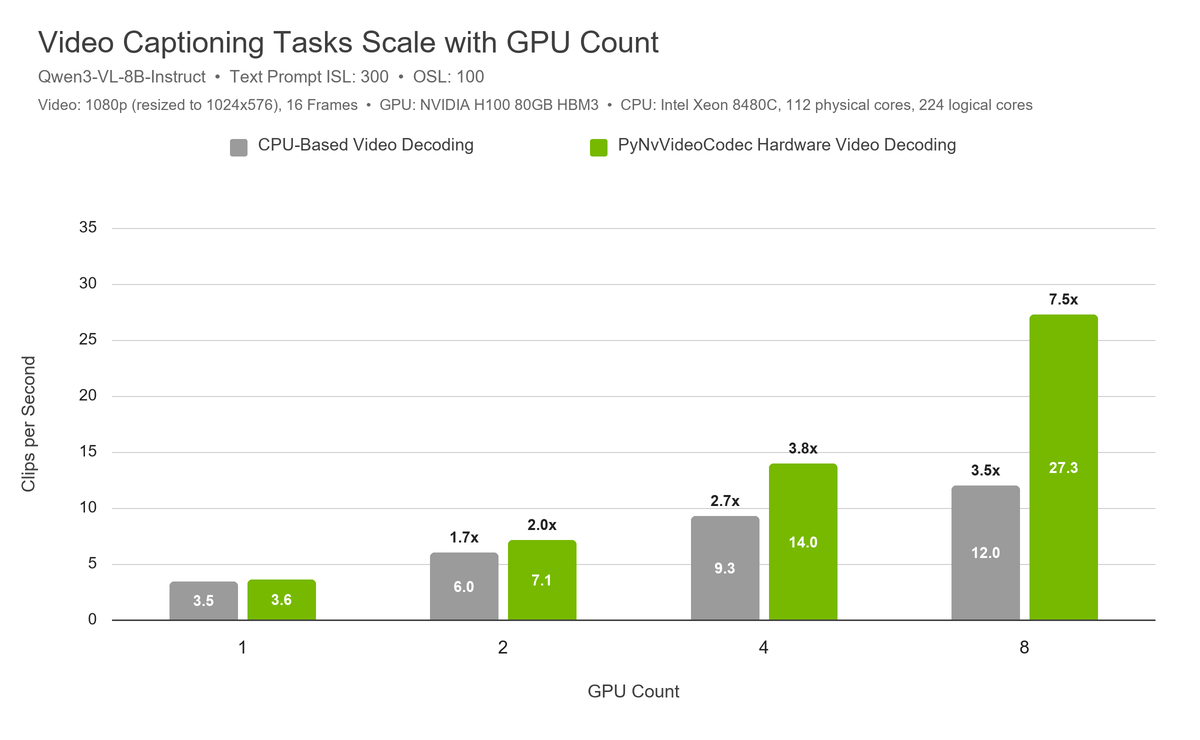
図 1:H100 GPU におけるマルチ GPU スケーラビリティの向上。8xH100 構成では、GPU ベースの動画デコードのスループットは CPU 動画デコーダの 2 倍以上になります。vLLM レプリカ 8 個、各レプリカに GPU 1 枚。
この手法の効果を示すために、NVIDIA の AV チームが使っている動画キャプションタスクを例に取ります。これらのシステムは数十万時間分の動画クリップのキャプションを生成し、累計で数億件の動画キャプションリクエストを処理します。こうしたタスクでは通常、比較的軽量なモデル(たとえば Qwen/Qwen3-VL-8B-Instruct)を使い、入力プロンプトで必要なキャプションの種類を指定し、出力は 100〜200 token 程度になります。
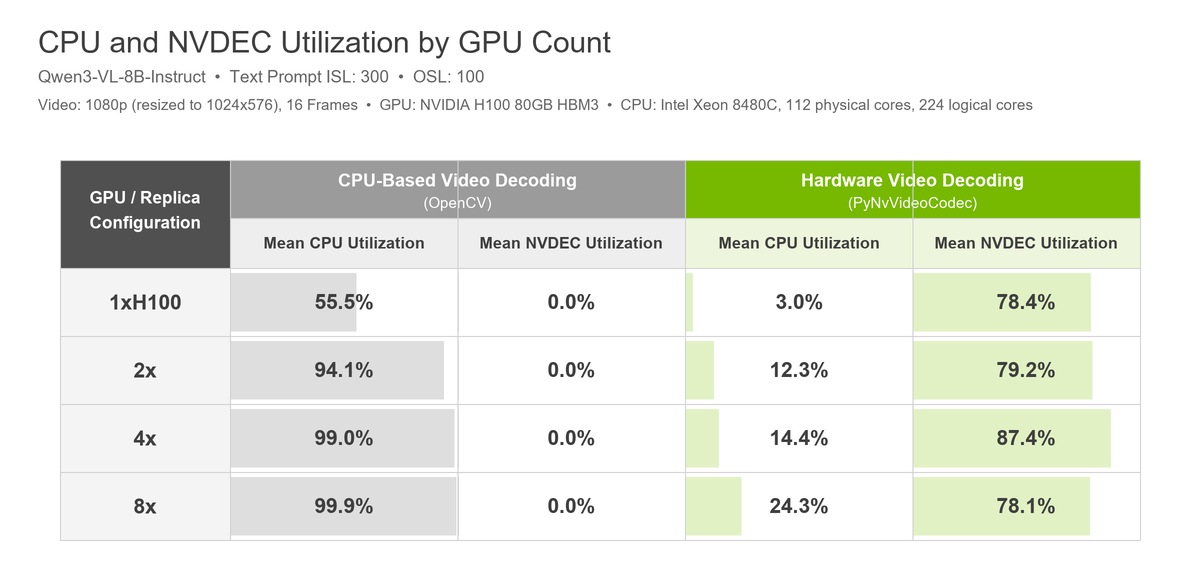
図 2:以前は 8 枚の GPU を使う大規模ワークロードでも、GPU 4 枚に届く前に CPU 使用率のボトルネックに当たっていました。ハードウェア動画デコード対応により、この CPU ボトルネックは解消されています。データはベンチマークの定常状態で取得。
注意点
動画デコードには一定の VRAM 確保が必要です。ユースケースですでに VRAM をすべて KV cache に使っている場合、多少の影響を受ける可能性があります。実際のテストでは、PyNvVideoCodec の使用によって性能が低下したケースはこれまでありません。
謝辞
vLLM へのハードウェア動画デコード対応に貢献してくださったすべての方に感謝します。
- NVIDIA:
NVCV チーム:Brandon Pelfrey、Benjamin Chislett、Dhaval Suthar、Jeremy Bottleson、Ernesto Zamora Ramos、David Lesage
- PyNvVideoCodec チーム:Rohit Naskulwar、Jayant Mukundam、Hareshkumar Borse
vLLM チームとコミュニティ: Roger Wang、Nick Hill、Cyrus Leung、Zifeng Mo