使用PyNvVideoCodec和vLLM扩展多GPU视频字幕生成
vLLM 集成 PyNvVideoCodec 硬件解码,视频描述吞吐量在 8 块 GPU 节点上仍可线性扩展。
中文
复制
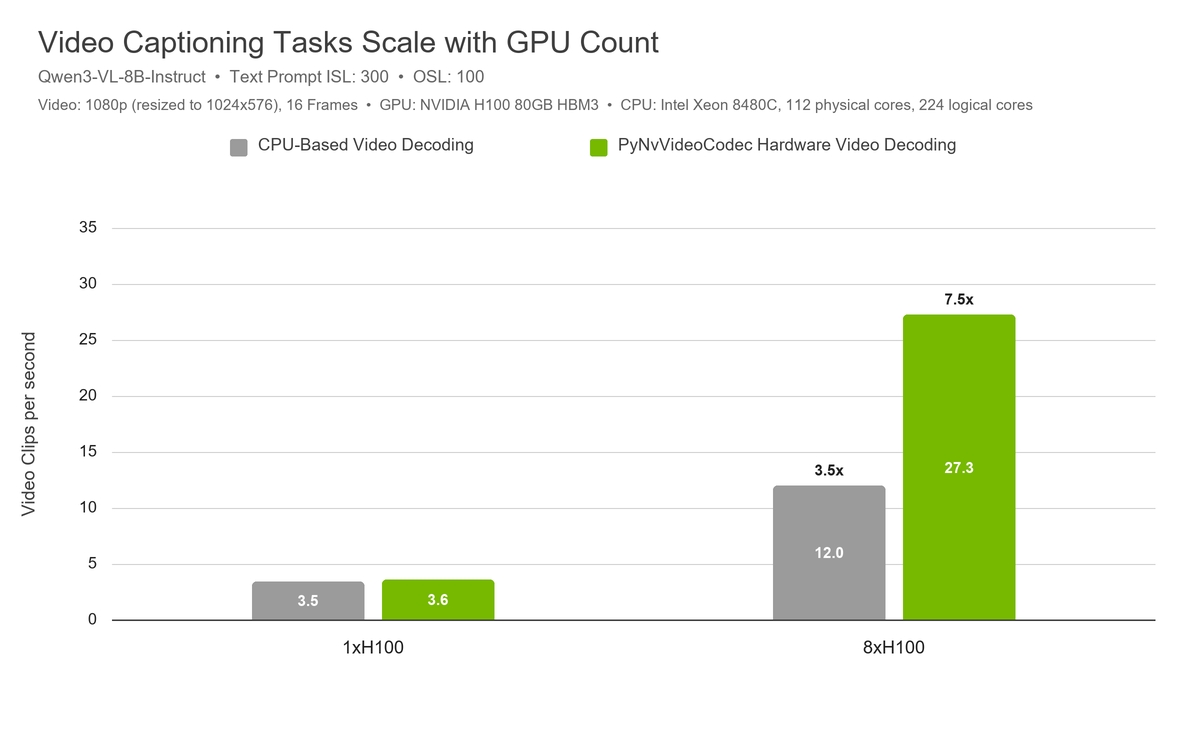
我们很高兴地宣布,vLLM 现已支持 NVIDIA GPU 内置的硬件视频解码,使此前受限于 CPU 的视频描述与标注任务,得以在数据中心级多 GPU 节点上扩展吞吐量。
视频描述是许多行业的常见任务,用于说明视频中正在发生什么。自动驾驶(AV)训练系统借此描述并分类危险场景、生成可读且可检索的元数据,等等。
此前,vLLM 处理这类数据集时,需要发送只能通过基于 CPU 的 OpenCV+FFMPEG 后端解码的视频。在多 GPU 节点上运行这类视觉语言模型(VLM,每块 GPU 一个 vLLM 服务)时,VLM 推理尚未开始,CPU 就已承受沉重的视频帧解码压力。视频描述的输出相对较短(100–200 token),解码视频所占的时间比例因此大得多,基于 CPU 的视频解码很快就会成为瓶颈——哪怕只有 2 块或 4 块 GPU,也能把 CPU 核心跑满。
通过集成 PyNvVideoCodec——NVIDIA 硬件视频解码器(又称“NVDEC”)的 Python 接口——vLLM 可以把这部分视频解码负载从 CPU 上移走,消除上述瓶颈,即便扩展到 8 块 GPU 也能保持良好的扩展性。
以下是该任务的输入提示与输出示例(真实提示更长、结构更复杂):
输入提示示例
分析这段前向行车记录仪视频。简要描述驾驶环境、相关道路使用者与交通控制设施,以及自车的动作。只报告清晰可见的细节,不要臆测。
输出示例
自车在白天沿多车道城市道路行驶,能见度良好。前方同车道及相邻车道有多辆车,可见一处信号控制交叉口。自车保持本车道行驶,接近车流时减速,随后继续行驶并与前车保持距离。
在 vLLM 中使用 NVIDIA 硬件视频解码
安装前置依赖
标准 CUDA 版 vLLM 已经内置了 PyNvVideoCodec 提供的功能!如果你用的是自行编译的 vLLM,请确认项目的 PyPi 依赖中包含 PyNvVideoCodec==2.0.4。
启用 PyNvVideoCodec 视频解码器启动 vLLM
# First launch CUDA MPS Daemon
nvidia-cuda-mps-control -d

# Launch vLLM with pynvvideocodec video backend
vllm serve Qwen/Qwen3-VL-8B-Instruct \
 --dtype bfloat16 \
 --max-model-len 32768 \
 --max-num-seqs 1024 \
 --max-num-batched-tokens 32768 \
 --api-server-count 4 \
 --renderer-num-workers 4 \
 --async-scheduling \
 --mm-ipc-gpu-memory-gb 2 \
 --media-io-kwargs \ '{"video":{"backend":"pynvvideocodec","min_frames":16,"max_frames":16,"hw_decoders":2}}' \
 --mm-processor-kwargs \
 '{"size":{"shortest_edge":65536,"longest_edge":9437184}}'
在多进程高并发场景下(比如批量 VLM 推理),要想跑出理想性能,CUDA MPS 必不可少。执行 vllm serve 之前,建议先确认 MPS Daemon 已启动。
--mm-ipc-gpu-memory-gb 用于为视频解码预留显存。你可以在不同取值下测试吞吐,只保留不影响吞吐的最小值。关于 PyNvVideoCodec 解码器后端相关参数的更多说明,参见 vLLM 相关文档。
扩展到多 GPU 时,通常建议每个 vLLM server 副本运行一个容器,每个容器只暴露一块 GPU。另一种做法是用 CUDA_VISIBLE_DEVICES 为每个 vLLM 副本暴露一块 GPU。副本之间的请求分发通过反向代理完成。
视频描述任务中的多 GPU 扩展
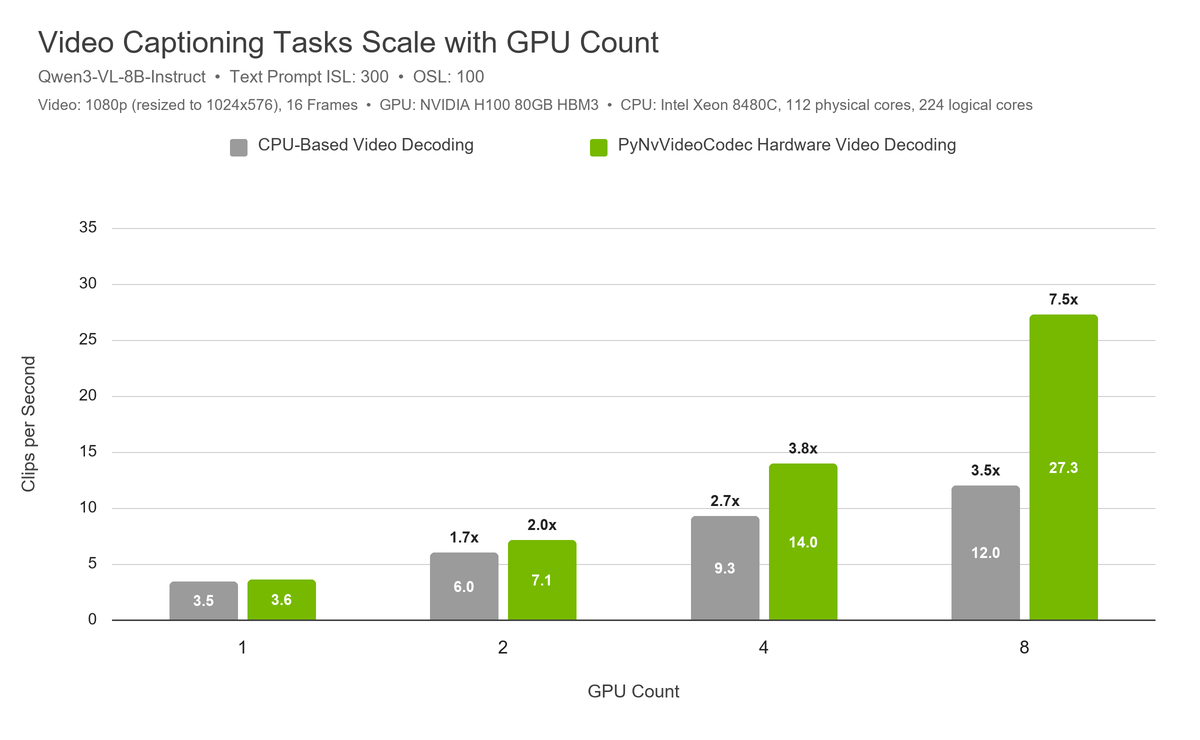
图 1:H100 GPU 上多 GPU 扩展性的提升。在 8xH100 配置下,基于 GPU 的视频解码吞吐量是 CPU 视频解码器的两倍以上。8 个 vLLM 副本,每个副本一块 GPU。
为了说明这种方法的收益,我们以 NVIDIA AV 各团队使用的视频描述任务为例。这些系统负责为数十万小时的视频片段生成描述,累计要处理数亿次视频描述请求。这类任务通常使用相对轻量的模型(例如 Qwen/Qwen3-VL-8B-Instruct),输入 prompt 会指定所需的描述类型,输出规模在 100–200 token 左右。
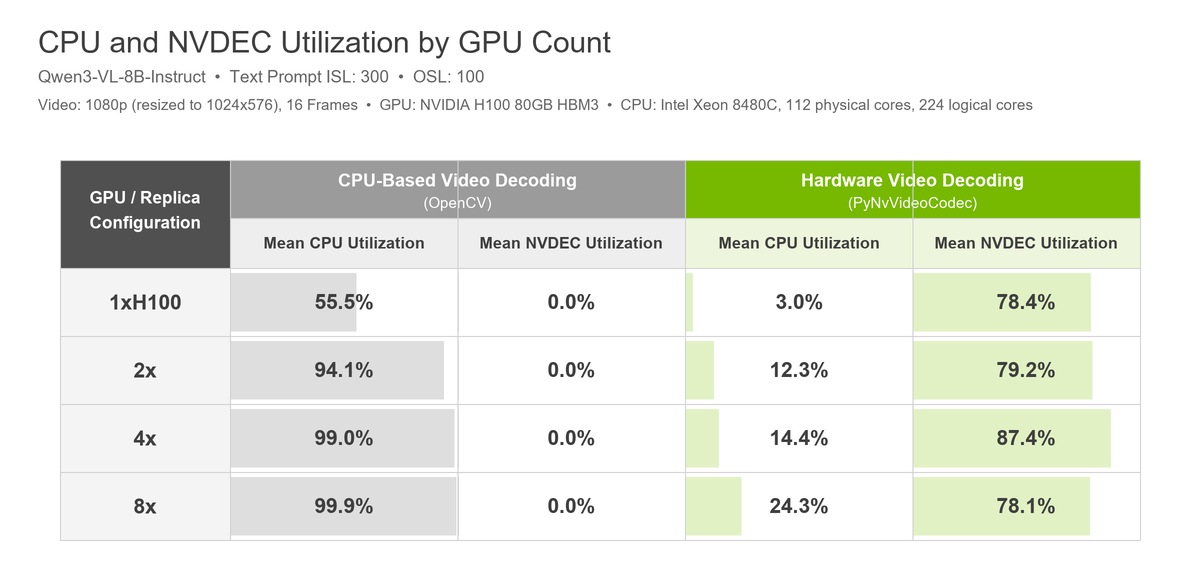
图 2:以往用到 8 块 GPU 的大规模负载,在 4 块 GPU 之前就会先撞上 CPU 利用率瓶颈。如今有了基于硬件的视频解码支持,这个 CPU 瓶颈已经消除。数据采集于 benchmark 稳态运行期间。
注意事项
需要说明的是,视频解码确实需要预留一部分 VRAM:如果你的使用场景已将全部 VRAM 用于 KV cache,那么可能会受到一些影响。在实际测试中,我们尚未遇到因使用 PyNvVideoCodec 而导致性能下降的情况。
致谢
感谢所有为 vLLM 引入硬件视频解码支持做出贡献的人。
- NVIDIA:
NVCV 团队:Brandon Pelfrey、Benjamin Chislett、Dhaval Suthar、Jeremy Bottleson、Ernesto Zamora Ramos、David Lesage
- PyNvVideoCodec 团队:Rohit Naskulwar、Jayant Mukundam、Hareshkumar Borse
vLLM 团队与社区: Roger Wang、Nick Hill、Cyrus Leung、Zifeng Mo