GB300 NVL72でKimi-K3最速のDSparkをどう訓練したか
vLLMがSpeculatorsトレーニングライブラリを2.8兆パラメータのKimi K3対応に拡張:4ビット量子化ターゲットモデルに5層・50億パラメータのDSparkドラフトモデルを組み合わせ、数学推論の単一ストリーム対話性が約110から約435 tok/s/userに向上、同時実行時に同じ対話性で出力スループットが最大約3.5倍、初回トークン中央値は100ミリ秒のみ増加。
日本語
コピー
GB300 NVL72 で Kimi-K3 最速の DSpark をどう訓練したか
6月、DeepSeek は DSpark を公開した。DFlash のブロック単位投機的デコーディングアルゴリズムを拡張したものだ。この新しいアルゴリズムはトークン間の一貫性が高く、そのぶん受け入れ長も伸びるとされている。だがオープンソースコミュニティにとって本当の関心事はいつも同じだ。博士課程の学生に checkpoint を見張らせずに、訓練して、パッケージして、デプロイできるのか。
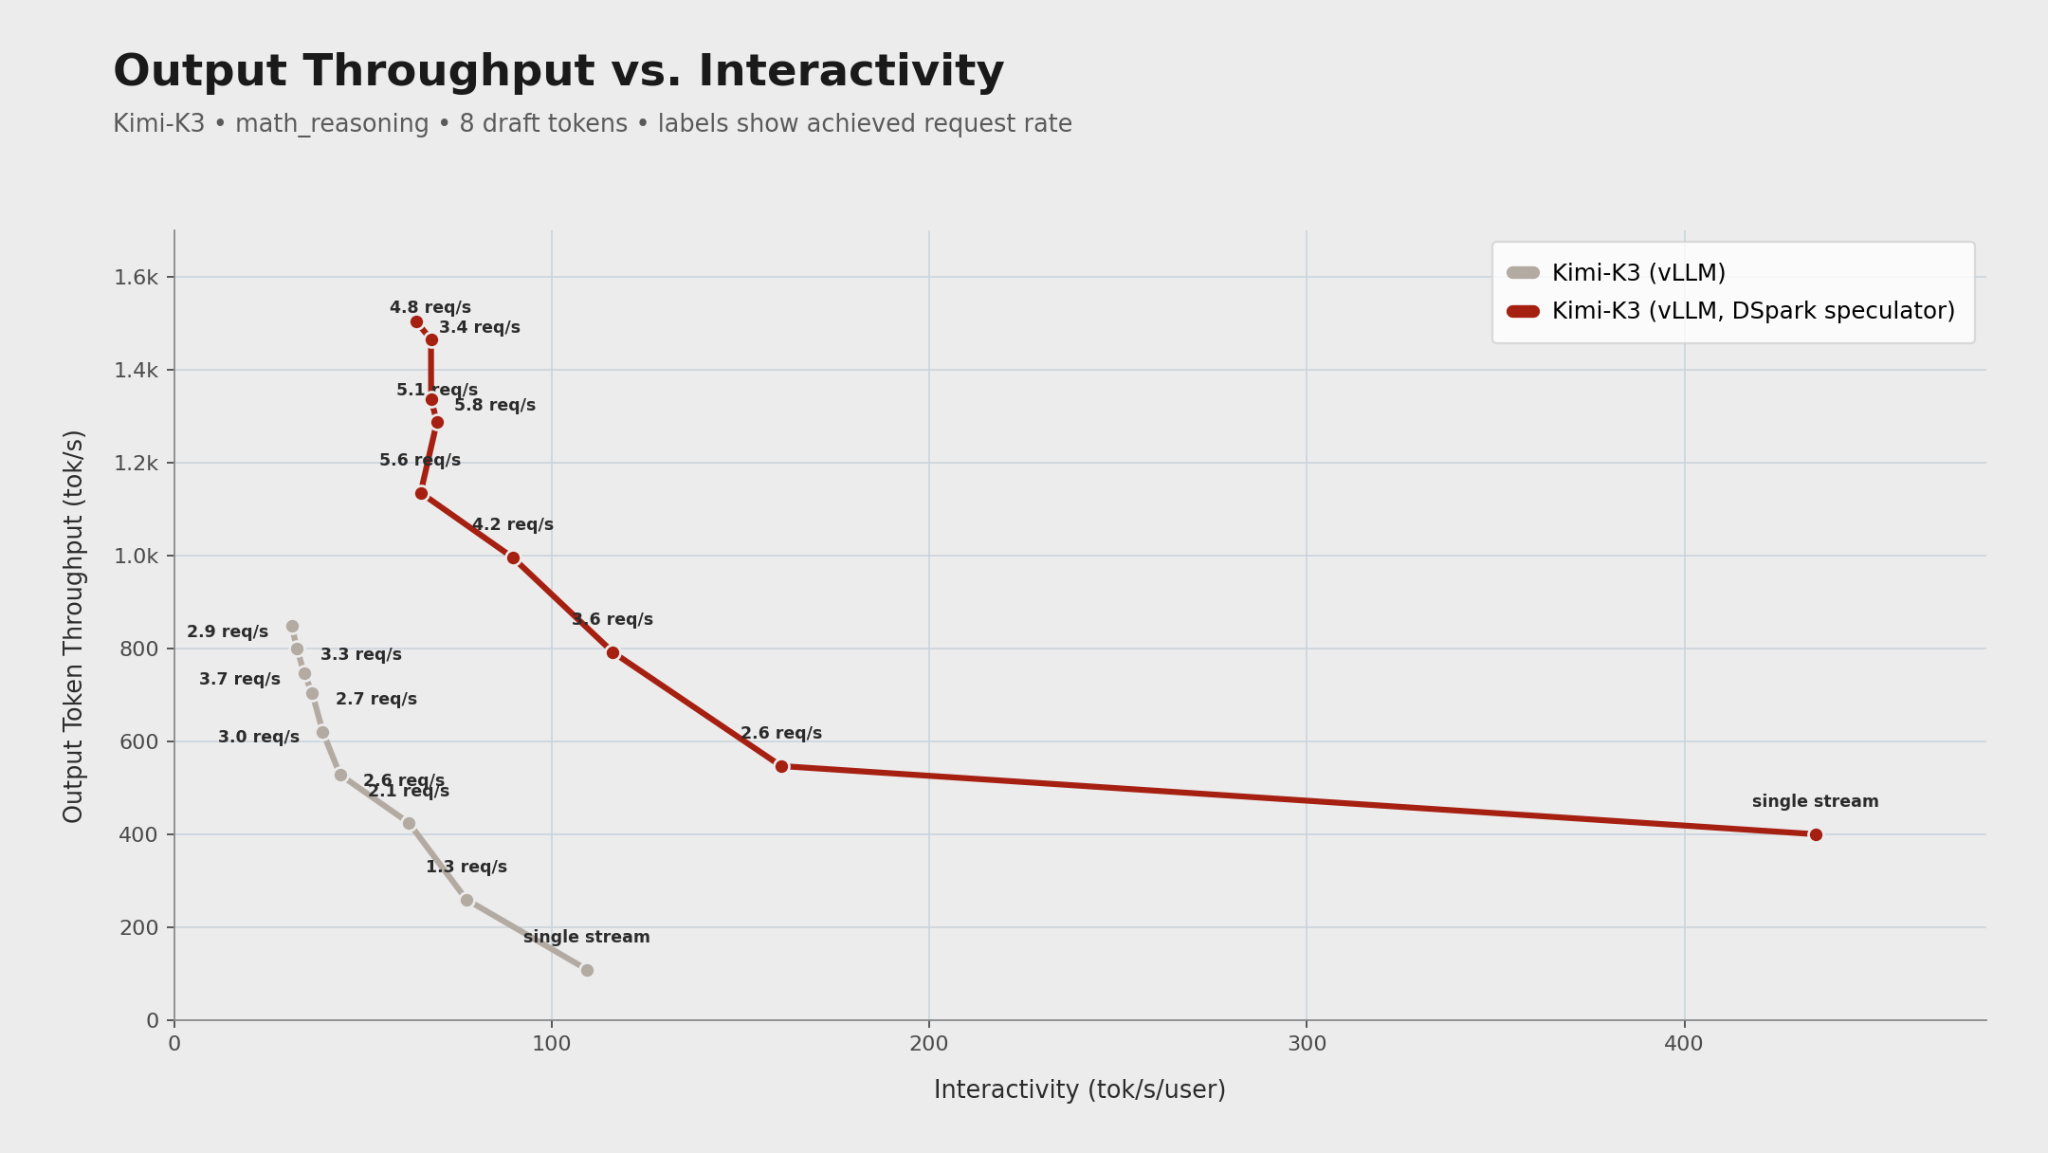
vLLM プロジェクトの Speculators 訓練ライブラリのおかげで、答えは明確に「イエス」だ。Speculators があれば、標準的で Hugging Face 互換のフォーマットで DSpark ドラフトモデルを訓練・パッケージ・デプロイでき、vLLM がそのまま読み込める。この実装はすでに Qwen3.6-35B-A3B、Gemma-4-31B-it、GLM-5.2 などで検証済みだ。本記事では、この訓練ライブラリを 2.8 兆パラメータのフロンティアモデル Kimi K3 に対応させるまでを書く。新しい DSpark 投機器は、数学推論におけるシングルストリームの対話性を約 110 tok/s/user から約 435 tok/s/user へ引き上げ、同時に並行負荷下でも、同じ対話性の水準で最大約 3.5 倍の出力スループットをもたらす。
DSpark 投機器あり/なしでの Kimi K3 の出力スループットと対話性の比較
図 1. Kimi K3 の DSpark 投機器は、数学推論の負荷でシングルストリームの対話性と全体の出力スループットを同時に高める。
DSpark とは何か
大規模言語モデルは、フォワードパス1回につきトークンを1つ生成する。投機的デコーディングは、軽量なドラフトモデルにいくつかのトークンを提案させ、それを完全なターゲットモデルがまとめて検証することでこの処理を加速する。
EAGLE-3 は強力なベースラインだが、起草はあくまで自己回帰的だ。7トークンを提案するには7回の直列な起草ステップが要る。DFlash は非因果的なバックボーンのフォワードパス1回でブロック全体を予測し、報告されている最高加速率は EAGLE-3 の2.5倍に達する。
代償は、並列な位置同士が互いを条件にできないことだ。「Thank you!」のようなプロンプトなら、モデルは最初の位置で「Of」と「No」の両方に、次の位置で「course」と「problem」の両方に同時に傾き、「Of problem」のような食い違いを生む。検証は最初に拒否されたトークンで止まるため、1つの誤りが残りのサフィックスまで無効にしてしまう。この問題は DSpark 論文で_サフィックス減衰_(suffix decay)と呼ばれている。
DSpark は DFlash の並列バックボーンを保ちつつ、軽量なコンポーネントを2つ追加する。
- マルコフ logit バイアスヘッドはトークンを順にサンプリングし、直前に選ばれたトークンで各位置の logits を調整する。その低ランク遷移行列は、transformer のフォワードパスをもう1回走らせることなく、重要な局所依存を回復する。
- 信頼度ヘッドは各トークンが受け入れられる確率を見積もる。ハードウェアを意識したスケジューラはこの推定を使い、負荷が軽いときはより長いプレフィックスを検証し、システムが混んでいるときは見込みの薄いサフィックスを切り捨てる。
こうして DSpark は、バックボーンのフォワードパス1回という並列起草の利点をそのまま受け継ぎながら、自己回帰生成の一貫性の一部を取り戻す。複数の Qwen3 ターゲットモデルで、報告されている受け入れ系列は DFlash より 16〜18%、EAGLE-3 より 27〜31% 長い。DeepSeek-V4 の本番サービスでは、同じスループットでユーザーあたりの生成速度を以前の MTP-1 ベースラインより 60〜85% 高めた。
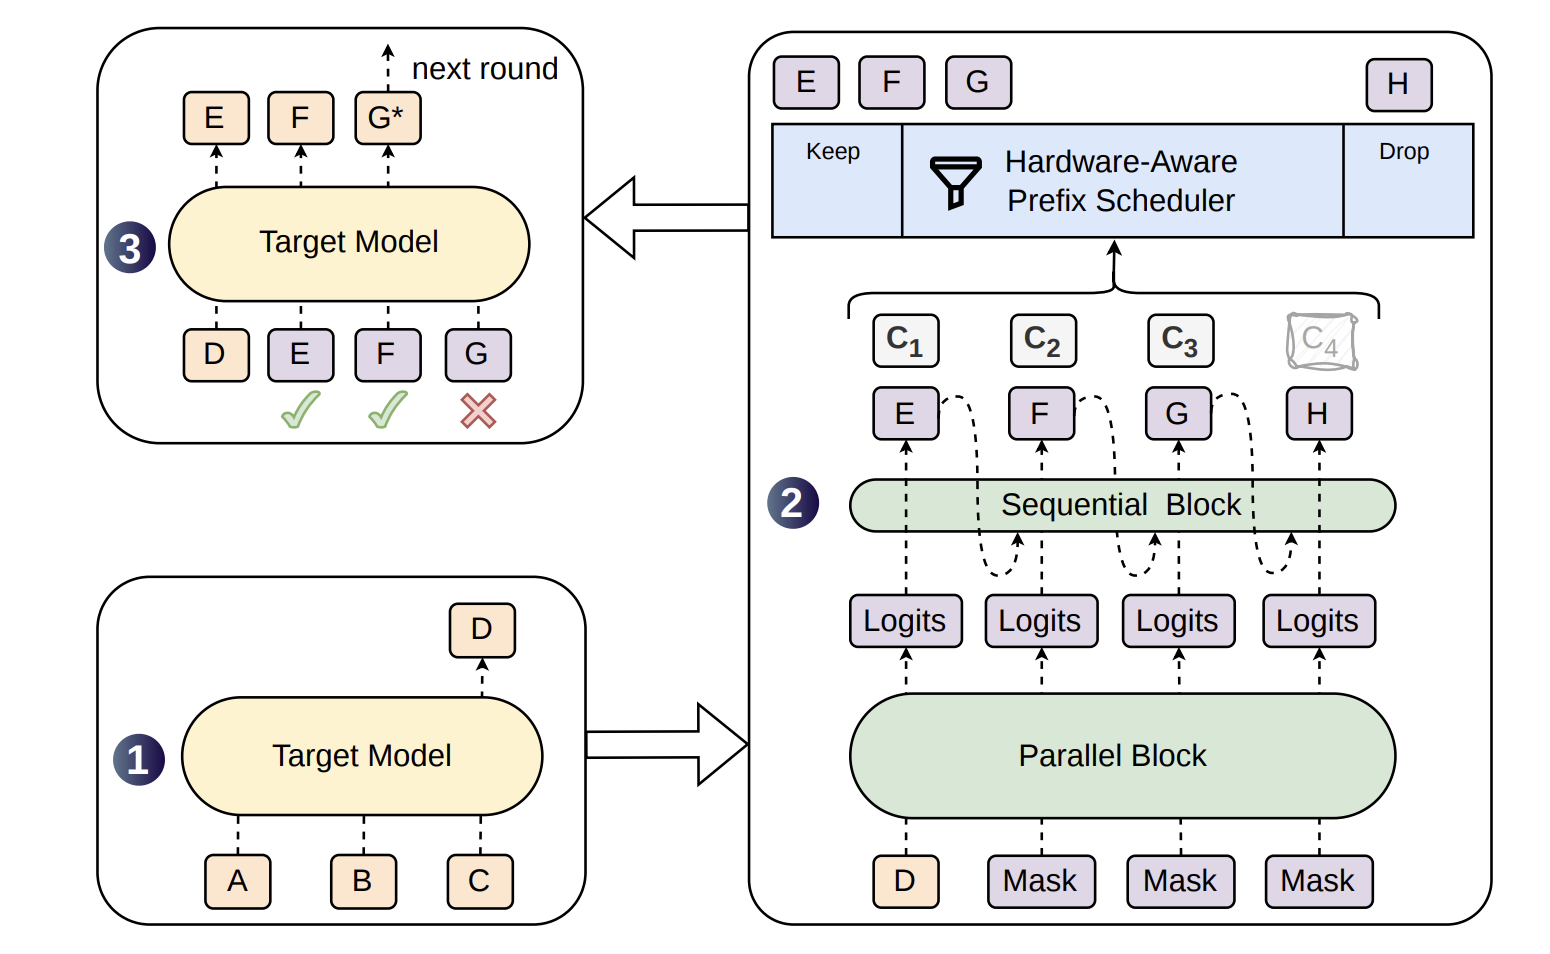
DSpark アーキテクチャ:並列起草、逐次補正、信頼度スコアリング、ハードウェアを意識した検証
図 2. DSpark はターゲットモデルの検証の前に、並列ブロックを逐次補正とハードウェアを意識したサフィックススケジューリングと組み合わせる。
推論時の挙動
DSpark の半自己回帰的な設計が推論を改善するのは、追加の直列処理がドラフトモデルのフォワードパスをもう1回走らせるコストをなお大きく下回る場合だけだ。公開されている Kimi K3 DSpark 投機器は、5層・50億パラメータのドラフトモデルを使い、デコードステップごとに8トークンを提案する。
9つの評価領域で、検証1ラウンドあたり 4.11 トークンのマクロ平均受け入れ長に達する。構造化タスクで最も強く、数学推論が 6.42 トークン、HumanEval が 4.96、翻訳が 4.65 だ。加速はリクエスト数が少ないときに特に顕著になる。
このモデルは長いコンテキストのプロンプトでとりわけよく効く。難しい領域データセットである LongBench-v2 で、我々の Kimi K3 DSpark は 378K トークンのプロンプトに対してデコード反復あたり最大 5.31 の出力トークンに達する。より広い負荷でも上位 10% のリクエストは1反復あたり少なくとも 3.76 トークンに達しており、本当に長いコンテキスト長でも深い投機的実行が現実的であることを示している。
同時に届くリクエストが増えても、きちんとスケールする。並列度を1から16に上げると、全体の出力スループットは毎秒177トークンから683トークンに伸びた。
重要なのは、負荷がかかってもレスポンスの立ち上がりが速いままである点だ。同時に処理するリクエスト数が16倍になっても、初回トークン時間の中央値は379ミリ秒から479ミリ秒へ、わずか100ミリ秒しか増えていない。
デプロイは簡単だ。ハードウェアとユースケースに合わせて、公式の vLLM recipe に従えばいい。
docker run --gpus all \
  --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e GLOO_SOCKET_IFNAME=$IFACE_NAME \
  -e NCCL_SOCKET_IFNAME=$IFACE_NAME \
  -e VLLM_ALLREDUCE_USE_FLASHINFER=1 \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest moonshotai/Kimi-K3 \
  --trust-remote-code \
  --gpu-memory-utilization 0.95 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr $HEAD_IP \
  --load-format fastsafetensors \
  --no-enable-flashinfer-autotune \
  --max-model-len 1048576 \
  --kv-cache-dtype fp8 \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --enable-prefix-caching \
  --attention-backend TOKENSPEED_MLA \
  --prefix-match-unit 128 \
  --reasoning-parser kimi_k3 \
  --language-model-only \
  --speculative-config '{"model":"RedHatAI/Kimi-K3-speculator.dspark", "num_speculative_tokens":8, "method":"dspark", "draft_sample_method":"probabilistic", "rejection_sample_method":"block"}'
ハードウェア構成
このモデルは Verda が快く提供してくれた GB300 ラック1台で学習した。Verda はヨーロッパの AI クラウドで、データセンターからマネージドサービスまで技術スタックをすべて自社で持ち、電力は100%再生可能エネルギーで賄っている。ヨーロッパでいち早く GB300 NVL72 ラックを導入したベンダーの一つでもある。社内の AI Lab も同じラック群で推論研究を行っている。
この GB300 ラックは NVIDIA のリファレンスデザインのままで、ベアメタルで仮想化なしに動作し、OS は Ubuntu 24.04.4 LTS、NVIDIA の 64K ページ対応カーネル 6.14 上で動いている。
Verda は最適化の力を最も重要なシステムレベルの構成選択に注ぎ、研究者が最先端の環境を使えるようにしている。このシステムは NVIDIA の 610.57.04 オープンソースカーネル GPU ドライバ(R610)を使う。CUDA 13.4.0 開発者プレビューが CUDA 13.1 と 12.9 とともにインストールされ、NCCL 2.31.2 がシステム全体で利用できる。
CUDA 13.4.0 を選んだのは、新しい Blackwell 向けプログラミング機能のためであり、Rubin サポートを含む最初のツールチェーン(sm_107)でもあるからだ。これにより、今日 GB300 上で書いてプロファイリングしたコードが、予期しない互換性問題なしに次世代ハードウェア向けにビルドできることが担保される。ハードウェアカウンタに基づく GPU プロファイリングも root 権限なしで使えるため、どの研究者も学習と推論のワークロードをプロファイリングできる。
私たちは Verda と協力し、オープンソースの学習・推論インフラを最新の GPU アーキテクチャへ広げる手助けをしてきた。現在の焦点は GB300 から VR200 へのラック規模システムだ。この協業の成果が形になりつつあるのを見られてありがたく思う。
隠れ状態を大規模に抽出する
投機的デコードのドラフトモデルが、その小ささにもかかわらずこれほど強力なのは、多くの場合、目標モデルの隠れ状態を入力として受け取り、自分の予測の指針にしているからだ。これが作業コンテキストを大きく改善し、ドラフトモデルが自分の予測を目標モデルにぴったり合わせられるようにする。
ただし前提がある。これらのドラフトモデルを学習するには、隠れ状態の入力と目標モデルの対数確率出力からなるデータセットが必要だ。幸い vLLM には隠れ状態抽出システムがあり、データセットのサンプルに対して目標モデルの内部隠れ状態をオンデマンドで取得できる。このシステムはダミーのドラフトモデルを使い、vLLM のドラフトモデルパイプラインを再利用して目標の隠れ状態を受け取り、それをダミーのアテンション層の KV cache に挿し込む。そこから KVConnector インターフェースを実装したクラスが隠れ状態を取り出して vLLM の外へ渡せる。現在 vLLM にはこれをそのまま行う ExampleHiddenStatesConnector が同梱されており、隠れ状態を非同期でディスクに書き出す。
このシステムは単一ノードの「vLLM + 学習」構成でよく機能する。たとえばノードの GPU の半分を学習専用にし、残り半分で vLLM が目標モデルをサービングして隠れ状態をオンデマンドで抽出する。このシステムは Speculators と vLLM で数か月にわたり十分にサポートされてきた。だが Kimi K3 のような2.8兆パラメータのモデルでは、モデル重みを4ビット量子化しても、最先端のアクセラレータがそろそろ VRAM の上限にぶつかり始める。単一ノードの学習を超えて、学習と隠れ状態抽出を分離できるシステムが必要だ。
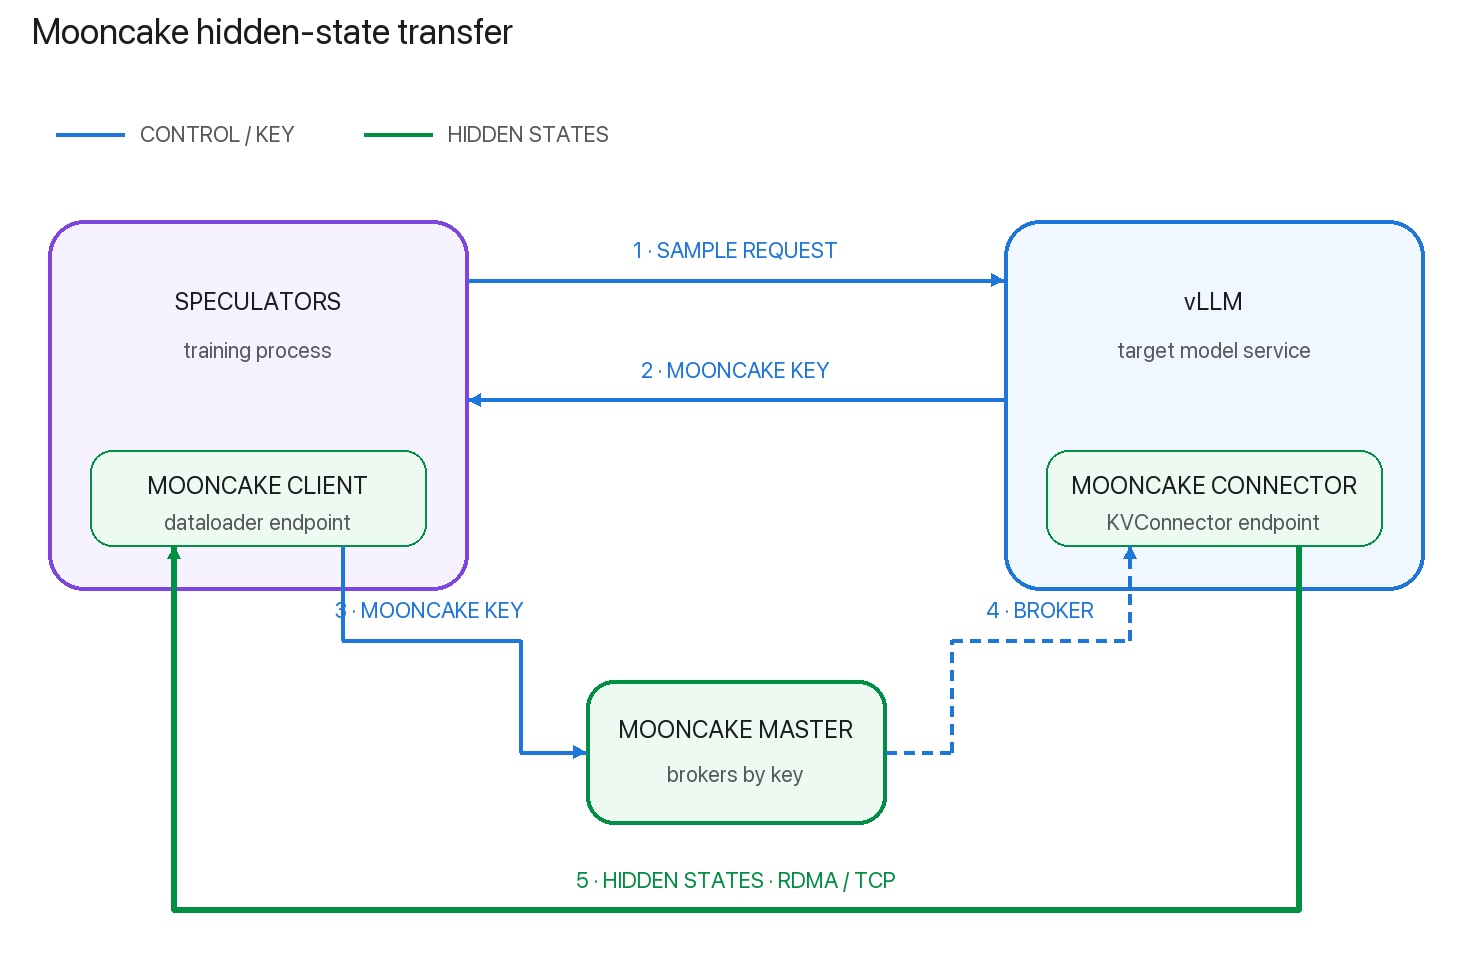
Speculators の学習プロセスと vLLM の推論プロセスの間の Mooncake 隠れ状態転送
図3. Mooncake コネクタは制御パスと隠れ状態データパスを分離し、RDMA または TCP で vLLM と Speculators の dataloader の間を転送する。
こうした要件を踏まえて私たちが作ったのが MooncakeHiddenStatesConnector で、Mooncake 転送エンジンをバックエンドに使い、プロセス間・ノード間で隠れ状態をストリーミングする。この新しいシステムは master Mooncake プロキシプロセスで vLLM と学習インスタンスの間の通信を管理し、後者は自分自身をクライアントとして登録する。セットアップが済むと、学習プロセスは vLLM フロントエンドにリクエストを送り、応答として Mooncake store key を受け取る。この key は次に Mooncake master に渡され、master が vLLM エンジンから Speculators の dataloader への転送を成立させる。ここまでの流れはすべて自動で、Mooncake サーバー側が管理し、構成に応じて高速な RDMA 転送か通常の TCP を使い、同一ノードか別ノードかを問わずプロセス間でデータを送る。
Kimi K3 DSpark のトレーニング
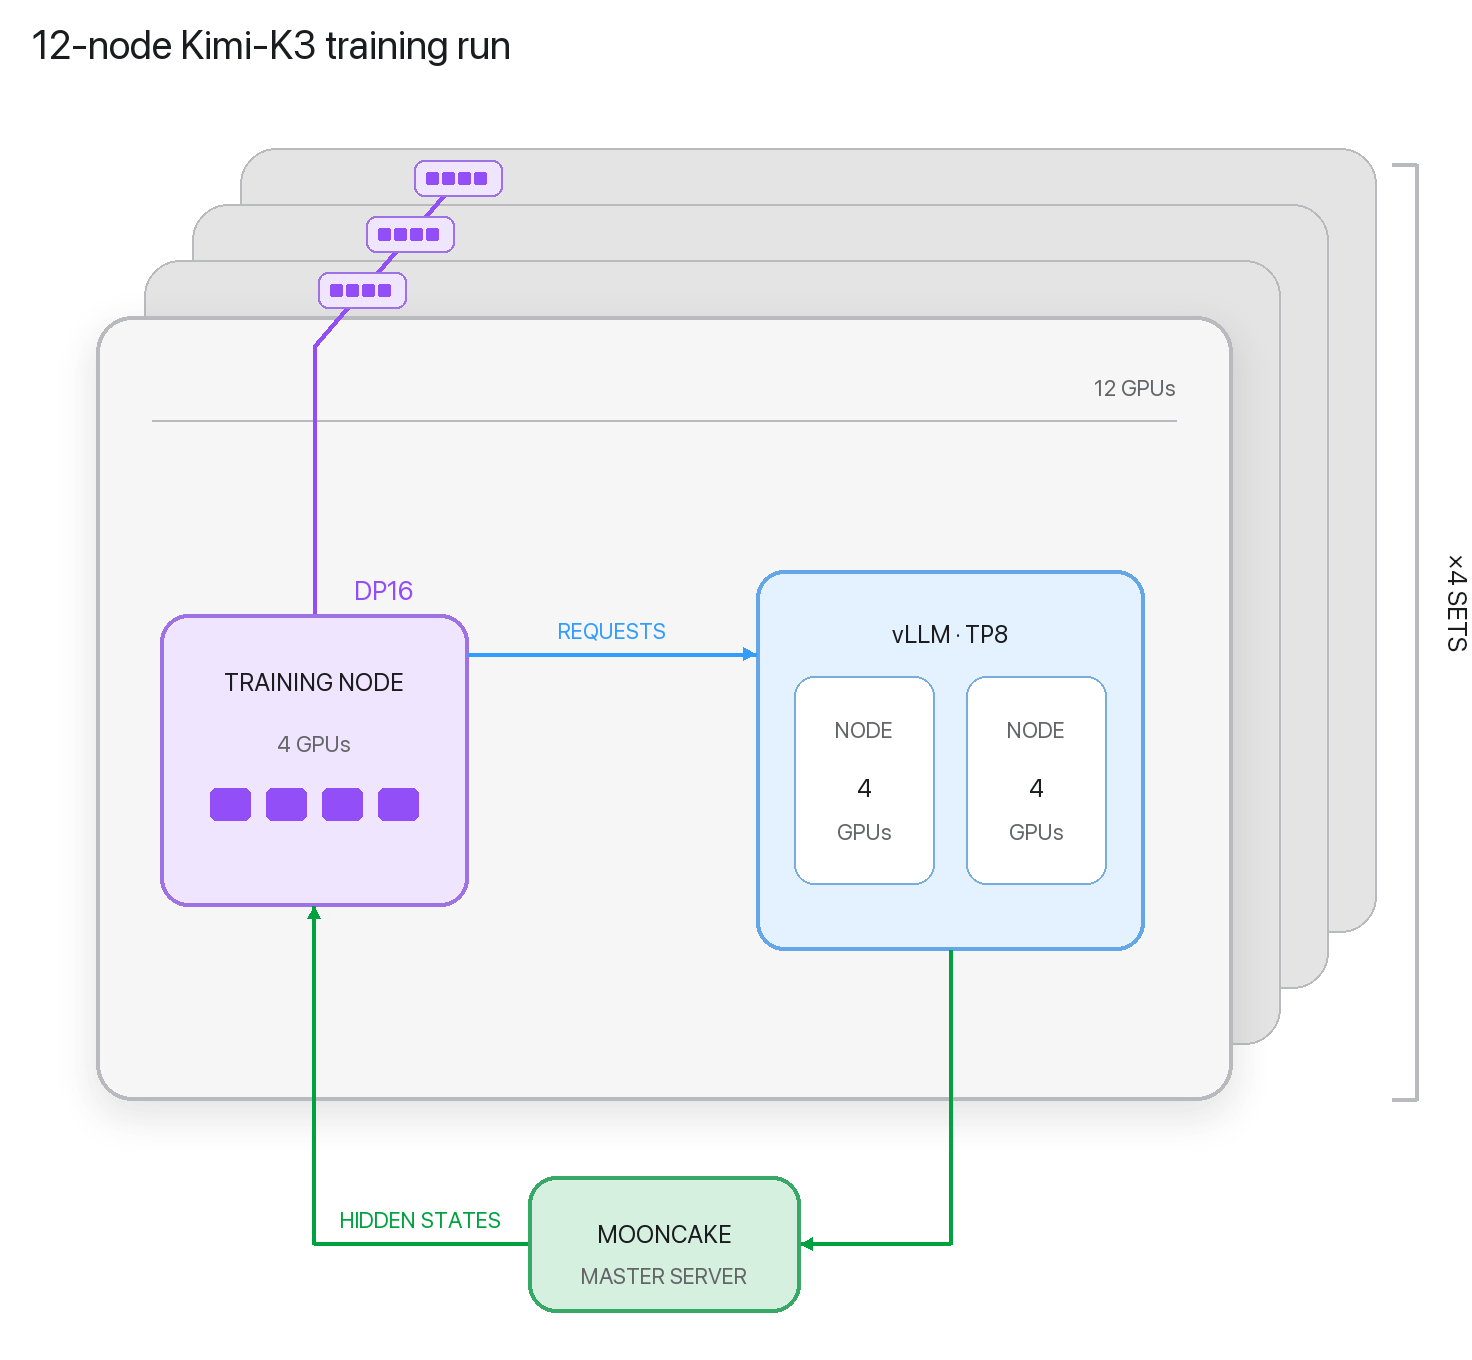
12ノード構成の Kimi K3 DSpark トレーニングトポロジー:分離された vLLM 推論と Mooncake 転送
図4. 4ノードを1グループとし、うち1台の4 GPUノードをトレーニング専用に、2台の4 GPUノードを vLLM 推論に充て、隠れ状態は Mooncake で転送する。
新たに MooncakeHiddenStatesConnector が加わったことで、大規模モデルのマルチノードトレーニングまでスケールできるシステムが整った。Kimi K3 を4ビットに量子化しても、サービングには少なくとも2台の GB300 ノード(各4 GPU)が必要になる。トレーニングと vLLM の構成をいくつか試したところ、3ノードを1グループ(推論2台、トレーニング1台)にしたときがスループット最大だった。Mooncake コネクタを使う Speculators にはもう一つ利点がある。最高の性能を引き出すために、任意のコンポーネントだけを個別にスケールアップ・スケールダウンするのが簡単なのだ。
まとめ
Speculators は、投機的デコーディングのモデルを構築・トレーニング・評価・共有するためのオープンソースライブラリで、vLLM のような推論エンジンとそのまま統合できる。新しいドラフトモデルをトレーニングする場合でも、DFlash、DSpark、DFlash2 といったアルゴリズムを試す場合でも、本番環境の推論性能を改善する場合でも、アイデアとコントリビューションを歓迎する。vLLM コミュニティ Slack に参加し、#speculators と #feat-spec-decode で私たちを見つけて、質問や結果の共有、新しいアルゴリズムの議論、コミュニティとの協働に加わってほしい。コード、ドキュメント、サンプル、モデルサポート、評価ツールへのコントリビューションを歓迎する。