vLLMにおけるウォーターマーク技術
テキスト透かしは出力分布、堅牢性、検出コストの間でトレードオフが必要。vLLMの記事ではレッドグリーンリスト、Gumbelノイズサンプリングなど数種類の手法と、それぞれがどのような条件で破られるかを解説。
日本語
コピー
テキストの来歴をたどるとは何か、なぜ難しいのか
共有する情報に信頼と説明責任をもたらすには、デジタルコンテンツの出所を確認することが欠かせない。透かし(ウォーターマーク)はその一つの解だ。作品自体に手を加えて、そのコンテンツに関する情報 [1](たとえば出所)を埋め込む。画像や音声なら、知覚できない程度の摂動として透かしを入れられるが、テキストは離散的で、同じ手は使えない。そこでテキスト自体を摂動させるのではなく、生成プロセスに介入する。変更を検出可能にしつつ、モデルが本来出力すべき分布は変えない、というやり方だ。
テキストへの透かし入れは科学の問題であり工学の問題でもあり、実用化するにはいくつかの要件のバランスを取る必要がある。
出力を歪めない
透かしはモデルの期待出力分布を変えてはならない [2]。特定の語、特定の文体、特定の解法に系統的に偏らせてはいけないということだ。
ロバスト性
生成されたテキストはさまざまな形で改変されうる。削除、編集、他のコーパスとの混合、さらには別の LLM による書き換え。優れた透かしシステムは、こうした改変を経ても出所の信号を保てなければならない。
速度
透かし入れが生成と検出に与える遅延とメモリのオーバーヘッドは、できる限り小さくすべきだ。vLLM のような高スループットの推論エンジンでは特に重要になる。性能低下は二つの源から生じる。スケジューリング遅延に敏感な小規模モデルと、語彙が非常に大きいモデルだ。
検出の依存をできるだけ少なく
テキストの透かしを検出するのに必要な情報は、できるだけ少ないほうがよい。ある文章がどこから来たのか知りたいユーザーが、その出所についての追加情報——作成日や、どの言語モデルが生成したか——を持っているとは限らない。
これらの要件は互いに引っ張り合う。信号が強く検出が容易なら、モデルの出力を大きく変えることになりかねない。追加情報に依存しないなら、使えるアルゴリズムが制限される。
例を挙げよう。
- ファイルに付随するメタデータは剥ぎ取れるし、新しいファイルにコピーすれば残らない。
- 紅緑リスト [3] やデータそのものへの透かし入れは、出力分布を歪める。
- Unicode の置換は簡単に外され、書き換えられる。
- テキストの統計的な手がかり(文の長さ、珍しい語や言い回しなど)は信頼できない。
- トーナメントサンプリング [2] は複数回の処理を要し、推論を遅くせずに効率よく実装するのは容易ではない。
こうした条件を満たすために、私たちは言語モデルの生成に備わったある性質を利用する。ランダム性だ。
LLM のランダム性を利用する
生成の各ステップで、言語モデルは次に来うるすべてのトークンに確率を割り当て、そのうち一つをサンプリングする。この過程は、ありうる続きからなる木の中の一本の経路をたどることに等しい。他の経路より出やすい経路はあるが、多くの経路が妥当な最終出力になりうる。
通常のランダムサンプリングは、各ステップで新しい乱数を引いては捨てる。透かしは違う。直近の文脈と各候補トークンから、再現可能な鍵付きの値を導出する。文脈と選ばれたトークンはどちらも出力に残るので、鍵を持つ検出側は生成が終わったあとにこれらの値を再構成できる。透かし入りのテキストはこうした値と系統的に揃い、系列が十分長ければ信号は積み上がっていく。
次の節では、これをどう実装するかを見る。モデル本来のサンプリング分布を保ったまま、モデルが取りうる複数の最終出力から再現可能に一つを選べるようにする方法だ。
Gumbel-max トリック
Gumbel-max トリックはカテゴリ分布からサンプリングする手法だ。モデルが各候補トークンに確率を割り当てたとする。各トークンについて独立な一様乱数を引き、それを Gumbel 乱数に変換する:
サンプリングされるトークンは:
この変換にはきれいな帰結がある:
言い換えれば、トークンの対数確率に Gumbel ノイズを足して argmax を取ると、得られるカテゴリ分布は通常のランダムサンプリングと完全に一致する。実際、Model Runner v2 の標準的なサンプリング経路はすでにこの手順を使っている。実装上は、Gumbel ノイズを logits に直接足せばよく、softmax を省けて計算も並列化しやすい。
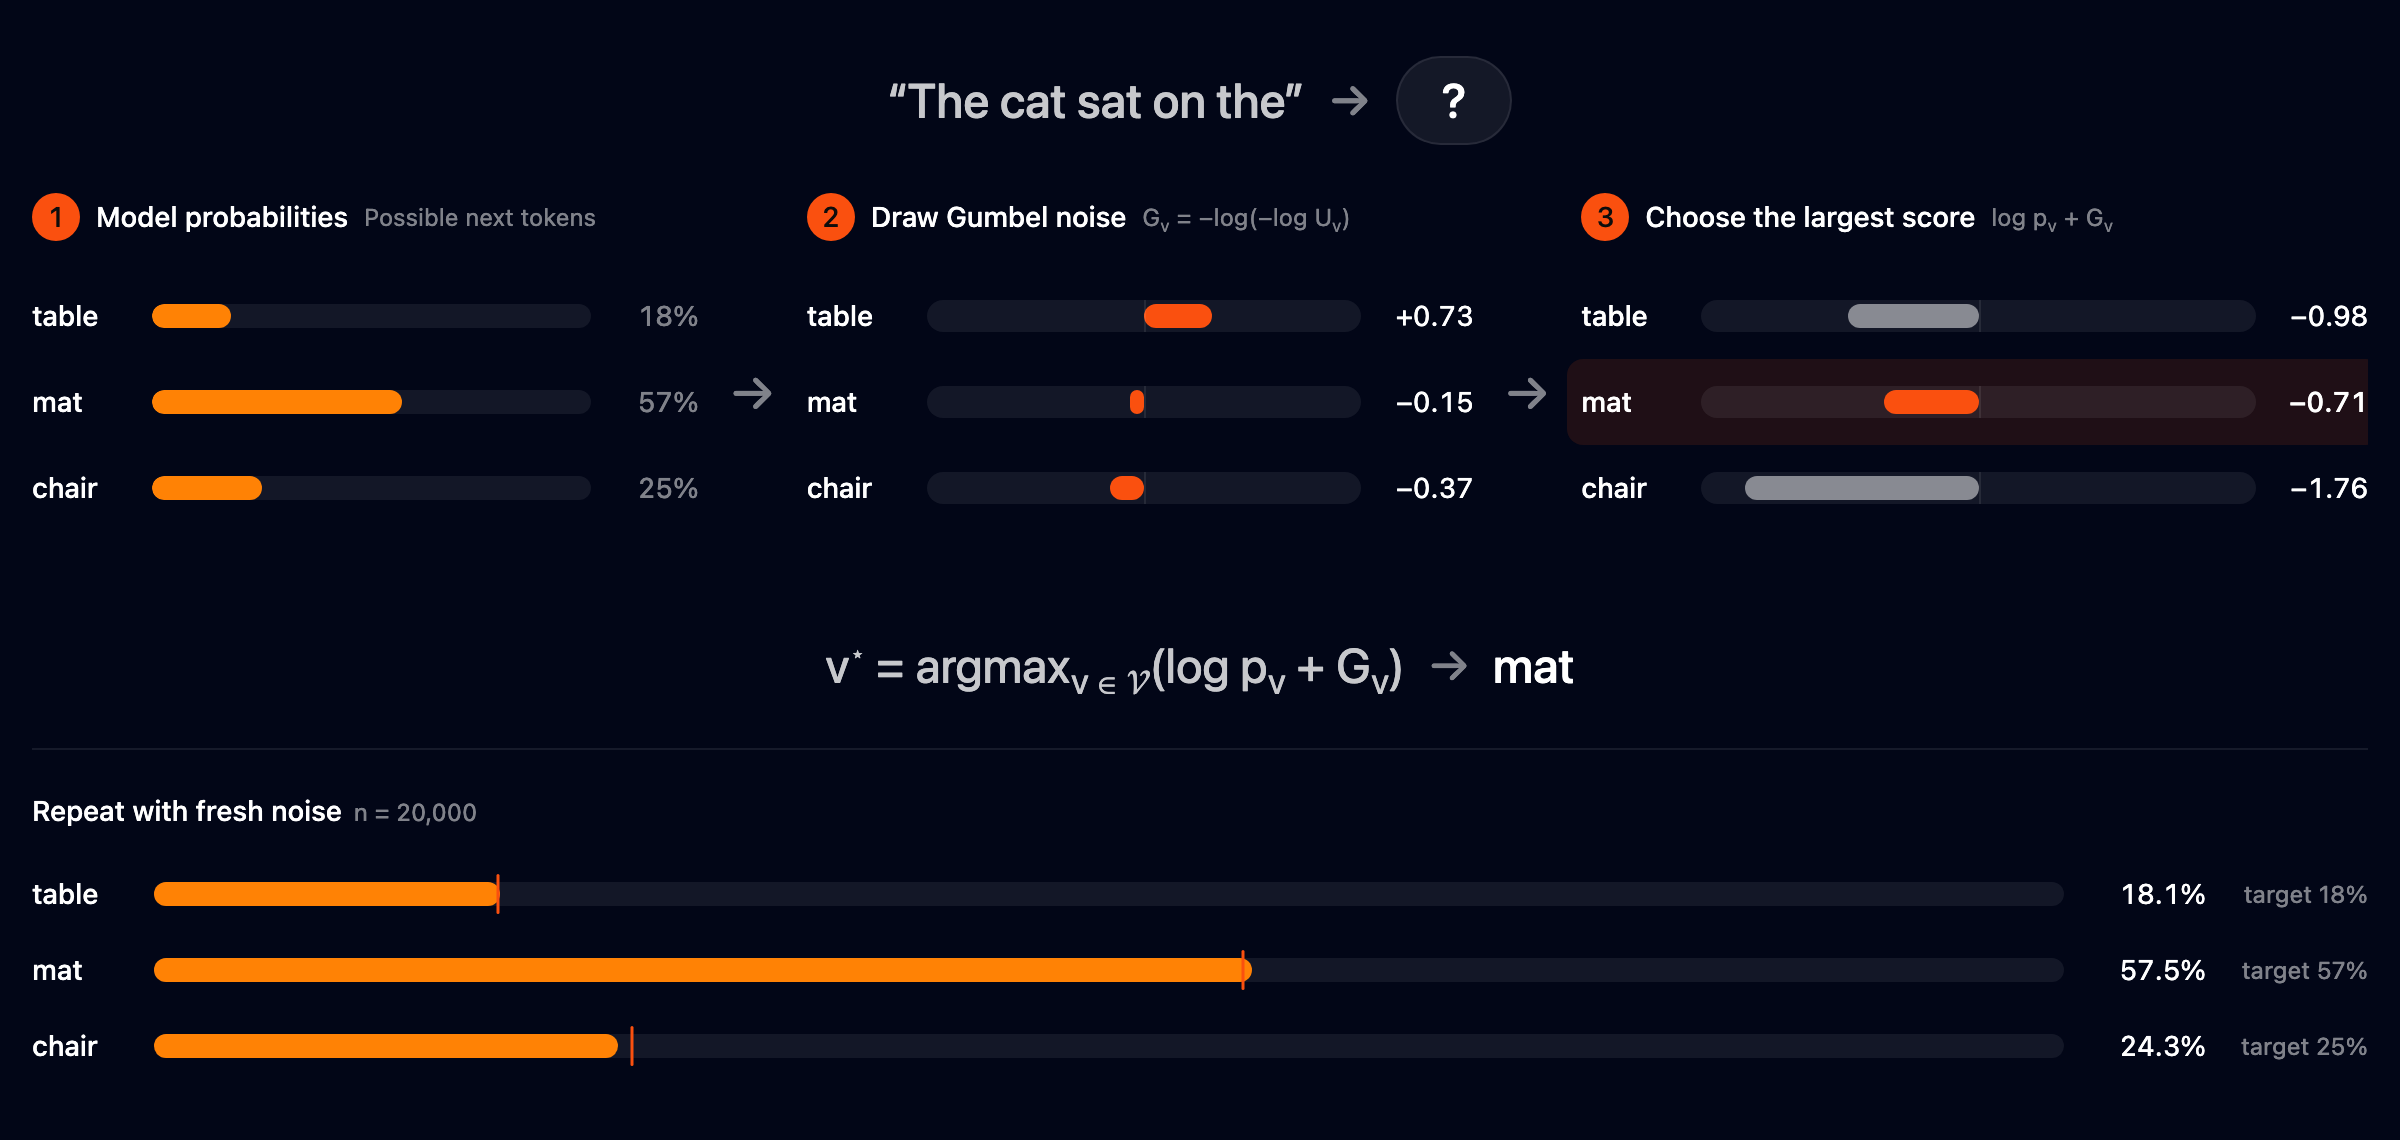
Gumbel-max サンプリングの例:table、mat、chair のモデル確率に Gumbel ノイズを重ねたもの。ある試行では「mat」が勝ち、20,000 回繰り返すと結果は元の 18%、57%、25% の分布に近づく。
これらのランダムな抽選を再現可能にするために、疑似ランダム関数(PRF)[4] を使う。PRF は鍵と入力を決定論的に、一様乱数を引いたのと同じように振る舞う値へ写す。同じ入力は常に同じ出力を生むので、検出側は生成時に使われた値を再構成できる。私たちは個々の一様抽選を次のように置き換える:
ここで秘密の透かし鍵、直近の透かし文脈(最後の数トークン)だ。トークン ID を入れるのが重要なのは、トークンごとに異なるノイズが乗るようにするためだ。直近の文脈(既定では最後の 4 トークン)を使うのは、加えるランダムノイズをほぼすべての生成ステップで別物にするためであり、秘密鍵は、鍵を持たない者にとってこのパターンを予測不能にするためだ。
生成器は候補トークンごとにこれらの鍵付きの値を計算し、ノイズを加えた対数確率が最大のトークンを選ぶ。同じ鍵と同じ文脈が与えられれば、この選択は再現できる。鍵がなければ、ただの普通のランダムサンプリングに見える。
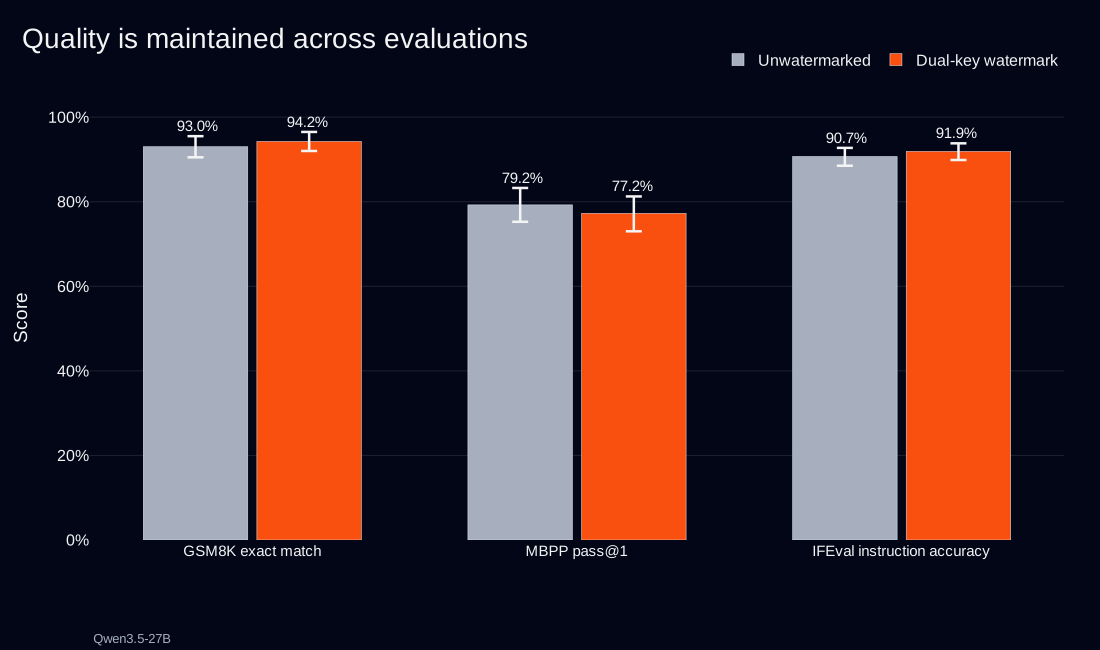
棒グラフは Qwen3.5-27B の品質を二重鍵ウォーターマークあり・なしで比較したもの:GSM8K 93.0% 対 94.2%、MBPP 79.2% 対 77.2%、IFEval 90.7% 対 91.9%、誤差バーは重なっている。
これにより、この手法は正確な無歪み保証を得る:鍵について期待値を取ると、トークンを選ぶ確率は依然としてちょうど である。ただしこれだけでは、系列全体が無歪みであることは保証されない。この限界とその対処法については「出力の多様性を保つ」で詳しく述べる。
ウォーターマークの検出
検出では生成過程を逆にたどる。検出にモデルの重みや logits へのアクセスは不要だが、秘密鍵と tokenizer を知っている必要がある。 ユーザーは出所不明のテキストを検出器に渡す。検出器はテキストを token ID に戻す。各トークンについて、検出器はその前のコンテキストと秘密鍵を使って疑似乱数値を再計算する:
ウォーターマークなしのテキストでは、観測されたトークンとその鍵付き値は互いに独立なので、一様乱数変数のように振る舞う。一方、ウォーターマークありの生成では鍵付き値が大きいトークンほど選ばれやすい。各鍵付き値をトークン単位のスコアに変換する:
同じコンテキストが繰り返し現れると鍵付き値も同じに再構成されるため、検出器はコンテキストごとに一度だけスコアを数える。テキストにウォーターマークがなければ、これらのスコアは平均 の指数分布に従う。その和
したがって形状パラメータ 、尺度パラメータ の Gamma 分布に従う。ここから片側 p 値を計算できる:ウォーターマークなしのテキストが 以上のスコアを出す確率である。p 値が小さいほど、そのテキストが埋め込まれたウォーターマークと一致していることを示す。
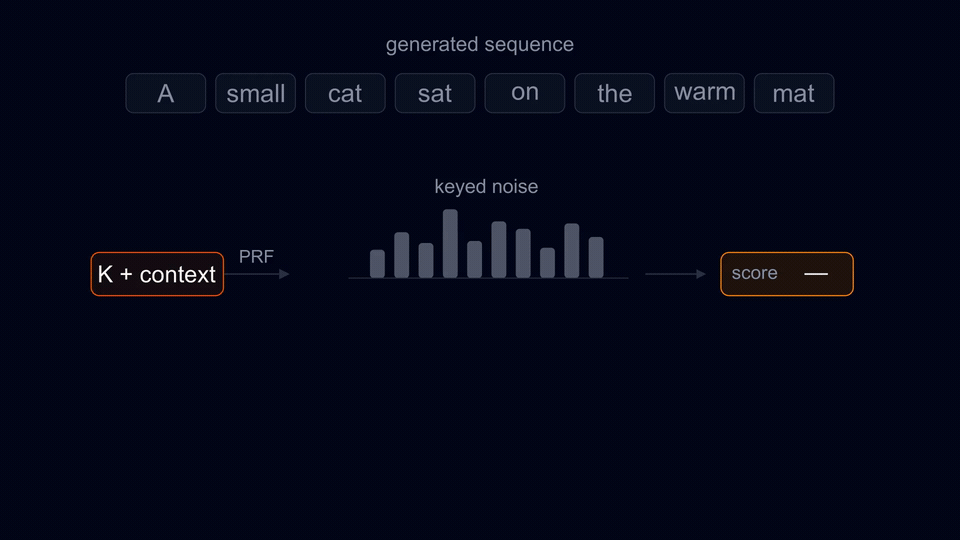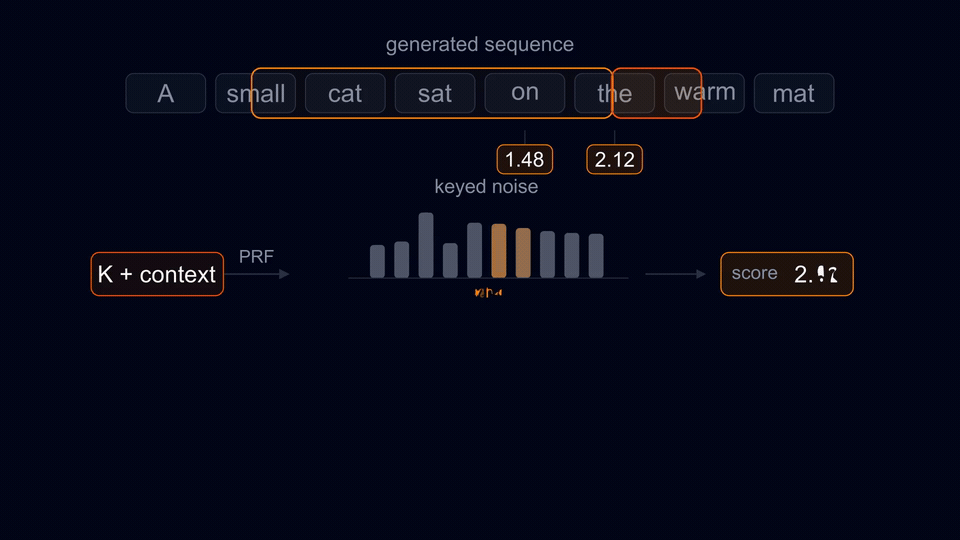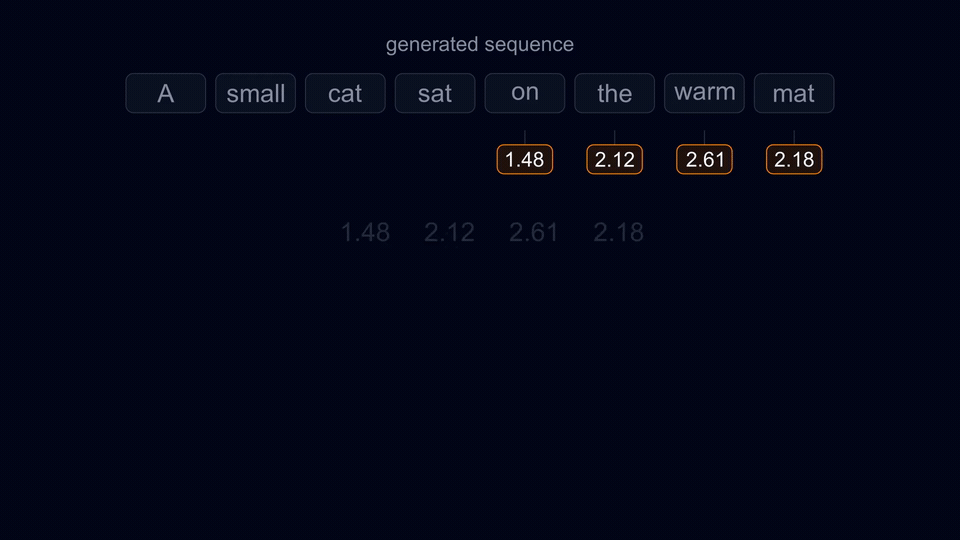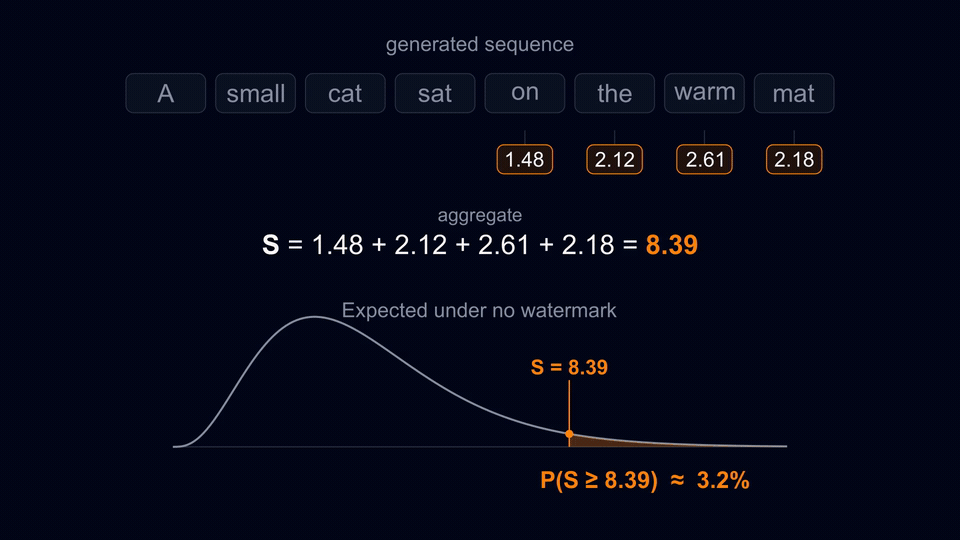
ウォーターマーク検出のアニメーション:各トークンの鍵とその前のコンテキストから鍵付きノイズが再構成され、トークンスコアが得られる。すべてのスコアを合計し、ウォーターマークなしの場合の Gamma 分布と比較して p 値を求める。
閾値の選択は偽陽性と偽陰性のトレードオフである。校正済みの検定では、 はウォーターマークなしの系列のおよそ 1% を陽性と判定する。実際には、複数の鍵、tokenizer、ウォーターマーク設定それぞれについて検定することもある。これでは偶然に高いスコアが出る確率が上がるため、多重検定の補正が必要になる。候補が増えるほど閾値は下がり、検出力も落ちる。
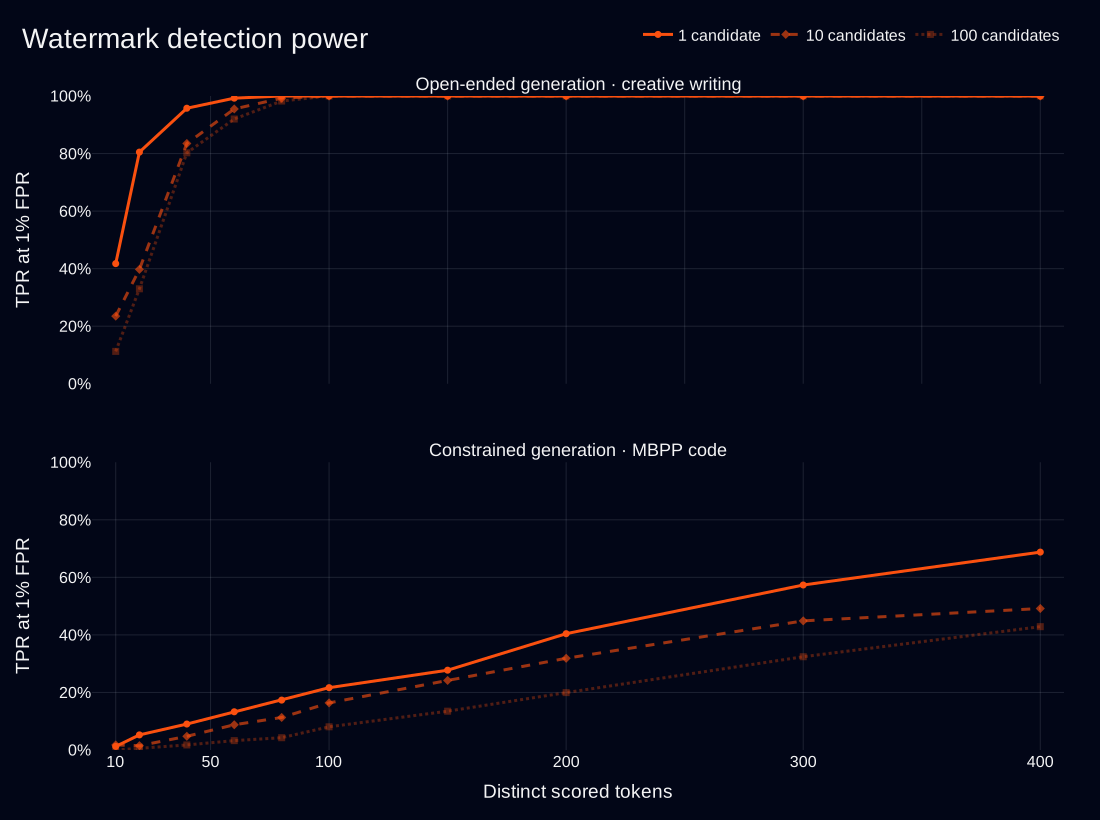
偽陽性率 1% における、候補検定 1、10、100 個のウォーターマーク検出力をスコア対象トークン数ごとに示したもの。クリエイティブライティングは約 100 トークンで TPR がほぼ 100% に達する。MBPP は上昇が遅く、400 トークンでそれぞれ約 69%、49%、43% となる。
検出は独立した証拠が積み重なるほど信頼できる:出力が長ければスコアを付けられるトークンが増え、高エントロピーなステップが多ければウォーターマークがトークン選択に影響する機会も増える。つまり短い出力や予測しやすい出力では信号が弱くなる。
信号はトークン選択そのものに符号化されているため、十分に長いテキストをコピー&ペーストしても証拠は保たれる。テキストを改変すると、改変されたトークンの周辺のスコアは乱れるが、それらのトークンが後続トークンの直近のコンテキストに含まれなくなれば、信号はそのまま残る。
vLLM での実装
この実装は当初 watermarking RFC で提案され、ウォーターマークは最終的なトークンサンプリングおよび投機的デコーディングと統合される必要があると指摘されていた。そこで Model Runner v2 のサンプリングパイプラインに直接組み込んだ。初期実装(PR #54053) は GPUWatermarkSampler をアルゴリズム固有の Watermarker に接続し、異なる方式が同じリクエスト処理とバッチ処理のロジックを共有できるようにする。
素朴な実装では実際に [batch, vocabulary] のノイズテンソルを生成するため、一時ストレージとメモリトラフィックが大量に発生する。vLLM では疑似乱数生成、Gumbel 変換、argmax のリダクションを単一の GPU kernel に融合している。Philox は呼び出しごとに 4 つの値を生成するので、この kernel は連続する 4 つの token ID を一度に処理できる。
行ごとのマスクにより、同じ融合サンプラーが、ウォーターマークありのリクエストには鍵付きノイズを、ウォーターマークなしのリクエストや繰り返しコンテキストには通常の乱数を使える。
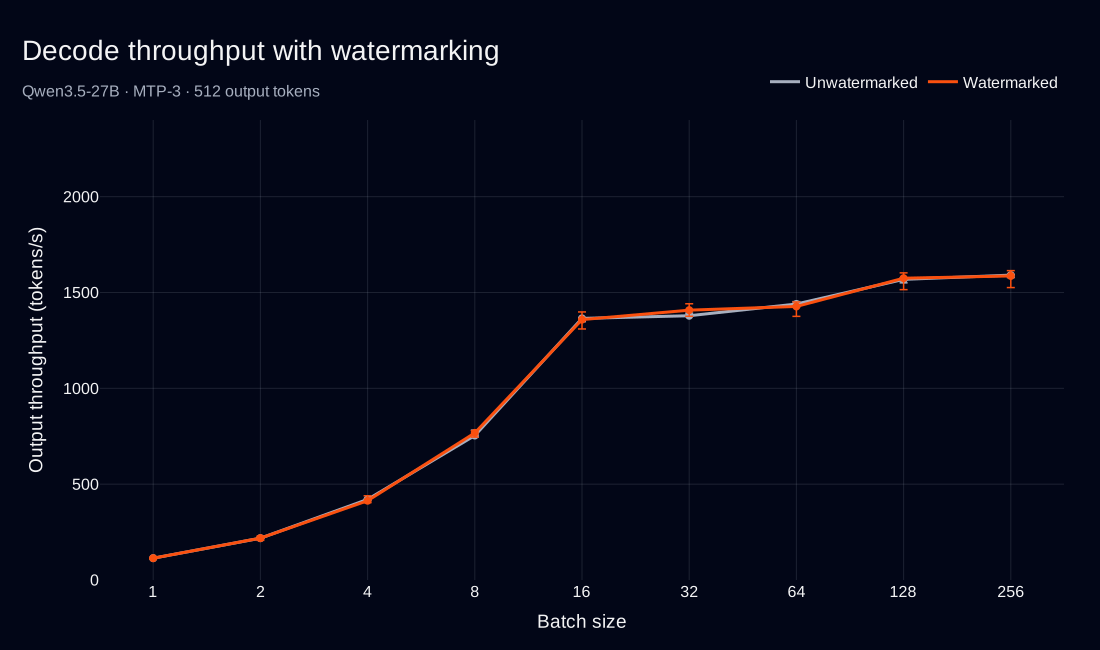
Qwen3.5-27B、MTP-3、batch size 1〜256 におけるデコードスループット。ウォーターマークありとなしの 2 本の曲線は全区間でほぼ重なり、スループットに一貫した変化は見られない。
8 つの鍵で、各 batch size におけるスループット一致時の平均変化は −1.1% から +2.0% の範囲に収まり、明らかな性能低下はない。
課題
ウォーターマーク技術には、特に巧妙な解決策を要する大きな課題がいくつかある。ここではそのうち最も重要な2つ、投機的デコーディングとの相互作用と、出力多様性の低下を取り上げる。
投機的デコーディング
投機的デコーディングは、ドラフト分布からトークンを提案し、目標分布に照らして受け入れるかどうかを決める。両方の分布に同じウォーターマークを適用すれば、それぞれの分布は変わらないままだが、両者の重なりが縮み、受け入れ率が下がる。vLLMのやり方はデュアルキー実装(PR #56122)を採用している。片方のキーは受け入れられたドラフトトークンに、もう片方は目標残差トークンとbonusトークンに使う。キーを分けることで、元の受け入れ率を保ちつつ、目標サンプリングが棄却されたドラフト提案の影響を受けないようにしている。 最終的なテキスト中のトークンはどちらか一方のキーでウォーターマークが付くため、スコアリングには両方のキーを使い、スコアを統合する必要がある。残念ながらこれでは各キーの信号が薄まり、検出信号が弱くなる。
この重み付けは、各トークンがどの経路から来たと想定されるか、そしてどれだけの信号を運んでいるかに合わせて調整できる。たとえばドラフトトークンは「易しい」、つまりエントロピーが低いときほど受け入れられやすい。これは、そうしたトークンが運ぶウォーターマーク信号がより少ないことを意味する。
出力の多様性を保つ
単一トークンの非歪曲性は、各ステップの生成で分布が変わらないことしか保証しない。系列全体の分布が変わらないことは保証しない。同じ文脈が繰り返し現れると、そのキーのノイズも繰り返され、本来なら通常のサンプリングが独立に下すはずのトークン選択が相関してしまう(下の例を参照)。単一系列の非歪曲性はより強い保証で、系列全体の分布も変わらない。 たとえば、固定キーによってモデルが次の系列を生成したとする。
1 + 1 + -> 1 context: (1, +, 1, +)
1 + 1 + 1 -> + context: (+, 1, +, 1)
1 + 1 + 1 + -> 1 context: (1, +, 1, +)
1 を再び生成した後、文脈 (1, +, 1, +) が繰り返される。固定キーはそれゆえ前と同じ疑似乱数を生み、それらは以前まさに 1 の生成を偏らせていたものだ。モデルの確率も近いか、バイアスが十分強ければ、再び 1 を選ぶ可能性が高い。こうなると生成は無限の反復ループに陥りかねない。
1 + 1 + 1 + 1 + 1 + (...)
これは最悪のケースだが、文脈をまたぐ相関は通常、系列内の多様性低下、退化した挙動の増加、生成長の増大、出力品質の低下を招く。
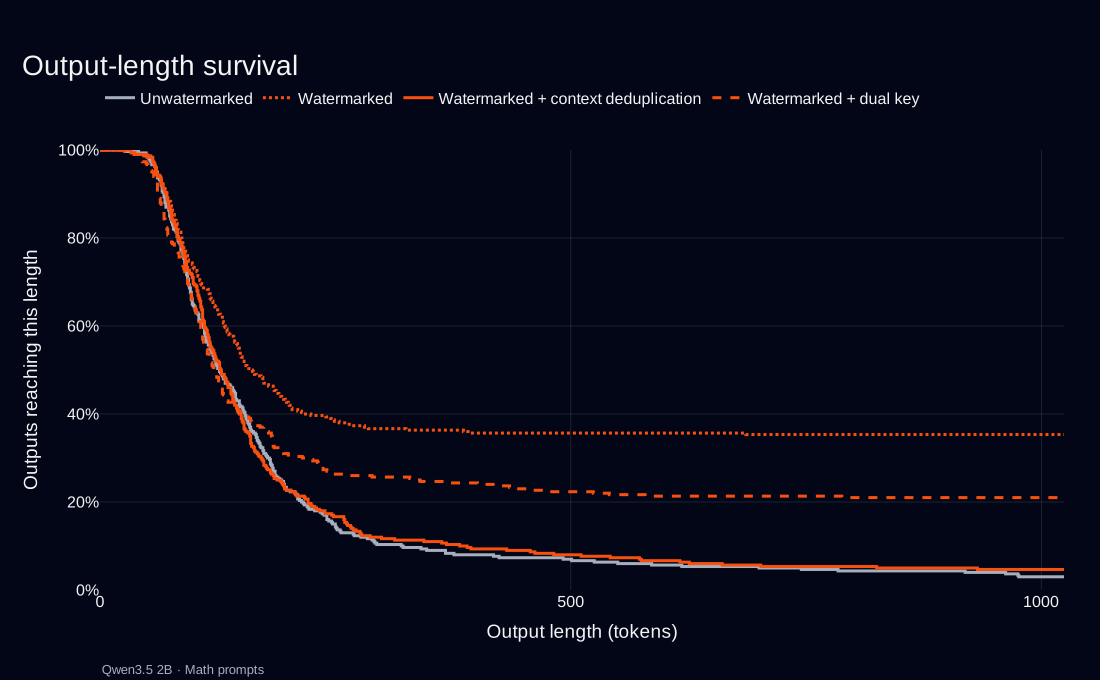
Qwen3.5-2B の数学プロンプトにおける出力長の生存曲線。通常のウォーターマークは打ち切られた超長出力を大量に生み、デュアルキーはその超過分を減らし、文脈の重複排除はウォーターマークなしのデコーディングと一致する。
vLLMは生成時の文脈重複排除(PR #56233)でこの問題を解決した。文脈が繰り返されたらウォーターマークをスキップし、単一系列の非歪曲性を保つ。各ステップで前回の生成に重複文脈がないか確認するにもかかわらず、Qwen3.5-27Bでのエンドツーエンドのスループット低下は最大0.19%にとどまる。
先に述べたデュアルキーのウォーターマーク方式も活かせる。トークンが目標分布から来るかドラフト分布から来るかのランダム性が、こうした好ましくない挙動を和らげ、系列間の多様性を高めるからだ。より一般には、投機的デコーディングを使わなくても、生成時にどちらのキーを使うかをランダムに選べばデュアルキールーティングを実現できる [5]。
クイックスタート
vLLMサーバーを起動するときにGumbel-maxウォーターマークを有効にできる。
vllm serve mistralai/Mistral-7B-Instruct-v0.3 \
 --watermark-config '{"algorithm":"gumbel","key":42}'
vLLMは最小構成のHTTP検出サーバー例も提供しており、対応するtokenizerとウォーターマークキーでテキストを検査できる。設定と検出の例はウォーターマークのドキュメントを参照。
結論
vLLMはGumbel-maxアルゴリズムに基づく無歪曲ウォーターマークをサポートするようになった。効率的なGPU生成と投機的デコーディングに対応している。評価では、出力の品質と多様性を保ちながら、性能オーバーヘッドはごくわずかであることが示された。
謝辞
本稿を丁寧にレビューしフィードバックをくれたWassim Bouaziz、Andy Lo、Nicolò Lucchesi、Victor Paltz、Leila Saidi、Mickaël Seznecに感謝する。実装とレビューに貢献したLucas Wilkinsonにも感謝する。
付録
スループットの測定
測定はQwen3.5-27B、H100 1枚、MTP-3、出力512トークンで行った。スループットは8つのウォーターマークキーと4つのウォーターマークなし対照の中央値。
| Batch size | ウォーターマークなし中央値(tok/s) | ウォーターマークあり中央値(tok/s) | ペア差の平均 | 95% CI |
|---|---|---|---|---|
| 1 | 113.9 | 113.9 | −0.23% | [−1.00%, +0.53%] |
| 2 | 218.2 | 218.5 | −0.30% | [−2.87%, +1.08%] |
| 4 | 420.5 | 413.7 | −1.11% | [−2.36%, +0.14%] |
| 8 | 753.9 | 767.3 | +0.77% | [−0.99%, +2.72%] |
| 16 | 1364.8 | 1358.7 | +0.02% | [−1.06%, +1.61%] |
| 32 | 1378.8 | 1407.9 | +2.03% | [+0.59%, +3.46%] |
| 64 | 1439.9 | 1427.3 | −1.10% | [−2.59%, +0.77%] |
| 128 | 1568.5 | 1574.5 | +0.36% | [−1.14%, +2.04%] |
| 256 | 1590.7 | 1586.5 | −0.58% | [−1.92%, +0.77%] |
参考文献
-
Ingemar J. Cox、Matthew L. Miller、Jeffrey A. Bloom、Jessica Fridrich、Ton Kalker 著「Digital Watermarking and Steganography」第2版、Morgan Kaufmann(2008年)。
-
Sumanth Dathathri ほか「Scalable watermarking for identifying large language model outputs」Nature 634、818–823(2024年)。Supplementary information, §G.3。
-
John Kirchenbauer、Jonas Geiping、Yuxin Wen、Jonathan Katz、Ian Miers、Tom Goldstein 著「A Watermark for Large Language Models」Proceedings of the 40th International Conference on Machine Learning(2023年)。
-
Scott Aaronson、Hendrik Kirchner 著「Watermarking GPT outputs」2023年。
-
Tom Sander ほか「TextSeal: A Localized LLM Watermark for Provenance & Distillation Protection」arXiv:2605.12456(2026年)。