vLLM中的水印技术
文本水印要在输出分布、鲁棒性与检测成本之间权衡。vLLM 这篇讲了红绿列表、Gumbel 噪声采样等几类方案,以及它们各自在什么条件下会被破坏。
中文
复制
什么是文本溯源,为什么它很难做?
要让我们分享的信息建立起信任与问责机制,确认数字内容的来源至关重要。水印提供了一种解法:它通过改动作品来嵌入关于这条内容的信息 [1],比如它的来源。图像和音频可以把水印作为细微的扰动嵌入,但文本是离散的,这类技术用不上。于是我们不去扰动文本本身,而是干预生成过程,让改动可被检测,同时不改变模型本应输出的分布。 给文本加水印既是科学问题,也是工程问题,要落地就得在几项要求之间取得平衡:
不扭曲输出
加水印不应改变模型的预期输出分布 [2]:它不应系统性地偏向某些词、某种写作风格或某类解法。
鲁棒性
生成的文本可能被以各种方式改动:删减、编辑、与其他语料混合,甚至被另一个 LLM 改写。好的水印系统要能在这些改动之下仍然保留来源信号。
速度
加水印给生成和检测带来的延迟与内存开销应当尽可能小。在 vLLM 这类高吞吐的推理引擎中,这一点尤其重要。性能下降有两个来源:一是对调度延迟敏感的小模型,二是词表很大的模型。
检测依赖尽可能少
检测文本水印所需的信息应当尽可能少:想知道某段文字出自何处的用户,未必掌握关于其来源的额外信息,比如创作日期,或者可能是哪个语言模型生成的。 这些期望彼此拉扯:信号强、容易检测,可能就意味着要大幅改变模型的输出;而不依赖额外信息,又会限制我们能用的算法。 举个例子:
- 附加在文件上的元数据可以被剥离,把数据复制到新文件后也不会保留。
- 红绿列表 [3] 和直接对数据加水印都会导致输出分布失真。
- Unicode 替换很容易被移除和篡改。
- 文本建模手段(例如看句子长度、不常见的词和表达)并不可靠。
- 锦标赛采样 [2] 需要多轮处理,想在不拖慢推理速度的前提下高效实现并不容易。
为了满足这些条件,我们利用了语言模型生成的一个固有特性:随机性。
利用 LLM 中的随机性
每生成一步,语言模型会为所有可能的下一个 token 分配概率,然后采样其中一个。这个过程在一条由各种可能续写构成的树中走出一条路径:其中一些路径比其他路径更可能出现,但很多路径都是合法的最终输出。 普通的随机采样在每一步都会抽取并丢弃新的随机值。水印则不同,它从最近的上下文和每个候选 token 推导出可复现的带密钥值。由于上下文和选中的 token 都会留在输出里,持有密钥的检测方可以在生成结束后重建这些值。带水印的文本会系统性地与这些值对齐,只要序列足够长,这个信号就会不断累积。 下一节讨论我们如何实现这一过程,同时仍然保持模型最初的采样分布,从而能够可复现地在模型若干可能的最终输出中选定一个。
Gumbel-max 技巧
Gumbel-max 技巧是一种从类别分布中采样的方法。假设模型为每个候选 token 分配了概率:对每个 token,我们抽取独立的均匀随机变量,并把它们变换为 Gumbel 随机变量:
采样得到的 token 就是:
这个变换有一个漂亮的结果:
换句话说,把 Gumbel 噪声加到 token 的对数概率上再取 argmax,得到的类别分布与普通随机采样完全一致:事实上,Model Runner v2 的标准采样路径已经在用这个过程。实践中,我们可以直接把 Gumbel 噪声加到 logits 上,省去 softmax,也让计算更容易并行。
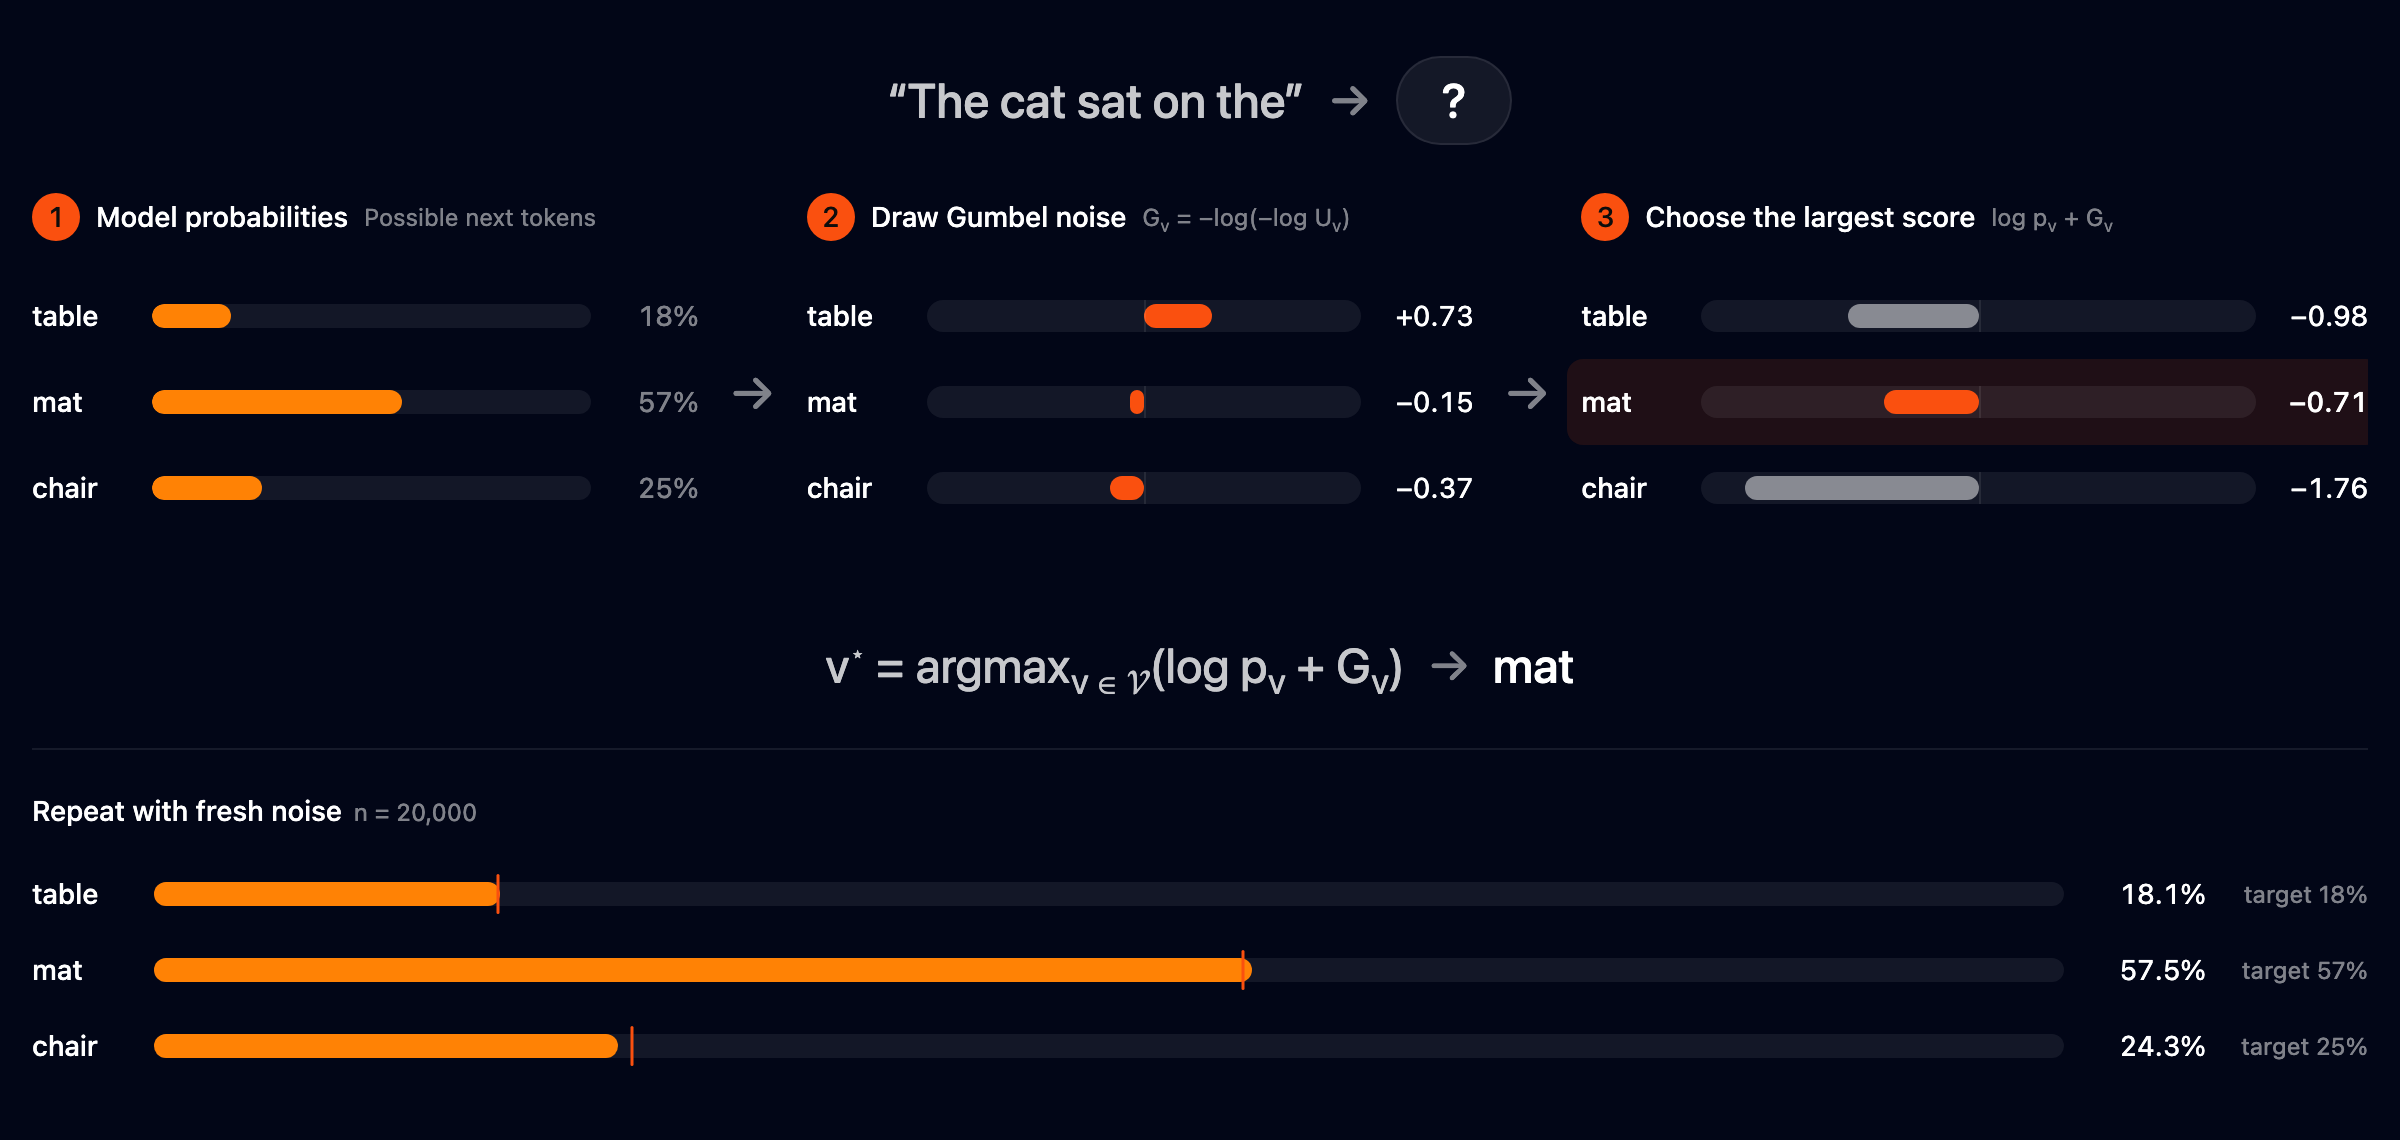
Gumbel-max 采样示例:table、mat、chair 的模型概率与 Gumbel 噪声叠加。“mat”在一次抽样中胜出,而重复 20,000 次后,结果接近原始的 18%、57%、25% 分布。
为了让这些随机抽样可复现,我们使用伪随机函数(PRF)[4]。PRF 确定性地将密钥和输入映射为一个表现得像均匀随机抽样的值:相同的输入总是产生相同的输出,因此检测方可以重建生成过程中使用的值。我们把每一次独立的均匀抽样替换为:
其中是秘密水印密钥,是近期水印上下文(最后几个 token)。 加入 token ID 很重要,因为它让每个 token 获得不同的噪声;近期上下文(默认使用最后 4 个 token)意味着我们施加的随机噪声在几乎每个生成步骤都不同;而秘密密钥让这一模式对没有密钥的人不可预测。 生成器为每个候选 token 计算这些带密钥的值,并选择加噪后对数概率最大的 token。给定相同的密钥和上下文,这一选择可以复现;但没有密钥时,它看起来就是一次普通的随机抽样。
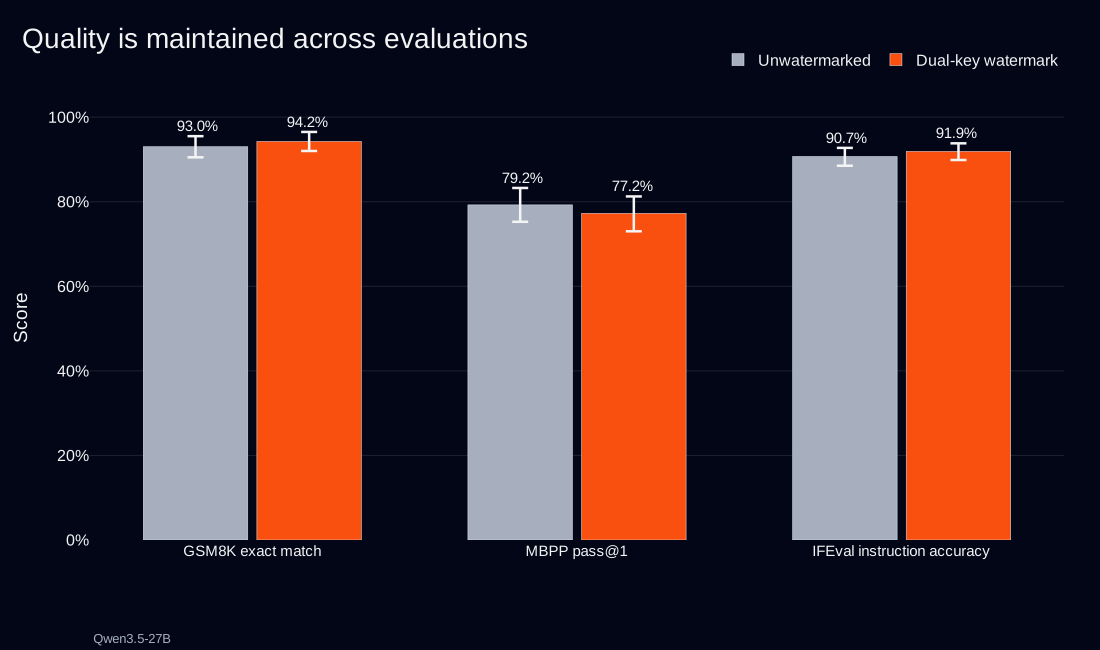
柱状图比较 Qwen3.5-27B 在使用和不使用双密钥水印时的质量:GSM8K 93.0% 对 94.2%,MBPP 79.2% 对 77.2%,IFEval 90.7% 对 91.9%,误差棒重叠。
这为该方法提供了精确的无失真保证:在密钥上取期望时,选择 token 的概率仍然恰好是。但仅凭这一点,并不能保证完整序列也无失真。我们会在“保持输出多样性”中进一步讨论这一局限及其解决办法。
检测水印
检测时,我们逆转生成过程。检测不需要访问模型的权重或 logits,但需要知道秘密密钥和 tokenizer。 用户会把一段来源未知的文本交给检测器。检测器将文本转换回 token ID。对于每个 token,检测器使用其前面的上下文和秘密密钥重新计算它的伪随机值:
对于无水印文本,观测到的 token 与其键控值相互独立,因此表现得像一个均匀随机变量。而有水印的生成则会更倾向于键控值较大的 token。我们把每个键控值转换成一个 token 级分数:
由于重复出现的上下文会重建出相同的键控值,检测器对每个上下文只计分一次。如果文本没有水印,这些分数服从均值为 的指数分布。它们的和
因此服从形状参数为 、尺度参数为 的 Gamma 分布。由此可以计算单侧 p 值:即无水印文本产生不低于 的分数的概率。p 值越小,越说明该文本与嵌入的水印相符。
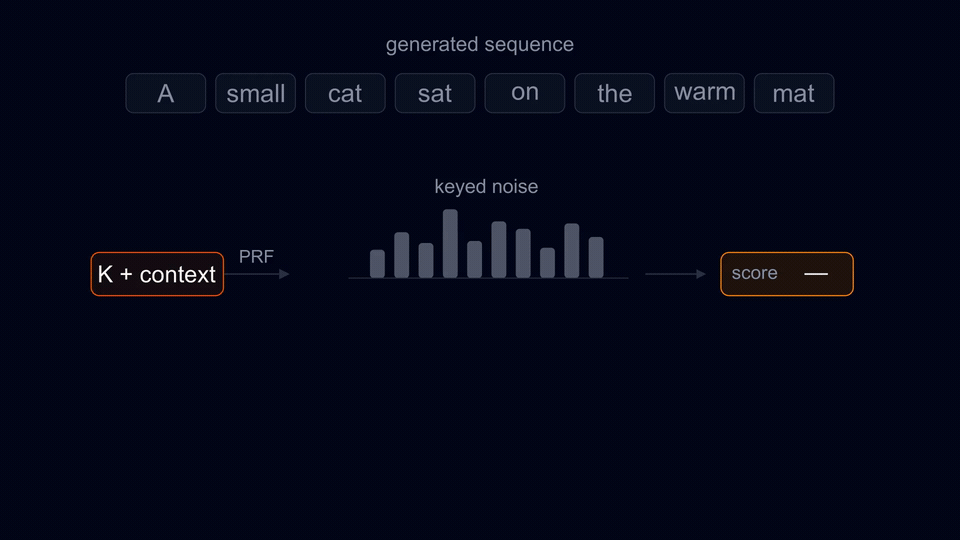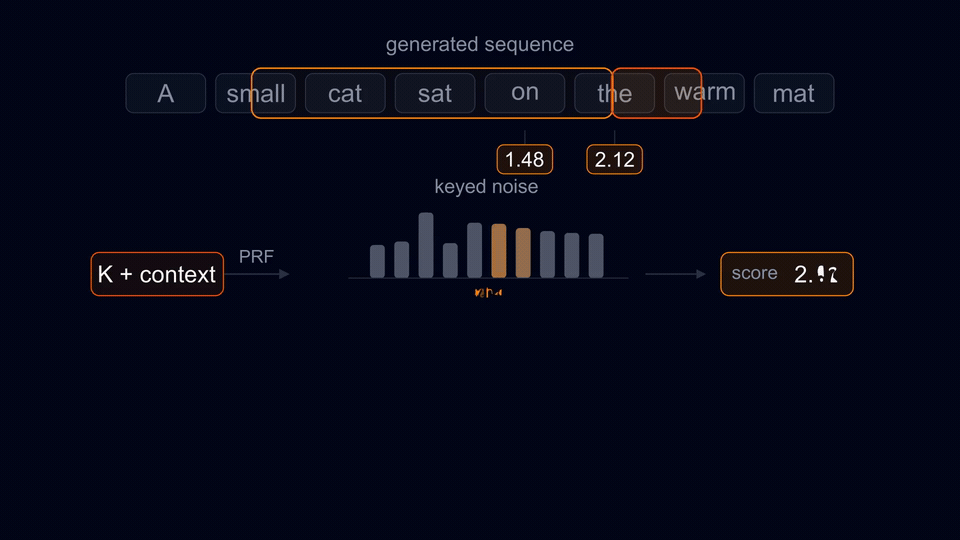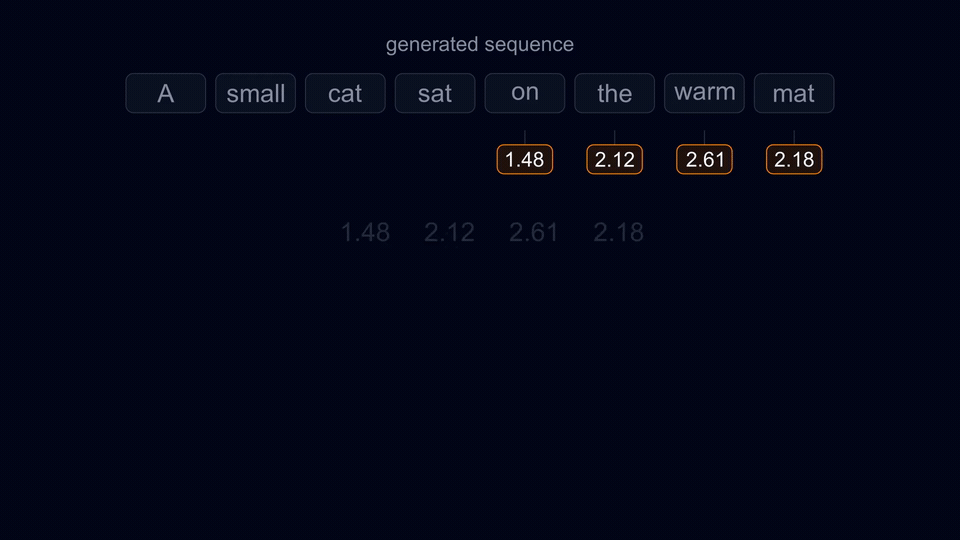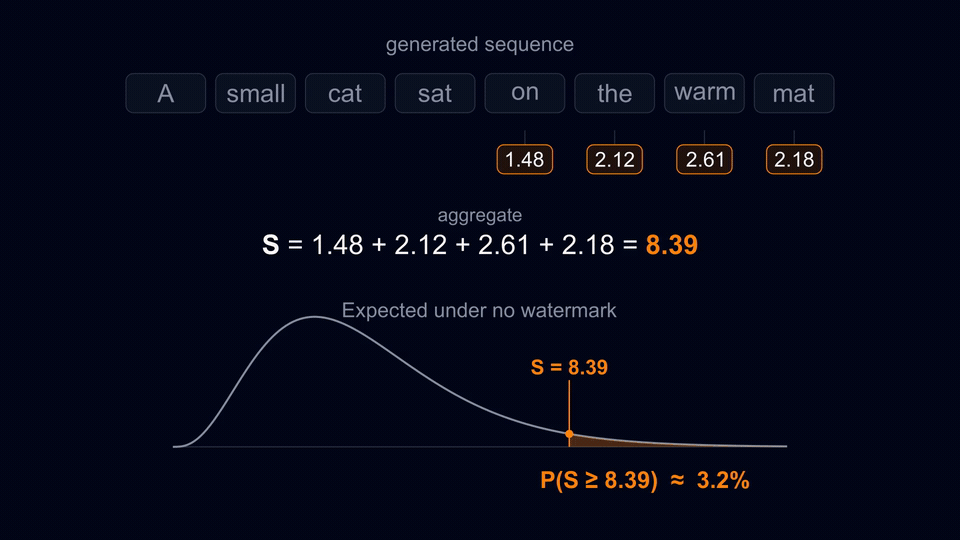
水印检测动画:每个 token 的密钥和它前面的上下文重建出键控噪声,进而得到一个 token 分数。所有分数求和后,与无水印情况下的 Gamma 分布比较,得到 p 值。
选择阈值就是在假阳性和假阴性之间做权衡。对于校准过的检验, 会把大约 1% 的无水印序列判为阳性。实际使用中,我们还可能针对多个密钥、tokenizer 或水印配置分别做检验。这会提高偶然出现高分的概率,因此需要做多重检验校正。候选越多,阈值就越低,检测能力也随之下降。
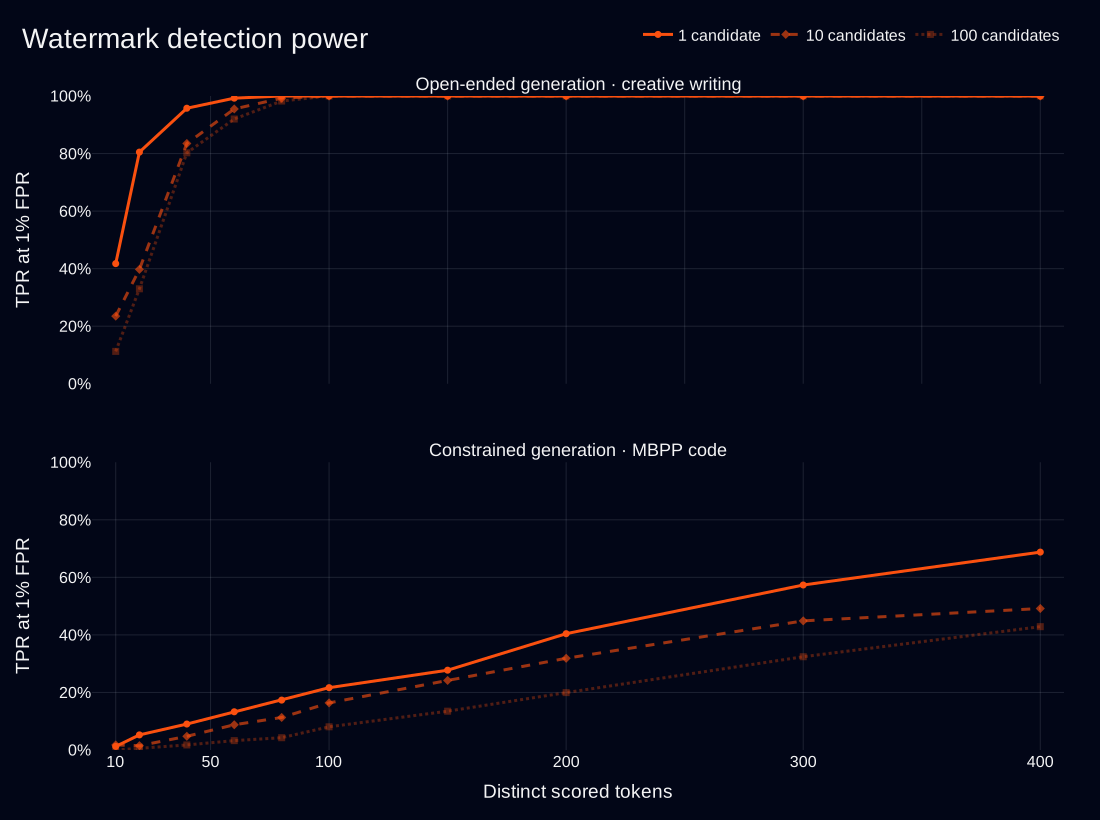
在 1% 假阳性率下,1、10、100 个候选检验的水印检测能力随不同计分 token 数的变化。创意写作在约 100 个 token 时接近 100% TPR;MBPP 上升更慢,在 400 个 token 时分别约为 69%、49% 和 43%。
检测会随着独立证据的积累而变得更可靠:输出越长,可供打分的 token 越多;高熵步骤越多,水印影响 token 选择的机会也越多。因此,短输出或可预测的输出提供的信号更弱。
由于信号编码在 token 选择本身之中,复制粘贴一段足够长的文本会保留其证据。修改文本会扰乱被修改 token 附近的分数,但一旦这些 token 不再处于后续 token 的近期上下文中,信号依然完整。
vLLM 中的实现方式
该实现最初在 watermarking RFC 中提出,其中指出水印必须与最终 token 采样和投机解码集成。因此我们将其直接接入 Model Runner v2 的采样流水线。初始实现(PR #54053) 将 GPUWatermarkSampler 连接到算法专属的 Watermarker,让不同方案共用同一套请求与批处理逻辑。
朴素实现会实际生成一个 [batch, vocabulary] 噪声张量,带来大量临时存储和内存流量。vLLM 则将伪随机数生成、Gumbel 变换和 argmax 归约融合进单个 GPU kernel。Philox 每次调用生成四个值,因此该 kernel 可以一次处理四个连续的 token ID。
逐行掩码让同一个融合采样器既能对有水印的请求使用带密钥的噪声,也能对无水印请求或重复上下文使用普通随机数。
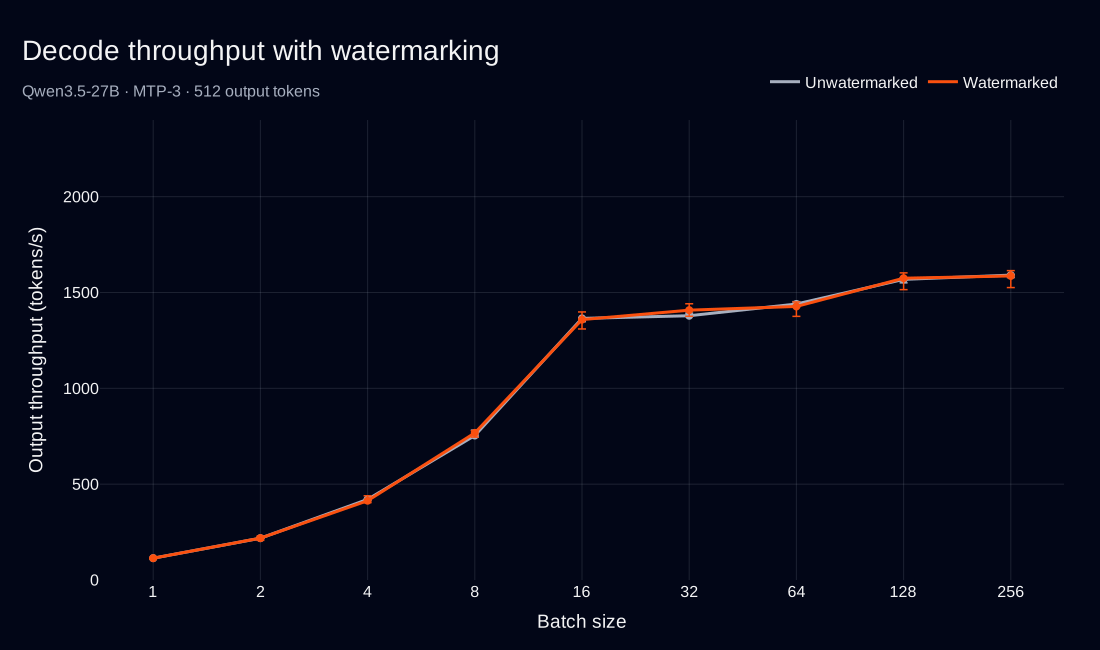
Qwen3.5-27B 在 MTP-3 下、batch size 1–256 的解码吞吐量。有水印与无水印两条曲线全程高度重合,吞吐量没有一致的变化。
在八个密钥上,各 batch size 下匹配吞吐量的平均变化范围为 −1.1% 到 +2.0%,没有明显的性能下降。
挑战
水印技术面临一些重大挑战,需要格外巧妙的解决方案。下文讨论其中最重要的两个:与投机解码的交互,以及输出多样性的下降。
投机解码
投机解码从草稿分布中提出 token,再依据目标分布决定是否接受。对两个分布施加相同的水印,各自的分布都能保持不变,但两者的重叠会缩小,接受率随之下降。vLLM 的做法是采用双密钥实现(PR #56122):一个密钥用于被接受的草稿 token,另一个用于目标残差 token 和 bonus token。把密钥分开,既保住了原本的接受率,也让目标采样不受被拒绝草稿提议的影响。 最终文本中的 token 由两个密钥之一加水印,因此打分时必须同时使用两个密钥并合并分数。可惜这会稀释两个密钥各自的信号,导致检测信号变弱。
这种加权可以校准,以同时反映每个 token 的预期来源以及它携带多少信号。例如,草稿 token 在“容易”因而熵较低时更容易被接受,这意味着它们携带的水印信号更少。
保持输出多样性
单 token 非失真只保证每一步生成时的分布不变,不保证整条序列上的分布不变。如果上下文重复出现,其密钥噪声也会重复,于是本该由普通采样独立做出的 token 选择被关联起来(见下例)。单序列非失真则是更强的保证:完整序列上的分布同样不变。 例如,设想一个固定密钥让模型生成如下序列:
1 + 1 + -> 1 context: (1, +, 1, +)
1 + 1 + 1 -> + context: (+, 1, +, 1)
1 + 1 + 1 + -> 1 context: (1, +, 1, +)
在再次生成 1 之后,上下文 (1, +, 1, +) 就重复了。固定密钥因此产生出与之前相同的伪随机值,而这些值此前正是偏向生成 1 的。如果模型的概率也相近,或者偏置足够强,它很可能再次选中 1:这种情况下,生成可能陷入无限重复的循环。
1 + 1 + 1 + 1 + 1 + (...)
这是最坏的情况,但跨上下文的相关性通常会导致序列内多样性下降、退化行为增多、生成长度增加以及输出质量降低。
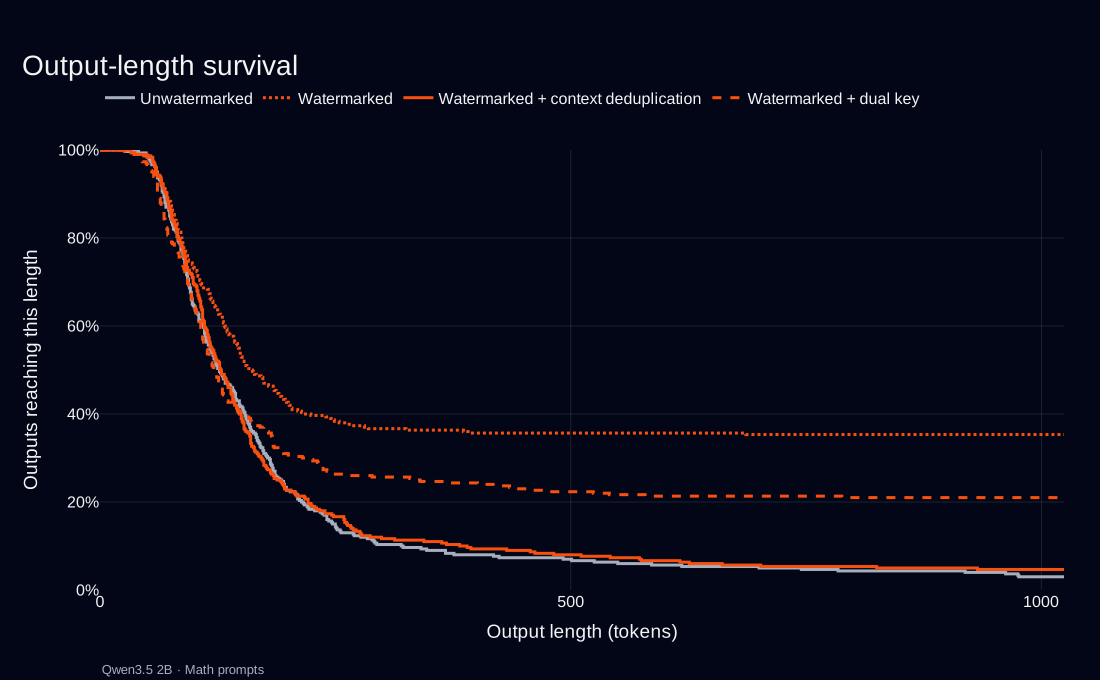
Qwen3.5-2B 数学提示词上的输出长度存活曲线:普通水印产生大量被截断的超长输出,双密钥减少了超额部分,上下文去重则与无水印解码一致。
vLLM 通过生成时上下文去重(PR #56233)解决了这个问题:只要上下文重复就跳过水印,从而保持单序列的无失真性。尽管每一步都要检查前一次生成是否存在重复上下文,它在 Qwen3.5-27B 上的端到端吞吐量最多只下降了 0.19%。
我们也可以利用前面讨论过的双密钥水印方案,因为 token 来自目标分布还是草稿分布的随机性,会减轻这种不良行为的影响,并提升序列之间的多样性。更一般地说,即使不做投机解码,也可以在生成时随机选择使用哪个密钥,从而实现双密钥路由 [5]。
快速上手
启动 vLLM 服务器时即可启用 Gumbel-max 水印:
vllm serve mistralai/Mistral-7B-Instruct-v0.3 \
 --watermark-config '{"algorithm":"gumbel","key":42}'
vLLM 还提供了一个最简 HTTP 检测服务器示例,用匹配的 tokenizer 和水印密钥检查文本。配置和检测示例见水印文档。
结论
vLLM 现已支持基于 Gumbel-max 算法的无失真水印,具备高效的 GPU 生成和投机解码支持。我们的评估显示,性能开销极小,同时保持了输出质量和多样性。
致谢
感谢 Wassim Bouaziz、Andy Lo、Nicolò Lucchesi、Victor Paltz、Leila Saidi 和 Mickaël Seznec 对本文的细致审阅与反馈,也感谢 Lucas Wilkinson 在实现和审阅方面的贡献。
附录
吞吐量测量
测量基于 Qwen3.5-27B,单张 H100,MTP-3,输出 512 个 token。吞吐量取八个加水印密钥与四个未加水印对照的中位数。
| Batch size | 未加水印中位数(tok/s) | 加水印中位数(tok/s) | 配对变化均值 | 95% CI |
|---|---|---|---|---|
| 1 | 113.9 | 113.9 | −0.23% | [−1.00%, +0.53%] |
| 2 | 218.2 | 218.5 | −0.30% | [−2.87%, +1.08%] |
| 4 | 420.5 | 413.7 | −1.11% | [−2.36%, +0.14%] |
| 8 | 753.9 | 767.3 | +0.77% | [−0.99%, +2.72%] |
| 16 | 1364.8 | 1358.7 | +0.02% | [−1.06%, +1.61%] |
| 32 | 1378.8 | 1407.9 | +2.03% | [+0.59%, +3.46%] |
| 64 | 1439.9 | 1427.3 | −1.10% | [−2.59%, +0.77%] |
| 128 | 1568.5 | 1574.5 | +0.36% | [−1.14%, +2.04%] |
| 256 | 1590.7 | 1586.5 | −0.58% | [−1.92%, +0.77%] |
参考文献
-
Ingemar J. Cox, Matthew L. Miller, Jeffrey A. Bloom, Jessica Fridrich, and Ton Kalker. “Digital Watermarking and Steganography.” 2nd ed., Morgan Kaufmann (2008).
-
Sumanth Dathathri et al. “Scalable watermarking for identifying large language model outputs.” Nature 634, 818–823 (2024). Supplementary information, §G.3.
-
John Kirchenbauer, Jonas Geiping, Yuxin Wen, Jonathan Katz, Ian Miers, and Tom Goldstein. “A Watermark for Large Language Models.” Proceedings of the 40th International Conference on Machine Learning (2023).
-
Scott Aaronson and Hendrik Kirchner. “Watermarking GPT outputs,” 2023.
-
Tom Sander et al. “TextSeal: A Localized LLM Watermark for Provenance & Distillation Protection.” arXiv:2605.12456 (2026).