x86-64とaarch64をいつ選択するか
x86-64 と aarch64 のどちらを選ぶかは、Postgres がファイルをどう読むかで決まる。記事は両者の違いと、新しいアプリでどちらを選ぶべきかを整理する。
日本語
コピー
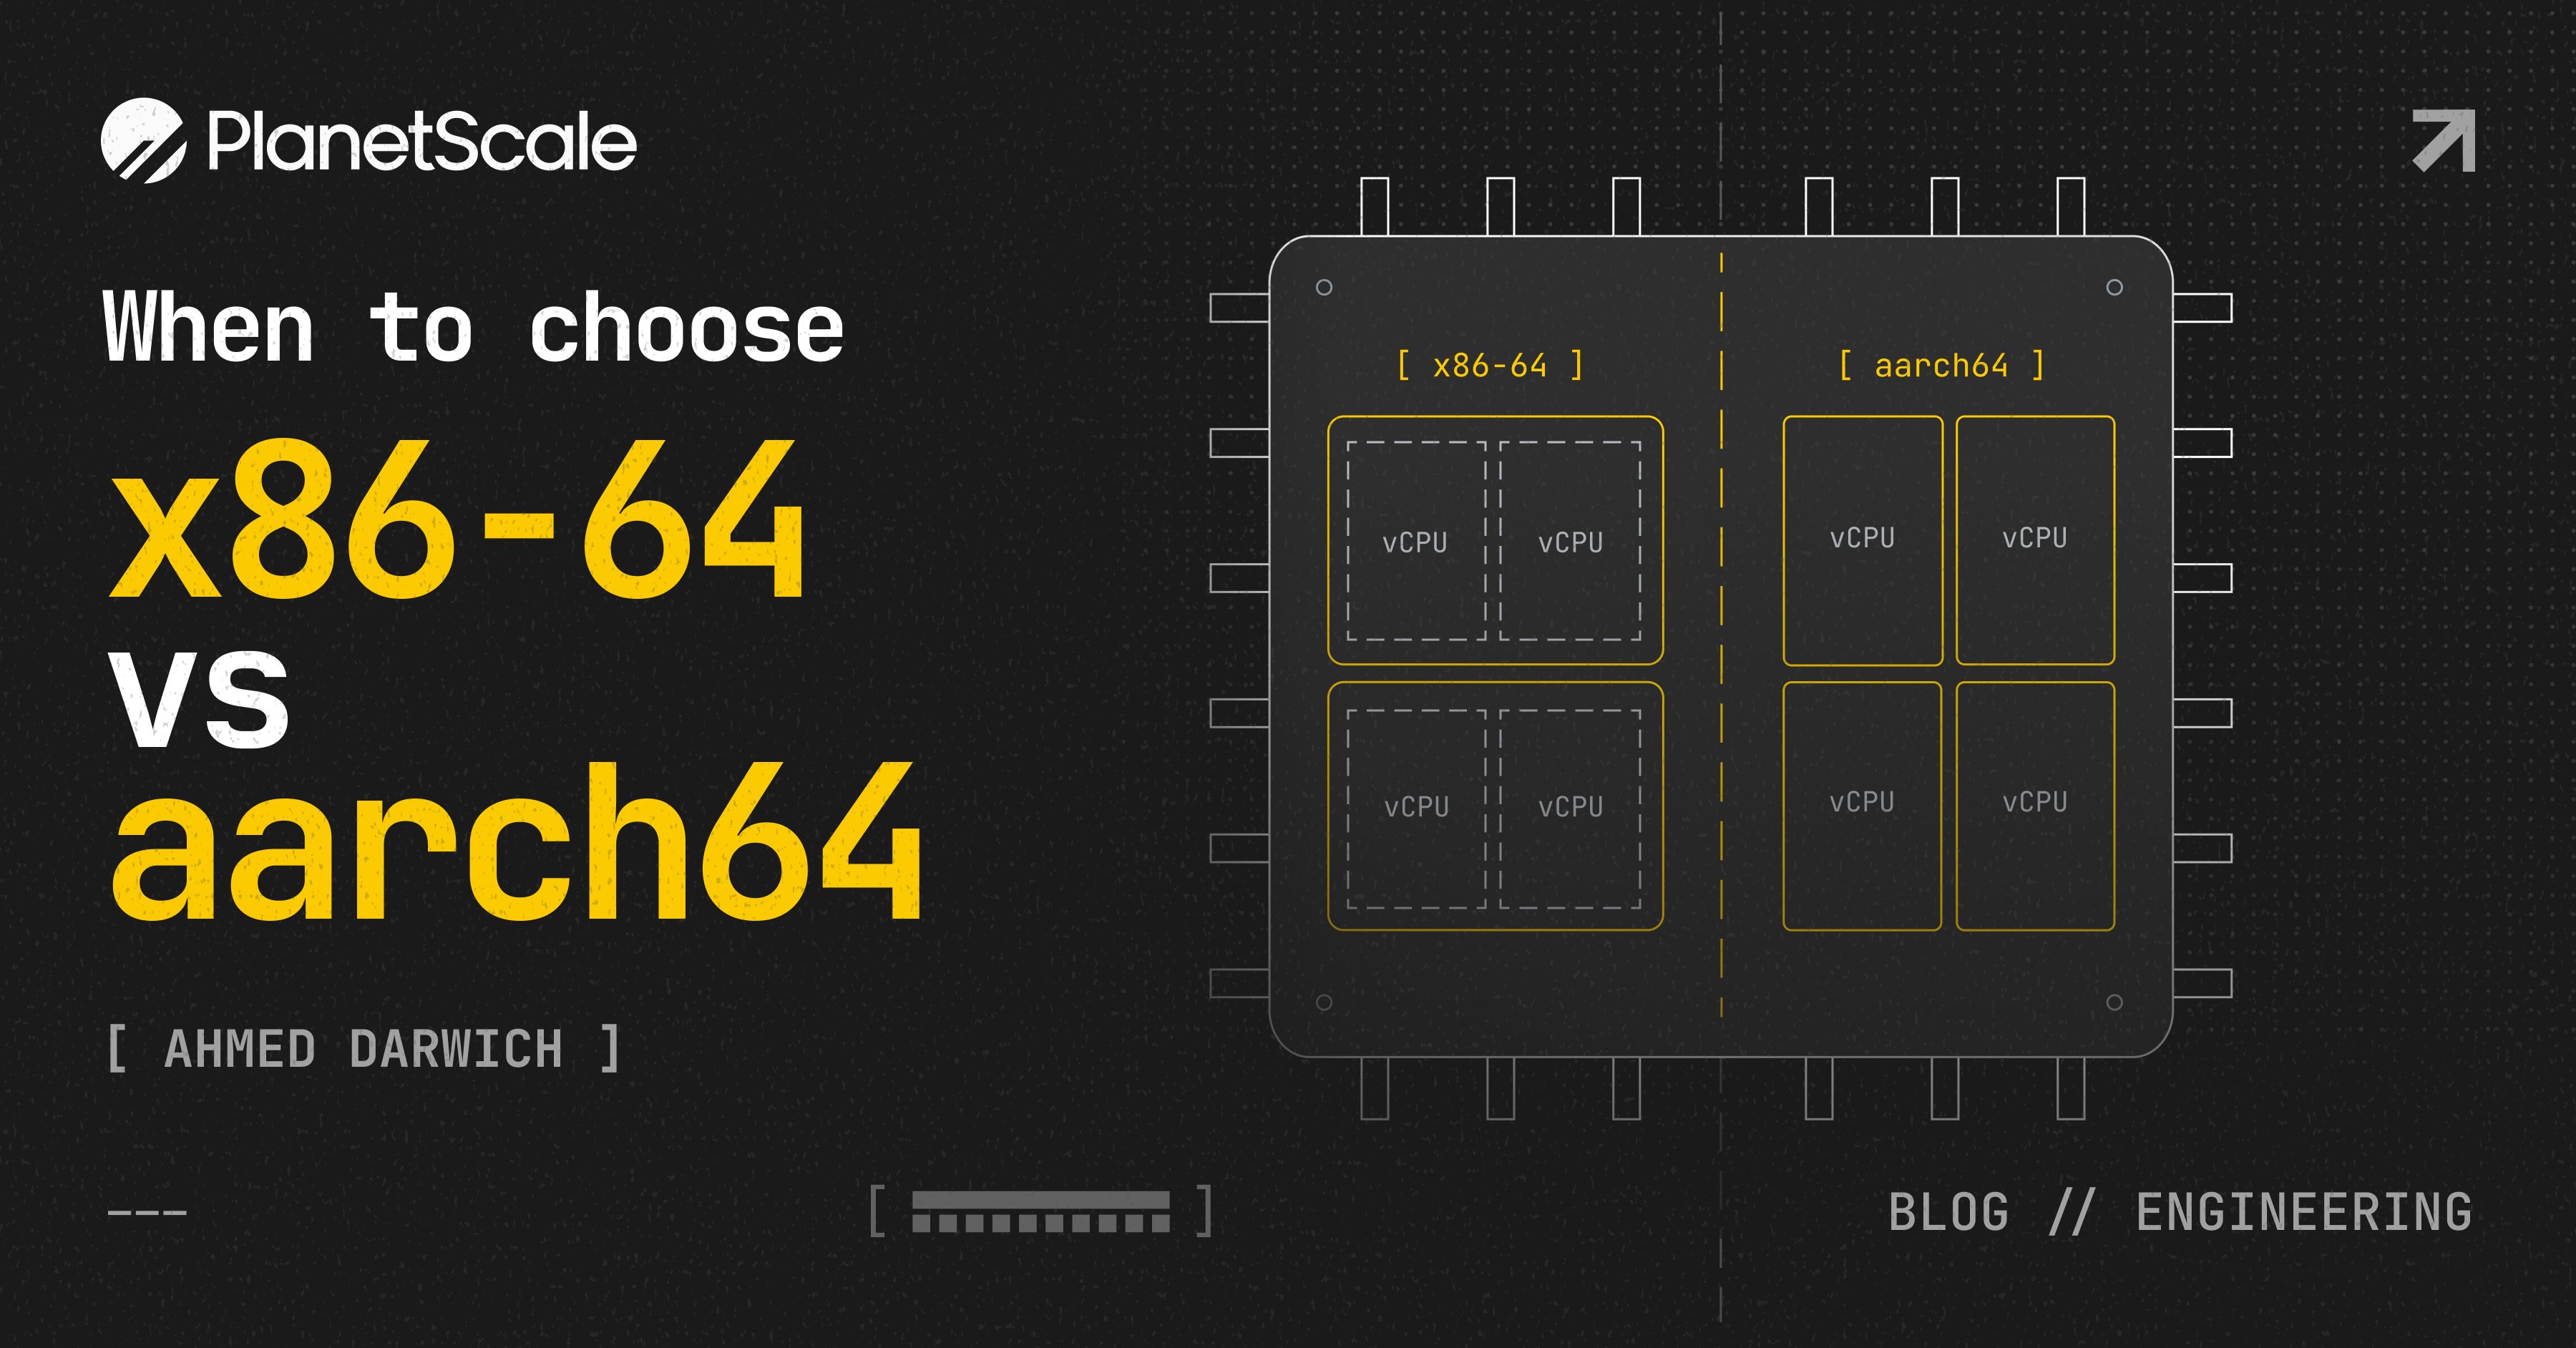
クラウド上の vCPU はどれも同じではない。
PlanetScale で Postgres や Neki のデータベースを作るときは、aarch64(ARM)か x86-64 のどちらかを選ばなければならない。vCPU 数もメモリも同じ2つのクラスタでも、アーキテクチャが違えば性能は大きく変わりうる。クラスタを作成したあとに CPU アーキテクチャを簡単に変更することはできないので、この違いは事前に把握しておく価値がある。
ARM と x86 は別々の問題を解くために生まれた
x86 はデスクトップの世界で育ち、後方互換性と性能を優先してきた。1978年に Intel で生まれ、IBM が初代 PC に x86 プロセッサを採用したことで、パソコンの標準となった。
最初の ARM プロセッサを開発したのはイギリスの Acorn だ。製造コストを抑えるため、同社は安価なプラスチックパッケージを使いたいと考えていた。チップの過熱を避けるため、チームは消費電力の予算を1ワットに定めた。
1985年4月、Acorn のエンジニアがこのチップに初めて電源を入れると、動きはしたものの電力計の針はゼロを指していた。テストボードの不具合でチップが電源にまったく接続されておらず、周囲の回路から漏れてくる電流だけで動いていたのだ。正しく電源に接続すると消費電力は約0.1ワットで、1ワットの予算を大きく下回った。ARM の設計者 Sophie Wilson は後に、この電力効率はまったくの偶然だったと語っている。
ARM の低消費電力は携帯電話にうってつけだった。データセンター事業者が電気代と冷却コストを削減する方法を模索し始めると、この電力効率はサーバーにとっても魅力的になった。現在 AWS と Google はそれぞれ Graviton と Axion という、クラウドサーバー向けの ARM プロセッサを自社開発している。
CPU アーキテクチャが Postgres に与える影響
データベースにとっての違いは、まずクラウド事業者が vCPU をどう数えるかに表れる。
ハイパースレッディングとは
CPU コアは複数の実行ユニットを持つが、単一のスレッドでそれらをすべて動かし続けることはほとんどない。たいていの時間、スレッドはメモリからのデータを待って止まっている。ハイパースレッディングでは、1つのコアに2つのスレッドを同時に載せる。片方が止まれば、コアはもう片方のスレッドの命令を実行する。厨房に2人の料理人がいる様子を思い浮かべればいい。より多くの料理を作れるが、オーブンと流しは共有だ。ハイパースレッディングに対応した x86 インスタンスでは、クラウド事業者はスレッド1つを vCPU 1つとして販売している。AWS Graviton や Google Axion といった ARM のサーバーチップはハイパースレッディングを使わない。vCPU 1つがコア1つそのもので、それぞれに専用のオーブンと流しがある。
大量の並行クエリか、1つの重いクエリか
ここが ARM の得意分野だ。大量のクエリが同時に押し寄せる場面では、コアの多さが効いてくる。たとえばネットショップなら、何百人もの顧客のために同時に商品を検索し、在庫を確認し、カートを更新することになる。1つ1つのクエリは小さいが、データベースはそれらを各コアに分散できる。コアには余裕もあるので、並列クエリの worker や autovacuum(Postgres のバックグラウンド整理プロセス)を業務クエリと並行して動かせる。一方、レポート用ダッシュボードを考えてみよう。数百万件の売上レコードを集計するのに数秒かかるクエリが1つある。このクエリが CPU バウンドで、並列 worker も使わないなら、コアが増えても速くはならない。ここで効くのは単一コアの速度であり、これが x86 が通常優位に立つ点だ。x86 のサーバーチップは一般にクロック周波数(コアが命令を実行する速さ)が高く、1つのコアで1つのクエリをより速く処理できる。
より幅広いベクトルレジスタ
コアの性能は、1命令でどれだけの処理ができるかにも左右される。複数の値をまとめて扱う命令がある。2つの32ビット数値のリストを比較するとしよう。ベクトル命令なら一度に何組も比較できる。128ビットベクトルなら4組、256ビットなら8組、512ビットなら16組だ。ベクトルが広いほど1命令で扱えるデータが増え、同じ処理に必要な命令数が減る。x86 では AVX2 が256ビットベクトルを使うベクトル命令群にあたる。一部のチップは AVX-512 にも対応し、幅を512ビットに広げる。AWS の ARM サーバーチップ Graviton4 と Graviton5 は128ビットベクトルを使う。TIN は PlanetScale が Postgres 向けに作った全文検索インデックスで、ビットマップの比較にベクトル命令を使う。ページ単位のビットマップはそれぞれ256ビットを持ち、各ビットが、あるデータベースページに検索語が含まれるかどうかを表す。articles という名前のテーブルに body というテキスト列があるとして、TIN インデックスを作れば “postgres” と “replication” の両方を含む記事を検索できる。
CREATE INDEX articles_body_tin ON articles USING tin (body);

SELECT *
FROM articles
WHERE body ==> 'postgres AND replication';
==> 演算子が TIN 検索を実行する。TIN は2つの語のビットマップを交差させ、両方の語を含む可能性のあるページを絞り込む。x86 では AVX2 の AND 1命令で256ビットすべてを一度に交差できる。pgvector はベクトル類似度検索のための Postgres 拡張で、こちらも x86 向けの専用最適化をいくつか備えている。その AVX-512 のコードは Hamming 距離と Jaccard 距離を計算し、2つのビットベクトル間の差異や重なりを測る。ARM ではこれらの計算は汎用のコードパスを通る。こうした理由から、一部のインデックス種別では x86 が明確に有利だ。
なぜ既存クラスタではアーキテクチャを変更できないのか
Postgres はどちらのアーキテクチャでも動くが、ディスクに書き出すファイルは両者で互換性がない。Postgres データベースを新しいハードウェアへ移すときの定石は、移行先にレプリカを立ててからプライマリに昇格させることだ。アーキテクチャをまたぐ場合はこの手が使えない。理由はレプリカの作り方にある。レプリカはデータベースを一から再構築するのではなく、まずプライマリのディスクファイル(テーブルとインデックスを含む)のバイト単位のコピーを受け取り、write-ahead log——すべての変更を記録した台帳——を再生して同期を保つ。このファイルの解釈が2台のマシンで食い違えば、誤った結果を計算しかねない。pg_trgm は Postgres で高速なテキストマッチングや類似度検索に使われる拡張機能で、この問題がどれほど微妙になりうるかを示している。設計当時、インデックスを異なるアーキテクチャ間で持ち運ぶことは想定されていなかった。Postgres は C で書かれており、C の普通の char が符号付きか符号なしかはコンパイラが決める。一般的な C コンパイラである GCC と Clang は、x86-64 Linux では char を符号付き、ARM64 Linux では char を符号なしにデフォルト設定する。つまり同じバイト 0xFF が、一方のマシンでは −1、もう一方では 255 になる。pg_trgm は char 比較を使ってインデックス内の trigram(3文字の組)を並べ替える。インデックスを別のアーキテクチャへコピーすると、新しいマシンが出す順序が元と一致しない可能性がある。Postgres はバージョン18でこの問題を解決した。だがこれは問題の本質をよく表している。バイトをコピーしても、2台のマシンがその意味を同じように解釈する保証にはならない。PlanetScale はプライマリとそのレプリカを同じ CPU アーキテクチャ上に保つ。Neki では、アーキテクチャはシャードが使う設定プロファイルに固定されている。いずれも日常的な変更には影響しない。クラスタのサイズ変更やレプリカの追加は同じアーキテクチャのまま行われるので、いつも通り使える。アーキテクチャを変えると決めたなら、新しいクラスタへ移行する必要がある。そこにテーブルとインデックスを作成し、論理レプリケーションで行データをコピーして新しい書き込みに追随させる。移行先は行データからインデックス項目を自前で構築するため、並べ替え結果は移行先自身の比較ルールと一致する。
どう選ぶか
新しいアプリケーションで、ごく普通の読み書きしかしないなら、クラスタ作成時に ARM を選ぶのは良いデフォルトだ。コストパフォーマンスが高く、並列負荷の処理にも優れている。PlanetScale では、同じ vCPU とメモリの ARM プランは通常 x86 プランより安く、差はプランとリージョンによって変わる。最新の価格は料金を参照。負荷が少数の CPU ヘビーなクエリに集中しているなら、x86 をよく検討する価値がある。性能が負荷にとって本当に重要で、それに最適なアーキテクチャを選びたいなら、ARM と x86 の別々のクラスタでそれぞれ実行してから決めよう。データと設定を揃え、ピーク時に想定される同時実行数でテストする。スループット、遅いクエリの応答時間、コストを比較する。既存の PlanetScale データベースを別のアーキテクチャへ移すには移行が必要なので、まず性能やコストの利点がその手間に見合うか確認しよう。