API 性能テスト:リアルに即したテストを設計する方法
性能テストは、インターフェースにやたらと大量のリクエストを送ることではない。著者はまず、負荷、ストレス、耐久、スパイク、キャパシティ、スケーラビリティの6種類のテストがそれぞれ何に答えるのかを説明し、次に現実に即したシナリオをどう設計するかに重点を置いて、ユーザーパスから業務量をもとにRPSを逆算するアルゴリズム、外部サービスをモックするかどうか、環境とデータベースをどう構成すべきかに至るまで解説している。
日本語
コピー
API パフォーマンステスト:リアルに即したテストをどう設計するか
パフォーマンステストという言葉は、ほとんどの人が一度は耳にしたことがあるでしょう。大きな機能をリリースする前、新しいアプリを公開する前、あるいは特定の負荷にアプリが耐えられるかどうかを確認したいだけのときにも使われます。
パフォーマンステストは、負荷がかかった状態でのアプリの振る舞いを理解し、想定されるプレッシャーに耐えられるかどうかを教えてくれます。ただし、きちんと設計されていることが前提です。そうでなければ、結果は誤解を招き、間違った結論へと導いてしまいます。
逆に、適切に設計されたパフォーマンステストは、ボトルネックの特定、アプリの限界の理解、そしてリリース前の確信につながります。
この記事では、まず基本的な概念とパフォーマンステストの種類を見ていきます。その後、より実践的な部分に入ります。リアルに即したテストシナリオをどう設計するか、アプリがどれだけの負荷に耐えるべきかをどう決めるか、外部サービスをどう扱うか、そしてテスト環境を本番にどれだけ近づけるかです。
目標は、大量のリクエストを送ることではありません。実際に役立つ情報を教えてくれるパフォーマンステストを作り、アプリが現実世界でどう振る舞うかを知ることです。
目次
- 基本的な定義
- テストの種類
- パフォーマンステストを正しく設計する方法
- 想定負荷の決定
- パフォーマンステストと外部サービス
- 環境構成
- 指標と結果
- まとめ
まずは基本的な定義と、パフォーマンステストの種類から始めましょう。
基本的な定義
パフォーマンステストとは、特定のワークロード下でのアプリの速度、安定性、拡張性、応答性を評価する、非機能的なソフトウェアテスト手法だと概括できます。
簡単にするため、API を例に考えてみましょう。負荷をかけてテストしたいエンドポイントを呼び出すテストを用意します。通常は、アプリが実際に使われる流れを表す特定の順序で呼び出します。パフォーマンステストの主な狙いは、想定負荷に耐えられないアプリをリリースしてしまうことを避けることにあります。
性能が悪いと、本番環境での障害、応答時間の悪化、あるいはアプリが制限時間内にジョブを処理しきれないといった事態が起きます。こうした問題は最終的に、顧客離れ、収益の損失、製品の評判の低下につながりかねません。
パフォーマンステストは、構成、目的、そして観察したい指標によって分類できます。
テストの種類
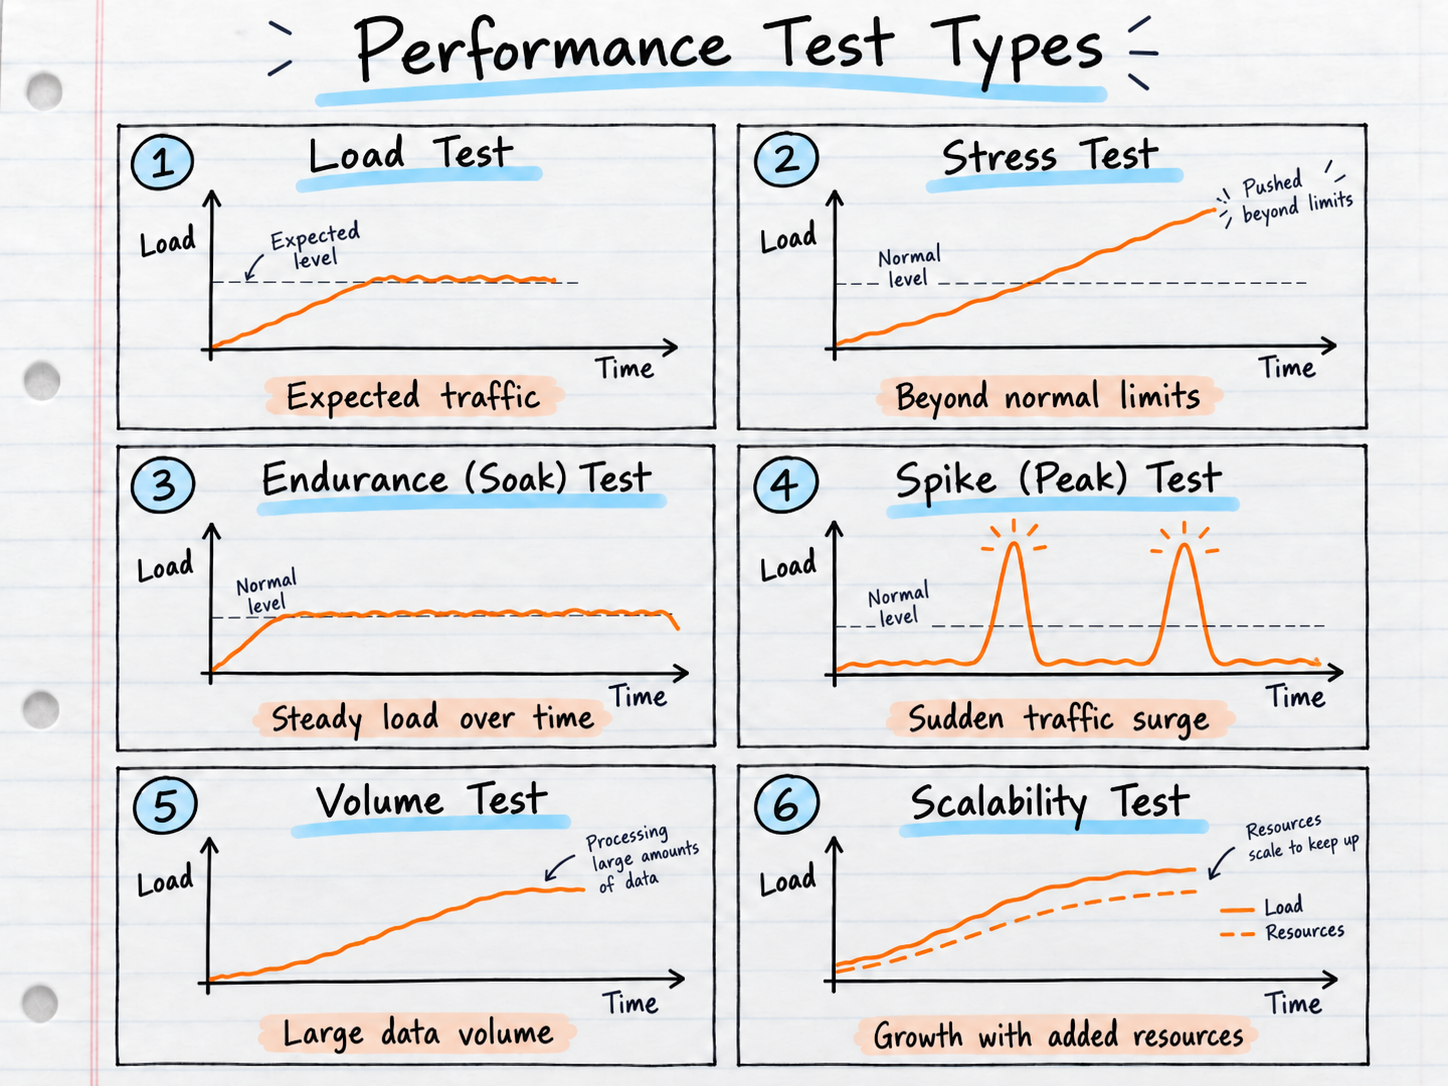
この図でほぼすべてが説明できていると思いますが、それぞれ簡単に説明します。
ロードテスト(Load tests) は、想定された、あるいは通常のトラフィックレベルでのアプリの振る舞いを検証します。目標は通常、許容できる応答時間、エラー率、リソース使用量を保ちながら、必要なユーザー数やリクエスト量にシステムが耐えられることを確認することです。
ストレステスト(Stress tests) は、アプリを想定限界を超えて押し込み、どこから劣化や失敗が始まるかを見つけます。システムの最大容量を特定し、CPU、メモリ、データベース接続、スレッドといったリソースが枯渇したときにどうなるかを観察するのに役立ちます。
耐久テスト(Endurance / Soak tests) は、持続的な負荷の下でアプリをより長時間動かします。短いテストでは現れないかもしれない問題、たとえばメモリリーク、接続リーク、リソース枯渇、時間の経過に伴う性能低下をあぶり出すのが目的です。
スパイクテスト(Spike / Peak tests) は、トラフィックの急激な増加をシミュレートします。負荷の急変に対するアプリの反応や、トラフィックが平常に戻った後に回復できるかどうかを検証するのに役立ちます。
ボリュームテスト(Volume tests) は、アプリが大量のデータを処理・扱う必要があるときの振る舞いに注目します。たとえば、データ量が平常時よりはるかに多いときに、データベースクエリ、インポート、エクスポート、バッチ処理がどう振る舞うかをテストできます。
スケーラビリティテスト(Scalability tests) は、ワークロードを増やし、さらにリソースを追加したときにアプリの性能がどう変わるかを検証します。目的は、システムが効率よくスケールできるかを理解することです。たとえば、アプリインスタンス、CPU、メモリ、データベース容量を増やすといった方法です。
必ずしも種類ごとにまったく別のテストを実装する必要はありません。多くの場合、同じパフォーマンステストシナリオを再利用し、テストしたいものに応じて構成だけを変えられます。たとえば、同時ユーザー数、継続時間、リクエストレート、負荷パターンなどです。そしてテストの目的に応じて、異なる指標を観察します。
すべてのアプリがすべての種類のパフォーマンステストを必要とするわけでもありません。ロードテストとストレステストが主に必要なアプリもあれば、ロードテストとスパイクテストのほうが重要なアプリもあります。アプリの要件、そして何よりユーザーが実際にどう使っているかによります。
パフォーマンステストを正しく設計する方法
適切に設計されたパフォーマンステストは重要です。ほとんどの場合、いくつかのエンドポイントに手当たり次第にリクエストを送りたいわけではないからです。それでは通常、アプリの実際の振る舞いも、ボトルネックがどこにあるかも分かりません。
長年にわたって私にとって有効だったのは、典型的なユーザー行動を特定し、それをパフォーマンステストでシミュレートすることです。たとえば、注文システムを備えた eコマースアプリを想像してみてください。
典型的なユーザーはこうするかもしれません。
- 商品をいくつか検索する。
- 商品をカートに入れる。
- チェックアウトの流れを進める。
- 支払いを完了する。
各エンドポイントを個別にテストするのではなく、この一連の流れ全体をシミュレートするパフォーマンステストを設計し、フロントエンドが普段呼び出しているのと同じエンドポイントを呼び出します。
別の例としては、複数のユーザータイプを持つ業務アプリが考えられます。ユーザータイプごとに権限が異なり、アプリの使い方も異なります。この場合、ユーザータイプごとに典型的なワークフローを設計し、フロントエンドが使うのと同じ順序で API エンドポイントを呼び出せます。このやり方の利点は、実際のユーザー行動をシミュレートしていることです。その後、テスト構成を変えられます。たとえば、同じリアルなワークフローを保ったまま、同時ユーザー数を増やします。
もう一つの例は、API 間の通信です。POST エンドポイントの後に GET エンドポイントが続くとします。この場合、特定の負荷の下でさまざまな入力パラメータやリクエストパターンをシミュレートし、システムがどう振る舞うかを観察できます。
ユーザーパスはすでに設計できたとしよう。実際のテストフローを組み立てる段階では、まだいくつか押さえておくべきことがある。次の図は、その重要なポイントをまとめたものだ:
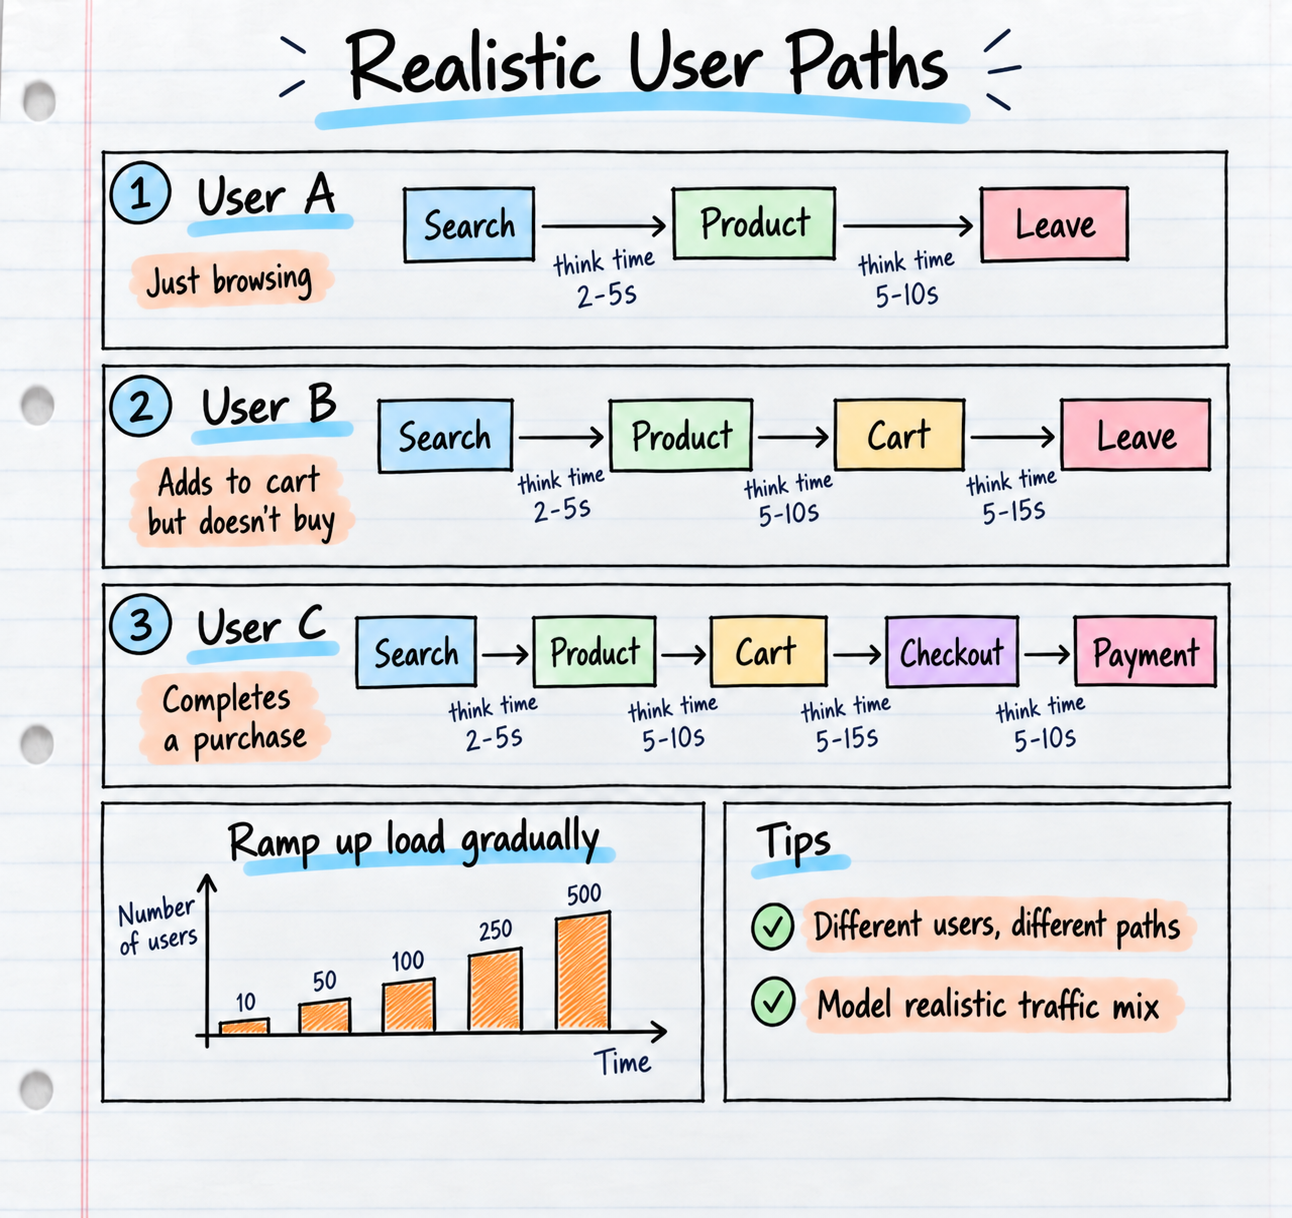
- 実際のユーザーは、性能テストがリクエストを送るようには速くクリックしない。だから操作と操作の間には、現実に近い思考時間を入れるべきだ。
- すべてのユーザーが同じパスを通るわけではない。EC アプリなら、注文まで完了する人もいれば、商品を眺めるだけの人もいるし、カートに入れてからしばらくして戻ってくる人もいる。だから挙動の異なる複数のユーザーパスをシミュレートする必要がある。
- ユーザーが一斉に同じ瞬間に接続してくることは普通ない。通常の負荷テストでは、負荷を徐々に立ち上げていくべきだ。
現実に近いユーザージャーニーがあれば、何をテストすべきかが見えてくる。次の問題は、システムがどれだけの負荷に耐える必要があるかだ。
想定負荷を決める
現実に近いワークロードを設計するのは、作業の一部にすぎない。テストを走らせる前に、どんな結果なら成功と言えるのかも定義しておく必要がある。すべてのアプリが毎秒 1,000 リクエストに耐える必要はない。システムごとに想定されるワークロードと性能要件がある。
たとえば:
Expected load: 150 RPS

p95 < 400 ms
p99 < 1 s
Error rate < 0.5%
Required throughput maintained
No continuously growing queues/connections
では、これらの数字はどうやって決めればいいのか。
EC の例に戻ろう。多くのアプリには、平常時より明らかにトラフィックが増える時期がある。EC アプリならクリスマス、ブラックフライデー、あるいは大規模なセールだろう。すでに可観測性がしっかり整っている会社なら、過去の本番メトリクスが有用な出発点になる。Grafana のようなツールを見れば、ピーク時のリクエストレート、同時ユーザー数、注文数、CPU 使用率、メモリ使用量、その他の関連メトリクスを確認できる。そこから将来の負荷を見積もる。たとえば来年トラフィックが 10% 増えると見込むなら、想定負荷にさらに安全余裕を上乗せしてシステムをテストする、と決められる。
必要な負荷を見積もる別の方法は、ビジネス要件から逆算することだ。たとえば、ビジネス側はこの EC アプリが 2 時間のピーク期間に 10,000 件の注文を処理することを期待しているとする。典型的な注文フローを見れば、ユーザーが商品を検索し、カートに商品を追加したり削除したりし、チェックアウトに進み、注文を完了するまでに、いくつの HTTP リクエストが発生するかを見積もれる。完了した注文 1 件あたり平均 20 リクエストだとすれば、10,000 件の注文はこの 2 時間でおよそ 200,000 リクエストになる。
ここから平均リクエストレートを計算できる:
200,000 リクエスト / 7,200 秒 ≈ 28 リクエスト/秒
これで平均およそ 28 RPS という数字が出る。だからといって、28 RPS が自動的にテスト目標になるわけではない。この計算は、完了した注文フローが生むトラフィックを推定しただけだ。実際のトラフィックは通常もっと多くなる。閲覧、放棄されたカート、バックグラウンドのリクエスト、その他のユーザージャーニーも総負荷に寄与しているからだ。実際のトラフィックが均等に分布することもほとんどないので、より短い時間のスパイクも考慮に入れ、適切な安全余裕を加えるべきだ。
信頼できる本番メトリクスが使えないとき、この方法は必要な負荷を見積もるもう一つの手段になる。性能目標は技術的なデータからもビジネス要件からも導ける、ということでもある。
性能テストと外部サービス
外部サービスには性能テストで特別な注意が必要だ。
場合によっては外部サービスを mock できる。いくつかの理由から、そもそもテストする必要がない、あるいはテストしたくないからだ。良い例が、エンドポイントの裏側にある有償 API、たとえば LLM API や別の有償サードパーティサービスだ。コストは現実的な懸念になる。性能テストでは、アプリが比較的短い時間に大量のリクエストを発生させかねないからだ。
別のケースとして、その外部 API をそもそも呼ぶ必要がないこともある。たとえば単純な参照データ API だったり、支払いサービスプロバイダーだったりして、その性能が今回のテストの対象外だという場合だ。そうなら WireMock のようなツールで、テスト中に期待どおりのレスポンスを返す制御された依存先に置き換えられる。こうすれば、外部サービスの性能、レート制限、可用性に結果を左右されることなく、本当のボトルネックも見つけやすくなり、自分たちのアプリの性能に集中できる。
逆に、外部サービスとの通信がシステムの現実の性能の重要な部分を占めるなら、それを単独でテストしたいかもしれないし、性能テストに含めたいかもしれない。
つまり、外部サービスを mock するかどうかは、シミュレートしたい挙動と、何を測定したいのかによって決めるべきだ。
環境構成
環境構成も性能テストの重要な要素だ。理想的には、性能テスト環境をできるだけ本番に近づけたいからだ。環境と本番が大きく違えば、結果が誤解を招くものになりかねない。とくに、実際の本番負荷のもとでアプリがどう振る舞うかを見積もりたいときはそうだ。
では、何を構成すべきか。
まず、アプリ自体は本番と同じか、ごく近い構成を使うべきだ。API を動かすサーバーやクラスタも、同等の CPU、メモリ、スケーリングルール、その他のリソース制限を持つべきだ。
データベースも同じだ。ただし、似たデータベースリソースを使うだけでは済まない。ほぼ空のデータベースでテストするのも避けるべきだ。データの量と分布は性能に大きく影響する。高負荷のもとでは、テーブルに数百万行が入っている場合と、テスト用のレコードが数件しかない場合とで、CRUD 操作、join、フィルタリング、ソートの挙動はまったく違ってくる。インデックス、クエリ実行プラン、統計情報、キャッシュも、データの規模と構造によって挙動が変わる。
だから可能な限り、テスト用データベースには現実に近い、代表的なデータ量を入れておくべきだ。
キャッシュ構成にも注意を払うべきだ。Redis やインメモリキャッシュなどだ。キャッシュ構成が違ったり、常にウォームアップされた状態のキャッシュでテストしたりすると、本番の実際の挙動を表さない結果になりうる。
ネットワークの状況も重要な要素だ。たとえば外部サービスをローカルで mock していれば、リクエストはほぼ瞬時に返ってくるかもしれないが、本番環境の実際のサービスでは数十ミリ秒、場合によっては百ミリ秒以上のネットワーク遅延が加わる。何を測りたいかによっては、より現実に近い結果を得るためにこの遅延を模擬する必要が出てくる。
最後に、負荷をかけるマシン自体の問題がある。これは忘れられがちだ。負荷を生成するマシンに十分な CPU、メモリ、ネットワーク容量、そして利用可能なコネクションがなければ、必要なワークロードを生み出せない。そうなれば、ボトルネックになるのはテスト対象のアプリケーションではなく、負荷生成側のマシンかもしれない。
指標と結果
パフォーマンステストを走らせたあとは、結果を評価し、たいていは何らかの形でレポートにまとめる必要がある。どの指標に注目するかはテストの種類によって変わる。テストの種類ごとに答える問いが違うからだ。
EC アプリの例に戻ろう。ここでは負荷テストとストレステストを同時に走らせることにしたとする。
負荷テストの場合、想定される負荷はすでに分かっている。たとえば 1 秒あたりのリクエスト数や同時ユーザー数だ。ここで検証したいのは、アプリが許容できるパフォーマンスを保ったまま、その負荷に耐えられるかどうかである。
特に重要な指標は次のとおりだ。
- レスポンスタイム、とくに p95 や p99 といったパーセンタイル。
- エラー率:失敗したリクエストの割合。
- スループット:アプリが想定どおりの数のリクエストを実際に処理できているか。
- リソース使用量:CPU、メモリ、データベースコネクション、コネクションプール、その他関連するリソース。
たとえば、あるエンドポイントの p95 レスポンスタイムが想定よりはるかに高ければ、ボトルネックがどこにあるか調べ始められる。同じように、エラー率が許容できる上限を超えていれば、どのリクエストが失敗しているのか、なぜ失敗しているのかを突き止める必要がある。
ストレステストの場合、目的は少し違う。意図的に想定を超える負荷をかけ、アプリが劣化し始める点を探す。ここで見るのは、負荷が上がるにつれてレスポンスタイムとエラー率がどう変化するか、そして CPU、メモリ、データベースコネクション、キュー、その他の制約のあるリソースがどう動くかだ。探しているのは、システムが飽和してエラーが増えすぎるか、あるいは必要なスループットを維持できなくなる点である。
負荷が下がったあとのアプリの挙動を観察するのも役に立つ。極端な負荷で遅くなってもその後回復するシステムと、固まってしまったり再起動が必要になったりするシステムとでは、振る舞いが大きく異なる。
次の図は、この例で監視している指標を示したもので、特定のボトルネックや飽和点を見つけるには複数のグラフを並べて見る必要がある理由も分かる。
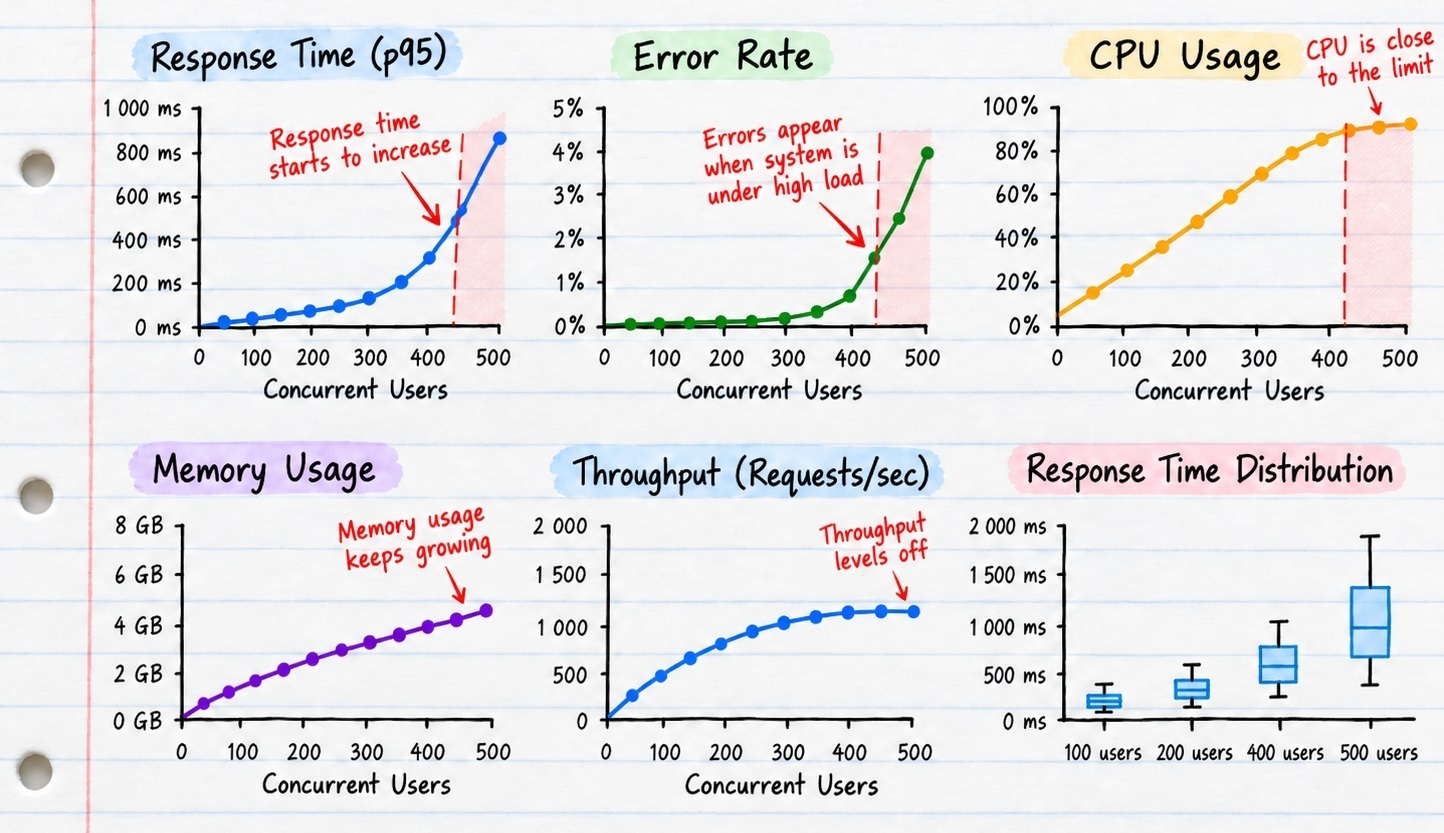
つまり最終的なレポートは、平均レスポンスタイムのような単一の数値を載せるだけでは不十分だ。生成したワークロードをレイテンシ、スループット、エラー、リソース使用量と結びつけて示すことで、アプリが期待に届いていないかどうかだけでなく、その理由まで分かるようになる。
まとめ
本記事ではパフォーマンステストの基礎をいくつか取り上げ、そのうえで現実的なシナリオ向けにテストを設計する方法に焦点を当てた。
鍵となるのは、アプリが実際にどう使われているかを理解し、現実に近いテスト環境を用意し、代表的なワークロードを生成し、正しい指標を監視することだ。これらの部分が適切に設計されていれば、パフォーマンステストはボトルネック、システムの限界、そして負荷がかかったときのアプリ全体の挙動について有用な情報を与えてくれる。
パフォーマンステストの理論や各種テストタイプについては、すでに優れた記事が数多くある。この記事の目的はそれらを繰り返すことではなく、より実践的な視点からパフォーマンステストを見て、私がどうやって現実に近いテストを設計しているかを示すことにある。
結局のところ、パフォーマンステストが役に立つのは、そのワークロード、環境、指標が結果に意味を持たせるのに十分なほど現実に近いときだけなのだ。