API 性能测试:如何设计贴近真实的测试
性能测试不是往接口上乱发一堆请求。作者先讲了负载、压力、耐久、尖峰、容量、可扩缩六类测试各自回答什么问题,再重点讲怎么设计贴近真实的场景:从用户路径、用业务量反推 RPS 的算法,到外部服务要不要 mock、环境与数据库该怎么配。
中文
复制
我们大多数人都听过性能测试这个词,无论是发布一个大功能之前、上线一个新应用之前,还是只是检查一个应用能不能扛住某个特定的负载。
性能测试帮我们理解应用在负载下的行为,以及它能不能承受预期的压力。但前提是它们得设计得当,否则结果会误导我们,把我们引向错误的结论。
反过来,设计得当的性能测试能帮我们识别瓶颈、理解应用的极限,也让我们在发布前更有把握。
本文先看基本概念和不同类型的性能测试,然后进入更实际的部分:怎么设计贴近真实的测试场景,怎么确定应用应该扛住多少负载,怎么处理外部服务,以及测试环境该和生产多接近。
目标不只是发出大量请求,而是做出能真正告诉我们一些有用信息的性能测试,让我们知道应用在现实世界里会怎么表现。
目录
- 基本定义
- 测试的类型
- 如何正确地设计性能测试
- 确定预期负载
- 性能测试与外部服务
- 环境配置
- 指标与结果
- 小结
那么,先从基本定义和不同类型的性能测试说起。
基本定义
我们可以把性能测试概括为一种非功能性的软件测试方法,它评估应用在特定工作负载下的速度、稳定性、可扩缩性和响应能力。
简化一下,我们就用 API 举例。我们准备好测试,去调用想要在负载下测试的那些端点,通常按一个特定的顺序,这个顺序代表应用实际被使用的样子。性能测试背后的主要想法,是避免把一个还没准备好承受预期负载的应用发布出去。
性能差会导致生产环境故障、响应时间变慢,或者出现应用无法在要求时间内处理完一个作业的情况。所有这些问题最终都可能导致客户流失、收入损失,或者产品声誉受损。
我们可以按配置、目的,以及想观察的指标,把性能测试分成不同的类型。
测试的类型
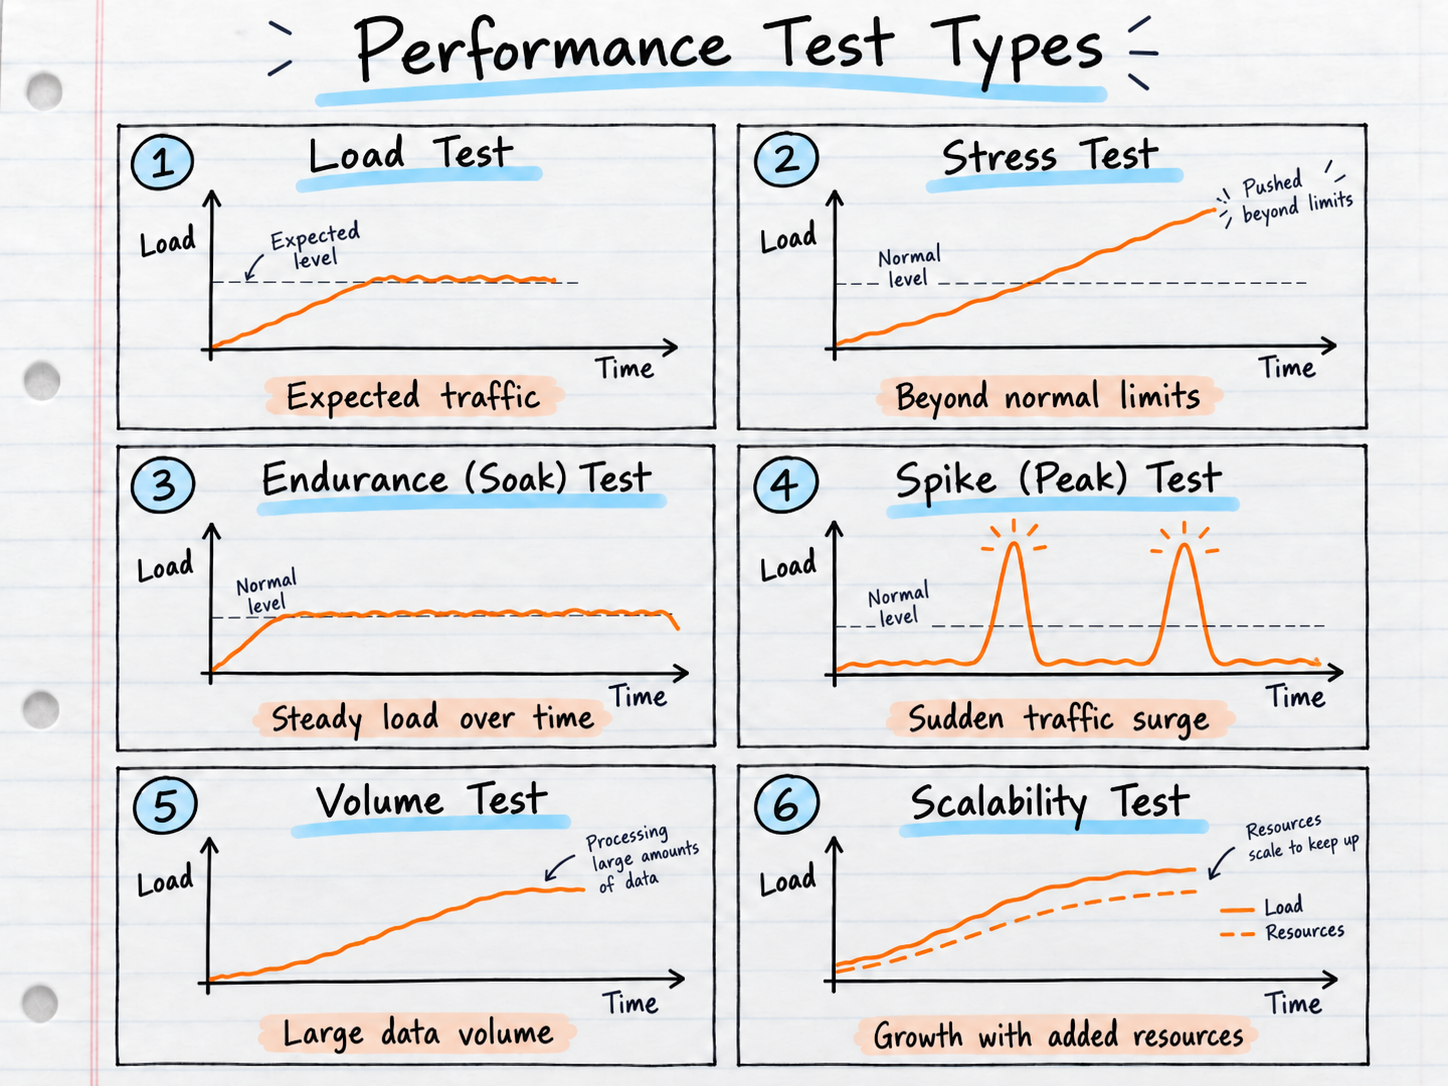
我觉得这张图已经说明了一切,但还是简单描述一下每一种:
**负载测试(Load tests)**验证应用在预期或正常流量水平下的行为。目标通常是确认系统能在保持可接受的响应时间、错误率和资源使用的前提下,承受所需的用户数或请求量。
**压力测试(Stress tests)**把应用推过它的预期极限,找出它从哪里开始退化或失败。它们帮我们识别系统的最大容量,并观察当 CPU、内存、数据库连接或线程这类资源被耗尽时它会怎样。
**耐久测试(Endurance / Soak tests)**让应用在持续负载下运行更长的时间。它的目的是暴露那些短测试里可能不会出现的问题,比如内存泄漏、连接泄漏、资源耗尽,或者随时间推移的性能衰减。
**尖峰测试(Spike / Peak tests)**模拟流量的突然大幅上升。它们帮我们验证应用对负载快速变化的反应,以及流量恢复正常后它能不能恢复过来。
**容量测试(Volume tests)**关注的是当应用需要处理或应对大量数据时它的行为。比如,我们可以测试当数据量远大于平常时,数据库查询、导入、导出或批处理会怎么表现。
**可扩缩性测试(Scalability tests)**验证当我们增加工作负载并追加更多资源时,应用性能如何变化。目的是理解系统能不能高效扩展,比如通过增加更多应用实例、CPU、内存或数据库容量。
你并不一定需要为每一种类型实现完全不同的测试。很多情况下,你可以复用同一个性能测试场景,只按你想测的东西改配置,比如并发用户数、持续时间、请求速率或负载模式。然后按测试的目的去观察不同的指标。
也不是每个应用都需要每一种性能测试。有些应用可能主要需要负载测试和压力测试,另一些则可能更需要负载测试和尖峰测试。这确实取决于应用的需求,更重要的是取决于用户实际是怎么用它的。
如何正确地设计性能测试
设计得当的性能测试非常重要,因为大多数时候,我们并不想随便往一些端点上乱发请求。那样通常说明不了应用的真实行为,也说明不了瓶颈在哪里。
这些年来对我有效的做法,是识别典型的用户行为,并在性能测试里把它模拟出来。举个例子,想象一个带下单系统的电商应用。
一个典型的用户可能会:
- 搜索几件商品。
- 把商品加入购物车。
- 走完结账流程。
- 完成支付。
与其孤立地测试每一个端点,我会设计一个性能测试,模拟这整条流程,调用前端平时调用的那些同样的端点。
另一个例子可能是一个有多种用户类型的业务应用,每种用户类型有不同的权限,使用应用的方式也不同。这种情况下,我们可以为每种用户类型设计一条典型工作流,并按前端使用的相同顺序调用 API 端点。这种做法的好处是我们模拟的是真实的用户行为。之后我们可以改测试配置:比如增加并发用户数,同时保留同样的真实工作流。
再一个例子是 API 与 API 之间的通信。假设我们有一个 POST 端点,后面跟着一个 GET 端点。这种情况下,我们可以在特定的负载下模拟不同的输入参数和请求模式,观察系统如何表现。
假设我们已经设计好了用户路径。在构建真正的测试流程时,还有几件重要的事要考虑。下面这张图总结了其中一些关键想法:
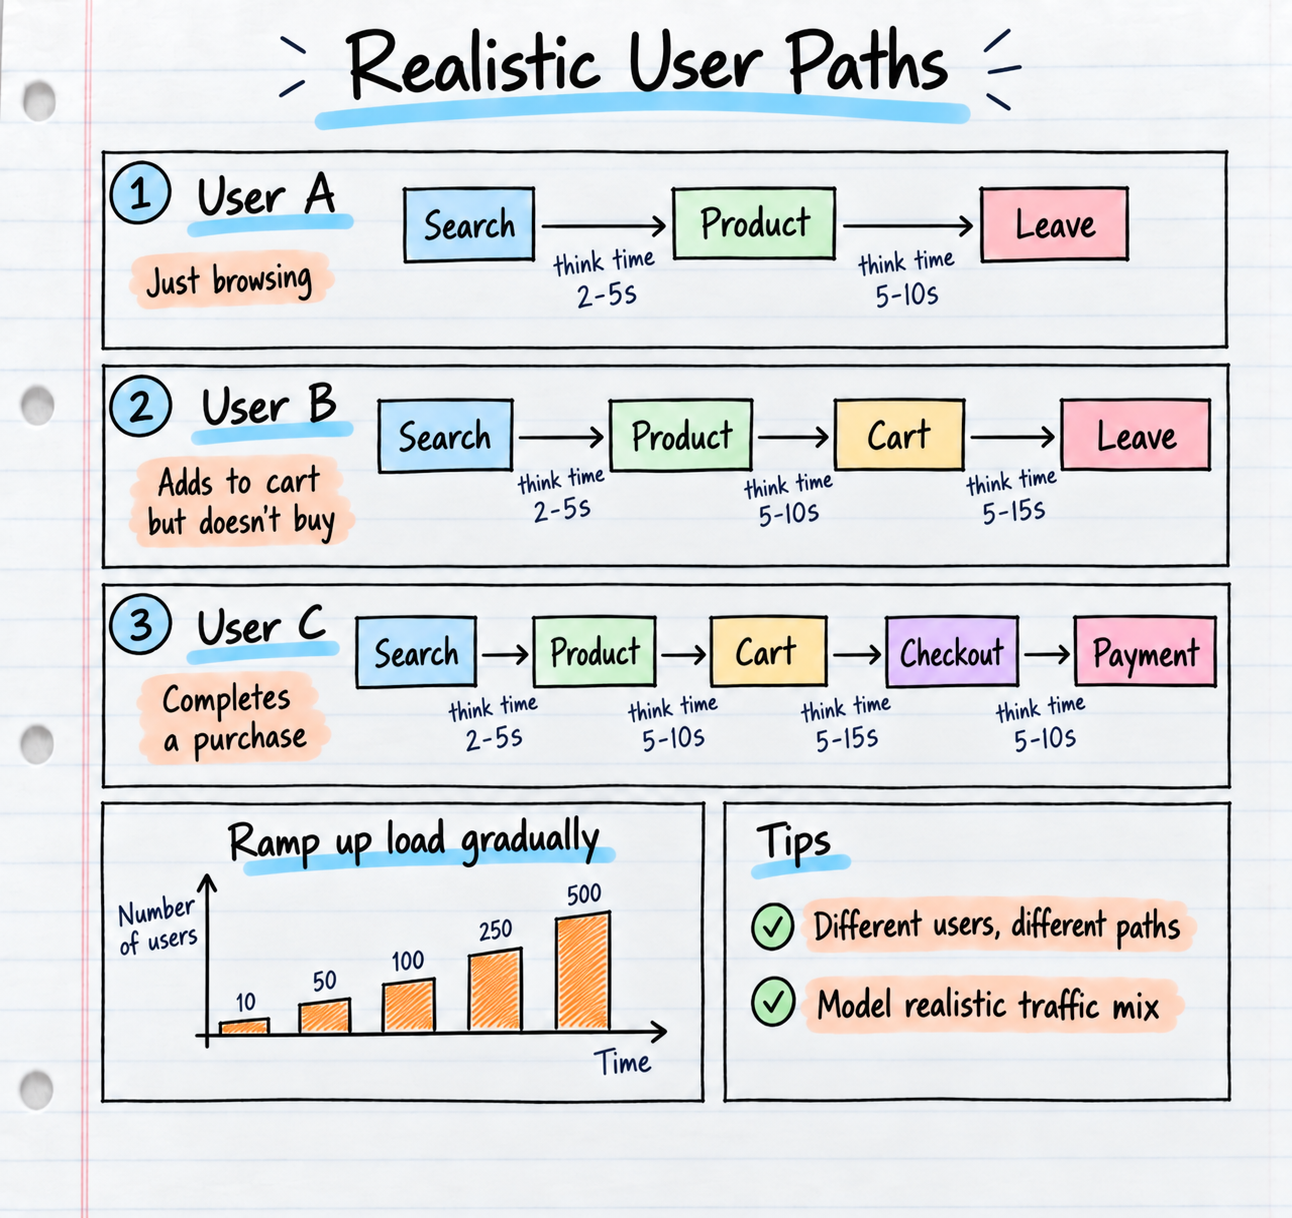
- 真实用户点击的速度没有性能测试发请求那么快,所以我们应该在操作之间加入贴近真实的思考时间。
- 不是每个用户都走同一条路径。在电商应用里,有些用户完成了下单,另一些只是浏览商品,或者把商品加进购物车之后过一阵再回来。因此我们应该模拟多条行为不同的用户路径。
- 用户通常不会都在同一瞬间连上来,所以对于普通的负载测试,我们应该让负载逐渐爬升。
一条贴近真实的用户旅程告诉我们该测什么。接下来的问题是,系统需要扛住多少负载。
确定预期负载
设计一个贴近真实的工作负载只是工作的一部分。在跑测试之前,我们还需要定义什么样的结果才算成功。不是每个应用都需要扛住每秒 1,000 个请求。每个系统都有自己的预期工作负载和性能要求。
例如:
Expected load: 150 RPS

p95 < 400 ms
p99 < 1 s
Error rate < 0.5%
Required throughput maintained
No continuously growing queues/connections
那么我们要怎么定出这些数字?
回到我们的电商例子。很多应用都有流量明显高于平常的时期。对电商应用来说,可能是圣诞、黑色星期五,或者其他大型促销活动。如果公司已经有不错的可观测性,历史生产指标可以给我们一个有用的起点。我们可以查看 Grafana 这类工具,确定峰值请求速率、并发用户数、订单量、CPU 使用率、内存占用以及其他相关指标。然后我们可以预估未来的负载。比如,如果我们预计明年流量增长 10%,我们可能会决定在预期负载之上再加一层安全余量来测试系统。
另一种估算所需负载的办法是从业务需求出发。比如,业务方期望我们的电商应用在两小时的峰值期内处理 10,000 笔订单。我们可以看一条典型的下单流程,估算用户在搜索商品、往购物车里加或减商品、走结账、完成订单的过程中会产生多少个 HTTP 请求。如果一笔完成的订单平均产生比如 20 个请求,那么 10,000 笔订单在这两小时里大约就是 200,000 个请求。
由此我们可以算出平均请求速率:
200,000 个请求 / 7,200 秒 ≈ 28 个请求/秒
这给我们一个大约 28 RPS 的平均值。这并不意味着 28 RPS 就该自动成为我们的测试目标。这个计算只估算了已完成下单流程产生的流量。真实的流量通常会更高,因为浏览、被放弃的购物车、后台请求和其他用户旅程也都在为总负载做贡献。真实流量也很少均匀分布,所以我们应该把更短的流量峰值考虑进去,并加上合适的安全余量。
在没有可靠生产指标可用时,这个办法给了我们另一种估算所需负载的方式,也说明我们既能从技术数据、也能从业务需求推导性能目标。
性能测试与外部服务
外部服务在性能测试中需要特别小心。
有些情况下,我们可以把外部服务 mock 掉,因为出于几个原因,我们根本不需要或者不想测它。一个很好的例子是我们端点背后那个付费 API,比如一个 LLM API 或者另一个付费的第三方服务。成本是实打实的顾虑,因为在性能测试中,我们的应用可能在相对短的时间里产生大量请求。
另一种情况是我们根本不需要调用那个外部 API。比如,它可能是一个简单的参考数据 API,或者一个支付服务商,而它的性能不在我们这次测试的范围里。那我们可以用 WireMock 这类工具把它替换成一个受控依赖,在测试期间返回我们预期的响应。这样我们就能专注于自己应用的性能,而不让外部服务的性能、速率限制或可用性影响结果、把真正的瓶颈变得更难找出来。
反过来说,如果与外部服务的通信是系统现实性能的重要部分,我们可能想单独测它,或者把它纳入性能测试里。
所以,要不要 mock 一个外部服务,应该取决于我们想模拟的行为,以及我们究竟想测量什么。
环境配置
环境配置是性能测试里另一个重要的部分,因为理想情况下,我们希望性能测试环境尽可能接近生产。如果环境和生产差别很大,结果就可能变得误导人,尤其是当我们想估算应用在真实生产负载下会怎么表现时。
那么,我们该配置什么?
首先,应用本身应该使用与生产相同或非常相似的配置。运行 API 的服务器或集群,也应该有可比的 CPU、内存、扩缩规则和其他资源限制。
数据库也一样。不过这不只是使用相似的数据库资源。我们还应该避免在一个几乎空的数据库上做测试。数据的量和分布会对性能产生显著影响。在高负载下,当表里装着数百万行、而不是几条测试记录时,CRUD 操作、join、过滤和排序的表现会非常不同。索引、查询执行计划、统计信息和缓存,都会因数据的规模和结构而有不同的行为。
因此,只要可能,测试数据库就应该包含贴近真实的、有代表性的数据量。
我们也应该注意缓存配置,比如 Redis 或内存缓存。不同的缓存配置,或者在一个一直预热的缓存上测试,都可能产生不代表真实生产行为的结果。
网络状况是另一个重要因素。比如,如果某个外部服务是在本地 mock 的,请求可能几乎瞬间返回,而生产环境里真实的服务可能会多出几十甚至上百毫秒的网络延迟。取决于我们想测什么,我们可能需要模拟这份延迟,才能得到更贴近真实的结果。
最后,还有压测机本身。这一点很容易被忘掉。产生负载的那台机器必须有足够的 CPU、内存、网络容量和可用连接,才能产生所需的工作负载。否则,成为瓶颈的就可能是压测机,而不是我们真正在测的那个应用。
指标与结果
跑完性能测试之后,我们需要评估结果,通常还要产出某种形式的报告。我们关注哪些指标取决于测试的类型,因为不同的测试类型回答不同的问题。
回到我们的电商应用,假设我们决定同时跑负载测试和压力测试。
对于负载测试,我们已经知道预期负载,比如每秒多少请求或多少并发用户。现在我们要验证的是,应用能不能在保持可接受性能的同时扛住这个负载。
其中最重要的几个指标是:
- 响应时间,尤其是 p95 或 p99 这类百分位。
- 错误率:失败的请求占多少。
- 吞吐量:应用是否真的处理了预期数量的请求。
- 资源使用:CPU、内存、数据库连接、连接池以及其他相关资源。
比如,如果某个端点的 p95 响应时间远高于预期,我们就可以开始查瓶颈在哪里。同样,如果错误率超过我们能接受的上限,我们就得找出是哪些请求在失败、为什么失败。
对于压力测试,我们的目标略有不同。我们有意把负载加到超过预期水平,努力找到应用开始退化的那个点。这里我们要看的是:随着负载上升,响应时间和错误率如何变化,以及 CPU、内存、数据库连接、队列和其他受限资源的变化。我们要找的是系统达到饱和、开始产生过多错误,或者再也维持不住所需吞吐量的那个点。
观察负载下降之后应用的表现也很有用。一个在极端负载下变慢、之后能恢复的系统,和一个卡住不动或者需要重启的系统,行为差别很大。
下面这张图展示了我们在示例里监控的指标,也说明为什么我们需要把多张图放在一起看,才能找出某个具体的瓶颈或饱和点。
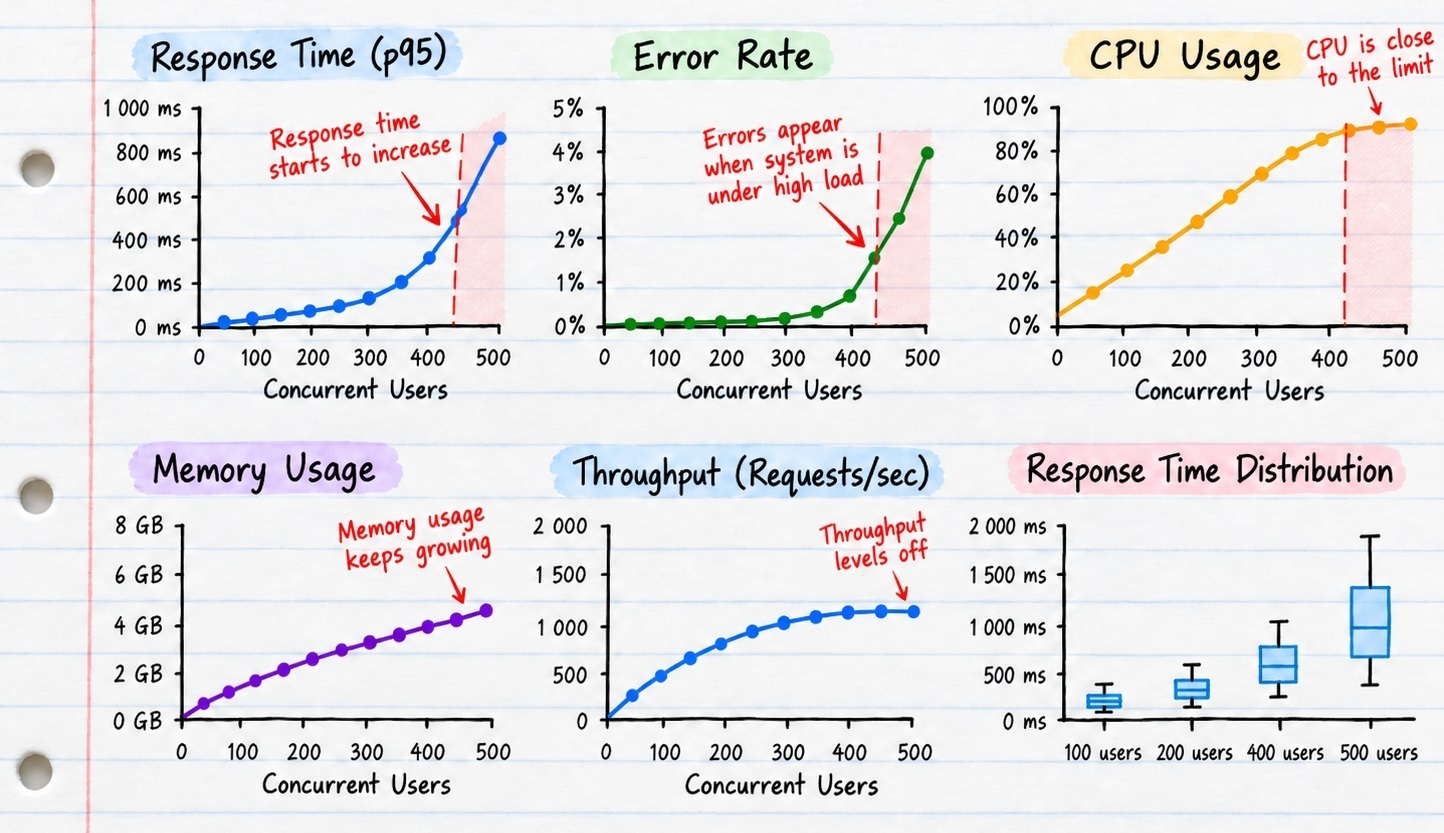
所以最终报告不应该只包含一个数字,比如平均响应时间。它应该把产生的工作负载与延迟、吞吐量、错误和资源利用联系起来,这样我们不仅能知道应用是否没达到预期,还能知道为什么。
小结
本文讲了一些性能测试的基础,然后重点讲了如何为现实场景设计测试。
关键在于理解应用实际是怎么被使用的,准备一个贴近真实的测试环境,产生有代表性的工作负载,并监控正确的指标。当这些部分都设计得当时,性能测试能给我们关于瓶颈、系统极限,以及应用在负载下整体行为的有用信息。
已经有很多很好的文章在讲性能测试的理论和各个测试类型。我写这篇的目的不是把那些重复一遍,而是从一个更实际的角度看性能测试,展示我是怎么设计贴近真实的测试的。
说到底,只有当它的工作负载、环境和指标都足够贴近真实、足以让结果有意义时,一次性能测试才是有用的。