当随机性实际上不够随机时
随机测试的好坏取决于其抽取的分布。本文展示了一个看似均匀的生成器如何悄然使你实际测试的用例产生偏差,以及如何为它赋予一个显式分布。
更多 测试
首页随机测试的好坏取决于其抽取的分布。本文展示了一个看似均匀的生成器如何悄然使你实际测试的用例产生偏差,以及如何为它赋予一个显式分布。
Rust 编译器团队把年度调查里关于调试的部分单独整理出来。开发者最缺的是对已优化构建的可调试性,以及异步代码、宏展开和泛型实例化处的单步能力。文章按痛点排序列出调查结果与后续打算。
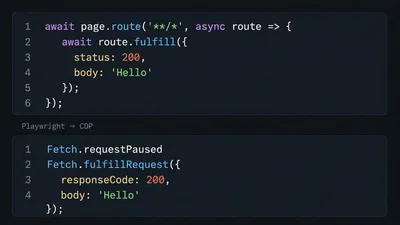
Playwright 的 page.route() 如何在不同浏览器中拦截请求,以及如何仅用 Chromium DevTools Protocol 实现同样的拦截。
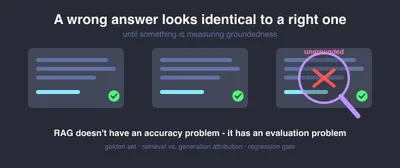
内部政策机器人演示时答得滴水不漏,上线后却依据已被取代的旧政策给出自信答案,而且没有任何信号能告诉你退化始于何时;这篇文章讲的是怎么为它建一道回归门禁。
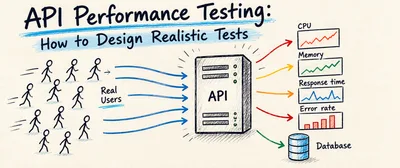
性能测试不是往接口上乱发一堆请求。作者先讲了负载、压力、耐久、尖峰、容量、可扩缩六类测试各自回答什么问题,再重点讲怎么设计贴近真实的场景:从用户路径、用业务量反推 RPS 的算法,到外部服务要不要 mock、环境与数据库该怎么配。
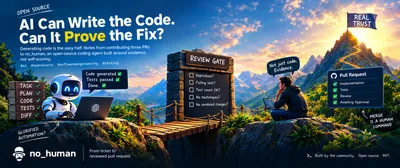
一个 AI 生成的改动要拿出什么证据,人类才有资格信它,作者借给 no_human 提的三个 PR 讲清了防篡改守卫、复现闸门和对抗性评审各自挡住哪一类失败。